
Identification de la distribution individuelle
Individual Distribution Identification ajuste simultanément plusieurs distributions de probabilité à vos données et évalue laquelle offre le meilleur ajustement statistique. Plutôt que de supposer la normalité, cet outil teste un large éventail de distributions (Weibull, lognormale, exponentielle, logistique, gamma, entre autres) et les classe selon leur capacité à décrire la forme et le comportement de vos données.
Dernière révision
Point clé
Individual Distribution Identification ajuste simultanément plusieurs distributions de probabilité à vos données et évalue laquelle offre le meilleur ajustement statistique.
Sur cette page
- Qu'est-ce que Individual Distribution Identification ?
- Quand utiliser Individual Distribution Identification ?
- Recommandations pour bien utiliser Individual Distribution Identification
- Alternatives : quand ne pas utiliser Individual Distribution Identification
- Exemple d'Individual Distribution Identification
- Comment utiliser Individual Distribution Identification
Qu'est-ce que Individual Distribution Identification ?
Individual Distribution Identification ajuste simultanément plusieurs distributions de probabilité à vos données et évalue laquelle offre le meilleur ajustement statistique. Plutôt que de supposer la normalité, cet outil teste un large éventail de distributions (Weibull, lognormale, exponentielle, logistique, gamma, entre autres) et les classe selon leur capacité à décrire la forme et le comportement de vos données.
C'est essentiel pour l'analyse de capabilité sur des données non normales, où l'utilisation d'une mauvaise distribution produit des estimations inexactes de Pp, Ppk ou Cp, Cpk et des prévisions trompeuses du taux de défauts.
Définition simple : un outil qui teste vos données par rapport à de nombreuses distributions statistiques différentes et indique laquelle s'ajuste le mieux, pour que vous puissiez réaliser une analyse de capabilité exacte même lorsque les données ne suivent pas une distribution normale.
Quand utiliser Individual Distribution Identification ?
- À utiliser lorsque vos données échouent à un test de normalité et que vous devez identifier la bonne distribution avant l'analyse de capabilité.
- À utiliser avec des données de procédé intrinsèquement asymétriques comme des temps de cycle, des temps de défaillance, des concentrations chimiques ou des tailles de particules.
- À utiliser avant d'appliquer une analyse de capabilité non normale pour s'assurer que la distribution choisie représente fidèlement le comportement du procédé.
- À utiliser lorsque la transformation de Box-Cox n'est pas appropriée , par exemple lorsque les données contiennent des zéros ou des valeurs négatives.
Recommandations pour bien utiliser Individual Distribution Identification
- Recueillez au moins 50 à 100 points de données pour que l'ajustement des distributions soit fiable : de petits échantillons ne fournissent pas assez d'informations pour distinguer les distributions.
- Utilisez ensemble les statistiques d'adéquation (Anderson-Darling) et les droites de probabilité pour choisir la meilleure distribution ; ne vous fiez pas uniquement à la valeur p.
- Choisissez une distribution qui a un sens physique pour le procédé : une distribution ayant la statistique AD la plus faible mais sans fondement physique n'est peut-être pas le meilleur choix.
- Assurez-vous que les données proviennent d'un procédé stable et maîtrisé avant d'ajuster des distributions : l'ajustement sur des données de procédé instable produit des résultats sans signification.
- Envisagez la transformation de Johnson ou de Box-Cox comme alternative lorsqu'aucune distribution standard ne s'ajuste bien.
Alternatives : quand ne pas utiliser Individual Distribution Identification
- Si les données sont déjà confirmées normales, passez directement à l' analyse de capabilité normale standard : l'identification de la distribution est inutile.
- Si vous voulez seulement vérifier la normalité sans explorer d'autres distributions, utilisez un simple test de normalité
- Si les données ont des bornes physiques claires ou un type de distribution connu, indiquez directement cette distribution dans l'analyse de capabilité plutôt que de tester toutes les options.
Exemple d'Individual Distribution Identification
Un ingénieur prélève un échantillon aléatoire de capsules et relève leur teneur en calcium. Pour déterminer la distribution des données qui s'ajuste le mieux, il réalise une identification de la distribution individuelle. Le test se déroule selon les étapes suivantes :
- Rassemblez les données nécessaires.
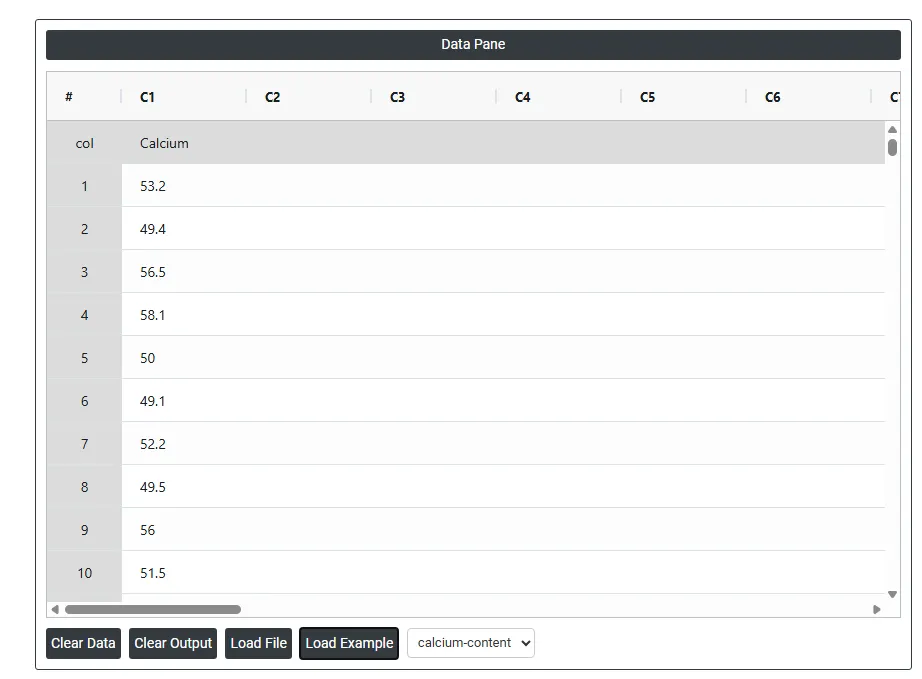
- Analysez ensuite les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver Individual Distribution Identification, choisissez Statistical module> Hypothesis Test> Individual Distribution Identification.
- Dans l'outil, saisissez les données et les autres paramètres comme suit :
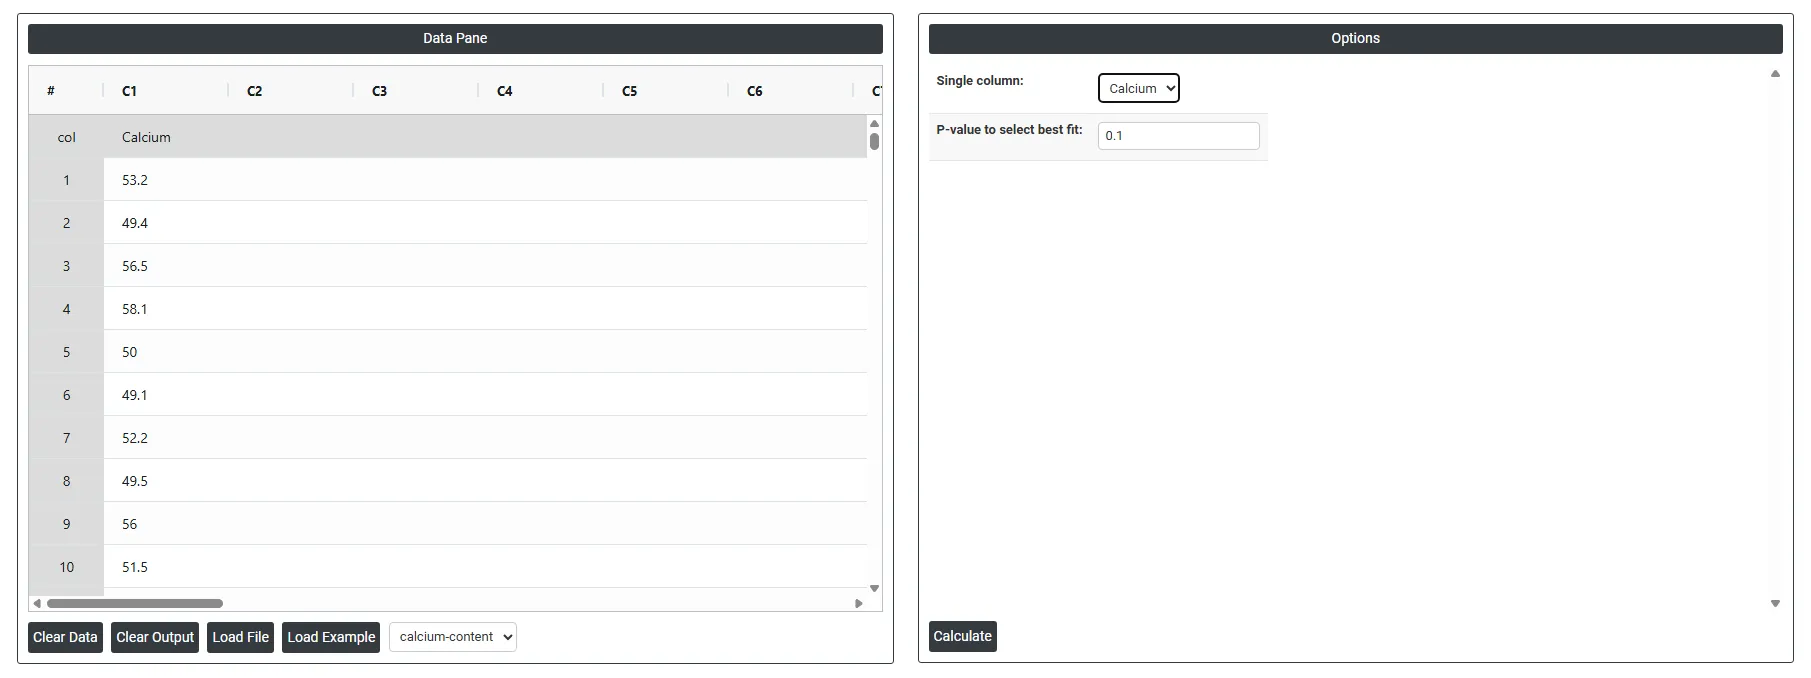
5. Après utilisation de l'outil ci-dessus, les résultats obtenus sont les suivants :
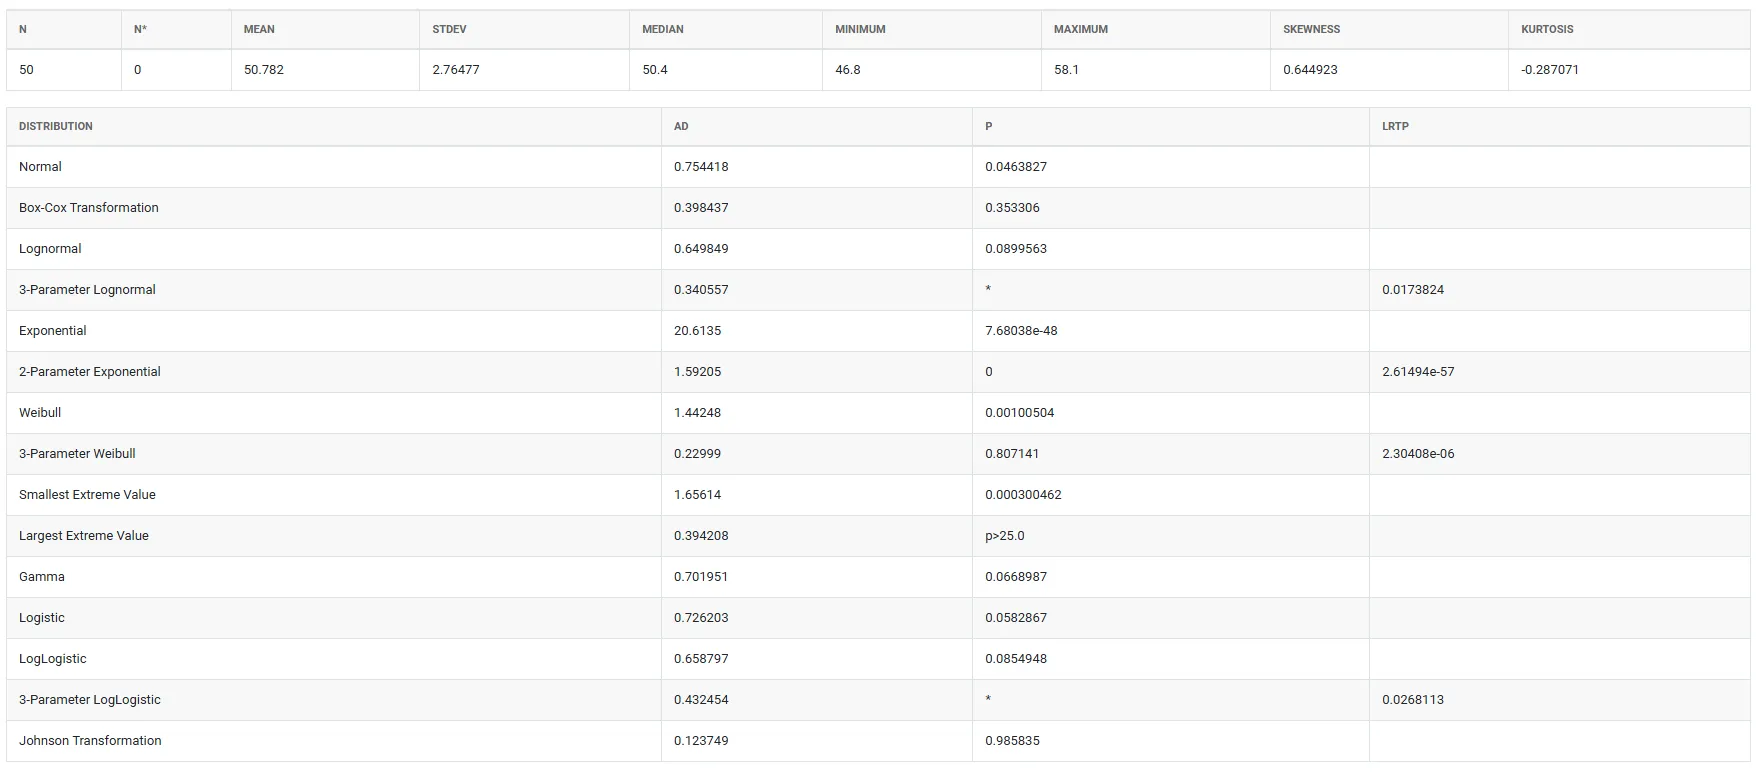
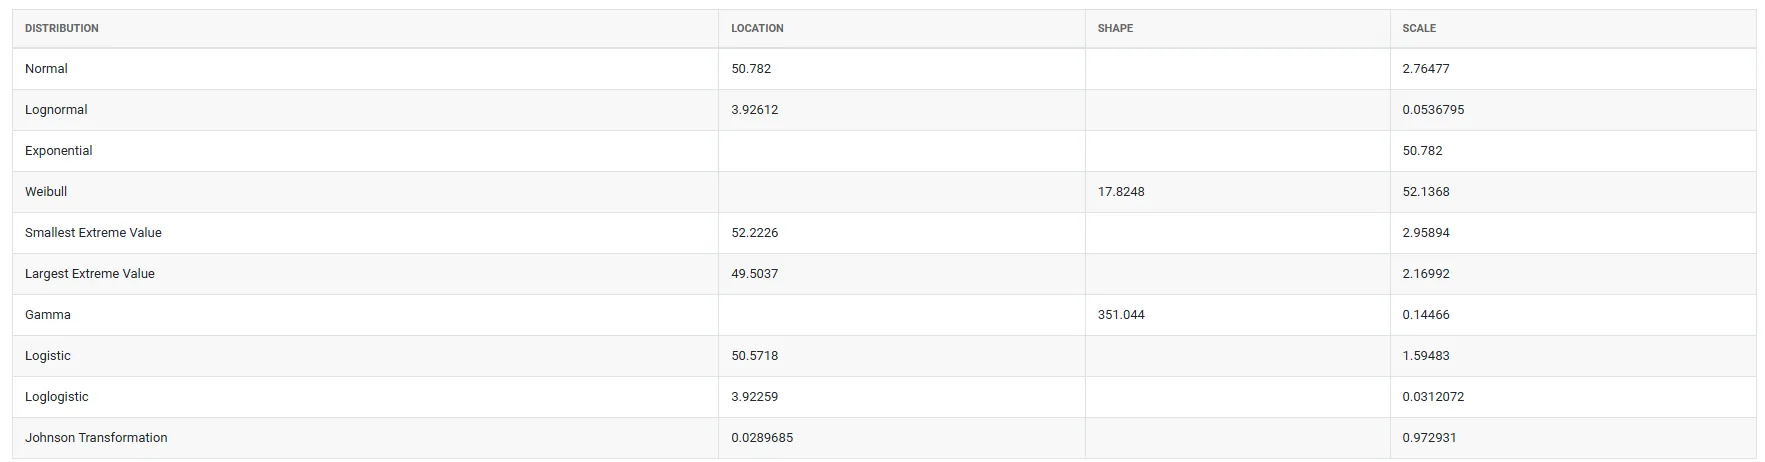
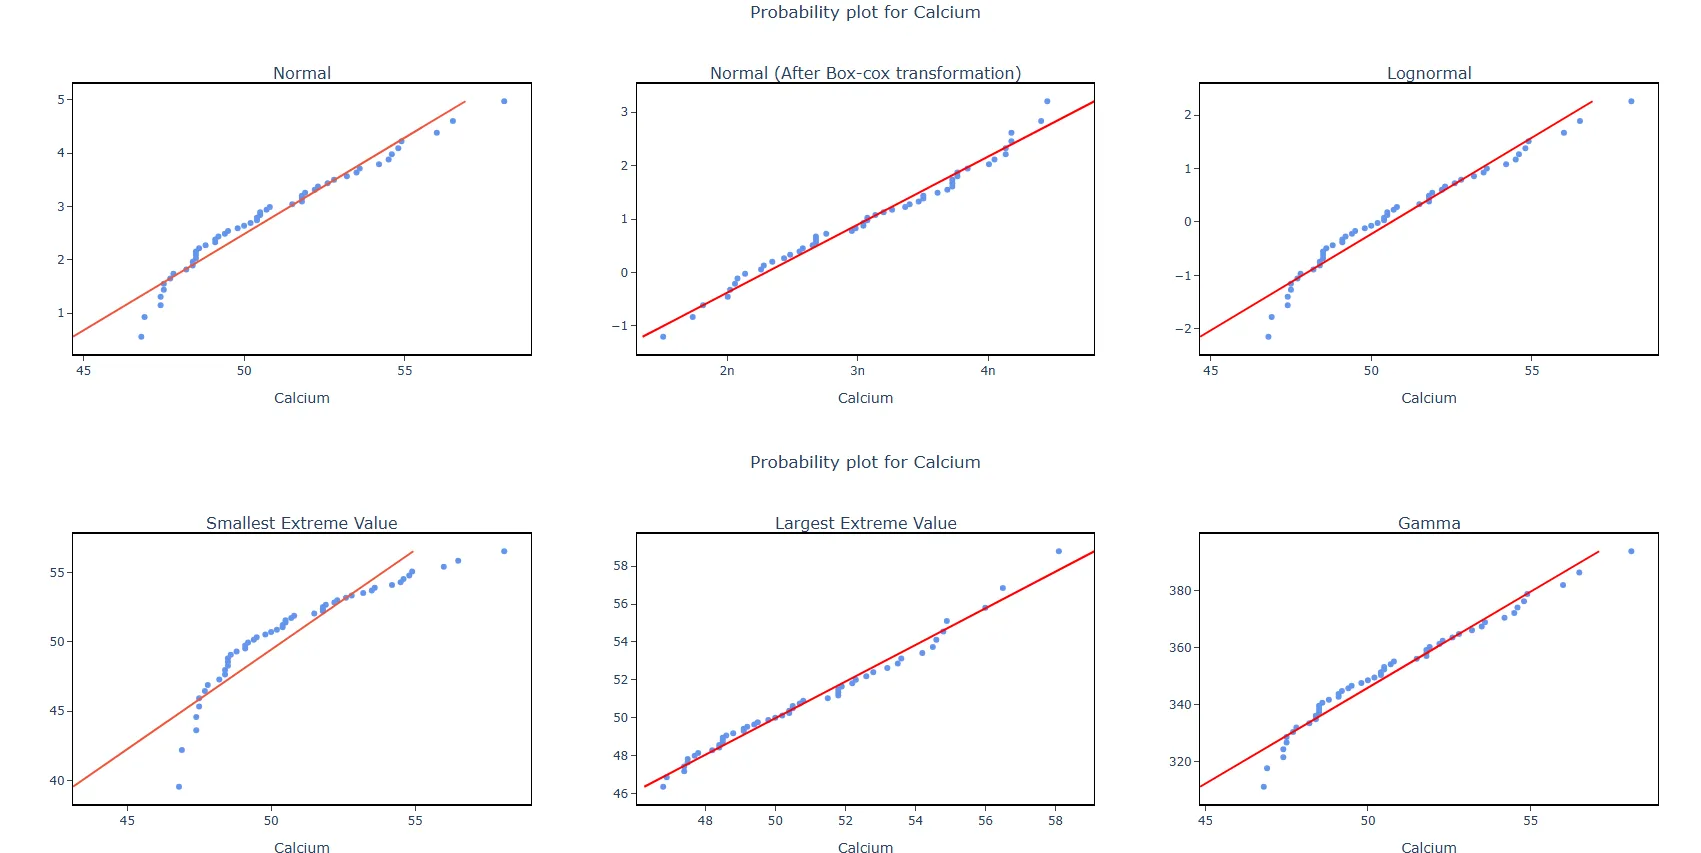
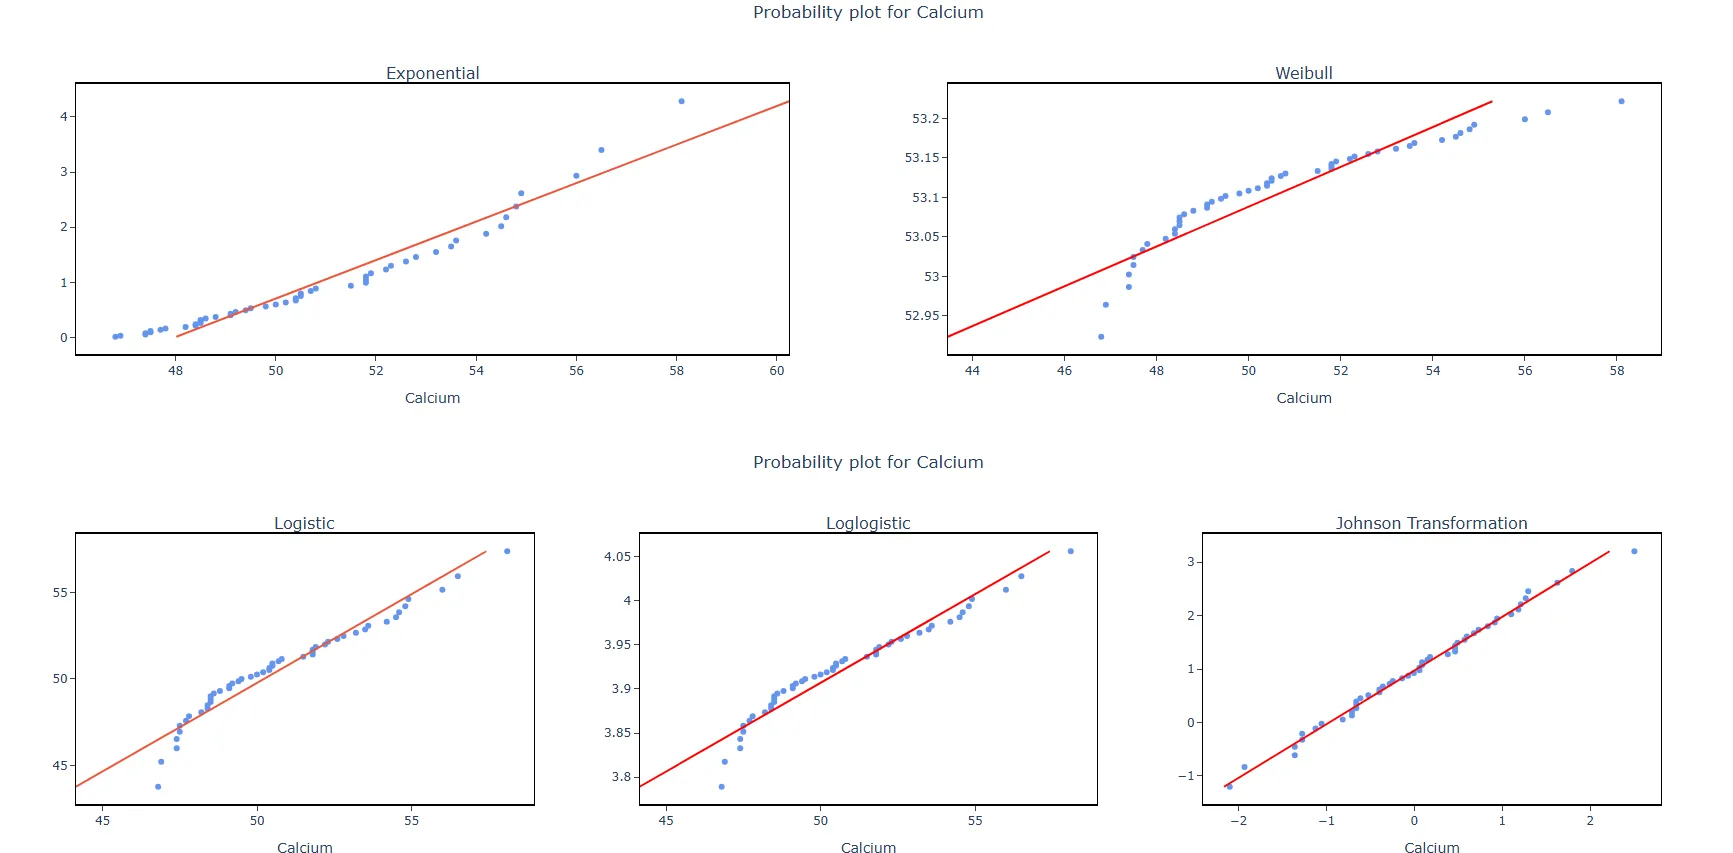
Comment utiliser Individual Distribution Identification
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Hypothesis Test >Individual Distribution Identification .
- Ensuite, saisissez les données manuellement ou copiez-les (Ctrl+C) depuis une feuille Excel et collez-les (Ctrl+V) ici.
- Renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Dans le tableau de bord de Individual Distribution Identification, la fenêtre est divisée en deux parties.
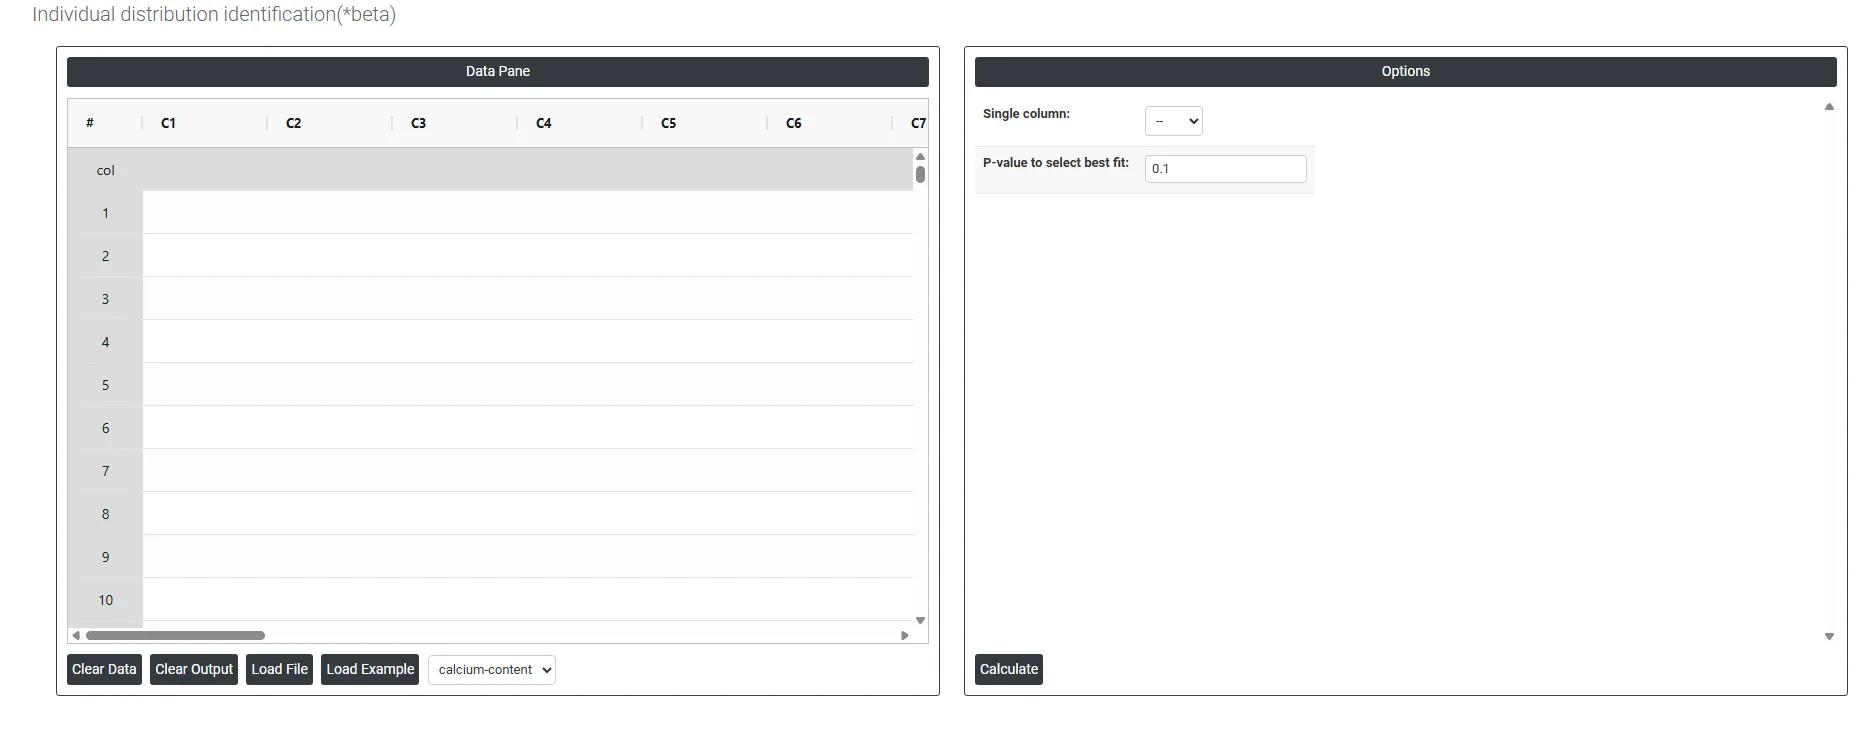
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement ou entièrement copiées (Ctrl+C) depuis une feuille Excel puis collées (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File : permet de charger directement des données Excel.
Dans la partie droite se trouvent de nombreuses options, comme suit :
- Single Column : sélectionnez la colonne contenant les données continues auxquelles vous voulez ajuster des distributions, par exemple des mesures comme des teneurs en calcium, des temps de cycle, une résistance à la traction ou des tailles de particules. L'outil prend toutes les valeurs de cette colonne et les teste simultanément par rapport à plusieurs distributions de probabilité pour déterminer laquelle décrit le mieux la forme et le comportement de vos données. Une seule colonne peut être sélectionnée à la fois, car chaque variable est évaluée indépendamment.
- P-Value to Select Best Fit : définit le seuil de signification utilisé pour déterminer quelles distributions offrent un ajustement acceptable à vos données. La valeur par défaut standard est 0.05: toute distribution dont la valeur p d'adéquation d'Anderson-Darling est supérieure à 0.05 est considérée comme un ajustement statistiquement acceptable, car il n'y a pas assez d'éléments pour rejeter cette distribution comme modèle de vos données. Comment interpréter la valeur p dans ce contexte :
- Valeur p > 0.05 : la distribution s'ajuste de façon acceptable aux données. Plus la valeur p est élevée, plus il est probable que la distribution convienne bien.
- Valeur p ≤ 0.05 : la distribution ne s'ajuste pas bien aux données et ne doit pas être utilisée pour l'analyse de capabilité ou une modélisation ultérieure.
- Lorsque plusieurs distributions donnent des valeurs p acceptables, choisissez celle ayant la valeur p la plus élevée comme candidate principale, mais combinez toujours cela avec un examen visuel de la droite de probabilité et demandez-vous si la distribution retenue a un sens physique pour votre procédé. Une distribution qui s'ajuste statistiquement mais n'a aucun fondement logique pour votre type de données doit être remise en question avant utilisation.
Questions fréquentes
Qu'est-ce que l'identification de la distribution individuelle ?
L'identification de la distribution individuelle ajuste simultanément plusieurs distributions de probabilité à vos données, dont Weibull, lognormale, exponentielle, logistique et gamma, et les classe selon leur capacité à décrire les données. Elle est essentielle pour l'analyse de capabilité sur des données non normales, car l'utilisation d'une mauvaise distribution produit des estimations inexactes de Pp, Ppk, Cp ou Cpk et des prévisions trompeuses du taux de défauts.
Quand utiliser l'identification de la distribution individuelle ?
Utilisez-la lorsque les données échouent à un test de normalité et que vous avez besoin de la bonne distribution avant l'analyse de capabilité, lorsque les données de procédé sont intrinsèquement asymétriques, comme des temps de cycle, des temps de défaillance, des concentrations chimiques ou des tailles de particules, et lorsqu'une transformation de Box-Cox n'est pas appropriée, par exemple parce que les données contiennent des zéros ou des valeurs négatives.
Comment choisir la distribution qui s'ajuste le mieux ?
Une distribution dont la valeur p d'Anderson-Darling est supérieure au seuil, 0.05 par défaut, est un ajustement acceptable ; à ce seuil ou en dessous, la distribution ne doit pas être utilisée. Lorsque plusieurs s'ajustent, retenez celle ayant la valeur p la plus élevée comme candidate principale, mais examinez aussi la droite de probabilité et vérifiez que la distribution a un sens physique pour le procédé.
De combien de points de données a-t-on besoin pour identifier une distribution ?
Recueillez au moins 50 à 100 points de données, car de petits échantillons ne fournissent pas assez d'informations pour distinguer les distributions. Les données doivent aussi provenir d'un procédé stable et maîtrisé, car l'ajustement de distributions à des données de procédé instable produit des résultats sans signification.