
Matrice de nuages de points (Matrix Plot)
Le Matrix Plot affiche les nuages de points de toutes les paires de deux variables numériques ou plus, ou une grille Y en fonction de X, avec des histogrammes facultatifs sur la diagonale et des groupes de couleurs. Il n'ajuste aucun modèle. Servez-vous-en pour trier les entrées et sorties d'un procédé avant une régression, repérer les variables qui portent la même information et détecter des grappes. L'interprétation guidée classe chaque X selon le R² ajusté comme prédicteur de la première variable.
Dernière révision
Point clé
Une matrice de nuages de points trace un nuage de points pour chaque paire de variables dans une seule grille, afin de voir d'un coup d'œil quelles variables évoluent ensemble, en sens inverse ou sans lien.
Sur cette page
Objectif
Le Matrix Plot trace un nuage de points pour chaque paire de variables dans une seule grille, afin de voir d'un coup d'œil quelles variables évoluent ensemble, lesquelles évoluent en sens inverse et lesquelles sont sans lien. Servez-vous-en pour trier plusieurs entrées et sorties d'un procédé avant une régression, pour trouver les variables qui portent la même information, ou pour repérer des grappes et des points inhabituels qu'un nuage de points unique laisserait passer.
Principales fonctionnalités
- Matrice de toutes les paires de deux variables numériques ou plus : un nuage de points pour chaque paire.
- Grille Y en fonction de X : une ligne par variable Y et une colonne par variable X, lorsque des variables X sont définies.
- Matrice complète, ou seulement la moitié inférieure gauche ou supérieure droite, pour supprimer les panneaux en double.
- Catégorie de couleur facultative, pour voir si des groupes (type de lot, fournisseur, équipe) se séparent.
- Interprétation guidée facultative : un Scatterplot Screener qui classe les autres variables selon la qualité avec laquelle chacune prédit la première.
Méthodes statistiques
Seules les lignes dont toutes les variables sélectionnées sont numériques sont utilisées, de sorte que chaque panneau montre le même ensemble d'observations. Le panneau de la ligne i et de la colonne j trace la variable i (verticale) en fonction de la variable j (horizontale). Le graphique n'ajuste rien lui-même ; une bande de points droite et étroite indique une forte relation linéaire, une forme en éventail indique une variation inégale, et des nuages séparés indiquent des grappes ou une stratification.
L'interprétation guidée prend la première variable sélectionnée comme Y et chacune des autres comme X (ou les variables X, lorsqu'elles sont définies). Pour chaque X, elle ajuste une droite et une parabole par les moindres carrés et ne conserve la parabole que si son terme quadratique est significatif au seuil de 5 %. Elle indique le R² ajusté du meilleur modèle comme Predictive Ability : la part de la variation de Y qu'explique X seul, corrigée du nombre de termes. Chaque X est jugé isolément ; lorsque les entrées sont corrélées entre elles, une régression multiple est nécessaire pour voir leur effet conjoint.
Champs de saisie et options
Champ | Description |
Variables (or Y variables) | Obligatoire. Deux colonnes numériques ou plus pour une matrice de toutes les paires. Si X variables est aussi défini, elles deviennent les lignes (variables Y) d'une grille Y en fonction de X. |
X variables (optional) | Facultatif. Construit une grille variables Y en fonction de variables X (lignes = Variables ci-dessus, colonnes = cette liste) au lieu d'une matrice de toutes les paires. |
Color-category column | Facultatif. Colore les points par groupe. Sélectionnez « -- » pour aucune catégorie. |
Matrix layout | Full matrix (default), Lower left only ou Upper right only. S'applique uniquement à la matrice de toutes les paires. |
Show histograms on the diagonal | Cochée par défaut : trace un histogramme de chaque variable dans les panneaux de la diagonale, avec un histogramme superposé par catégorie lorsqu'une Color-category column est définie ; décochez pour omettre les panneaux de la diagonale. |
Title | Titre du graphique. Par défaut « Matrix Plot ». |
Discrete color sequence | Palette de couleurs des catégories. Par défaut D3. |
Data Options: Subset (optional) | Exclude matching rows (default) ou Include only matching rows ; Row numbers (par ex. 3,7,12-15) et/ou une Condition (par ex. Batch_Type == "Premium") sélectionnent les lignes. |
Show guided interpretation | Ajoute un Predictive Ability Report, un Diagnostic Report et un Report Card (Scatterplot Screener pour la première variable). Désactivée par défaut. |
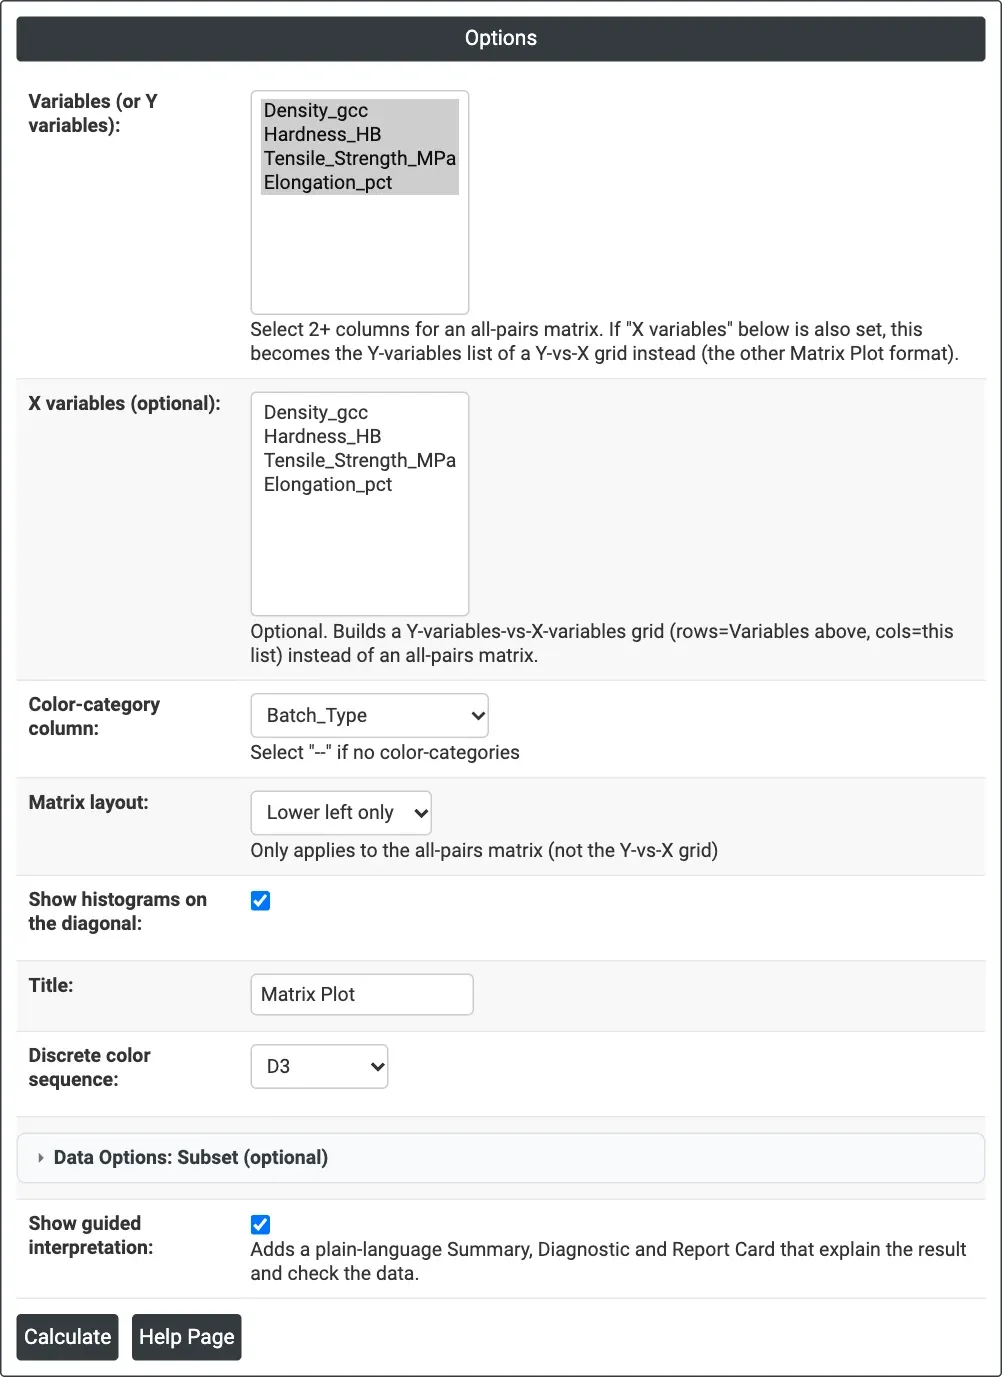
Figure 1 — Options de l'exemple : quatre propriétés de matériau colorées par Batch_Type, disposition en bas à gauche, histogrammes sur la diagonale, interprétation guidée activée.
Description des résultats
- Matrix Plot — la grille de nuages de points, avec un histogramme de chaque variable sur la diagonale lorsque cette option est cochée, colorée par catégorie avec une légende lorsqu'une catégorie est choisie ; survolez un point pour lire ses valeurs.
- Predictive Ability Report — diagramme en barres et tableau du meilleur modèle (Linear ou Quadratic) et de son R-sq(adj) % pour chaque X comme prédicteur de la première variable (interprétation guidée uniquement).
- Diagnostic Report — les configurations à rechercher dans chaque panneau (interprétation guidée uniquement).
- Report Card — vérifications sur les données inhabituelles, autres graphiques et suites à donner (interprétation guidée uniquement).
- Export PDF via Download.
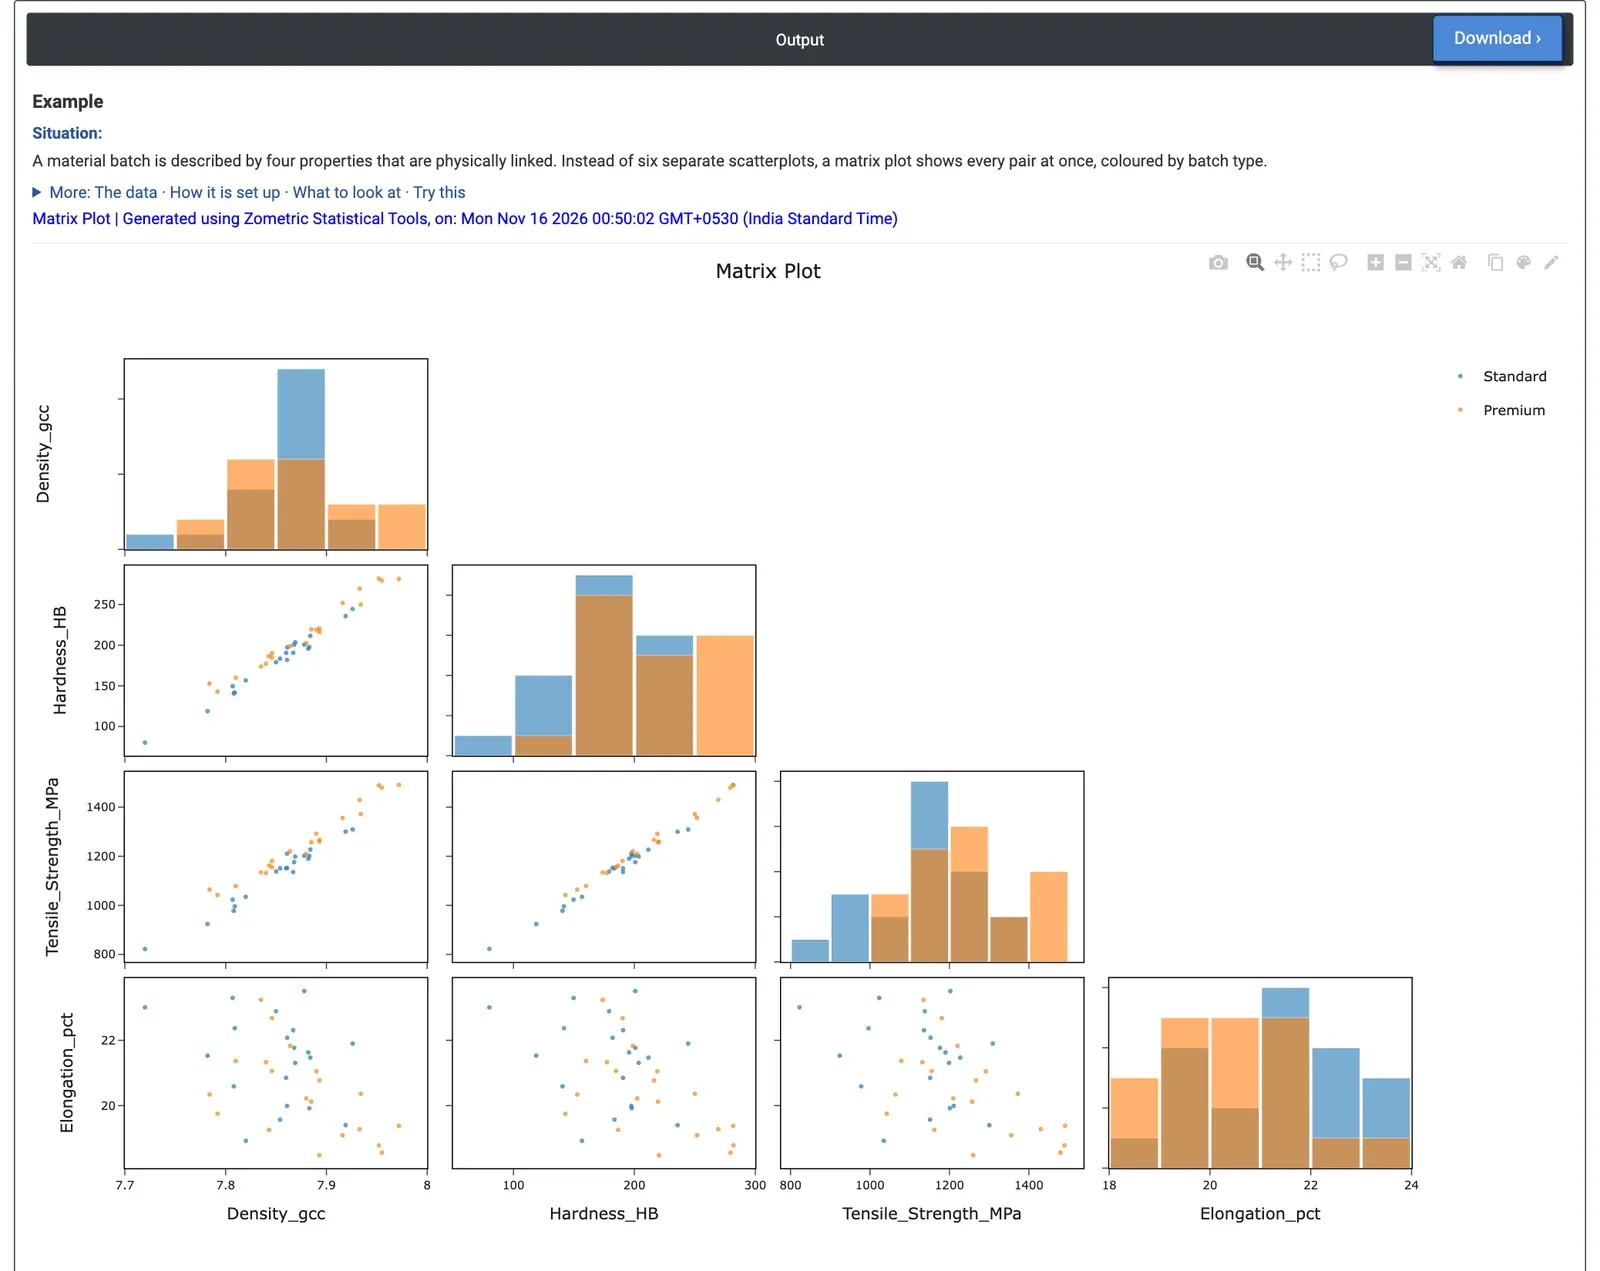
Figure 2 — Matrice inférieure gauche de la densité, de la dureté, de la résistance à la traction et de l'allongement pour 40 lots, Standard (bleu) et Premium (orange), avec l'histogramme de chaque propriété sur la diagonale.
Exemple résolu
Un métallurgiste dispose de quatre propriétés pour chacun de 40 lots de matériau (20 Standard, 20 Premium) : densité (g/cc), dureté (HB), résistance à la traction (MPa) et allongement (%). Au lieu de six nuages de points séparés, il sélectionne les quatre comme Variables, définit Color-category column = Batch_Type et Matrix layout = Lower left only, laisse Show histograms on the diagonal cochée et coche Show guided interpretation.
La densité, la dureté et la résistance à la traction augmentent ensemble en bandes droites et étroites : leurs corrélations vont de 0.97 à 0.99. L'allongement évolue en sens inverse, plus faiblement : les lots les plus résistants sont moins ductiles (corrélations d'environ −0.46 à −0.51). Les lots Premium se situent plus haut en dureté (moyenne de 212.9 contre 180.1 HB) et en résistance à la traction (1253.6 contre 1126.2 MPa), alors que leur densité diffère peu (7.878 contre 7.850 g/cc).
Le Predictive Ability Report, avec la densité comme Y, montre que la dureté (R-sq(adj) 96.4%) et la résistance à la traction (93.7%) prédisent chacune presque entièrement la densité par une droite, alors que l'allongement n'en explique que 18.8%. Pour l'équipe, cela signifie que la dureté, la résistance à la traction et la densité portent presque la même information : un essai de dureté rapide peut servir à trier les lots selon leur résistance, et l'allongement doit être mesuré séparément car il ne peut pas être bien déduit des autres.
Questions fréquentes
Quand utiliser une matrice de nuages de points ?
Utilisez une matrice de nuages de points pour trier plusieurs entrées et sorties d'un procédé avant une régression, trouver les variables qui portent la même information, ou repérer des grappes et des points inhabituels qu'un nuage de points unique laisserait passer. Elle remplace de nombreux nuages de points séparés par une seule grille ; quatre variables, par exemple, exigeraient sinon six nuages de points.
Comment lire une matrice de nuages de points ?
Chaque panneau trace une variable en fonction d'une autre. Une bande de points droite et étroite indique une forte relation linéaire, une forme en éventail indique une variation inégale, et des nuages séparés indiquent des grappes ou une stratification. Seules les lignes dont toutes les variables sélectionnées sont numériques sont utilisées, de sorte que chaque panneau montre les mêmes observations.
Qu'est-ce que le rapport Predictive Ability dans une matrice de nuages de points ?
Avec l'interprétation guidée, la première variable est Y et chaque autre variable est un X. Pour chaque X, une droite et une parabole sont ajustées, la parabole n'étant conservée que si son terme quadratique est significatif à 5 %. Le R² ajusté du meilleur modèle est indiqué comme Predictive Ability, la part de la variation de Y qu'explique X seul.
Quelle est la différence entre la matrice complète et la disposition inférieure gauche ?
La matrice complète montre chaque paire dans les deux sens, de sorte que chaque relation apparaît deux fois. La disposition inférieure gauche ou supérieure droite ne montre que la moitié de la matrice pour supprimer les panneaux en double. Les options de disposition ne s'appliquent qu'à la matrice de toutes les paires, pas à une grille Y en fonction de X.