
Capabilité du procédé à variables multiples
Multiple Variables Process Capability évalue deux colonnes ou plus, comme des empreintes, des machines ou des lignes, par rapport à une même LSL/USL et à une cible facultative. Servez-vous-en pour trouver le procédé le moins performant sans comparer des rapports distincts. Chaque variable est supposée normale, sans test de normalité par variable. Le résultat est un tableau comparatif unique avec N, Mean, StDev, Pp, Ppk, Cpm et PPM, plus un histogramme par variable.
Dernière révision
Point clé
Multiple Variables Process Capability compare plusieurs procédés parallèles, comme des empreintes de moule, des machines ou des lignes, à une même spécification dans un seul tableau Pp, Ppk et Cpm pour montrer lequel est le plus mauvais.
Sur cette page
Objectif
Multiple Variables Process Capability répond à une question précise et courante à laquelle les outils de capabilité existants de l'application ne pouvaient répondre qu'indirectement : lorsqu'une même caractéristique est mesurée sur plusieurs variables parallèles — différentes empreintes d'un moule d'injection, différentes machines, différentes lignes — par rapport à une spécification commune, laquelle est la pire ? Au lieu de lancer N rapports de capabilité distincts et de les comparer à l'œil, cet outil produit UN tableau comparatif unifié côte à côte et un seul jeu d'histogrammes, de sorte que les indices de la famille Cp/Cpk de chaque variable figurent dans le même tableau.
Principales fonctionnalités
- Sélectionnez au moins 2 colonnes et obtenez un tableau comparatif agrégé au lieu de N rapports empilés.
- Une seule paire LSL/USL est appliquée uniformément à chaque variable sélectionnée : la comparaison se fait donc toujours à armes égales, par rapport à la même spécification.
- Une cible commune facultative ajoute l'indice Cpm de chaque variable au même tableau comparatif.
- Histogrammes par variable avec les limites de spécification communes superposées, à côté du tableau agrégé.
- Multiplicateur de tolérance K-sigma configurable, cohérent avec les autres outils de capabilité de l'application.
Méthodes statistiques
Chaque variable/colonne sélectionnée est traitée comme un procédé indépendant, soumis au même moteur de capabilité normale que celui de la voie Normal de l'outil Automated Process Capability. Pour chacune, σ_overall est estimé par la méthode de l'étendue mobile (MRbar/d2, ou étendue mobile médiane), et la famille d'indices de performance standard fondés sur z est calculée : Pp = (USL − LSL) / (K·σ), Ppu = (USL − x̄) / ((K/2)·σ), Ppl = (x̄ − LSL) / ((K/2)·σ), Ppk = min(Ppu, Ppl), avec K = 6 par défaut. Chaque variable suppose toujours la normalité ici : cet outil ne comporte ni test de normalité par variable ni aiguillage vers une méthode non normale.
Lorsqu'une cible commune est fournie, Cpm est en outre calculé pour chaque variable : Cpm = (USL − LSL) / (K·√(mean((x − Target)²))), ce qui pénalise une variable dont la moyenne est décentrée par rapport à la cible, même si sa dispersion seule paraîtrait par ailleurs capable.
Comme chaque variable est évaluée par rapport aux mêmes LSL/USL (et à la même cible, lorsqu'elle est fournie), les valeurs de Ppk et de Cpm obtenues sont directement comparables d'une variable à l'autre : la variable ayant le Ppk (ou le Cpm) le plus bas dans le tableau comparatif est la moins performante par rapport à la spécification commune.
PPM Expected est calculé à partir de la probabilité de queue de la distribution normale ajustée au-delà de chaque limite de spécification pour cette variable ; PPM Observed est la fraction empirique de l'échantillon propre à cette variable qui tombe hors des limites de spécification — ce qui permet de repérer les cas où les deux divergent (signe que l'hypothèse de distribution normale peut ne pas tenir pour cette variable en particulier).
Champs de saisie et options
Champ | Description |
Process variables | Obligatoire. Sélectionnez au moins 2 colonnes à comparer — chaque colonne est traitée comme son propre procédé. |
LSL / USL | Appliquées à chaque variable sélectionnée. |
Target | Facultatif. Ajoute l'indice Cpm de chaque variable au tableau comparatif. |
Tolerance (K) | Multiplicateur appliqué à sigma pour former la bande de tolérance de capabilité ; 6 par défaut. |
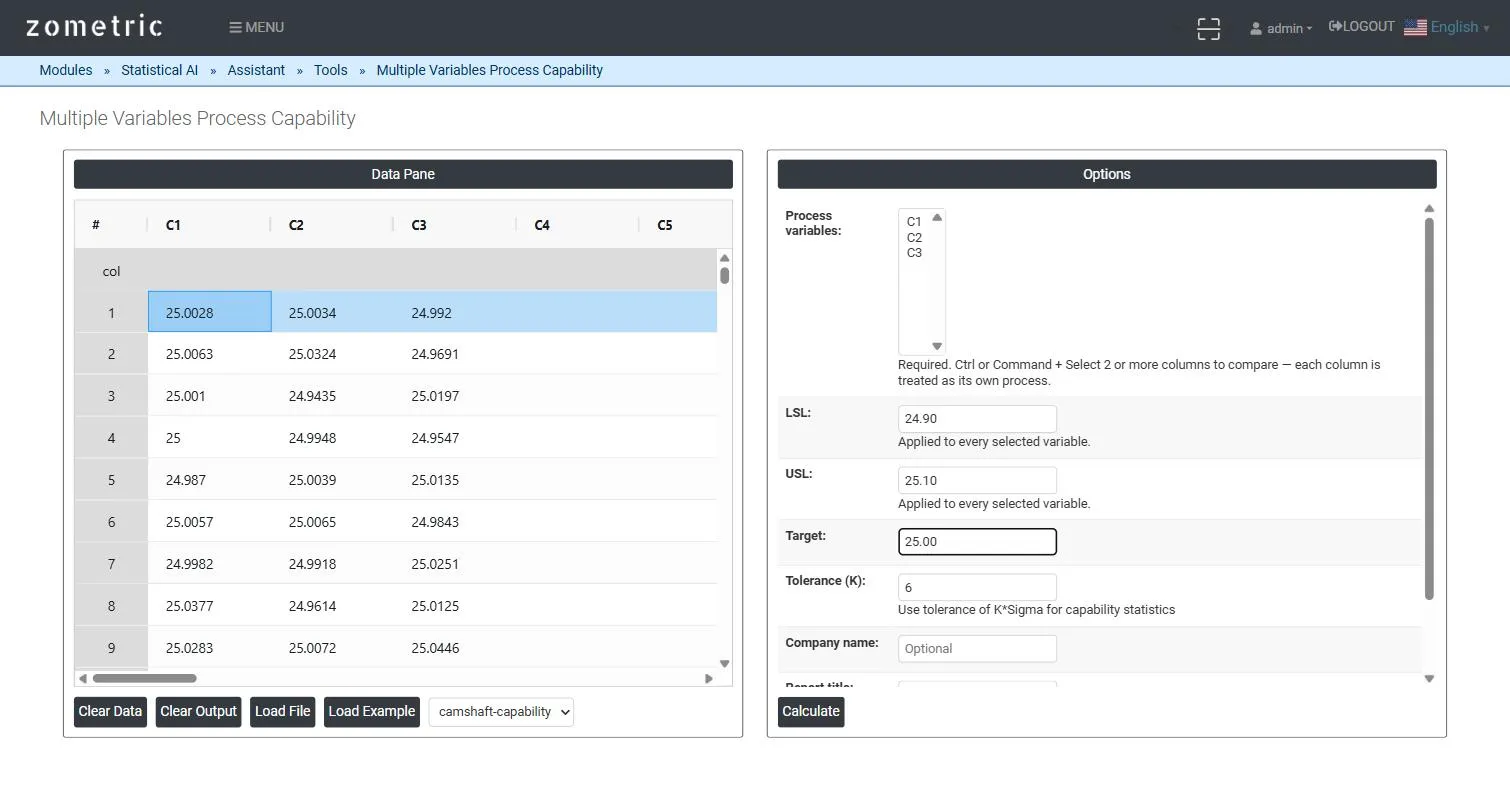
Figure 1 — Data Pane avec des relevés de diamètre d'alésage de 3 empreintes dans C1–C3, les trois étant sélectionnées comme Process variables, avec des LSL/USL/Target communes.
Description des résultats
- Tableau comparatif — une ligne par variable sélectionnée avec N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm (lorsque Target est fournie), PPM Expected et PPM Observed, le tout par rapport aux mêmes limites de spécification communes.
- Histogramme par variable — la distribution propre à chaque variable avec les lignes de référence LSL/Target/USL communes et une courbe normale ajustée.
- Export PDF du rapport comparatif complet via Download as PDF.
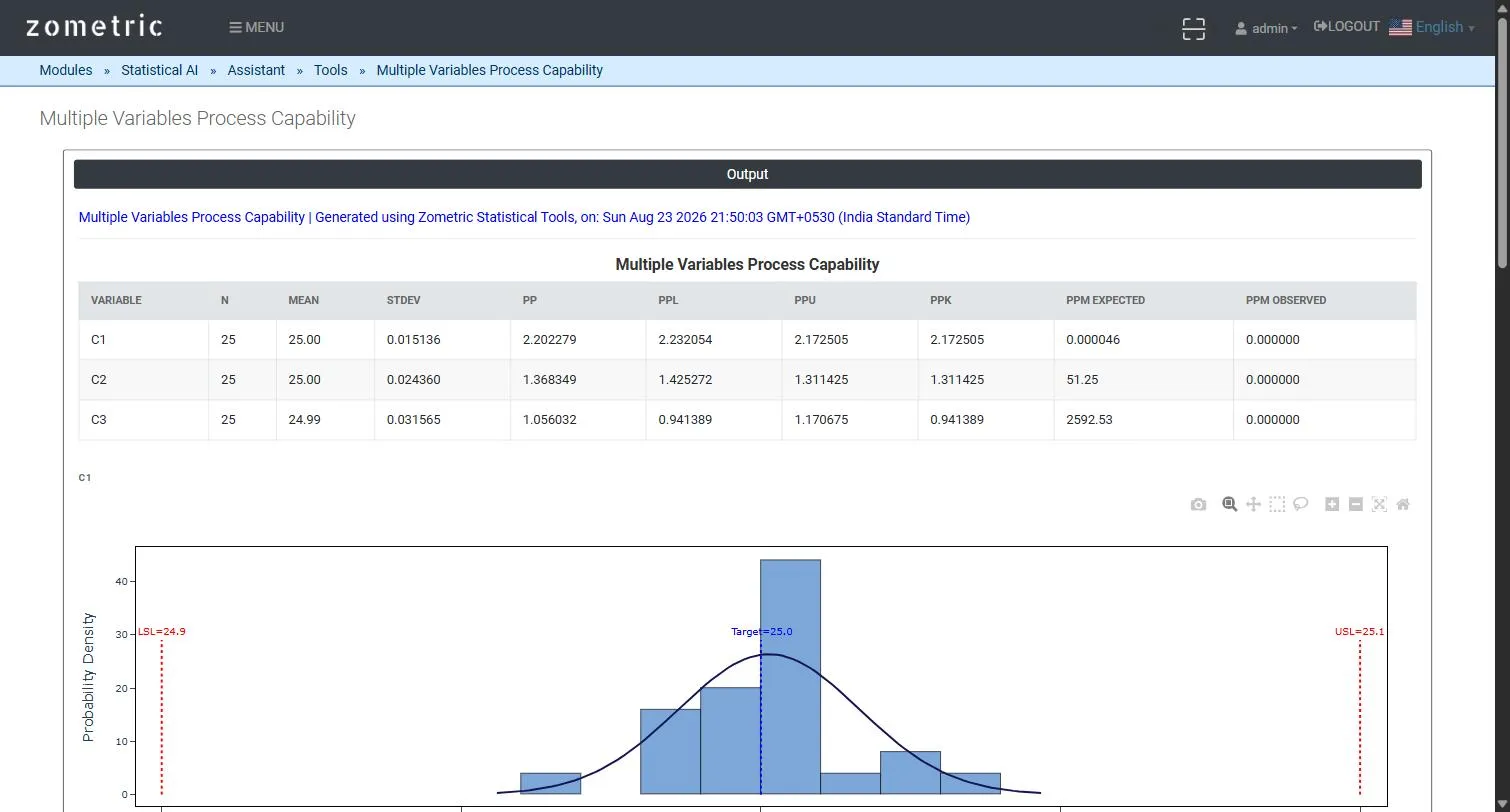
Figure 2 — Le tableau comparatif unifié (N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm, PPM Expected, PPM Observed par variable) avec l'histogramme de la première variable.
Exemple résolu
Un outillage de moulage par injection comporte 3 empreintes qui produisent la même pièce ; le diamètre d'alésage (mm) est mesuré sur 25 pièces de chaque empreinte (C1 = empreinte 1, C2 = empreinte 2, C3 = empreinte 3), par rapport à des LSL = 24.90, USL = 25.10 et Target = 25.00 communes. Le tableau comparatif montre l'empreinte 1 avec la dispersion la plus faible (Ppk ≈ 2.17, Cpm ≈ 2.24) et l'empreinte 3 nettement moins bonne (Ppk ≈ 0.94) — ce qui signale immédiatement l'empreinte 3 comme celle qui exige de l'attention, sans avoir à lancer puis comparer manuellement trois rapports distincts.
Questions fréquentes
Qu'est-ce que Multiple Variables Process Capability ?
C'est une analyse de capabilité qui compare une même caractéristique mesurée sur plusieurs variables parallèles, comme différentes empreintes de moule, machines ou lignes, par rapport à une spécification commune. Au lieu de rapports distincts, elle produit un tableau comparatif unique côte à côte des valeurs de Pp, Ppl, Ppu, Ppk, Cpm et PPM, ce qui permet d'identifier facilement la variable la moins performante.
Comment identifier le pire procédé dans une étude de capabilité à variables multiples ?
Comme chaque variable est évaluée par rapport aux mêmes LSL, USL et Target, les valeurs de Ppk et de Cpm sont directement comparables. La variable ayant le Ppk le plus bas, ou le Cpm le plus bas lorsqu'une Target est fournie, est la moins performante par rapport à la spécification commune et doit être examinée en premier.
Multiple Variables Process Capability suppose-t-il la normalité ?
Oui. Chaque variable est analysée par un calcul de capabilité normale et il n'y a ni test de normalité par variable ni aiguillage vers une méthode non normale. Comparer PPM Expected, issu de la queue de la distribution normale ajustée, à PPM Observed, la fraction réelle hors spécification, aide à repérer les variables pour lesquelles les deux divergent, signe que l'hypothèse de normalité peut ne pas tenir.
Qu'apporte Cpm à la comparaison ?
Lorsqu'une Target commune est fournie, Cpm est calculé pour chaque variable comme (USL - LSL) divisé par K fois la racine de l'écart quadratique moyen par rapport à la Target. Il pénalise une variable dont la moyenne est décentrée par rapport à la cible, même si sa dispersion seule paraîtrait par ailleurs capable.