
Capabilité du procédé à variables multiples (non normale)
Cet outil compare la capabilité de deux colonnes ou plus à une même spécification lorsque les données sont asymétriques, comme la taille de particules, la planéité ou les impuretés. Il ajuste à chaque colonne un modèle choisi parmi quinze, dont Weibull, Lognormal, Box-Cox et Johnson, selon la méthode Z-Score ou ISO. Chaque colonne exige au moins 4 valeurs. Les résultats sont un tableau de Pp, PPL, PPU, Ppk et PPM, plus des histogrammes.
Dernière révision
Point clé
Cet outil compare plusieurs procédés à une même spécification lorsque les données ne sont pas normales, en ajustant la même distribution à chacun et en listant Pp, Ppk et PPM côte à côte.
Sur cette page
Objectif
La capabilité du procédé à variables multiples (non normale) compare la capabilité de plusieurs procédés, lignes, machines ou empreintes à une même spécification lorsque les données ne suivent pas une distribution normale. Elle ajuste la même distribution à chaque colonne séparément et présente côte à côte, dans un seul tableau, Pp, PPL, PPU, Ppk ainsi que les parties par million hors spécification attendues et observées, avec un histogramme pour chaque colonne. Utilisez-la pour des caractéristiques asymétriques comme la taille de particules, la planéité, le faux-rond ou les impuretés, où un Ppk fondé sur la loi normale juge mal la queue de distribution, et lorsque vous voulez classer les procédés.
Fonctionnalités principales
- Deux colonnes ou plus, chacune traitée comme son propre procédé et ajustée indépendamment.
- Quinze modèles : Weibull, Exponential, Logistic, Loglogistic, Largest and Smallest Extreme Value, 2-Parameter Exponential, 3-Parameter Weibull, Gamma, Lognormal, 3-Parameter Lognormal, 3-Parameter LogLogistic, transformations de Box-Cox et de Johnson, et une Mixed Distribution (ISO 22514-2).
- Méthode Z-Score ou méthode des percentiles ISO pour les indices.
- Spécifications unilatérales ou bilatérales appliquées à chaque colonne.
- Tableau comparatif avec Pp, PPL, PPU, Ppk, PPM Expected et PPM Observed, et un histogramme de chaque colonne avec les limites de spécification et la courbe ajustée.
Méthodes statistiques
Pour chaque colonne, la distribution choisie est ajustée par maximum de vraisemblance (Weibull, Gamma et Exponential avec le seuil fixé à 0 ; les modèles à 3 paramètres l'estiment). Lognormal utilise la moyenne et l'écart-type des données logarithmiques. Box-Cox et Johnson transforment les données en données normales et travaillent sur l'échelle transformée ; la Mixed Distribution ajuste un mélange de distributions normales, dont le nombre de composantes est choisi par le BIC sauf s'il est fixé. Chaque colonne exige au moins 4 valeurs.
Méthode Z-Score (par défaut) : les probabilités ajustées au-delà de chaque limite sont transformées en scores normaux, Z_USL = Φ⁻¹(F(USL)) et Z_LSL = Φ⁻¹(F(LSL)), où F est la fonction de répartition ajustée. Ensuite PPU = Z_USL / 3, PPL = −Z_LSL / 3, Pp = (Z_USL − Z_LSL) / 6 et Ppk = min(PPL, PPU). Méthode ISO : les indices utilisent les percentiles ajustés X₀.₁₃₅, X₅₀ et X₉₉.₈₆₅ (les points qui couvrent la même part ±3σ qu'une loi normale) : Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅), PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅), PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀). Avec une seule limite, Pp n'est pas donné et Ppk est l'indice unilatéral.
PPM Expected est la part ajustée de la population au-delà des limites, multipliée par 1,000,000 ; PPM Observed est la part des valeurs de l'échantillon au-delà de celles-ci. Ce sont des indices globaux (long terme) calculés à partir de toutes les données. Ils ne valent que ce que vaut la distribution : le même modèle est appliqué à chaque colonne ; vérifiez donc l'ajustement de chacune (par exemple avec Individual Distribution Identification) avant de comparer les colonnes.
Champs de saisie et options
Champ | Description |
Process variables | Obligatoire. Deux colonnes numériques ou plus à comparer ; chacune est ajustée séparément. |
Fit distribution | Obligatoire. L'un des quinze modèles listés ci-dessus (Weibull par défaut), appliqué à chaque colonne. |
Mixture components | Uniquement pour Mixed Distribution (ISO 22514-2) : Auto (choisi par le BIC, par défaut) ou 2 à 6 composantes. |
Method of analysis | Z-Score (par défaut) ou ISO. |
LSL / USL | Limites de spécification appliquées à chaque colonne ; au moins une est requise, et LSL doit être inférieure à USL. |
Company name / Report title | Texte facultatif pour le rapport ; titre par défaut Multiple Variables Process Capability (Nonnormal). |
Data Options: Subset (optional) | Exclude matching rows (par défaut) ou Include only matching rows, par numéros de ligne (par exemple 3,7,12-15) et/ou par une condition. |
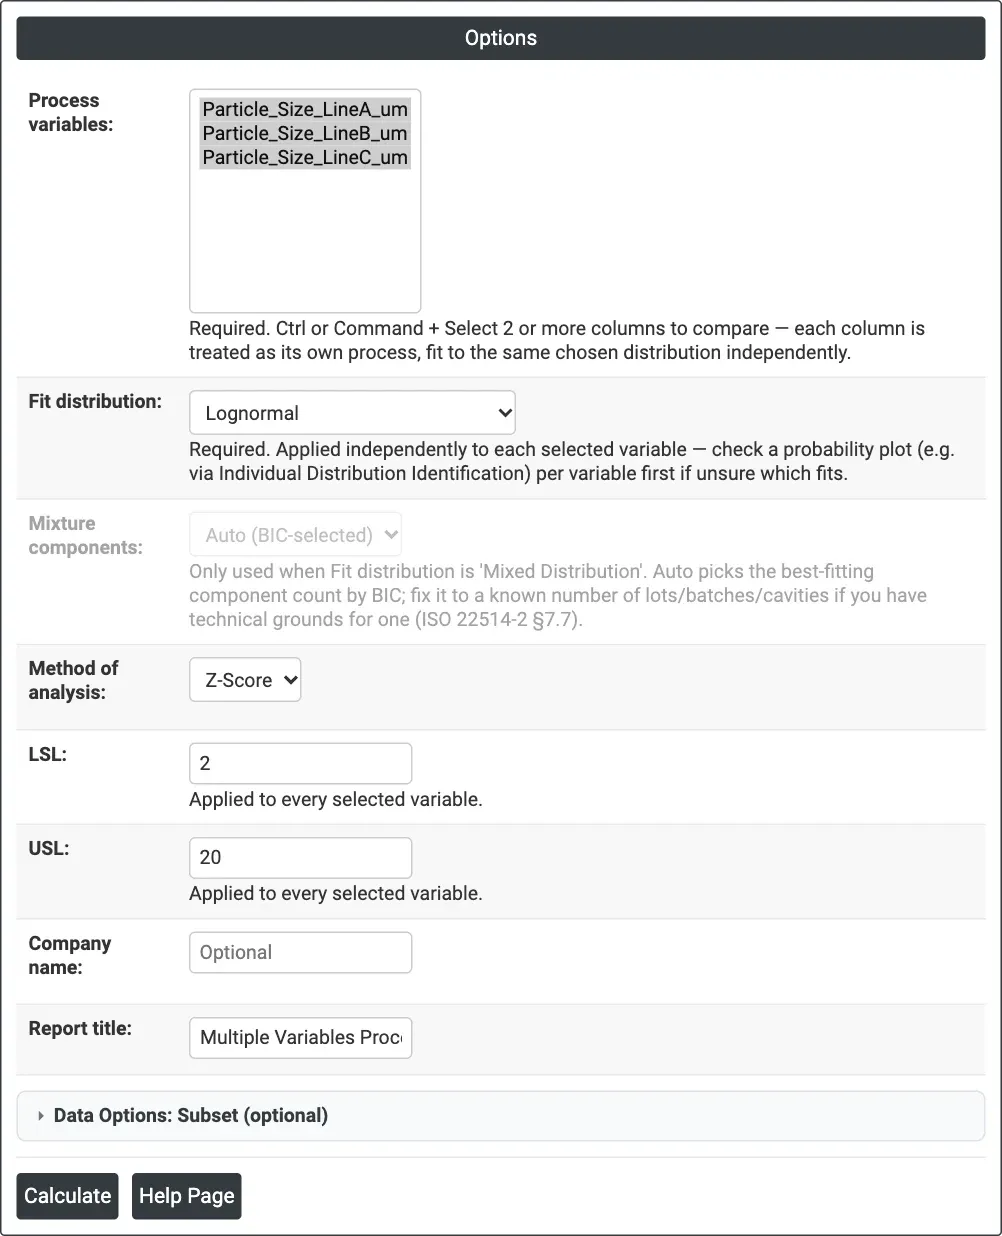
Figure 1 — Options pour l'exemple : taille de particules de trois lignes, Lognormal, méthode Z-Score, LSL 2 µm et USL 20 µm.
Description des résultats
- Multiple Variables Process Capability (Nonnormal) — une ligne par colonne : Variable, N, Distribution, Pp, PPL, PPU, Ppk, PPM Expected et PPM Observed.
- Histogram of <distribution> Distribution — un par colonne, sous le nom de la colonne, avec LSL et USL et la courbe de densité ajustée.
- Export PDF via Download.
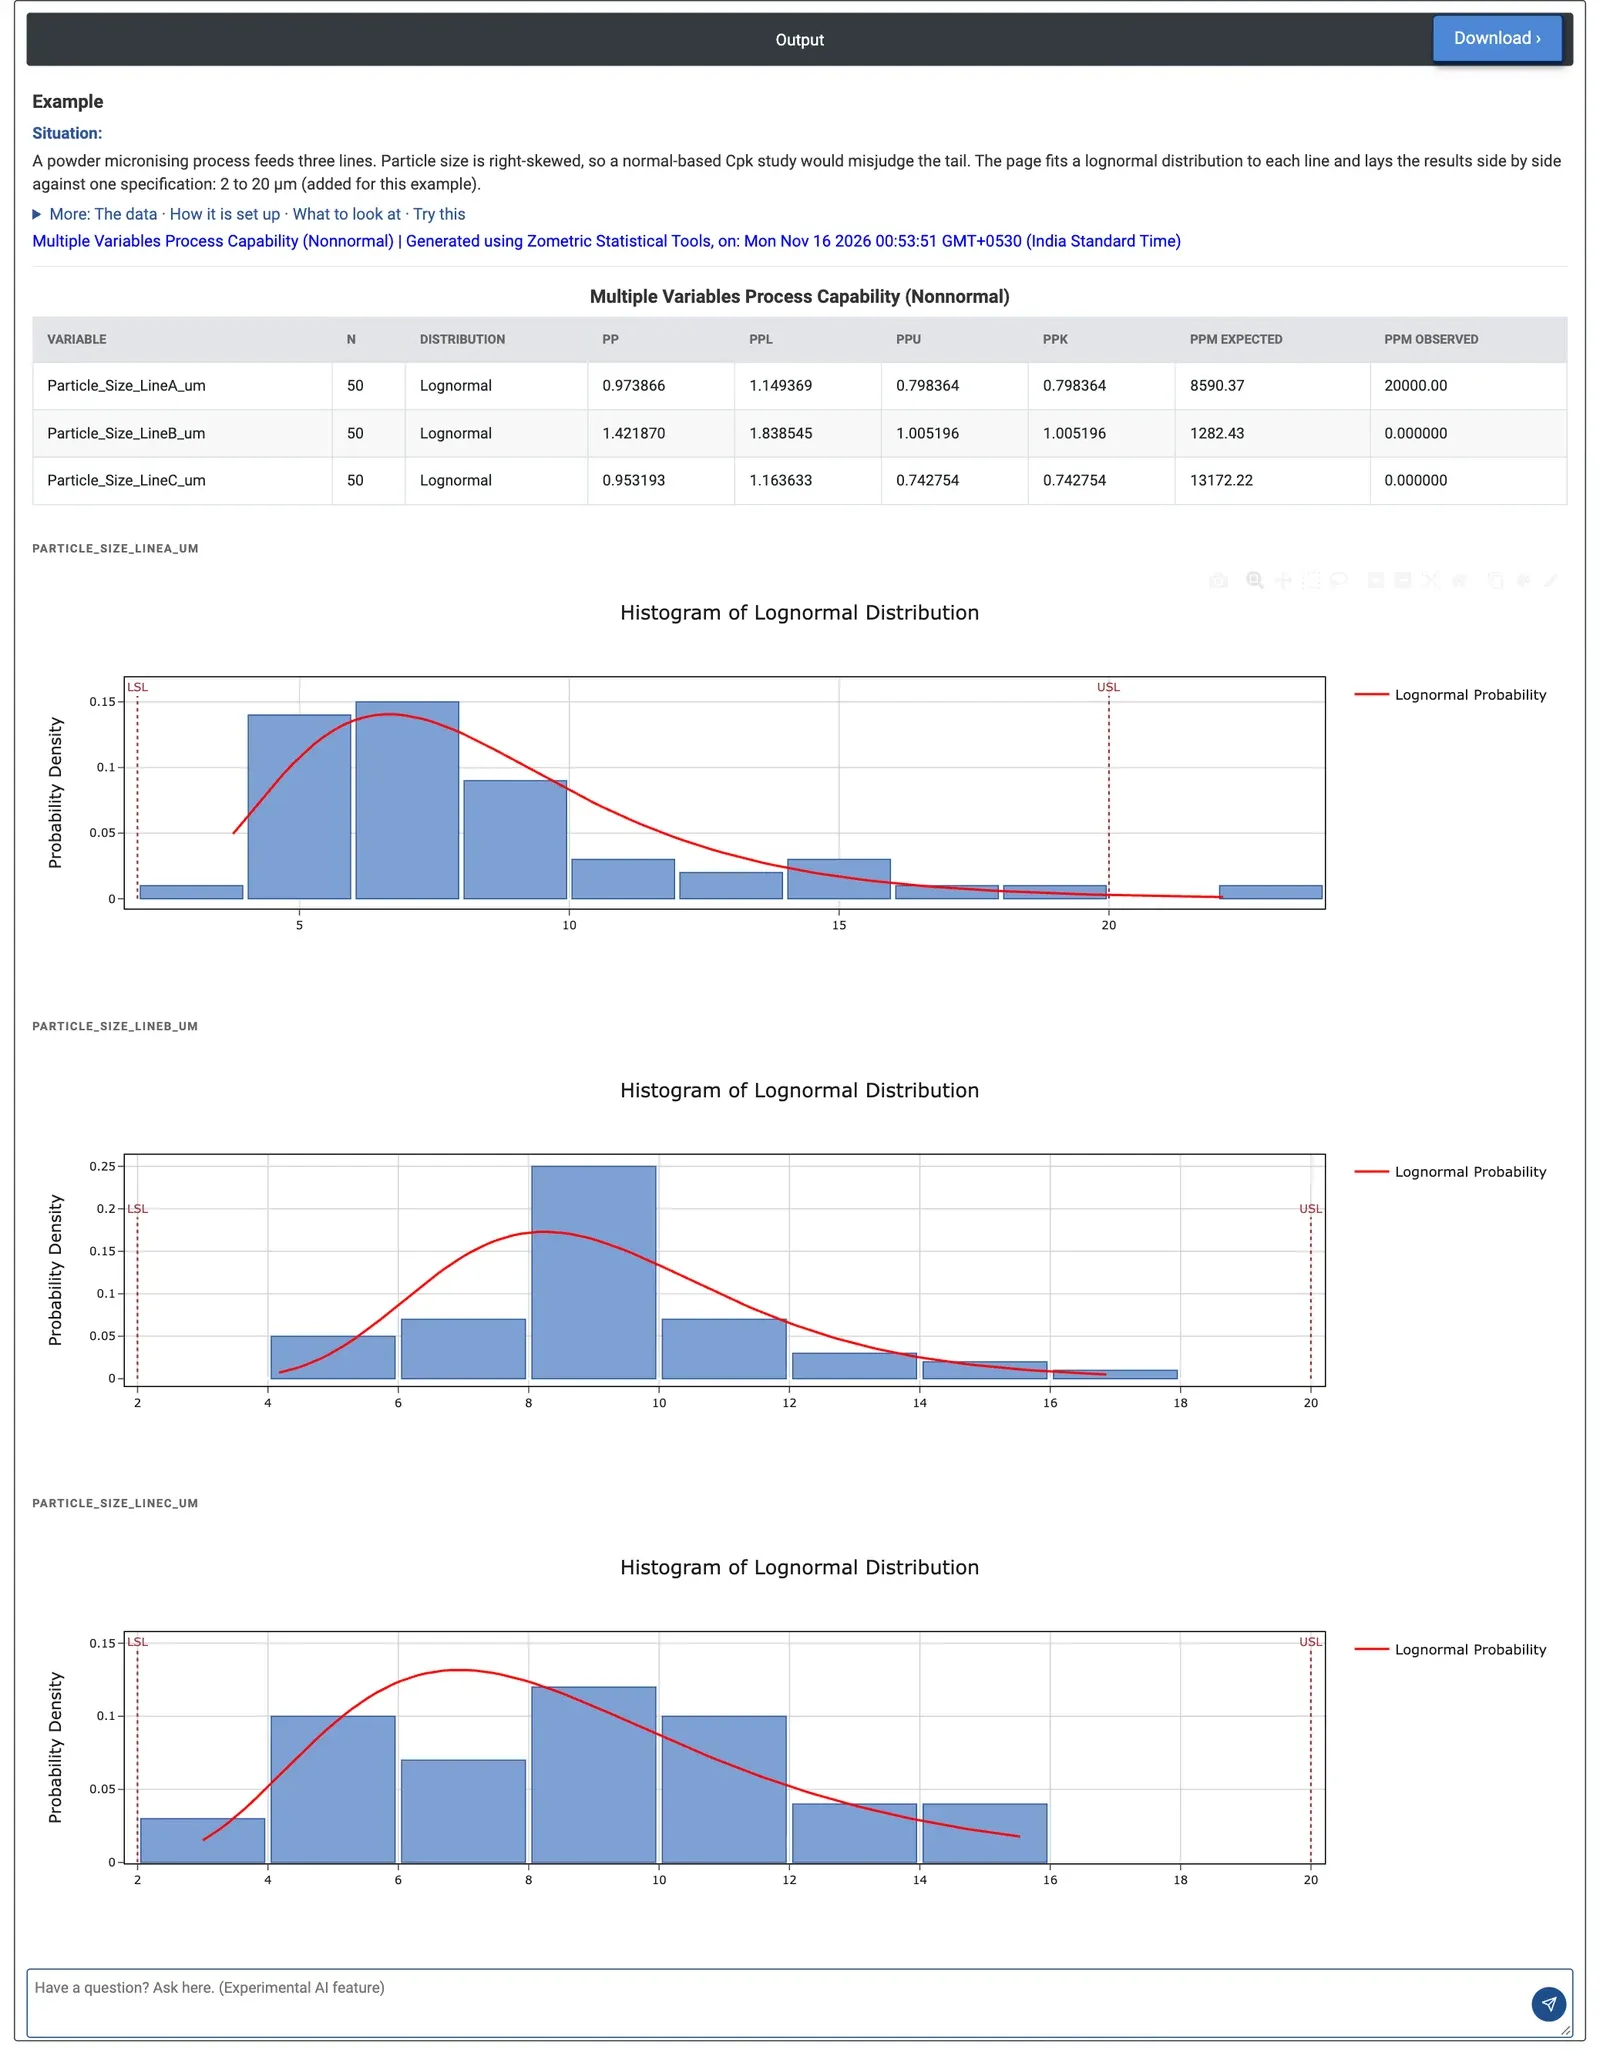
Figure 2 — Tableau comparatif et histogrammes lognormaux des trois lignes : Ppk 0.798 pour la ligne A, 1.005 pour la ligne B et 0.743 pour la ligne C, avec PPU inférieur à PPL sur chaque ligne ; seule la ligne A a un échantillon au-dessus de la USL.
Exemple résolu
Un procédé de micronisation de poudre alimente trois lignes, et la taille de particules est asymétrique à droite (médiane d'environ 7 à 9 µm, avec une longue queue vers les grosses particules). L'ingénieur procédés veut comparer les lignes à une spécification de 2 à 20 µm à partir de 50 échantillons par ligne. Process variables = Particle_Size_LineA_um, Particle_Size_LineB_um et Particle_Size_LineC_um, Fit distribution = Lognormal, Method of analysis = Z-Score, LSL = 2, USL = 20.
La ligne A a un Ppk de 0.798 et 8,590 PPM attendus hors spécification ; un échantillon (22.11 µm) dépasse déjà 20 µm, donc 20,000 PPM sont observés. La ligne B est la meilleure, avec un Ppk de 1.005 et 1,282 PPM attendus, mais encore sous la cible habituelle de 1.33. La ligne C est la plus risquée, avec un Ppk de 0.743 et 13,172 PPM attendus. Sur chaque ligne, PPU est inférieur à PPL : le risque vient des grosses particules supérieures à 20 µm, et non des fines inférieures à 2 µm ; les travaux d'amélioration doivent donc cibler la queue grossière, en commençant par la ligne C. Les histogrammes montrent la même image : chaque courbe ajustée a sa longue queue vers la USL, et sur la ligne A une barre se situe au-delà.
Le modèle compte. Avec la méthode ISO, les valeurs de Ppk tombent à 0.694, 1.008 et 0.619, avec le même classement. Avec un ajustement de Weibull, PPL devient l'indice le plus bas sur chaque ligne et le classement change (Ppk 0.641, 0.948 et 0.798, la ligne A étant désormais la pire). Les statistiques d'Anderson-Darling calculées séparément de cette page favorisent la loi lognormale pour les lignes A et B (0.79 contre 2.17, et 0.63 contre 1.34) mais la loi de Weibull pour la ligne C (0.20 contre 0.55) ; il faut donc vérifier les lignes une à une avant d'utiliser le classement pour des décisions.
Questions fréquentes
Quand utiliser l'analyse de capabilité non normale pour plusieurs variables ?
Utilisez-la pour comparer et classer la capabilité de plusieurs procédés, lignes, machines ou empreintes par rapport à une même spécification lorsque les données ne suivent pas une distribution normale. Des exemples typiques sont les caractéristiques asymétriques comme la taille de particules, la planéité, le faux-rond ou les impuretés, où un Ppk fondé sur la loi normale juge mal la queue de la distribution.
Quelle est la différence entre les méthodes Z-Score et ISO ?
La méthode Z-Score convertit les probabilités ajustées au-delà de chaque limite en scores normaux et divise par 3 pour donner PPU et PPL. La méthode ISO utilise les percentiles ajustés à 0.135 %, 50 % et 99.865 % à la place de l'étendue normale de plus ou moins 3 sigma. Les deux peuvent donner des valeurs de Ppk différentes, comme le montre l'exemple résolu, bien que le classement puisse rester le même.
Pourquoi le choix de la distribution compte-t-il en capabilité non normale ?
Les indices ne valent que ce que vaut la distribution ajustée, et le même modèle est appliqué à chaque colonne. Dans l'exemple résolu, passer de Lognormal à Weibull a changé l'indice le plus bas et le classement des lignes. Vérifiez l'ajustement de chaque colonne, par exemple avec Individual Distribution Identification, avant de les comparer.
Quelle est la différence entre PPM Expected et PPM Observed ?
PPM Expected est la part de la distribution ajustée située au-delà des limites de spécification, multipliée par 1,000,000. PPM Observed est la part des valeurs réelles de l'échantillon au-delà des limites. Les deux sont des mesures globales, à long terme, calculées à partir de toutes les données de chaque colonne.