
Régression logistique nominale
La régression logistique nominale est un outil statistique servant à analyser la relation entre une ou plusieurs variables prédictives et une variable de réponse catégorielle à trois catégories non ordonnées ou plus, comme rayure, bosse ou déchirure. Elle prédit la probabilité d'apparition de chaque catégorie à partir des valeurs des prédicteurs.
Dernière révision
Point clé
La régression logistique nominale est un outil statistique servant à analyser la relation entre une ou plusieurs variables prédictives et une variable de réponse catégorielle à trois catégories non ordonnées ou plus.
Sur cette page
- Qu'est-ce que la régression logistique nominale ?
- Quand utiliser la régression logistique nominale ?
- Recommandations pour bien utiliser la régression logistique nominale
- Alternatives : quand ne pas utiliser la régression logistique nominale
- Exemple de régression logistique nominale
- Comment utiliser la régression logistique nominale
Qu'est-ce que la régression logistique nominale ?
La régression logistique nominale est un outil statistique servant à analyser la relation entre une ou plusieurs variables prédictives et une variable de réponse catégorielle à trois catégories non ordonnées ou plus — comme rayure, bosse ou déchirure. Elle prédit la probabilité d'apparition de chaque catégorie à partir des valeurs des prédicteurs.
Quand utiliser la régression logistique nominale ?
Variables prédictives
- Les prédicteurs peuvent être continus, catégoriels, ou un mélange des deux
- Les variables discrètes peuvent être traitées comme continues ou catégorielles selon le nombre de niveaux et l'objectif de l'analyse
- Un seul prédicteur continu avec une réponse continue → utilisez la droite d'ajustement
- Plusieurs prédicteurs avec une réponse continue → utilisez l' ajustement d'un modèle de régression
Variable de réponse
- La réponse doit avoir trois catégories ou plus sans ordre naturel (p. ex. couleur, type de matériau, type de défaut)
- Si la réponse est continue → utilisez l' ajustement d'un modèle de régression
- Si la réponse a deux catégories (conforme/non conforme) → utilisez la régression logistique binaire
- Si la réponse a des catégories ordonnées (faible/moyen/élevé) → utilisez la régression logistique ordinale
Recommandations pour bien utiliser la régression logistique nominale
- La variable de réponse doit avoir trois catégories non ordonnées ou plus; si les catégories ont un ordre naturel, utilisez plutôt la régression logistique ordinale.
- Les prédicteurs peuvent être continus ou catégoriels; assurez-vous que chaque variable est correctement classée avant de lancer l'analyse.
- Assurez-vous que les données représentent fidèlement la population cible; des données biaisées ou incomplètes produiront des prédictions peu fiables.
- Collectez suffisamment de points de données par catégorie : trop peu d'observations dans une catégorie rend le modèle instable et les prédictions peu dignes de confiance.
- Mesurez toutes les variables aussi précisément que possible; les erreurs dans les données d'entrée réduisent directement la précision des probabilités prédites.
- Enregistrez les données dans l'ordre où elles sont collectées pour aider à repérer d'éventuels motifs temporels susceptibles d'affecter les résultats.
- Après l'ajustement, validez le modèle à l'aide de statistiques d'adéquation et de diagnostics des résidus; un modèle mal ajusté produit des prédictions de catégories trompeuses.
- Vérifiez qu' aucune catégorie n'a trop peu d'observations : les catégories rares réduisent la fiabilité du modèle et peuvent causer des problèmes d'estimation.
Alternatives : quand ne pas utiliser la régression logistique nominale
- Si la variable de réponse est continue, utilisez plutôt l' ajustement d'un modèle de régression .
- Si vous n'avez qu' un seul prédicteur continu avec une réponse continue, utilisez plutôt la droite d'ajustement .
- Si la réponse a deux catégories (p. ex. conforme/non conforme), utilisez plutôt la régression logistique binaire .
- Si les catégories de réponse ont un ordre naturel (p. ex. faible/moyen/élevé), utilisez plutôt la régression logistique ordinale .
- Si vous avez un seul prédicteur catégoriel avec une réponse continue, utilisez plutôt l' ANOVA à un facteur .
Exemple de régression logistique nominale
Pour évaluer l'efficacité de différentes méthodes d'enseignement, un administrateur scolaire recueille les données de 30 élèves, en notant la matière préférée de chaque élève ainsi que la méthode d'enseignement utilisée dans sa classe. Comme la variable de réponse, la matière préférée (mathématiques, sciences ou lettres), est catégorielle sans ordre inhérent, l'administrateur applique une régression logistique nominale. Cette analyse aide à explorer comment l'âge des élèves (de 10 à 13 ans) et le type de méthode d'enseignement (démonstration ou explication) sont associés à leurs préférences de matière. Les étapes sont les suivantes :
- Les données nécessaires ont été rassemblées.
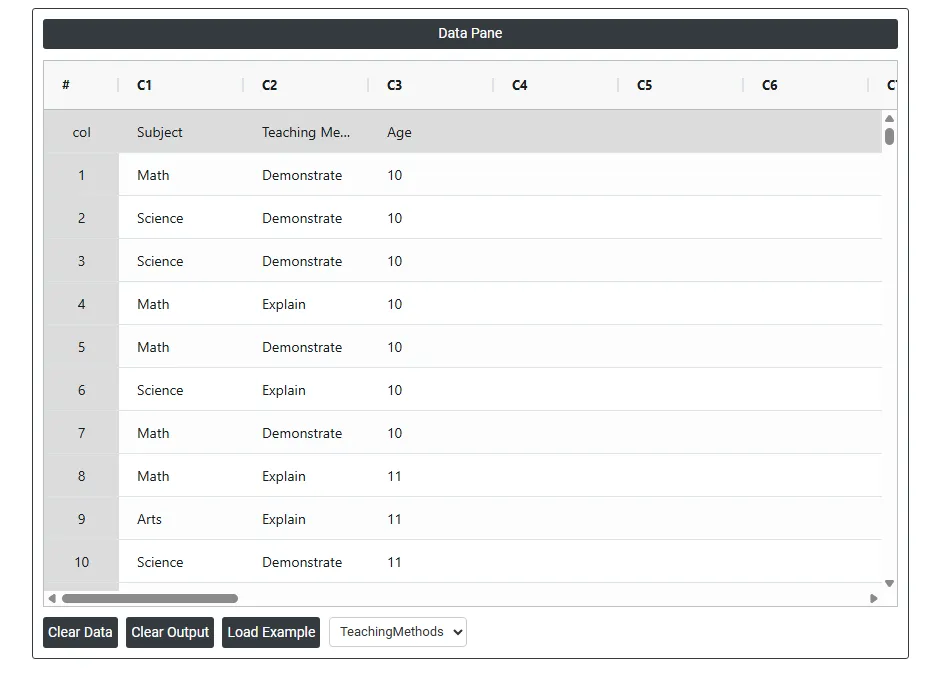
- Analysez maintenant les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver Nominal Logistic Regression, choisissez Statistical module> Regression>Nominal Logistic Regression.
- Dans l'outil, saisissez les données ainsi que les autres paramètres comme suit :
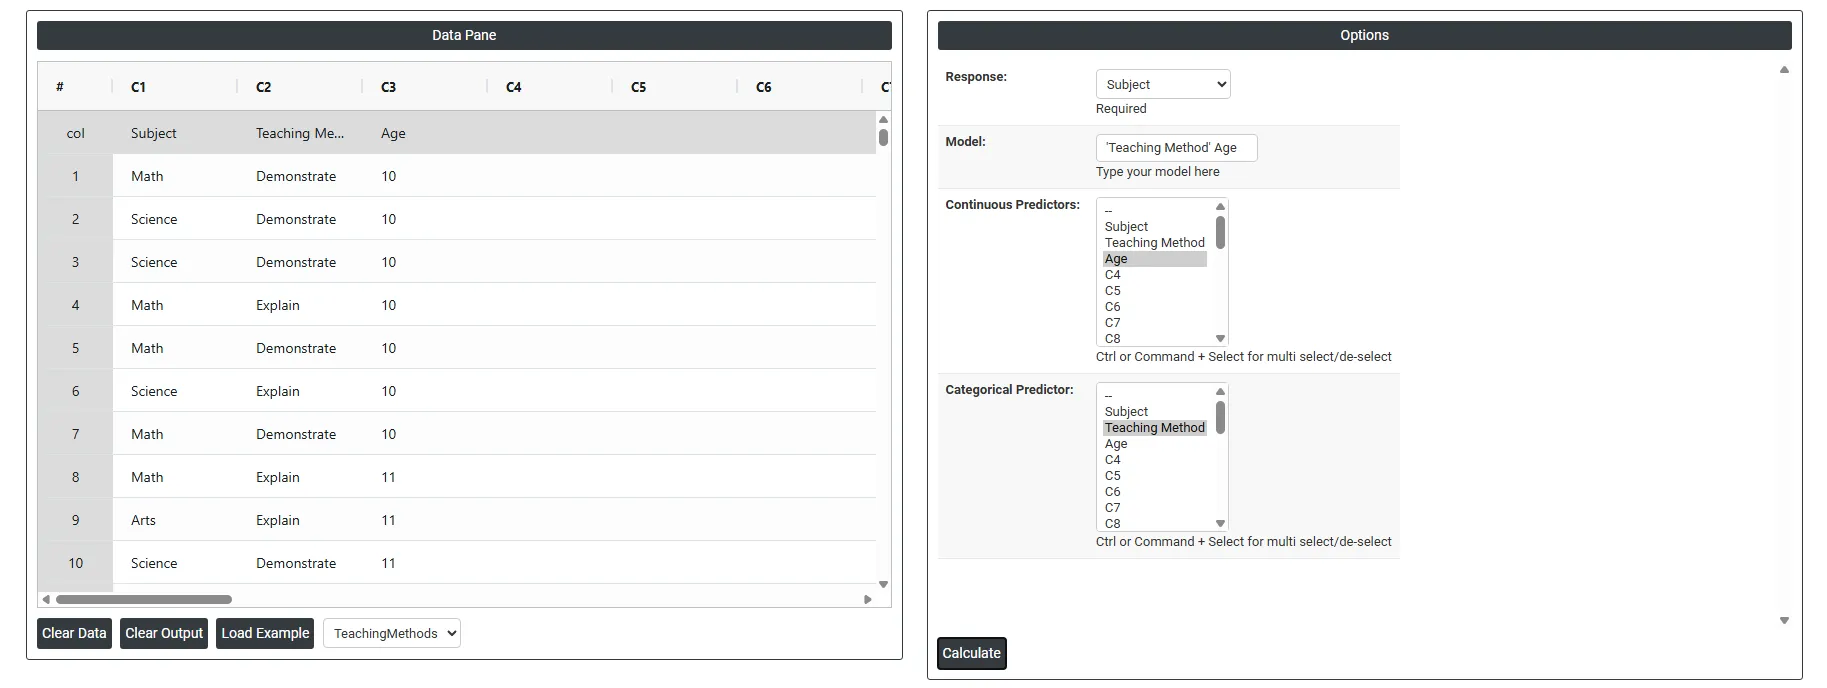
5. Après avoir utilisé l'outil ci-dessus, obtenez les résultats comme suit :
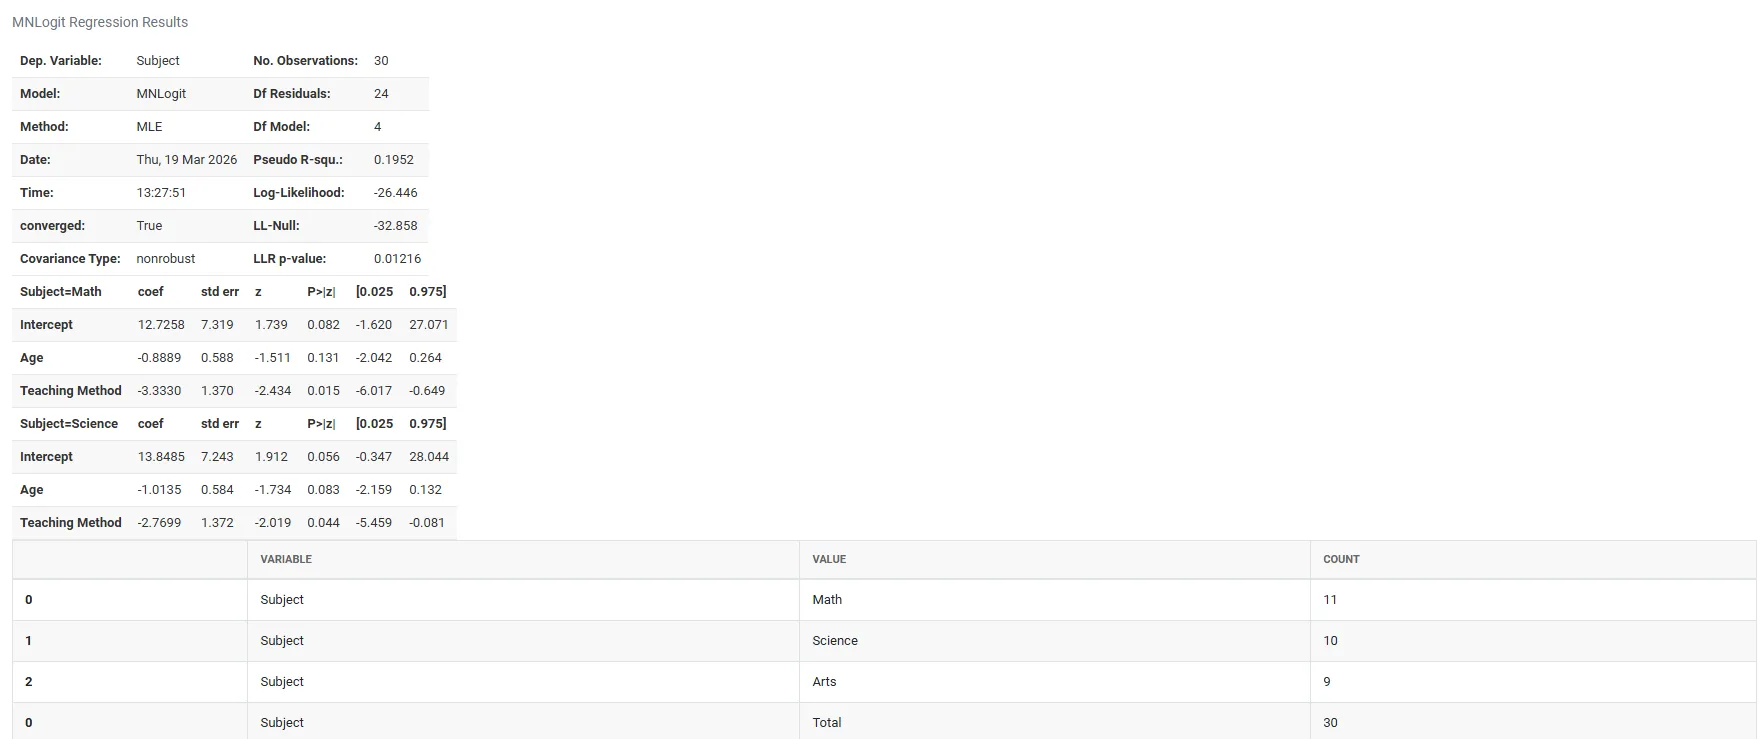
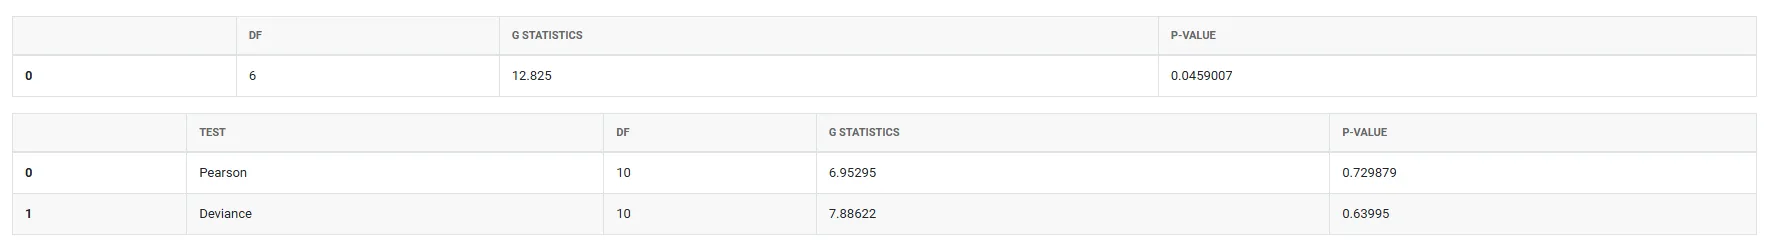
Comment utiliser la régression logistique nominale
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Regression > Nominal Logistic Regression.
- Ensuite, mettez à jour les données manuellement, ou copiez-les (Ctrl+C) depuis une feuille Excel et collez-les (Ctrl+V), ou encore utilisez l'option Load Example pour charger les données d'exemple.
- Ensuite, vous devez renseigner les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Sur le tableau de bord de Nominal Logistic Regression, la fenêtre est divisée en deux parties.
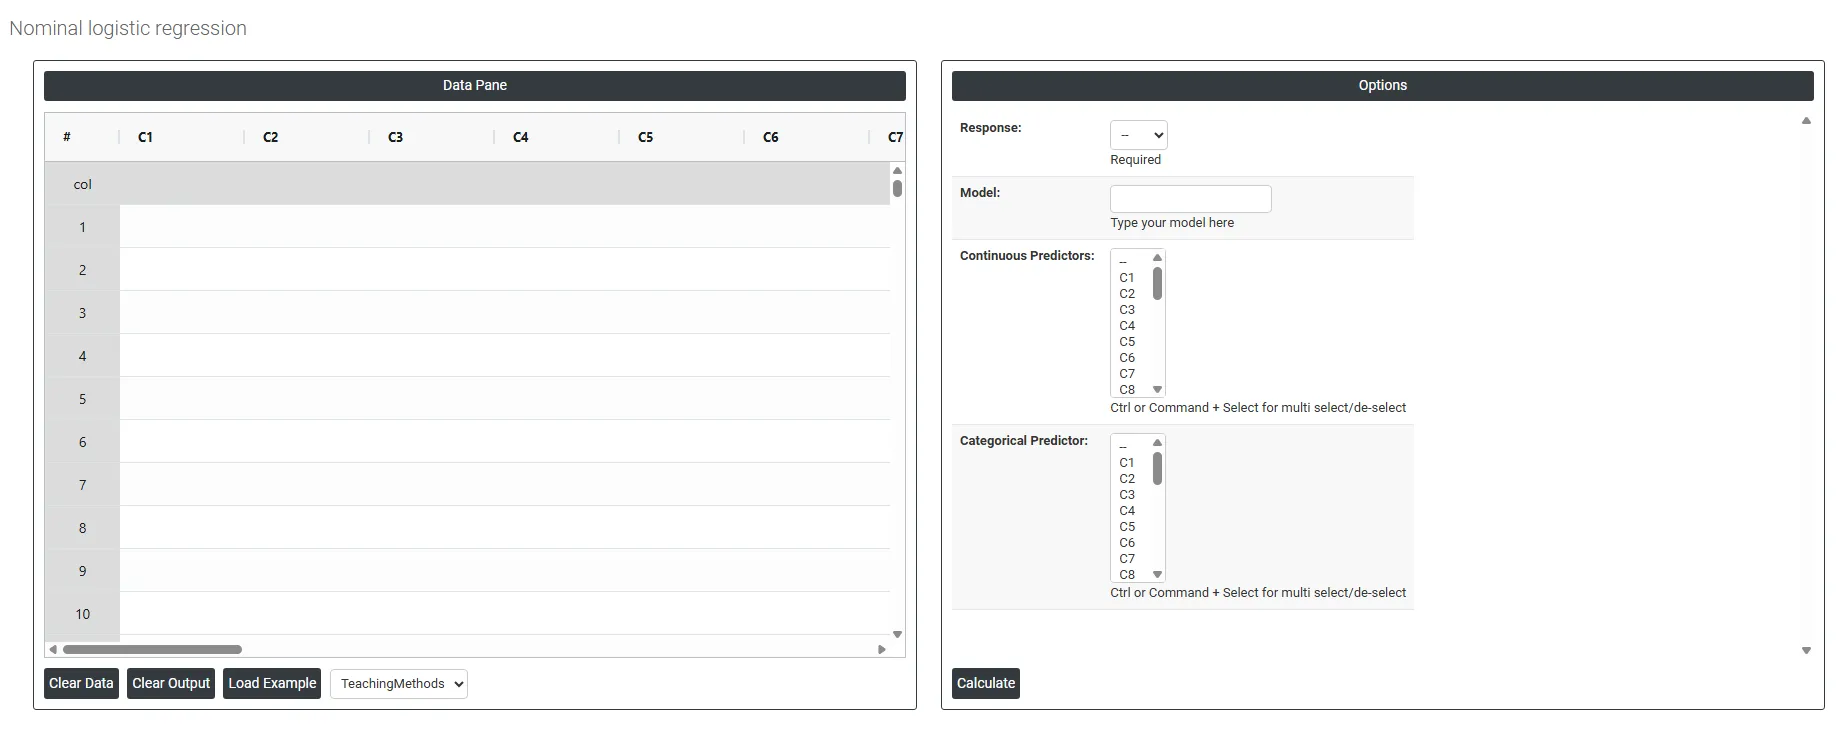
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement, ou copiées (Ctrl+C) depuis une feuille Excel puis collées (Ctrl+V) ici.
Load example :des données d'exemple sont chargées.
Load File: permet de charger directement les données Excel.
Dans la partie droite, de nombreuses options sont disponibles :
- Response : la variable de résultat que vous essayez de prédire ou de classer ; elle doit contenir trois catégories ou plus sans ordre naturel, comme le type de défaut (rayure, bosse, déchirure) ou le mode de paiement (espèces, carte, en ligne). Le modèle estime la probabilité d'apparition de chaque catégorie à partir des valeurs de prédicteurs fournies.
- Categorical Predictor : une variable prédictive qui contient un ensemble fixe de groupes ou d'étiquettes distincts, comme le type de machine, l'équipe ou le matériau. Ces groupes n'ont pas de distance mesurable entre eux. Chaque catégorie est traitée comme un niveau distinct et le modèle estime comment chaque groupe influence la probabilité de chaque catégorie de réponse.
- Continuous Predictor : une variable prédictive qui peut prendre n'importe quelle valeur numérique mesurable dans une plage, comme la température, la pression ou le temps. Le modèle utilise ces valeurs pour estimer comment une augmentation d'une unité du prédicteur déplace la probabilité que la réponse tombe dans chaque catégorie.
- Model : définit quels prédicteurs et quels termes d'interaction sont inclus dans l'analyse. Par défaut, l'analyse construit un modèle à effets principaux avec tous les prédicteurs sélectionnés. Vous pouvez le personnaliser pour inclure des termes d'interaction (p. ex. A*B) si vous pensez que deux prédicteurs influencent conjointement la réponse. Choisir la bonne structure de modèle est important : inclure des termes inutiles ajoute du bruit, tandis que l'omission de termes clés conduit à des prédictions inexactes.
Questions fréquentes
Qu'est-ce que la régression logistique nominale ?
La régression logistique nominale analyse la relation entre une ou plusieurs variables prédictives et une réponse catégorielle à trois catégories non ordonnées ou plus, comme rayure, bosse ou déchirure. Elle prédit la probabilité d'apparition de chaque catégorie de réponse à partir des valeurs des prédicteurs. Les prédicteurs peuvent être continus, catégoriels ou un mélange des deux.
Quelle est la différence entre la régression logistique nominale et ordinale ?
La régression logistique nominale s'applique à une réponse à trois catégories ou plus sans ordre naturel, comme la couleur, le type de matériau ou le type de défaut. Si les catégories ont un ordre naturel, comme faible, moyen et élevé, utilisez plutôt la régression logistique ordinale. Pour une réponse à deux catégories comme conforme/non conforme, utilisez la régression logistique binaire.
Quelles sont les conditions d'application de la régression logistique nominale ?
La réponse doit avoir trois catégories non ordonnées ou plus, et chaque catégorie nécessite suffisamment d'observations, car les catégories rares rendent le modèle instable et peuvent causer des problèmes d'estimation. Les données doivent représenter la population cible, être mesurées avec précision et enregistrées dans l'ordre de collecte. Après l'ajustement, validez le modèle avec des statistiques d'adéquation et des diagnostics des résidus.
Comment exécuter une régression logistique nominale dans Zometric Statistical Software ?
Choisissez Statistical Tool > Regression > Nominal Logistic Regression, puis saisissez ou collez les données. Sélectionnez la Response, les Categorical et Continuous Predictors éventuels, et définissez le Model, qui par défaut est un modèle à effets principaux et peut inclure des termes d'interaction tels que A*B. Cliquez ensuite sur Calculate pour obtenir les résultats.