
Capabilité du procédé non normale
Utilisez la capabilité du procédé non normale pour des données continues asymétriques ou suivant une distribution telle que Weibull, exponentielle, gamma ou lognormale. Collectez au moins 100 points de données d'un procédé stable et vérifiez que la distribution s'ajuste. Saisissez LSL et USL et choisissez la méthode du score Z ou la méthode des percentiles de l'ISO 22514. Les résultats incluent les indices de capabilité et le pourcentage prévu de production hors spécification.
Dernière révision
Point clé
La capabilité du procédé non normale évalue si un procédé produit dans les limites de spécification lorsque ses données ne suivent pas une distribution normale, en ajustant une distribution adaptée comme Weibull ou lognormale.
Sur cette page
- Qu'est-ce que la capabilité du procédé non normale ?
- Quand utiliser la capabilité du procédé non normale ?
- Recommandations pour bien utiliser la capabilité du procédé non normale
- Alternatives : quand ne pas utiliser la capabilité du procédé non normale
- Exemple de capabilité du procédé non normale ?
- Comment réaliser une analyse de capabilité du procédé non normale
Qu'est-ce que la capabilité du procédé non normale ?
La capabilité du procédé non normale est une méthode utilisée pour évaluer l'aptitude d'un procédé à produire des résultats dans des limites spécifiées lorsque les données s'écartent d'une distribution normale. Cette analyse est essentielle lorsque les données présentent des caractéristiques telles qu'une asymétrie ou des valeurs aberrantes, ou suivent une distribution autre que la courbe en cloche normale. En choisissant le bon modèle de distribution non normale, cette analyse évalue dans quelle mesure les résultats du procédé satisfont les exigences du client, mesure la performance globale du procédé et prédit le pourcentage de résultats susceptibles de se situer hors de l'étendue acceptable. Cette approche aide à déterminer si le procédé peut respecter de façon fiable les standards souhaités, même lorsque la distribution des données n'est pas normale.
En termes simples, c'est un moyen de s'assurer qu'un procédé fonctionne bien, même lorsque les données n'ont pas l'allure attendue.
Quand utiliser la capabilité du procédé non normale ?
La capabilité du procédé non normale doit être utilisée lorsque les données analysées ne suivent pas une distribution normale, c'est-à-dire qu'elles n'ont pas la courbe en cloche typique, symétrique et centrée sur la moyenne. Voici quelques situations où vous l'utiliseriez :
- Données asymétriques: si vos données sont asymétriques à gauche ou à droite, c'est-à-dire que la plupart des valeurs sont regroupées d'un côté, une analyse de capabilité du procédé non normale est plus appropriée.
- Présence de valeurs aberrantes : si vos données contiennent des valeurs extrêmes qui ne cadrent pas avec le schéma général, elles peuvent fausser une distribution normale. Examinez-les d'abord ; si elles font réellement partie d'un procédé à queue longue, une distribution non normale peut mieux modéliser la queue que la distribution normale.
- Distributions non symétriques: lorsque les données présentent un schéma non symétrique (par exemple des distributions lognormales ou exponentielles), la capabilité du procédé non normale permet une évaluation plus précise.
- Pics multiples : si vos données présentent plus d'un pic (distribution bimodale ou multimodale), elles ne suivent pas une distribution normale ; cela signifie généralement que les données proviennent de plus d'un flux de procédé (par exemple différentes machines ou différents lots), qu'il faut séparer avant d'évaluer la capabilité.
- Caractéristiques du procédé: certains procédés produisent naturellement des données non normales en raison de la nature du procédé ou du produit. Par exemple, l'usure au fil du temps, les procédés par lots ou les procédés à limites intrinsèques peuvent produire des données non normales.
Recommandations pour bien utiliser la capabilité du procédé non normale
- Utilisez des données continues pour l'analyse ; pour des données d'attribut, appliquez plutôt l'analyse de capabilité binomiale ou de Poisson.
- Collectez au moins 100 points de données pour garantir des estimations de capabilité fiables et une représentation exacte de la variation du procédé.
- Assurez-vous que le procédé est stable et maîtrisé avant de réaliser l'analyse de capabilité, en utilisant au besoin des outils comme la carte Xbar-S ou le Capability Six Pack (non normal).
- Les données doivent suivre de près la distribution non normale choisie ; utilisez l'identification de la distribution individuelle pour trouver le meilleur ajustement et obtenir des estimations de capabilité exactes.
Alternatives : quand ne pas utiliser la capabilité du procédé non normale
- Si vous ne savez pas quelle distribution non normale correspond à vos données, utilisez l'identification de la distribution individuelle avant l'analyse.
- Pour vérifier la maîtrise du procédé et l'adéquation à une distribution non normale précise, utilisez d'abord le Capability Six Pack (non normal).
- Pour estimer la variation intra-sous-groupe et la capabilité potentielle en plus de la capabilité globale, utilisez la capabilité du procédé (distribution normale) afin de transformer les données non normales et de les évaluer sur la base d'une distribution normale.
Exemple de capabilité du procédé non normale ?
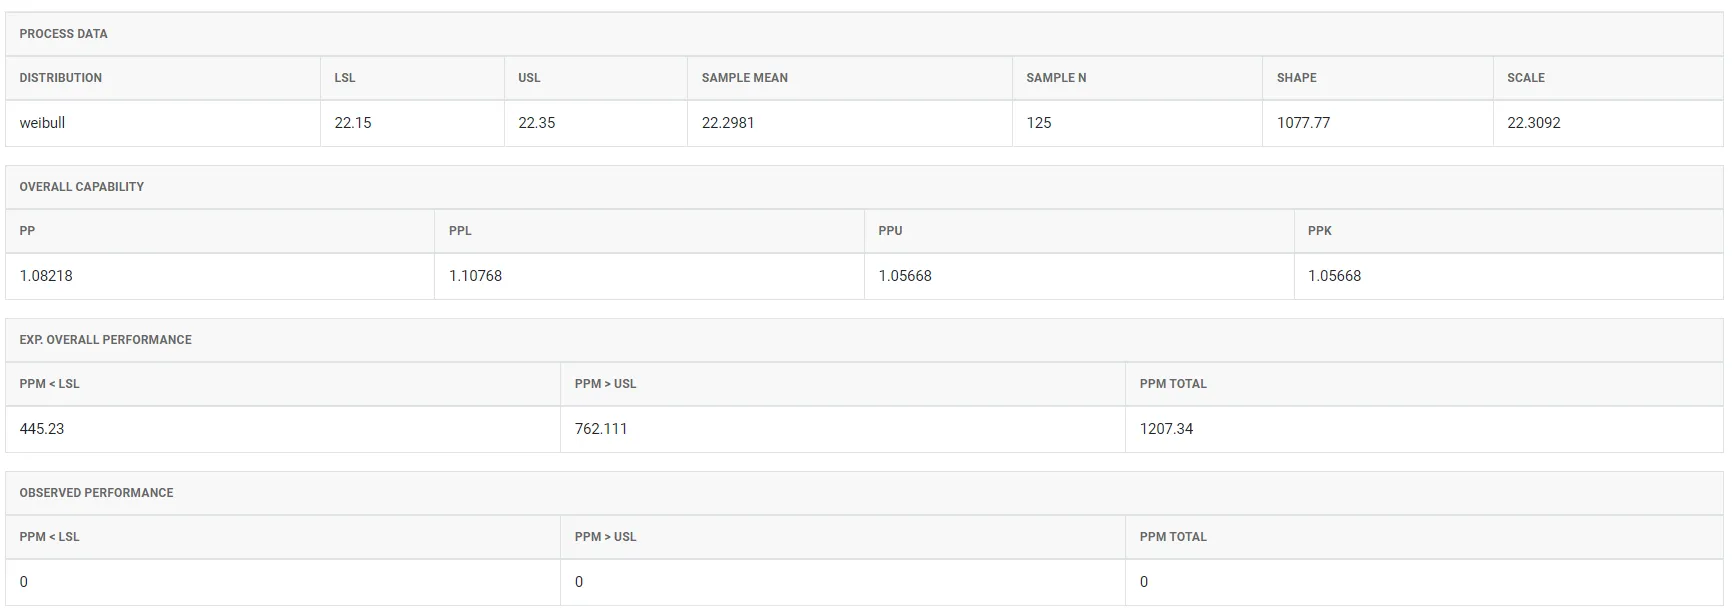
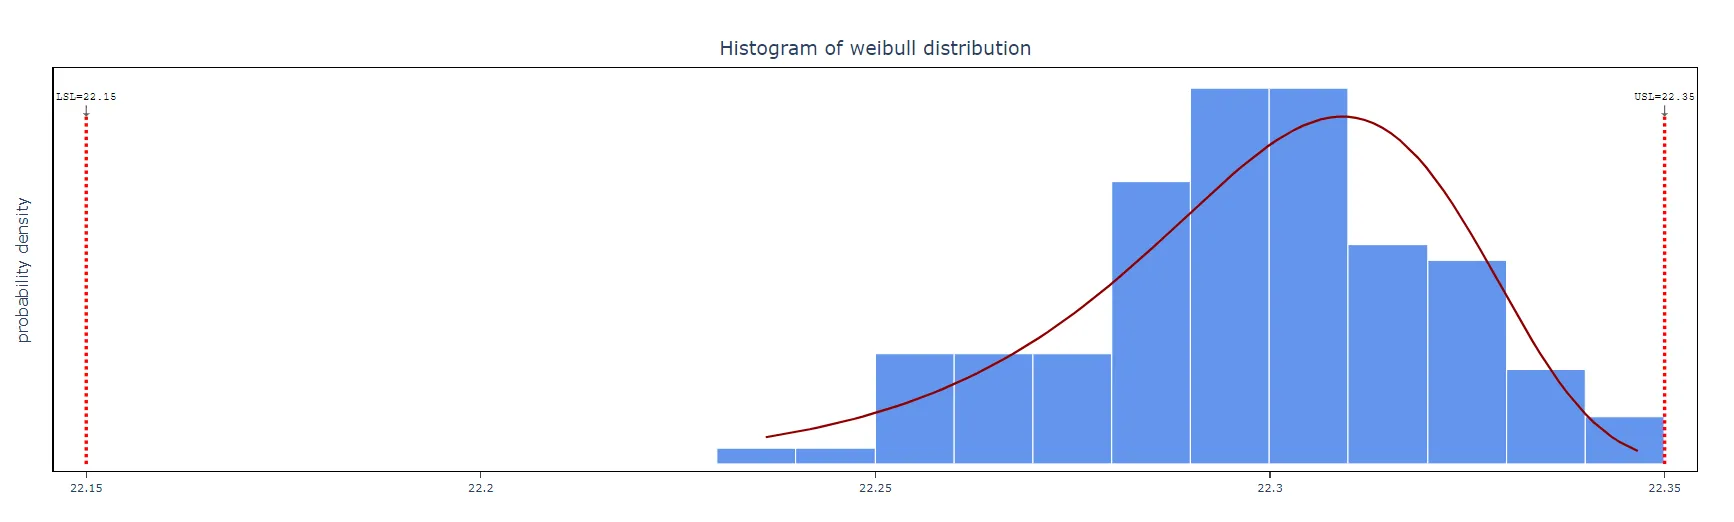
Un fabricant de composants automobiles cherche à savoir si une machine de perçage peut respecter les spécifications d'un composant critique. Le composant doit se situer dans une plage : limite de spécification inférieure (LSL) de 22.15 et limite de spécification supérieure (USL) de 22.35. Pour l'évaluer, l'ingénieur prélève 125 échantillons sur la machine et effectue les étapes suivantes :
- Les données nécessaires ont été rassemblées.
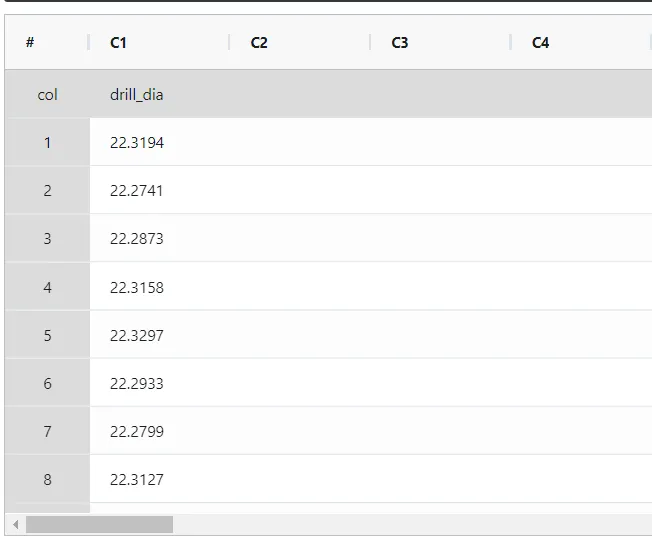
- Analysez maintenant les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver la capabilité du procédé non normale, choisissez Statistical module> Process Capability>Non-Normal Process Capability.
- Dans l'outil, saisissez les données ainsi que les autres entrées comme suit :
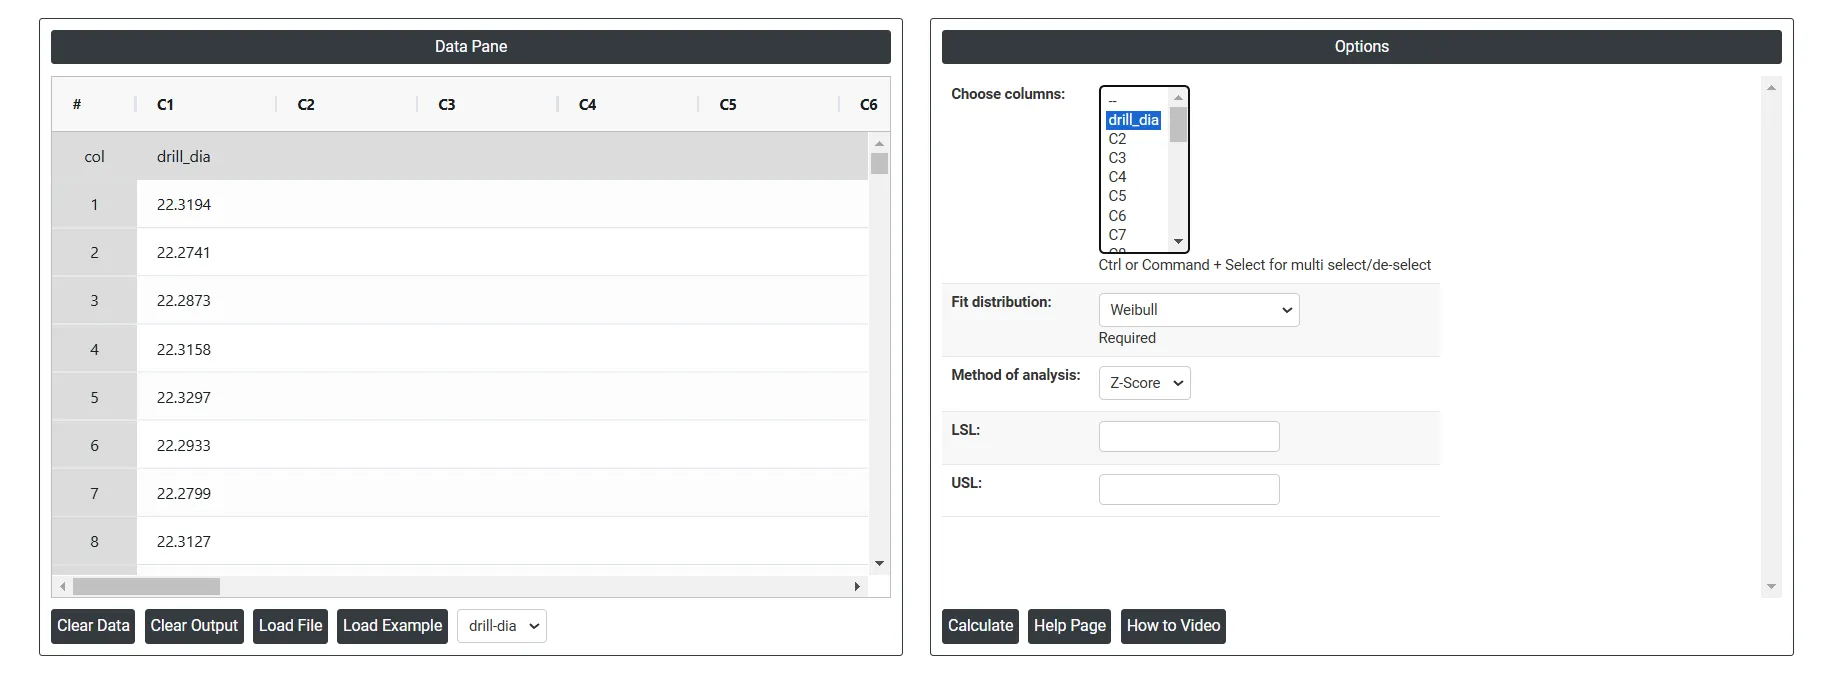
5. Après avoir utilisé l'outil ci-dessus, récupérez les résultats comme suit :
Comment réaliser une analyse de capabilité du procédé non normale
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Process Capability >Non-Normal Process Capability.
- Cliquez sur Non Normal Process Capability pour accéder au tableau de bord.
- Ensuite, mettez à jour les données manuellement ou copiez-les (Ctrl+C) intégralement depuis une feuille Excel et collez-les (Ctrl+V) ici.
- Ensuite, vous devez sélectionner la distribution à ajuster, saisir LSL et USL, et choisir la méthode d'analyse.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Sur le tableau de bord de la capabilité du procédé non normale, la fenêtre est divisée en deux parties.
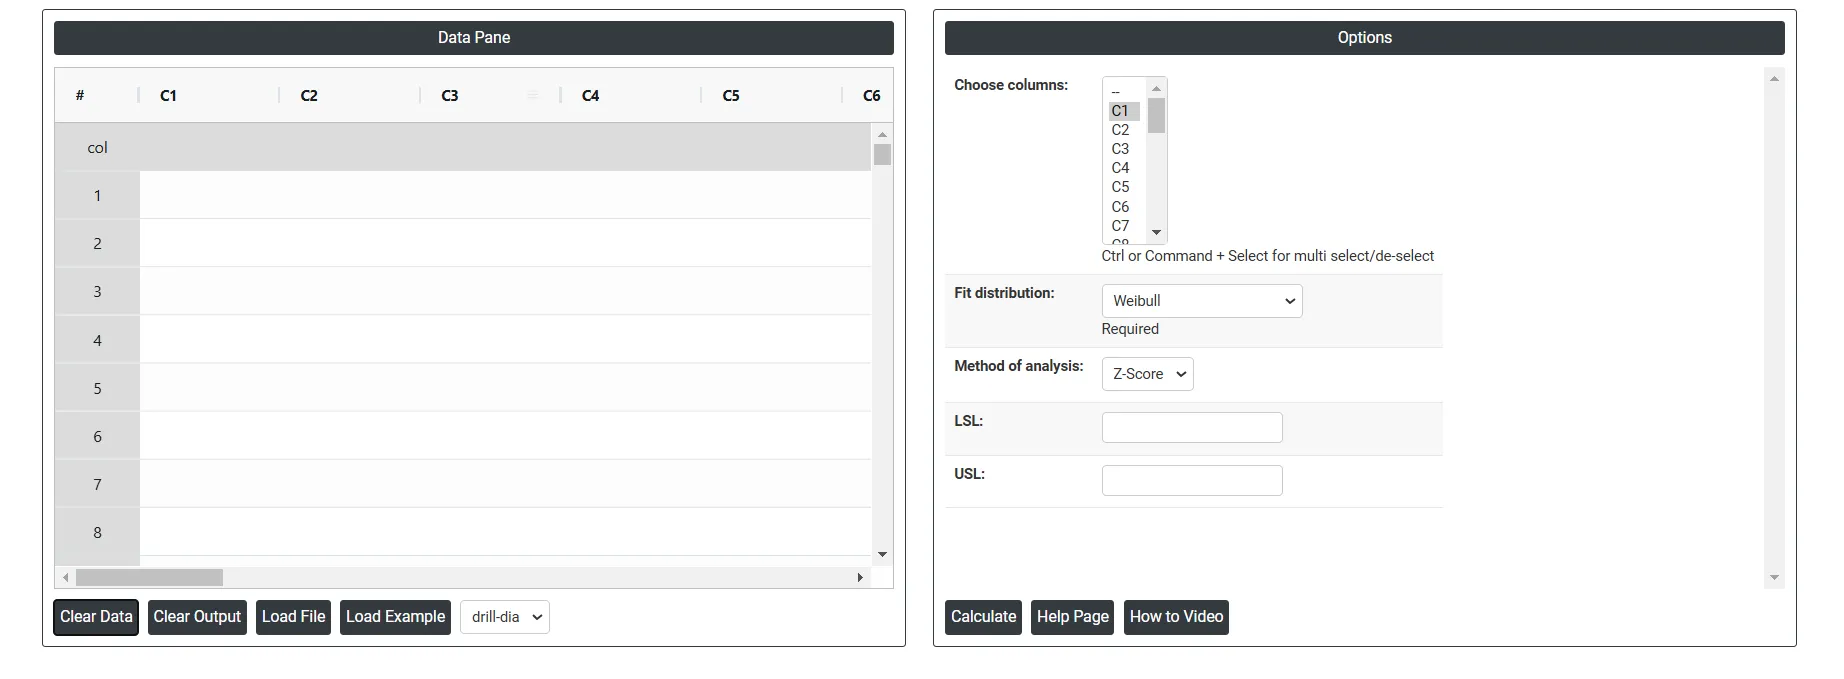
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement ou copiées (Ctrl+C) intégralement depuis une feuille Excel puis collées (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File : permet de charger directement les données Excel.
Dans la partie droite, de nombreuses options sont présentes, comme suit :
- Fit Distribution :
- Weibull distribution : la distribution de Weibull est un modèle statistique flexible utilisé en ingénierie, en recherche médicale, en finance et en climatologie, notamment pour analyser des données de temps jusqu'à la défaillance et traiter des données de procédé asymétriques. Elle est définie par trois paramètres : forme, échelle et seuil. La distribution de Weibull à 3 paramètres les comprend tous les trois, tandis que la version à 2 paramètres, qui exclut le seuil, n'est utilisée que pour des valeurs positives. Le paramètre de forme influe sur l'asymétrie de la distribution, le paramètre d'échelle indique le point où 63.2% de la population devrait avoir défailli, et le paramètre de seuil décale la distribution le long de l'axe du temps. Cette distribution est essentielle pour prédire les défaillances, estimer les cycles de vie et comprendre des structures de données complexes. Sa polyvalence s'étend aussi au contrôle qualité et à la gestion des risques.Exponential : la distribution exponentielle est une distribution de probabilité continue fréquemment utilisée en analyse de capabilité du procédé avec des données non normales, notamment pour des données de temps jusqu'à la défaillance à taux de défaillance constant, et pour les temps d'inter-arrivée d'événements dans un processus de Poisson, où les événements surviennent de façon continue et indépendante à un taux moyen constant. Cette distribution est idéale pour modéliser le temps jusqu'à la survenue d'un événement précis ; sa propriété d'absence de mémoire la rend adaptée aux situations où le passé n'influence pas l'avenir, ce qui permet d'analyser avec exactitude des données asymétriques qui ne suivent pas une distribution normale.Logistic : la distribution logistique joue un rôle important dans l'analyse de capabilité du procédé non normale , notamment lorsque les données sont symétriques mais non normalement distribuées. La distribution logistique a une forme proche de celle de la distribution normale mais des queues plus lourdes, c'est-à-dire qu'elle attribue plus de probabilité aux valeurs extrêmes. Cette caractéristique la rend utile dans certaines analyses de capabilité où les données tendent à avoir des valeurs aberrantes ou une dispersion plus grande que ce que la distribution normale peut accommoder.Loglogistic : la distribution loglogistique est utilisée pour des données positives asymétriques à droite dont le logarithme suit une distribution logistique. Elle est proche de la distribution lognormale mais a des queues plus lourdes, ce qui la rend adaptée aux procédés où les grandes valeurs sont plus probables que ne le prévoirait une distribution lognormale.Largest Extreme Value : la distribution des valeurs extrêmes maximales est essentielle en analyse de capabilité du procédé non normale lorsque les données portent sur des valeurs maximales ou des distributions asymétriques à droite. Elle garantit que les valeurs extrêmes sont modélisées avec exactitude, ce qui conduit à des évaluations de capabilité plus fiables et à des décisions mieux éclairées sur la performance et les risques du procédé.Smallest Extreme Value : la distribution des valeurs extrêmes minimales (SEV) joue un rôle essentiel en analyse de capabilité du procédé non normale, notamment lorsque les données sont asymétriques et ne s'ajustent pas à la distribution normale. La distribution SEV est particulièrement utile pour modéliser les valeurs minimales d'un jeu de données, comme le plus petit temps jusqu'à la défaillance ou le maillon le plus faible d'une chaîne d'événements.2-Parameter Exponential : la distribution exponentielle à 2 paramètres est définie par un paramètre d'échelle (λ) et un paramètre de seuil (θ). Le paramètre de seuil décale la distribution de θ unités vers la droite, ce qui indique un temps d'attente minimal avant que des événements puissent survenir. Le paramètre d'échelle contrôle le taux auquel les événements surviennent après le seuil.3- Parameter Weibull : la distribution de Weibull à 3 paramètres est définie par un paramètre de forme (β), un paramètre d'échelle (η) et un paramètre de seuil (γ). Le paramètre de forme (β) détermine le comportement du taux de défaillance, le paramètre d'échelle (η) indique la vie caractéristique, et le paramètre de seuil (γ) décale la distribution, représentant le temps minimal avant le début des défaillances. Cette distribution sert à modéliser des données de durée de vie avec une période d'attente initiale avant que des événements puissent survenir, ce qui ajoute de la flexibilité pour un ajustement plus exact des données.Gamma : la distribution gamma est une distribution de probabilité continue caractérisée par un paramètre de forme (k ou α) et un paramètre d'échelle (θ). Elle sert principalement à modéliser le temps d'attente jusqu'à la survenue d'un nombre donné d'événements, ce qui la rend idéale pour les procédés impliquant des temps cumulés ou des données asymétriques.Lognormal : la distribution lognormale est une distribution de probabilité continue dans laquelle le logarithme de la variable aléatoire suit une distribution normale. Elle se caractérise par une asymétrie positive et est définie par la moyenne (μ) et l'écart-type (σ) de la distribution normale sous-jacente. Couramment utilisée en finance, en sciences de la vie et en analyse de fiabilité, elle modélise des données qui doivent rester positives et présenter une croissance multiplicative ou un comportement asymétrique à droite.
- LSL : c'est la valeur minimale acceptable d'une mesure du procédé. Toute valeur inférieure à cette limite indique que le produit ou le procédé ne satisfait pas aux standards de qualité et est considéré comme défectueux.
- USL : c'est la valeur maximale acceptable d'une mesure du procédé. Toute valeur supérieure à cette limite indique elle aussi que le produit ou le procédé est hors spécification et ne satisfait pas aux exigences de qualité.
- Method of Analysis :
- Z-Score : la méthode du score Z utilise la distribution ajustée pour trouver la probabilité de dépasser chaque limite de spécification et la convertit en une valeur Z de la loi normale centrée réduite équivalente. Les indices de capabilité sont ensuite calculés à partir de ces valeurs Z (chaque indice unilatéral est égal à Z divisé par 3) ; ils sont donc comparables aux indices utilisés pour des données normales. La méthode aide à repérer les problèmes de performance et permet de prendre des décisions fondées sur les données pour améliorer la qualité.
Utilisez cette méthode lorsque:
- Les données ne suivent pas une distribution normale, ce qui est fréquent dans de nombreux procédés réels.
- Vous avez besoin d'une approche plus flexible pouvant s'adapter à diverses distributions (par exemple exponentielle, lognormale).
- Vous voulez calculer des indices de capabilité du procédé (Cp, Cpk) standardisés en nombre d'écarts-types séparant la moyenne du procédé des limites de spécification.
Avantages:
- La méthode du score Z offre une compréhension plus claire de la performance du procédé par rapport aux limites de spécification en exprimant la capabilité en écarts-types.
- Elle permet de mieux comparer différents procédés ou caractéristiques, même lorsque les données sont non normales.
- ISO : la méthode ISO suit la norme ISO 22514 pour l'analyse de capabilité non normale. Elle calcule les indices de capabilité directement à partir des percentiles de la distribution ajustée : les percentiles 0.135 et 99.865, qui correspondent à ±3 écarts-types dans une distribution normale, et la médiane comme centre du procédé. Cette méthode est préférable lorsque la conformité aux normes internationales de qualité est exigée.
- Download as Excel: affiche le résultat au format Excel ; il peut être facilement modifié puis rechargé pour de nouveaux calculs avec l'option Load File.
Questions fréquentes
Qu'est-ce que la capabilité du procédé non normale ?
La capabilité du procédé non normale évalue l'aptitude d'un procédé à produire dans les limites de spécification lorsque les données ne suivent pas une distribution normale. En ajustant un modèle de distribution non normale adapté, elle évalue la performance globale du procédé et prédit le pourcentage de production susceptible de se situer hors de l'étendue acceptable.
Quand utiliser l'analyse de capabilité non normale ?
Utilisez-la lorsque des données continues sont asymétriques, non symétriques, ou proviennent d'un procédé qui produit naturellement des données non normales, comme l'usure au fil du temps ou les procédés à limites intrinsèques. Examinez d'abord les valeurs aberrantes et séparez les données à plusieurs pics selon leurs flux de procédé, comme différentes machines ou différents lots, avant d'évaluer la capabilité. Pour des données d'attribut, utilisez l'analyse de capabilité binomiale ou de Poisson.
De combien de données avez-vous besoin pour la capabilité du procédé non normale ?
Collectez au moins 100 points de données pour des estimations de capabilité fiables. Le procédé doit être stable et maîtrisé avant l'analyse, et les données doivent suivre de près la distribution choisie. Si vous ne savez pas quelle distribution convient, utilisez d'abord l'identification de la distribution individuelle.
Quelle est la différence entre les méthodes Z-score et ISO pour la capabilité non normale ?
La méthode du score Z utilise la distribution ajustée pour trouver la probabilité au-delà de chaque limite de spécification et la convertit en une valeur Z de la loi normale centrée réduite équivalente ; chaque indice unilatéral est égal à Z divisé par 3, de sorte que les indices sont comparables à ceux des données normales. La méthode ISO suit la norme ISO 22514 et calcule les indices à partir des percentiles 0.135 et 99.865 de la distribution ajustée, avec la médiane comme centre du procédé.