
Capabilité du procédé non normale
L'analyse de capabilité du procédé non normale mesure dans quelle mesure un procédé respecte ses limites de spécification lorsque les données ne suivent pas une distribution normale (en cloche). Au lieu d'imposer l'hypothèse de normalité à des données asymétriques ou atypiques, elle ajuste aux données une distribution non normale reconnue, comme Weibull, Lognormal, Exponential ou Gamma, puis calcule des indices de capabilité fondés sur la forme réelle de cette distribution.
Dernière révision
Point clé
L'analyse de capabilité du procédé non normale mesure dans quelle mesure un procédé respecte ses limites de spécification lorsque les données ne suivent pas une distribution normale (en cloche).
Sur cette page
- Qu'est-ce que la capabilité du procédé non normale ?
- Quand utiliser la capabilité du procédé non normale ?
- Recommandations pour bien utiliser la capabilité du procédé non normale
- Alternatives : quand ne pas utiliser la capabilité du procédé non normale
- Exemple de capabilité du procédé non normale
- Comment réaliser une capabilité du procédé non normale
Qu'est-ce que la capabilité du procédé non normale ?
L'analyse de capabilité du procédé non normale mesure dans quelle mesure un procédé respecte ses limites de spécification lorsque les données ne suivent pas une distribution normale (en cloche). Au lieu d'imposer l'hypothèse de normalité à des données asymétriques ou atypiques, elle ajuste aux données une distribution non normale reconnue, comme Weibull, Lognormal, Exponential ou Gamma, puis calcule des indices de capabilité fondés sur la forme réelle de cette distribution.
Les indices de capabilité standard comme Cp et Cpk supposent la normalité. Lorsque cette hypothèse n'est pas respectée, ces indices deviennent inexacts et peuvent surestimer ou sous-estimer la vraie capabilité du procédé. La capabilité non normale résout ce problème en utilisant le bon modèle de distribution, ce qui donne une image beaucoup plus honnête et précise de la capacité du procédé à livrer de façon constante des produits conformes à la spécification.
Définitions simples : une analyse de capabilité conçue pour des données asymétriques ou non normales : elle ajuste la bonne distribution à vos données puis calcule des indices de capabilité fondés sur cette forme réelle, au lieu d'imposer une hypothèse normale incorrecte.
Quand utiliser la capabilité du procédé non normale ?
- À utiliser lorsque les données de votre procédé sont continues mais ne passent pas un test de normalité, par exemple des temps de cycle, des mesures de résistance ou des concentrations chimiques fortement asymétriques.
- À utiliser lorsqu'une droite de probabilité ou un test de normalité confirme que vos données suivent une distribution non normale précise comme Weibull, Lognormal, Exponential ou Gamma.
- À utiliser lorsque l'application d'une transformation de Box-Cox ou de Johnson n'est pas appropriée ou pratique, par exemple lorsque les données transformées sont difficiles à interpréter dans les unités d'origine.
- À utiliser lorsque l' outil Individual Distribution Identification a confirmé la distribution qui s'ajuste le mieux à vos données.
Recommandations pour bien utiliser la capabilité du procédé non normale
- Lancez toujours d'abord Individual Distribution Identification pour déterminer la distribution qui s'ajuste le mieux avant de la sélectionner dans cette analyse : choisir la mauvaise distribution produit des indices de capabilité trompeurs.
- Recueillez au moins 100 points de données afin que l'ajustement de la distribution produise des estimations de paramètres fiables et stables.
- Assurez-vous que le procédé est stable et sous contrôle statistique avant de lancer l'analyse de capabilité : un procédé instable produit des chiffres de capabilité dénués de sens, quelle que soit la distribution utilisée.
- N'utilisez pas cette analyse pour des données d'attribut ou de comptage : utilisez plutôt la capabilité binomiale ou de Poisson.
- Vérifiez la distribution choisie à l'aide de statistiques d'adéquation et de droites de probabilité : une valeur p élevée et une droite de probabilité rectiligne confirment un bon ajustement.
- Les indices de capabilité tels que Pp, Ppk, Cp et Cpk sont fournis à partir des percentiles de la distribution ajustée plutôt que de multiples de l'écart-type : interprétez-les en conséquence.
Alternatives : quand ne pas utiliser la capabilité du procédé non normale
- Situation
À utiliser à la place
Les données suivent une distribution normale
Analyse de capabilité normale (standard)
Les données peuvent être transformées pour devenir normales
Analyse de capabilité avec transformation de Box-Cox ou de Johnson
La distribution est inconnue ou incertaine
Capabilité du procédé non paramétrique
Les données sont réussite/échec ou des comptages de défectueux
Analyse de capabilité binomiale
Les données sont des comptages d'événements (défauts par unité)
Analyse de capabilité de Poisson
Besoin d'un rapport graphique et statistique combiné
Capability Six Pack (Between/Within)
Exemple de capabilité du procédé non normale
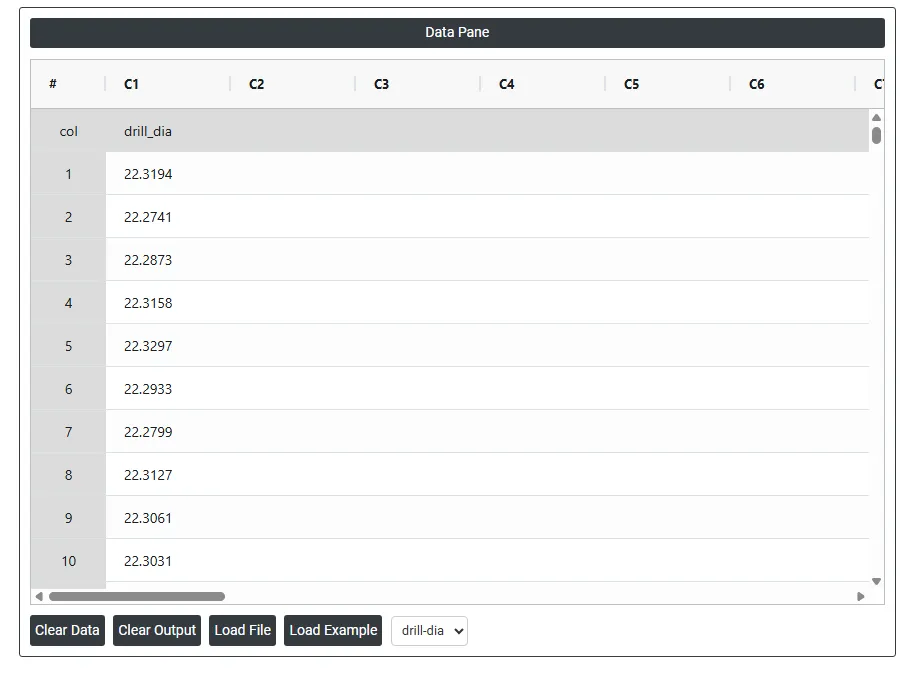
Un fabricant de composants automobiles développe un composant critique pour un client constructeur. Pour garantir la qualité, un ingénieur vérifie si une perceuse peut respecter les spécifications. La pièce doit se situer dans une plage : LSL (limite de spécification inférieure) de 22.15 et USL (limite de spécification supérieure) de 22.35. L'ingénieur prélève 125 échantillons sur la machine et réalise une étude de capabilité machine. Les étapes suivantes ont été suivies :
- Les données nécessaires ont été rassemblées.
- Analysez maintenant les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver Non-Normal Process Capability, choisissez Statistical module> Control Chart>Non-Normal Process Capability.
- Dans l'outil, saisissez les données et les autres paramètres comme suit :
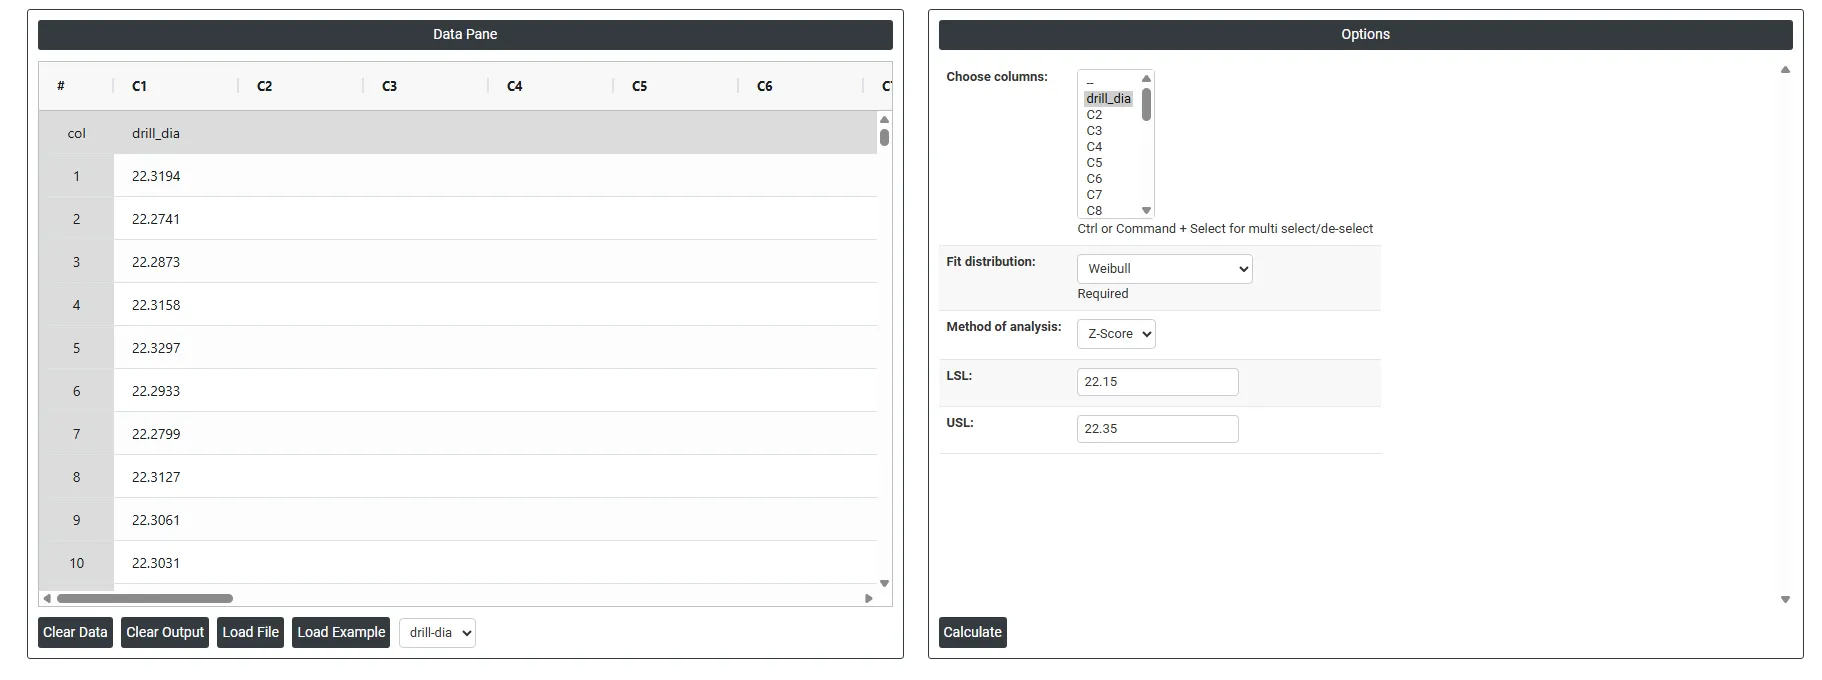
5. Après exécution de l'outil, les résultats obtenus sont les suivants :
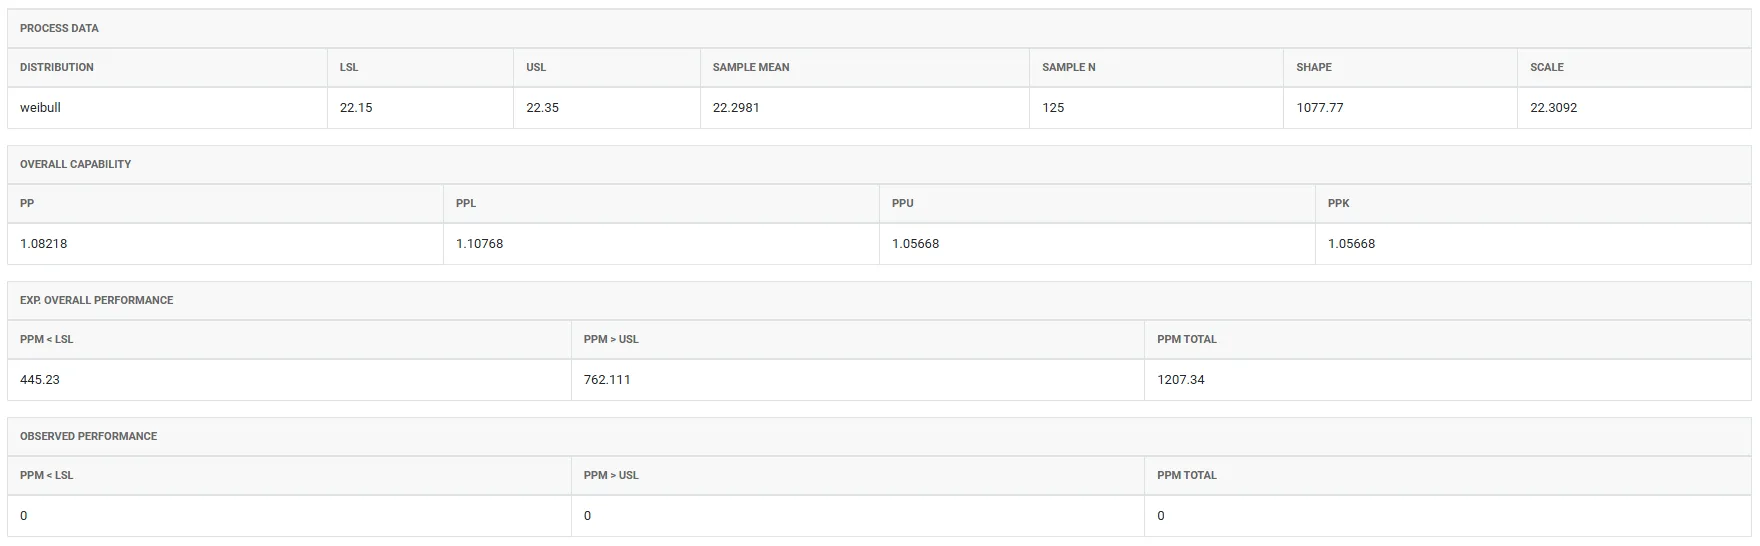
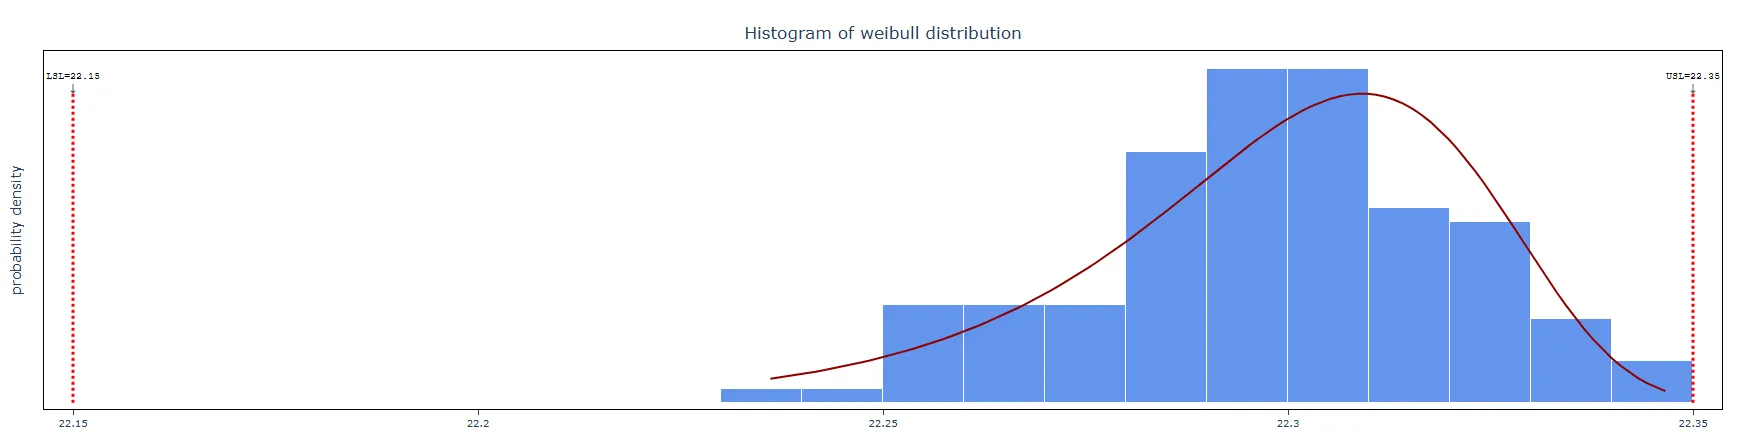
Comment réaliser une capabilité du procédé non normale
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Control Chart>Non-Normal Process Capability .
- Ensuite, saisissez les données manuellement, ou copiez (Ctrl+C) l'ensemble des données d'une feuille Excel et collez-les (Ctrl+V) ici.
- Renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Sur le tableau de bord de Non-Normal Process Capability, la fenêtre est divisée en deux parties.
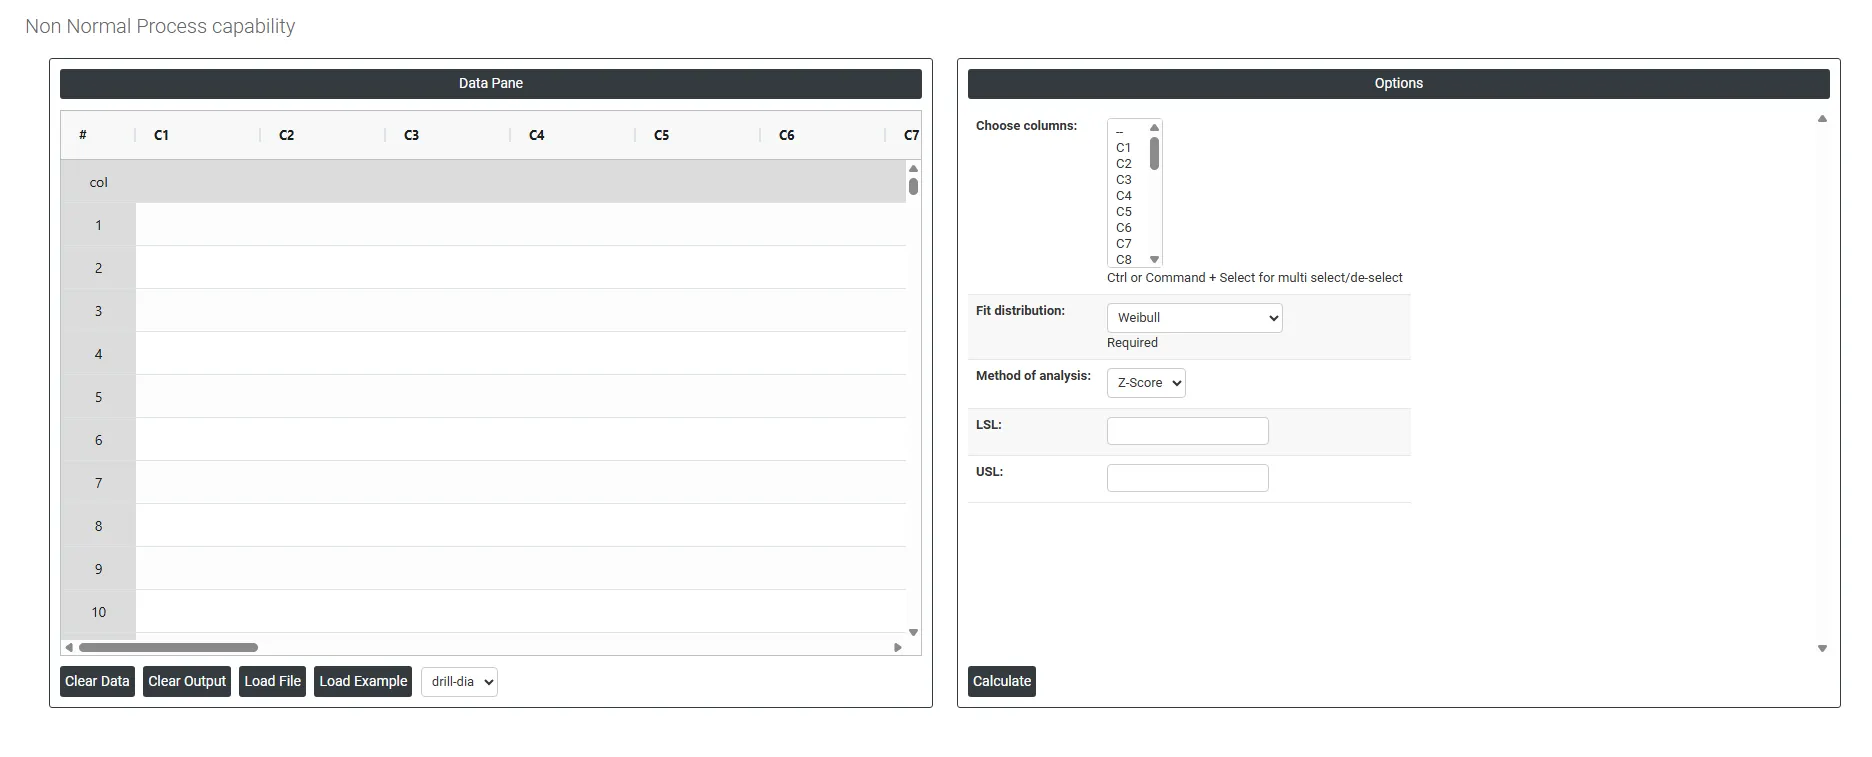
La partie gauche contient le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement, ou vous pouvez copier (Ctrl+C) l'ensemble des données d'une feuille Excel et les coller (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File : permet de charger directement des données Excel.
La partie droite contient de nombreuses options, décrites ci-dessous :
- Choose Columns : sélectionnez la ou les colonnes contenant vos données de mesure continues. Utilisez Ctrl ou Commande + clic pour sélectionner plusieurs colonnes à la fois. Ce sont les mesures réelles du procédé, comme des diamètres de perçage, des résistances à la traction ou des temps de cycle, qui seront analysées en capabilité par rapport aux limites de spécification avec la distribution non normale sélectionnée.
- Fit Distribution : sélectionnez la distribution qui décrit le mieux la forme de vos données. C'est le réglage le plus critique de l'analyse : les indices de capabilité sont calculés à partir des propriétés mathématiques de la distribution choisie, de sorte que le mauvais choix donne des résultats inexacts. Lancez toujours d'abord Individual Distribution Identification pour confirmer quelle distribution s'ajuste à vos données avant de faire ce choix. Options disponibles et cas d'usage typiques :
- Weibull — couramment utilisée pour la fiabilité, la durée de vie en fatigue et les données de temps avant défaillance. Gère bien les données asymétriques à droite et fait partie des distributions non normales les plus souples et les plus répandues.
- Exponential — utilisée pour des données représentant le temps entre événements aléatoires indépendants, comme le temps entre pannes de machines ou entre arrivées d'appels de service. Suppose un taux de défaillance constant.
- Logistic — de forme proche de la distribution normale mais à queues plus lourdes. Utilisée lorsque les données sont symétriques mais comportent plus de valeurs extrêmes que ne le prévoit la normalité.
- Loglogistic — distribution asymétrique à droite utilisée pour des données de survie et de fiabilité, proche de la lognormale mais à queues plus lourdes. Convient aux temps avant défaillance ou aux données de type revenus.
- Largest Extreme Value — modélise la distribution de la valeur maximale d'un échantillon. Utilisée lorsque les données représentent des mesures de pic, comme la contrainte maximale, les niveaux de crue ou les températures les plus élevées.
- Smallest Extreme Value — modélise la distribution de la valeur minimale d'un échantillon. Couramment utilisée pour la résistance minimale ou les plus petites mesures observées.
- 2-Parameter Exponential — extension de la distribution exponentielle standard qui inclut un paramètre de seuil, ce qui permet à la distribution de démarrer à une valeur autre que zéro. Utile lorsque les mesures ne peuvent pas être inférieures à une certaine valeur minimale.
- 3-Parameter Weibull — ajoute à la distribution de Weibull standard un paramètre de position (seuil), ce qui permet à la distribution de démarrer à un point non nul. Utile lorsqu'aucune défaillance ni mesure ne peut survenir sous une valeur minimale connue.
- Gamma — distribution souple asymétrique à droite, couramment appliquée aux temps de procédé, aux temps d'attente, aux quantités de pluie et à d'autres mesures continues positives modérément asymétriques.
- Lognormal — utilisée lorsque le logarithme des données suit une distribution normale. Courante pour les concentrations chimiques, les tailles de particules, les temps de réparation et les données financières où les valeurs sont strictement positives et asymétriques à droite.
- Method of Analysis : détermine comment les statistiques de capabilité et les limites de spécification sont interprétées et fournies. Deux options sont disponibles :
- Z-Score — calcule la capabilité en convertissant les limites de spécification en scores Z standardisés à partir des percentiles de la distribution ajustée. Cela exprime la capabilité en nombre d'écarts-types entre les limites de spécification et le centre du procédé, ce qui rend les résultats comparables aux indices de capabilité normale standard comme Cp et Cpk.
- ISO — suit la méthodologie de la norme ISO 22514 pour l'analyse de capabilité non normale. Cette méthode calcule les indices de capabilité directement à partir des percentiles de la distribution (précisément les 0.135e et 99.865e percentiles, qui correspondent aux limites de ±3 sigma d'une distribution normale), sans conversion en scores Z. C'est la méthode préférée lorsque la conformité aux normes internationales de qualité est exigée.
- LSL (Lower Specification Limit) : la valeur minimale acceptable de la mesure. Tout point de données inférieur à cette valeur est considéré comme hors spécification. Saisissez la LSL définie par votre plan technique, l'exigence du client ou la spécification du produit. Au moins une limite de spécification (LSL ou USL) doit être fournie ; les deux peuvent être saisies si la mesure a des spécifications bilatérales.
- USL (Upper Specification Limit) : la valeur maximale acceptable de la mesure. Tout point de données dépassant cette valeur est considéré comme hors spécification. Saisissez l'USL de votre plan technique ou de la spécification du produit. Si la caractéristique du procédé n'a qu'une exigence unilatérale, par exemple une résistance minimale sans limite supérieure, seule la limite concernée doit être saisie.
Questions fréquentes
Qu'est-ce que l'analyse de capabilité du procédé non normale ?
L'analyse de capabilité du procédé non normale mesure dans quelle mesure un procédé respecte ses limites de spécification lorsque les données ne suivent pas une distribution normale. Au lieu d'imposer l'hypothèse de normalité, elle ajuste une distribution reconnue comme Weibull, Lognormal, Exponential ou Gamma, et calcule des indices de capabilité à partir de la forme réelle de cette distribution.
Pourquoi ne pas utiliser les Cp et Cpk standard pour des données non normales ?
Les Cp et Cpk standard supposent la normalité. Lorsque les données sont asymétriques ou autrement non normales, ces indices deviennent inexacts et peuvent surestimer ou sous-estimer la vraie capabilité du procédé. Utiliser le bon modèle de distribution donne une image plus honnête et plus précise de la capacité du procédé à livrer de façon constante des produits conformes à la spécification.
Comment choisir la bonne distribution pour la capabilité non normale ?
Lancez d'abord Individual Distribution Identification pour trouver la distribution qui s'ajuste le mieux, puis vérifiez-la avec des statistiques d'adéquation et des droites de probabilité ; une valeur p élevée et une droite de probabilité rectiligne indiquent un bon ajustement. Choisir la mauvaise distribution produit des indices de capabilité trompeurs. Si aucune distribution ne convient, utilisez la capabilité du procédé non paramétrique.
Quelle est la différence entre les méthodes Z-Score et ISO ?
La méthode Z-Score convertit les limites de spécification en scores Z standardisés à partir des percentiles de la distribution ajustée, ce qui rend les résultats comparables aux Cp et Cpk normaux. La méthode ISO suit la norme ISO 22514 et calcule les indices directement à partir des 0.135e et 99.865e percentiles de la distribution ajustée ; elle est préférée lorsque la conformité aux normes internationales est exigée.