
Régression non linéaire
La régression non linéaire ajuste, sur une réponse et un prédicteur, une courbe dont les paramètres n'interviennent pas linéairement. Utilisez-la lorsque la physique ou la chimie du procédé dicte la forme de la courbe. Choisissez l'une des sept fonctions intégrées ou une fonction définie par l'utilisateur, et fournissez des valeurs initiales raisonnables. Les résultats comprennent les estimations des paramètres avec erreurs-types et intervalles de confiance, une droite ajustée, une matrice de corrélation et un test de manque d'ajustement.
Dernière révision
Point clé
La régression non linéaire ajuste une courbe à paramètres non linéaires, comme une approche exponentielle d'une limite, pour estimer des paramètres tels qu'une valeur limite ou une constante de vitesse, avec intervalles de confiance.
Sur cette page
Objectif
La régression non linéaire ajuste, sur une réponse et un prédicteur, une courbe dont les paramètres n'interviennent pas linéairement, comme une approche exponentielle d'une limite, une courbe de saturation ou une courbe de croissance en S. Utilisez-la lorsque la physique ou la chimie du procédé vous indique la forme de la courbe et que vous voulez des estimations de ses paramètres, comme une valeur limite ou une constante de vitesse, avec des intervalles de confiance.
Principales fonctionnalités
- Sept fonctions d'espérance intégrées : décroissance exponentielle, croissance exponentielle, puissance, logistique à 3 paramètres, Michaelis-Menten, Gompertz et quadratique.
- Fonction d'espérance définie par l'utilisateur en X avec des paramètres b1, b2, …, utilisant + − * / ^ et exp, log, ln, log10, sqrt, abs, sin, cos, tan, arctan.
- Ajustement par Gauss-Newton, Levenberg-Marquardt ou Trust Region Reflective, avec vos propres valeurs initiales, limite d'itérations et tolérance.
- Estimations des paramètres avec erreurs-types et intervalles de confiance, et leur matrice de corrélation.
- Droite ajustée avec bandes de confiance et de prédiction facultatives.
- Test de manque d'ajustement lorsque le prédicteur comporte des valeurs répétées.
- Colonne de pondérations facultative et graphiques des résidus.
Méthodes statistiques
L'outil trouve les valeurs de paramètres θ qui minimisent la somme des carrés des erreurs SSE = Σ (yᵢ − f(xᵢ, θ))², ou Σ wᵢ (yᵢ − f(xᵢ, θ))² avec une colonne de pondérations. Levenberg-Marquardt (par défaut) et Trust Region Reflective utilisent les solveurs de moindres carrés de SciPy ; Gauss-Newton utilise la réduction de pas par moitié et indique le nombre d'itérations. L'itération s'arrête lorsque la variation relative de la SSE et des paramètres passe sous la tolérance de convergence. Les lignes comportant une valeur manquante dans la réponse, le prédicteur ou les pondérations sont écartées.
Les erreurs-types proviennent de l'approximation linéaire à la solution : Cov(θ) = MSE·(JᵀJ)⁻¹, où J est la matrice des dérivées de f par rapport aux paramètres et MSE = SSE / (n − p) pour p paramètres ; S = √MSE. Les intervalles de confiance sont θ ± t(1−α/2, n−p)·SE. La bande de confiance de la courbe utilise la même approximation ; la bande de prédiction ajoute MSE pour un seul nouveau relevé. Ces intervalles sont approximatifs et deviennent peu fiables si les paramètres sont mal déterminés, ce qui se manifeste par des corrélations proches de ±1 dans la matrice de corrélation.
Lorsque certaines valeurs du prédicteur sont répétées, la somme des carrés de l'erreur est scindée en erreur pure (dispersion entre répétitions) et manque d'ajustement, et F = MS lack-of-fit / MS pure error teste si la courbe choisie s'ajuste. Les valeurs initiales comptent : les fonctions intégrées partent de valeurs par défaut fixes (par exemple a = 1, b = 1 pour Michaelis-Menten), avec c à la médiane de X pour les courbes logistique et de Gompertz ; une fonction définie par l'utilisateur exige une valeur initiale par paramètre. Donnez des valeurs proches de ce que vous attendez, faute de quoi l'ajustement peut échouer ou trouver un mauvais minimum local.
Champs de saisie et options
Champ | Description |
Response (Y) / Predictor (X) | Colonnes numériques ; elles doivent être différentes. Obligatoire. |
Expectation function | Exponential decay y = a·exp(−b·x) (par défaut), Exponential growth, Power y = a·x^b, Logistic (3-param), Michaelis-Menten y = a·x/(b + x), Gompertz, Quadratic, ou User-defined expectation function. |
Expectation function (user-defined) | Affiché pour le choix défini par l'utilisateur. Formule en X avec des paramètres b1, b2, …, p. ex. b1 * exp(-b2 * X). |
Weights (optional) | Colonne de pondérations pour les moindres carrés pondérés. |
Starting values (space-separated) | Une valeur par paramètre, dans l'ordre. Facultatif pour les fonctions intégrées (valeurs par défaut utilisées si vide), obligatoire pour une fonction définie par l'utilisateur. |
Confidence level | 95 par défaut. |
Fitting algorithm | Gauss-Newton, Levenberg-Marquardt (par défaut) ou Trust Region Reflective. |
Maximum number of iterations / Convergence tolerance | Par défaut 200 et 1e-05. |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | Ajoute les bandes à la droite ajustée. Désactivé par défaut. |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | Graphiques des résidus ; Four in one trace les quatre ensemble. |
Residuals versus the variables | Trace les résidus en fonction d'une colonne choisie. |
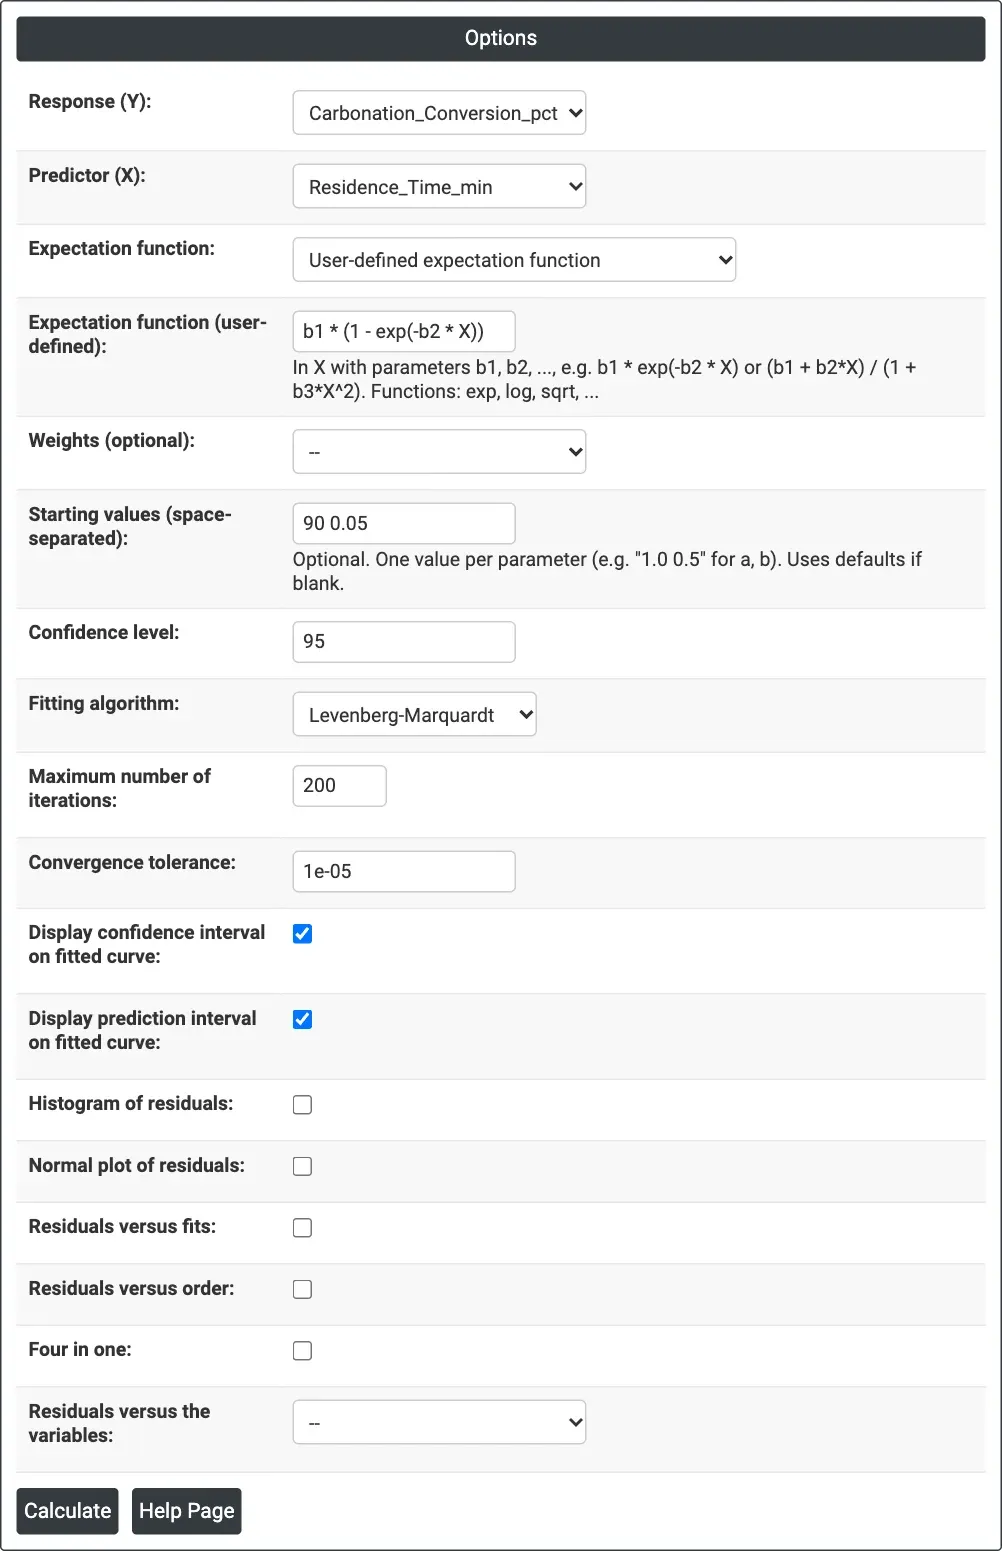
Figure 1 — Options de l'exemple de carbonatation : fonction définie par l'utilisateur b1 * (1 - exp(-b2 * X)) avec des valeurs initiales 90 et 0.05, bandes de confiance et de prédiction cochées.
Description des résultats
- Method — algorithme, nombre maximal d'itérations, tolérance et, pour Gauss-Newton, nombre d'itérations utilisées.
- Starting Values for Parameters — les valeurs de départ de l'ajustement.
- Regression Equation — la courbe ajustée avec les noms des colonnes.
- Parameter Estimates — Estimate, SE Estimate et limites de confiance pour chaque paramètre.
- Summary of Fit — Final SSE, DFE, MSE et S.
- Fitted Line Plot — données, courbe ajustée et bandes CI et PI facultatives.
- Correlation Matrix for Parameter Estimates.
- Lack-of-Fit — lignes d'erreur, de manque d'ajustement et d'erreur pure avec F et P, lorsque le prédicteur comporte des valeurs répétées.
- Graphiques des résidus, s'ils sont sélectionnés.
- Export PDF via Download.
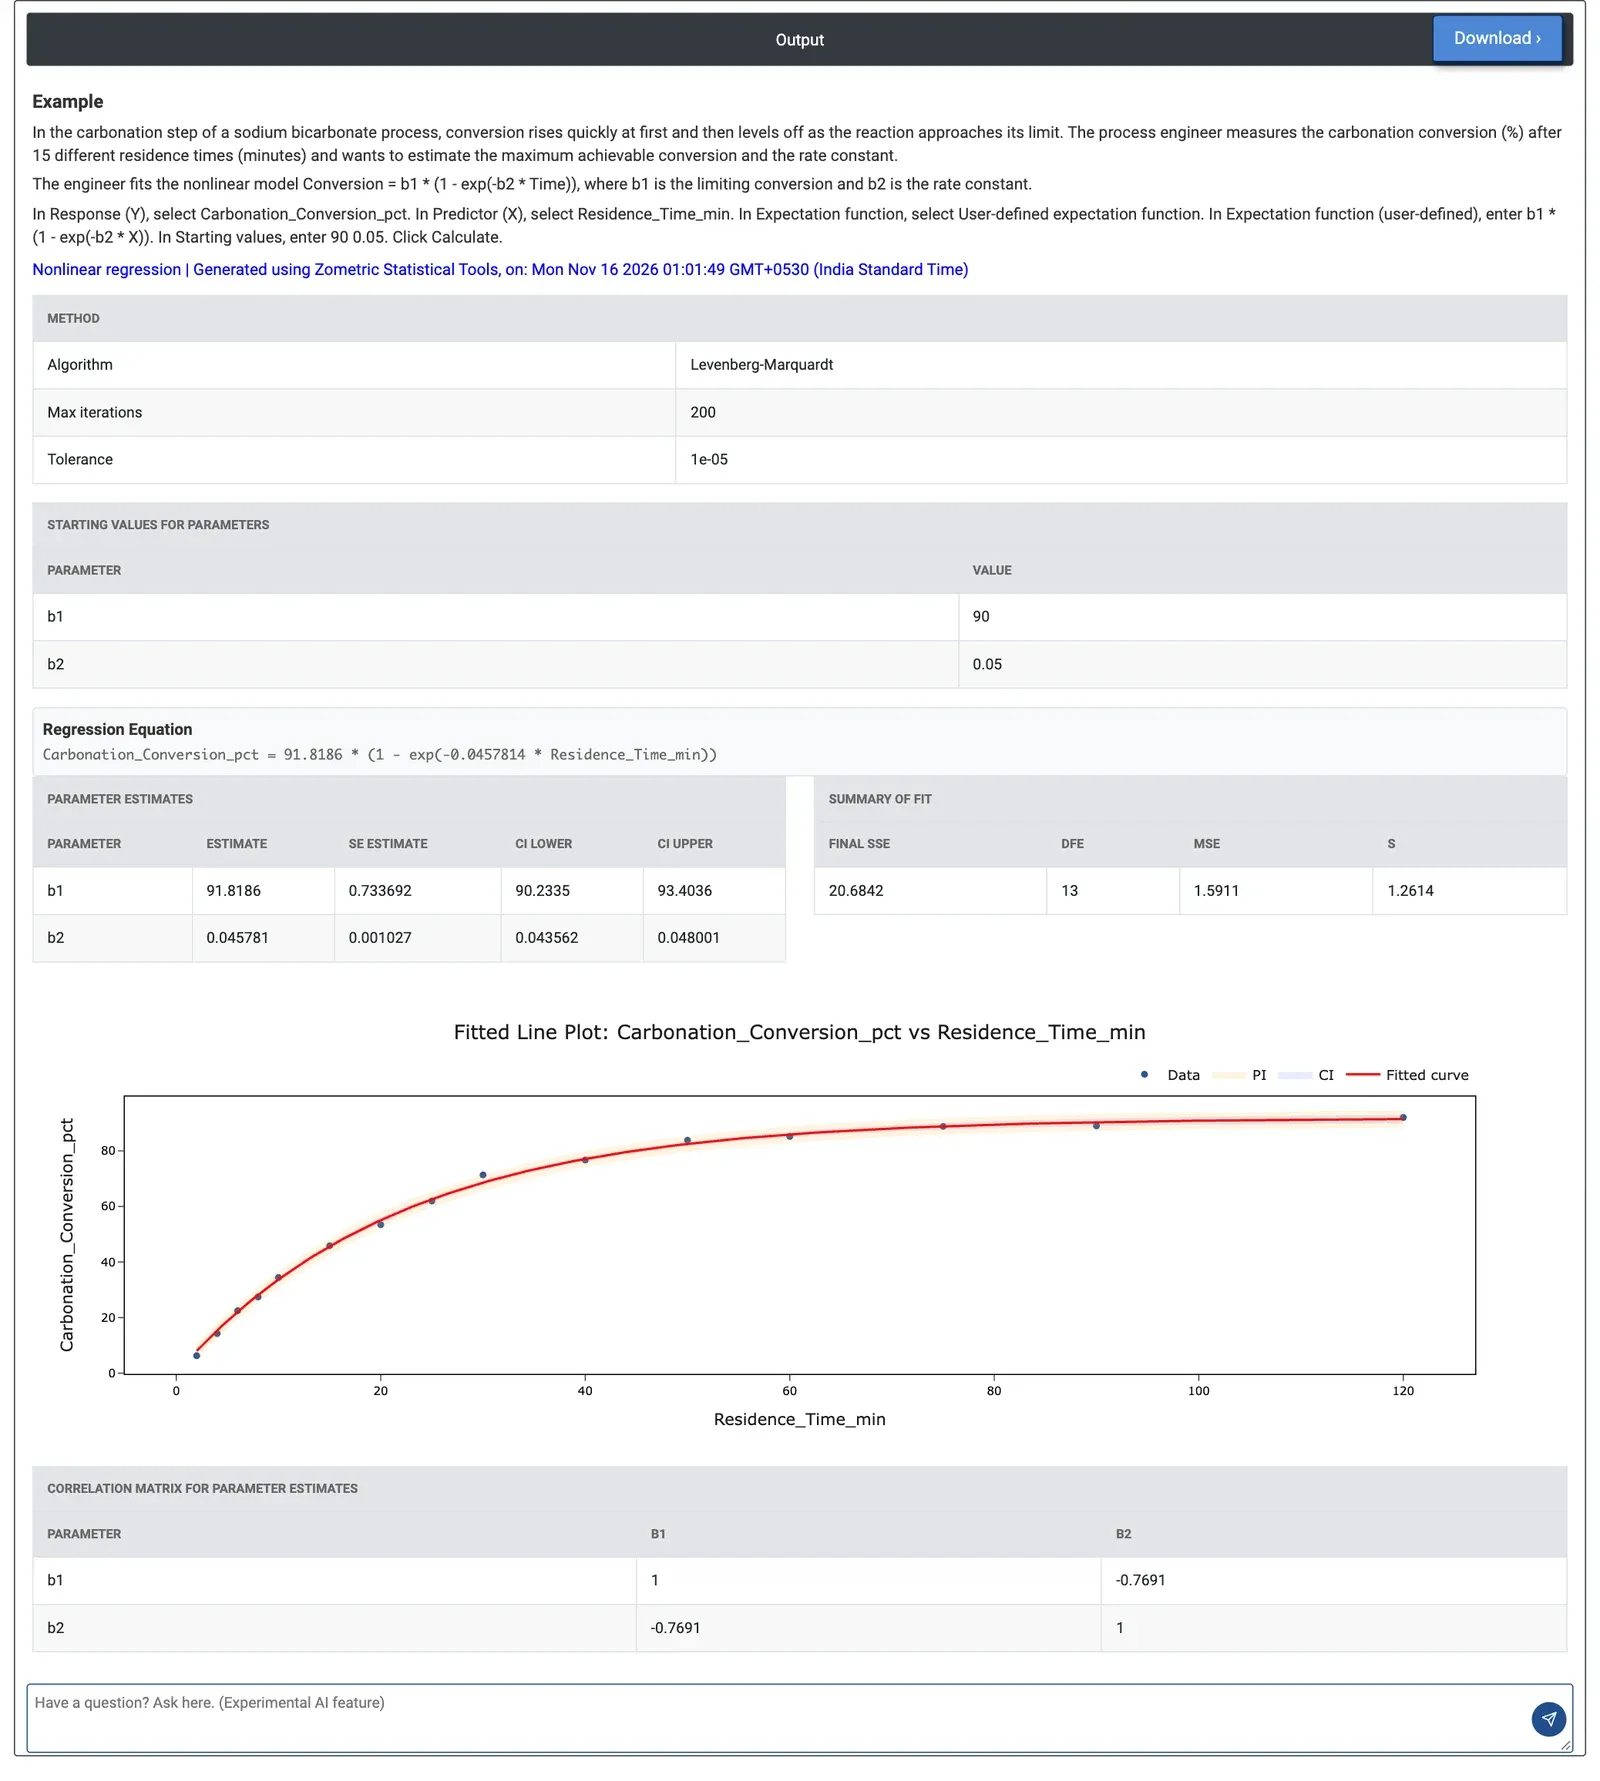
Figure 2 — Conversion de carbonatation en fonction du temps de séjour : conversion limite b1 = 91.82% et constante de vitesse b2 = 0.0458 par minute, S = 1.26.
Exemple résolu
Dans l'étape de carbonatation d'un procédé au bicarbonate de sodium, la conversion augmente rapidement puis se stabilise. Un ingénieur procédés mesure la conversion (%) à 15 temps de séjour de 2 à 120 minutes et veut connaître la conversion limite et la constante de vitesse. Il saisit le modèle du premier ordre Conversion = b1·(1 − exp(−b2·Time)) comme fonction définie par l'utilisateur, donne les valeurs initiales 90 et 0.05 et coche les deux bandes.
L'ajustement converge vers b1 = 91.82% (IC à 95 % de 90.23 à 93.40) et b2 = 0.0458 par minute (IC à 95 % de 0.0436 à 0.0480). S vaut 1.26 point de pourcentage, faible par rapport à une plage de 6 à 92 %, et les points se placent sur la courbe sur toute sa longueur. La corrélation entre b1 et b2 est de −0.77 : modérée, donc les deux paramètres sont bien déterminés. Gauss-Newton donne les mêmes estimations en 3 itérations. Sans temps de séjour répétés, aucun test de manque d'ajustement n'est affiché.
D'après la courbe ajustée, 90 % de la conversion limite est atteint à ln(10)/b2 ≈ 50 minutes et 95 % à environ 65 minutes ; à 30 minutes, la conversion n'est que d'environ 69 %. Des temps de séjour bien supérieurs à une heure apportent peu de conversion supplémentaire, ce qui aide l'ingénieur à fixer le débit de la tour.
Questions fréquentes
Qu'est-ce que la régression non linéaire ?
La régression non linéaire ajuste, sur une réponse et un prédicteur, une courbe dont les paramètres n'interviennent pas linéairement, comme une approche exponentielle d'une limite, une courbe de saturation ou une courbe de croissance en S. Elle trouve les valeurs de paramètres qui minimisent la somme des carrés des erreurs et les restitue avec erreurs-types et intervalles de confiance.
Quand utiliser la régression non linéaire ?
Utilisez la régression non linéaire lorsque la physique ou la chimie du procédé vous indique la forme de la courbe et que vous voulez des estimations de ses paramètres, comme une valeur limite ou une constante de vitesse. Les formes intégrées comprennent la décroissance et la croissance exponentielles, la puissance, la logistique à 3 paramètres, Michaelis-Menten, Gompertz et la quadratique, ou vous pouvez définir votre propre fonction.
Pourquoi les valeurs initiales comptent-elles en régression non linéaire ?
L'ajustement est itératif : il part donc de valeurs initiales. Les fonctions intégrées utilisent des valeurs par défaut fixes, tandis qu'une fonction définie par l'utilisateur exige une valeur initiale par paramètre. Des valeurs proches de ce que vous attendez aident l'ajustement à converger ; de mauvaises valeurs initiales peuvent faire échouer l'ajustement ou le faire se fixer sur un mauvais minimum local.
Comment savoir si un ajustement de régression non linéaire est fiable ?
Vérifiez S et la proximité des points par rapport à la courbe, et examinez les graphiques des résidus. Les intervalles de confiance sont approximatifs et deviennent peu fiables si les paramètres sont mal déterminés, ce qui se manifeste par des corrélations proches de plus ou moins 1 dans la matrice de corrélation des paramètres. Lorsque des valeurs du prédicteur sont répétées, un test F de manque d'ajustement vérifie si la courbe choisie s'ajuste.