
OECD
L'outil OECD Statistical Decision Tree est un système d'analyse statistique guidé, fondé sur le cadre décisionnel de sélection et d'application du test statistique adapté à des données expérimentales. Sans obliger l'utilisateur à parcourir manuellement une théorie statistique complexe, l'outil suit automatiquement le cheminement décisionnel de l'OCDE (OECD) en évaluant à chaque étape le type de données, la normalité, l'homogénéité des variances et le nombre de groupes, puis applique le test approprié.
Dernière révision
Point clé
L'outil OECD Statistical Decision Tree est un système d'analyse statistique guidé, fondé sur le cadre décisionnel de sélection et d'application du test statistique adapté à des données expérimentales.
Sur cette page
- Qu'est-ce que OECD ?
- Quand utiliser OECD ?
- Étape 1 — Évaluation du type de données
- Étape 2 — Vérification de la normalité (données continues)
- Étape 3 — Cheminement paramétrique
- Étape 4 — Cheminement non paramétrique
- Recommandations pour bien utiliser OECD
- Alternatives : quand ne pas utiliser OECD
- Exemple de OECD
- Comment utiliser OECD
Qu'est-ce que OECD ?
L'outil OECD Statistical Decision Tree est un système d'analyse statistique guidé, fondé sur le cadre décisionnel de sélection et d'application du test statistique adapté à des données expérimentales. Sans obliger l'utilisateur à parcourir manuellement une théorie statistique complexe, l'outil suit automatiquement le cheminement décisionnel de l'OCDE (OECD) en évaluant à chaque étape le type de données, la normalité, l'homogénéité des variances et le nombre de groupes, puis applique le test approprié.
L'outil est conçu pour garantir que les conclusions statistiques sont scientifiquement valides, entièrement reproductibles et conformes aux lignes directrices reconnues au niveau international. C'est particulièrement crucial en toxicologie, en sciences de l'environnement, en recherche pharmaceutique et dans les études destinées à des dossiers réglementaires, où le choix du test statistique doit être documenté, justifié et défendable lors d'un audit.
Définition simple : un outil intelligent et automatisé qui suit pas à pas l'organigramme de décision statistique de l'OCDE en évaluant le type de vos données, leur distribution et la structure des groupes, pour sélectionner et appliquer automatiquement le test statistique adapté, de sorte que vous obtenez toujours un résultat valide et défendable.
Quand utiliser OECD ?
- L'approche par organigramme de l'OCDE s'utilise lorsque vous devez exécuter en une seule fois une chaîne complète de comparaisons statistiques, plutôt que de décider test par test au fur et à mesure. Au lieu de vous arrêter après chaque test pour déterminer la suite, vous fournissez d'emblée les caractéristiques de vos données (type de données, résultat de normalité, résultat sur les variances) et l'ensemble de l'arbre de décision se résout d'un coup.
- C'est avant tout un cadre de comparaison : il est conçu spécifiquement pour déterminer quel test statistique est approprié pour comparer des groupes (2 groupes ou 3 groupes et plus) entre eux ou à un témoin. Plutôt que de décider test par test à chaque étape, vous indiquez d'emblée les caractéristiques de vos données. Surtout utilisé dans le domaine pharmaceutique.
L'outil suit l'organigramme de l'OCDE dans une séquence logique stricte. Chaque étape produit une décision qui détermine la branche suivante du cheminement. Comprendre ce déroulement vous aide à interpréter les résultats de l'outil et à saisir pourquoi un test statistique particulier a été retenu pour vos données.
Étape 1 — Évaluation du type de données
Le premier point de décision détermine si vos données sont continues ou discrètes/quantales. Cette distinction commande tout le cheminement ultérieur.
Type de données
Description et exemples
Données continues
Valeurs numériques mesurées pouvant prendre n'importe quelle valeur dans un intervalle, comme le poids corporel, l'activité enzymatique, le poids d'un organe, une concentration ou des paramètres hématologiques. Pour les données continues, l'outil passe à une vérification de la normalité.
Données discrètes ou quantales
Comptages, pourcentages, proportions, rangs ou résultats qualitatifs, comme le nombre d'animaux atteints, l'incidence d'une lésion, la présence ou l'absence d'une réponse, ou des scores de gravité. L'outil passe directement à la sélection d'un test non paramétrique ou pour données qualitatives.
Étape 2 — Vérification de la normalité (données continues)
Pour les données continues, l'outil vérifie si les données suivent une distribution normale (en cloche) à l'aide des tests de normalité sélectionnés. Le résultat détermine le cheminement statistique suivi.
Si la normalité n'est PAS rejetée (p ≥ α) — les données sont normales :
→ L'outil suit le cheminement paramétrique.
→ Les tests paramétriques ont une plus grande puissance statistique et doivent toujours être utilisés lorsque la normalité est confirmée.
Si la normalité EST rejetée (p < α) — les données ne sont pas normales :
→ Une transformation des données est tentée (logarithme, racine carrée, etc.).
→ La normalité est vérifiée de nouveau sur les données transformées.
→ Si les données transformées sont normales → des tests paramétriques sont appliqués aux données transformées.
→ Si les données transformées ne sont toujours pas normales → l'outil passe au cheminement non paramétrique.
Étape 3 — Cheminement paramétrique
Une fois les données confirmées normales (ou transformées avec succès vers la normalité), l'outil détermine le test paramétrique approprié selon le nombre de groupes comparés.
Comparaison de 2 groupes
L'outil vérifie l'homogénéité des variances à l'aide du test F pour déterminer si les deux groupes ont des variances statistiquement égales.
Résultat d'homogénéité des variances
Test statistique appliqué
Variances égales (test F non significatif)
Le test t de Student est appliqué. C'est le test t à deux échantillons standard, qui suppose des variances égales dans les deux groupes.
Variances inégales (test F significatif)
La méthode de Satterthwaite (test t de Welch) est appliquée. Cette variante ne suppose pas l'égalité des variances et ajuste les degrés de liberté en conséquence.
Comparaison de 3 groupes ou plus
L'outil vérifie l'homogénéité des variances à l'aide du test de Bartlett, du test de Levene ou du test de Brown-Forsythe.
Résultat d'homogénéité des variances
Test statistique appliqué
Variances égales (non significatif)
L'analyse de la variance (ANOVA) est appliquée. → Si l'ANOVA est significative : le test de Dunnett est réalisé pour la comparaison par paires de chaque groupe traité au témoin. → Si l'ANOVA n'est pas significative : aucun test supplémentaire n'est nécessaire. Arrêt.
Variances inégales (significatif)
L'outil passe directement au test approprié qui ne suppose pas l'homogénéité des variances.
Étape 4 — Cheminement non paramétrique
Lorsque les données ne peuvent pas être normalisées, ou lorsqu'elles se composent de comptages, de pourcentages ou de rangs, l'outil suit le cheminement non paramétrique.
Situation des données
Test appliqué
Résultat / suite
Données de comptage / pourcentage / rang, ≥ 3 groupes
Test de Kruskal-Wallis
Si significatif → test de Dunn (post hoc). Si non significatif → arrêt.
Données de comptage / pourcentage / rang, 2 groupes
Test U de Mann-Whitney
Comparaison directe entre deux groupes indépendants.
Données qualitatives ou indices
Test du khi-deux
Le choix du test dépend de la structure précise des données et du plan de l'étude.
Recommandations pour bien utiliser OECD
- Veillez à saisir les données correctement et de façon cohérente : les erreurs de saisie à l'étape d'entrée se propagent à chaque décision ultérieure de l'arbre et peuvent conduire à l'application d'un test inadapté.
- Sélectionnez les colonnes de réponse avec soin : si plusieurs réponses sont sélectionnées, chaque colonne doit représenter un jeu de données de groupe complet et indépendant. Si une seule réponse est sélectionnée, assurez-vous que la colonne de facteur identifie correctement et complètement l'appartenance de chaque observation à un groupe.
- Gardez actifs les deux tests de normalité, Anderson-Darling et Shapiro-Wilk (réglage par défaut). Le fait que deux tests indépendants confirment la même conclusion de normalité renforce la défendabilité scientifique du cheminement retenu.
Alternatives : quand ne pas utiliser OECD
- Si votre étude n'exige pas la conformité aux lignes directrices de l'OCDE et n'a pas de contexte réglementaire, utilisez directement le test statistique spécifique le plus approprié : le cadre de l'arbre de décision de l'OCDE ajoute une lourdeur structurée qui peut être inutile pour des analyses purement exploratoires ou académiques.
- Si votre étude nécessite une régression, une analyse de corrélation ou une modélisation dose-réponse plutôt qu'une simple comparaison de groupes, utilisez les outils de régression ou de modélisation appropriés : l'outil OECD est conçu spécifiquement pour la comparaison de moyennes entre groupes, et non pour ajuster des relations entre variables continues.
- Si vous avez des observations appariées (par exemple des mesures avant et après sur un même sujet), utilisez le test t apparié ou le test des rangs signés de Wilcoxon . L'arbre de décision de l'OCDE tel qu'il est mis en œuvre ici suppose des groupes indépendants.
- Si les données sont de nature chronologique ou longitudinale (mesures qui évoluent sur plusieurs temps successifs), utilisez une ANOVA à mesures répétées, des modèles à effets mixtes ou une analyse de séries temporelles
- Si l'objectif analytique principal est un test d'équivalence ou une évaluation de non-infériorité plutôt que la détection d'une différence, utilisez des procédures de test d'équivalence dédiées plutôt que le cadre de supériorité standard de l'arbre de décision de l'OCDE.
Exemple de OECD
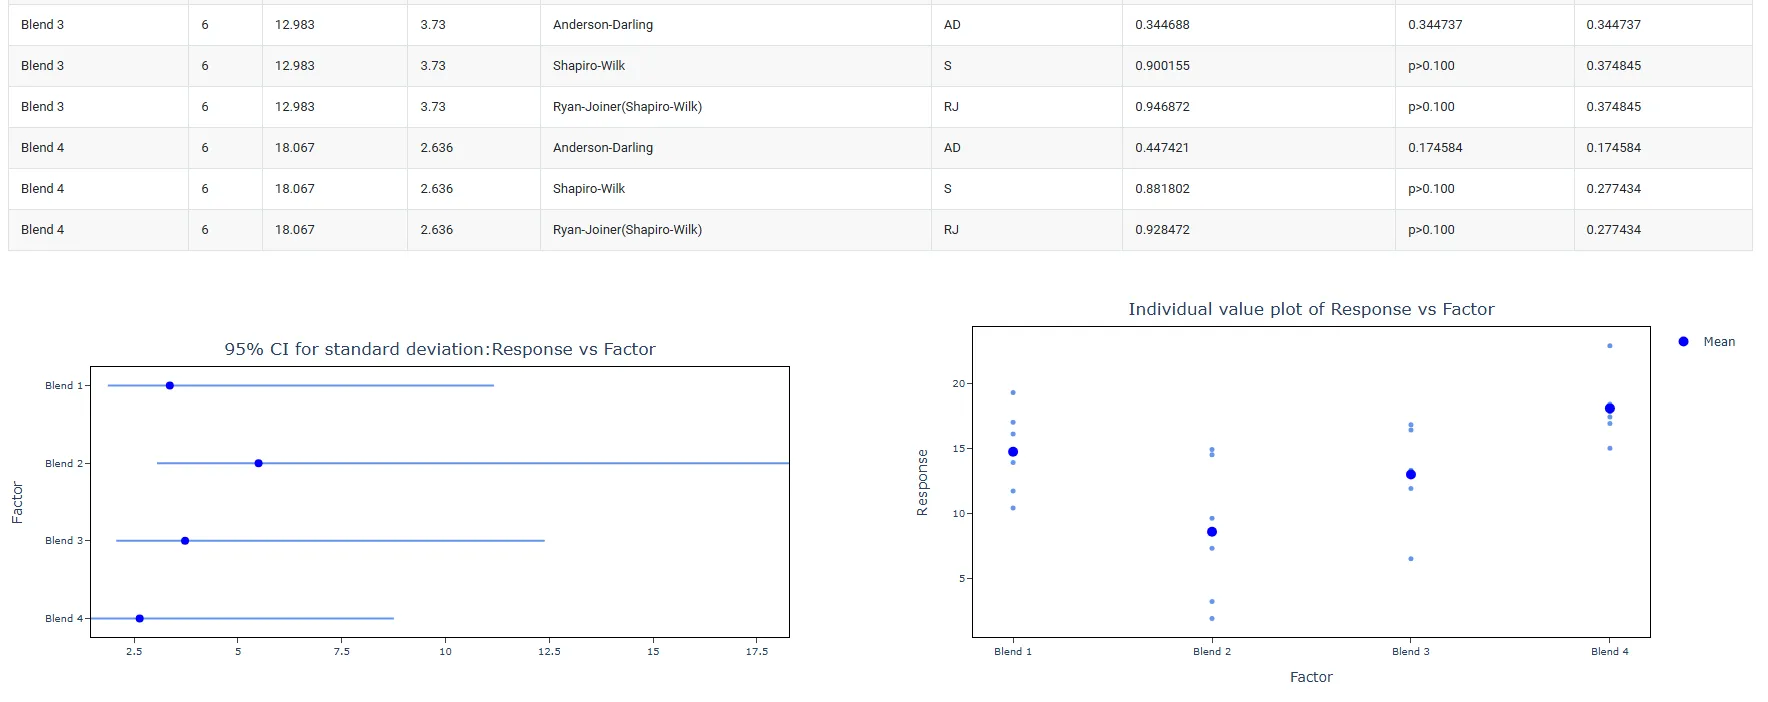
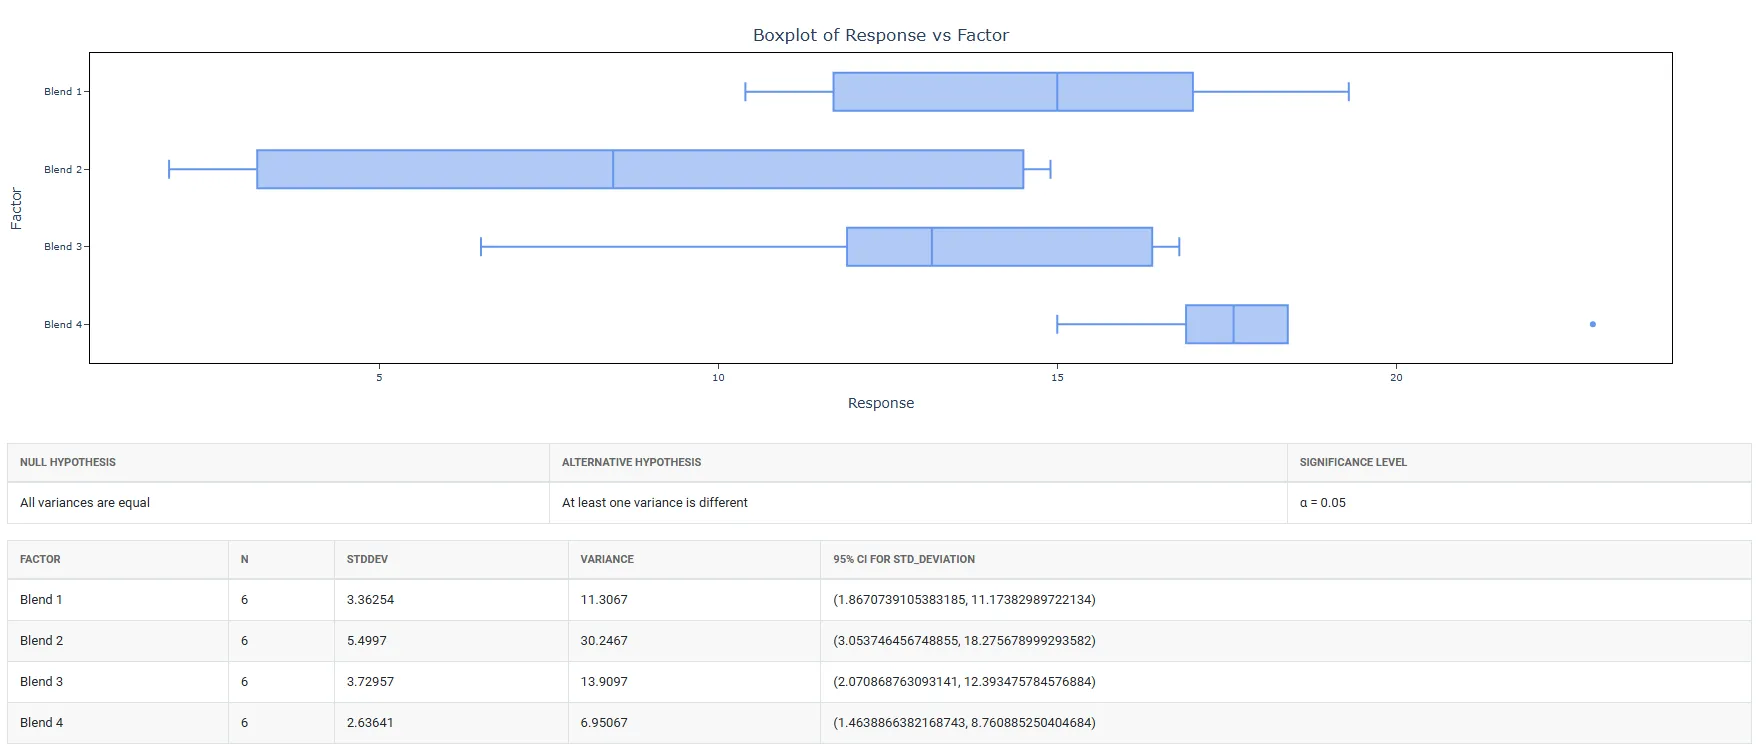
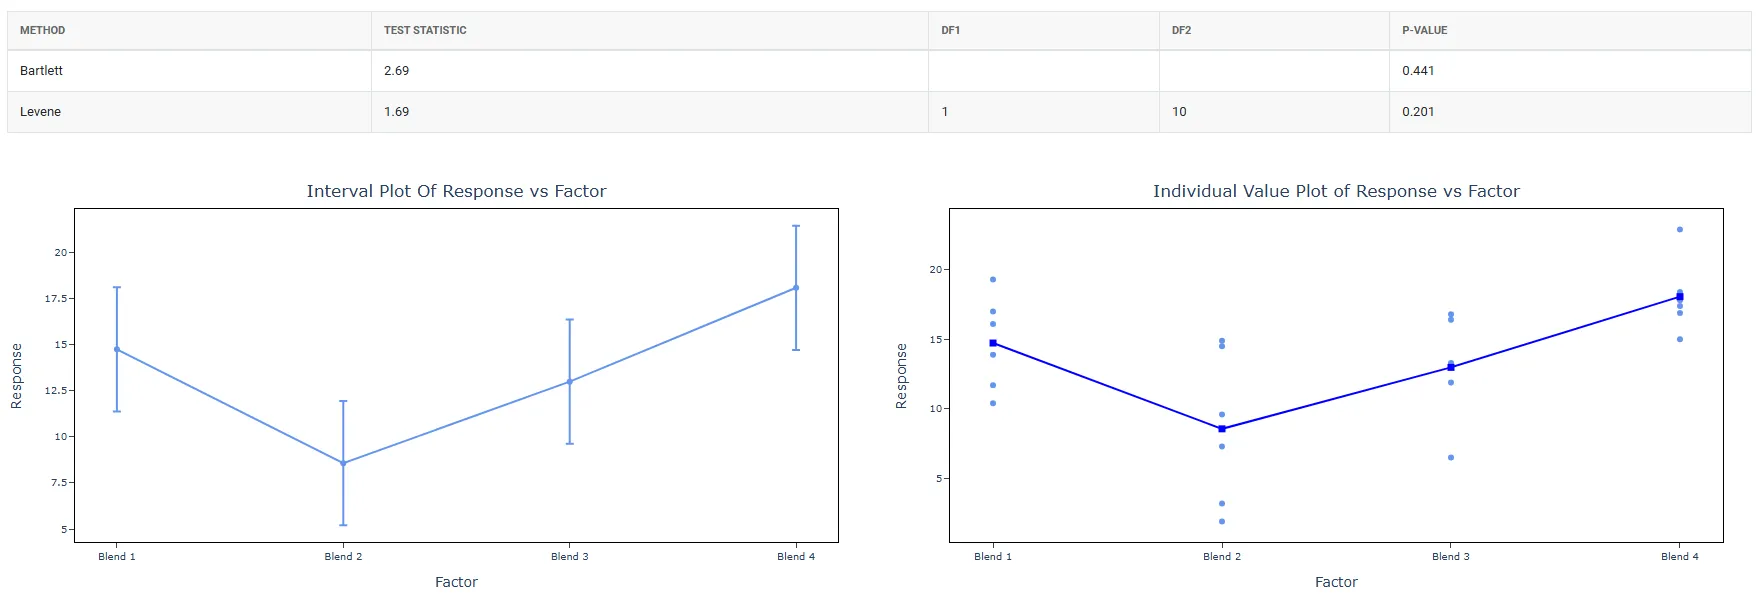
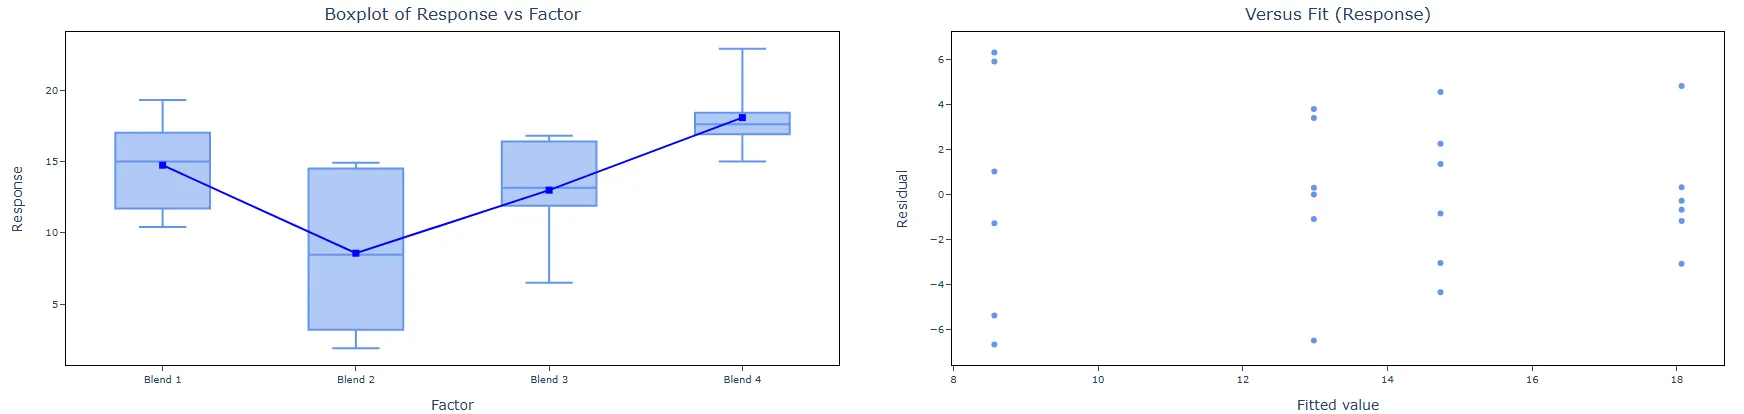
Un ingénieur chimiste veut comparer la dureté de quatre mélanges de peinture. Six échantillons de chaque mélange ont été appliqués sur une pièce métallique, puis cuits. La dureté de chaque échantillon a ensuite été mesurée. Les étapes sont les suivantes :
- Rassemblez les données nécessaires.
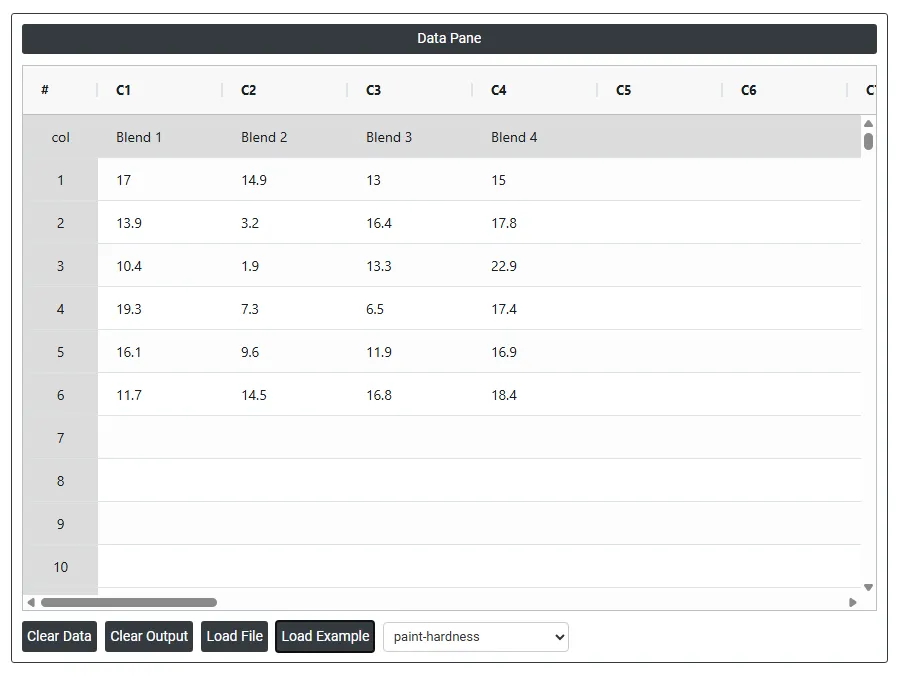
2. Analysez ensuite les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
3. Pour trouver OECD, choisissez Statistical module> OECD>OECD.
4. Dans l'outil, saisissez les données et les autres paramètres comme suit :
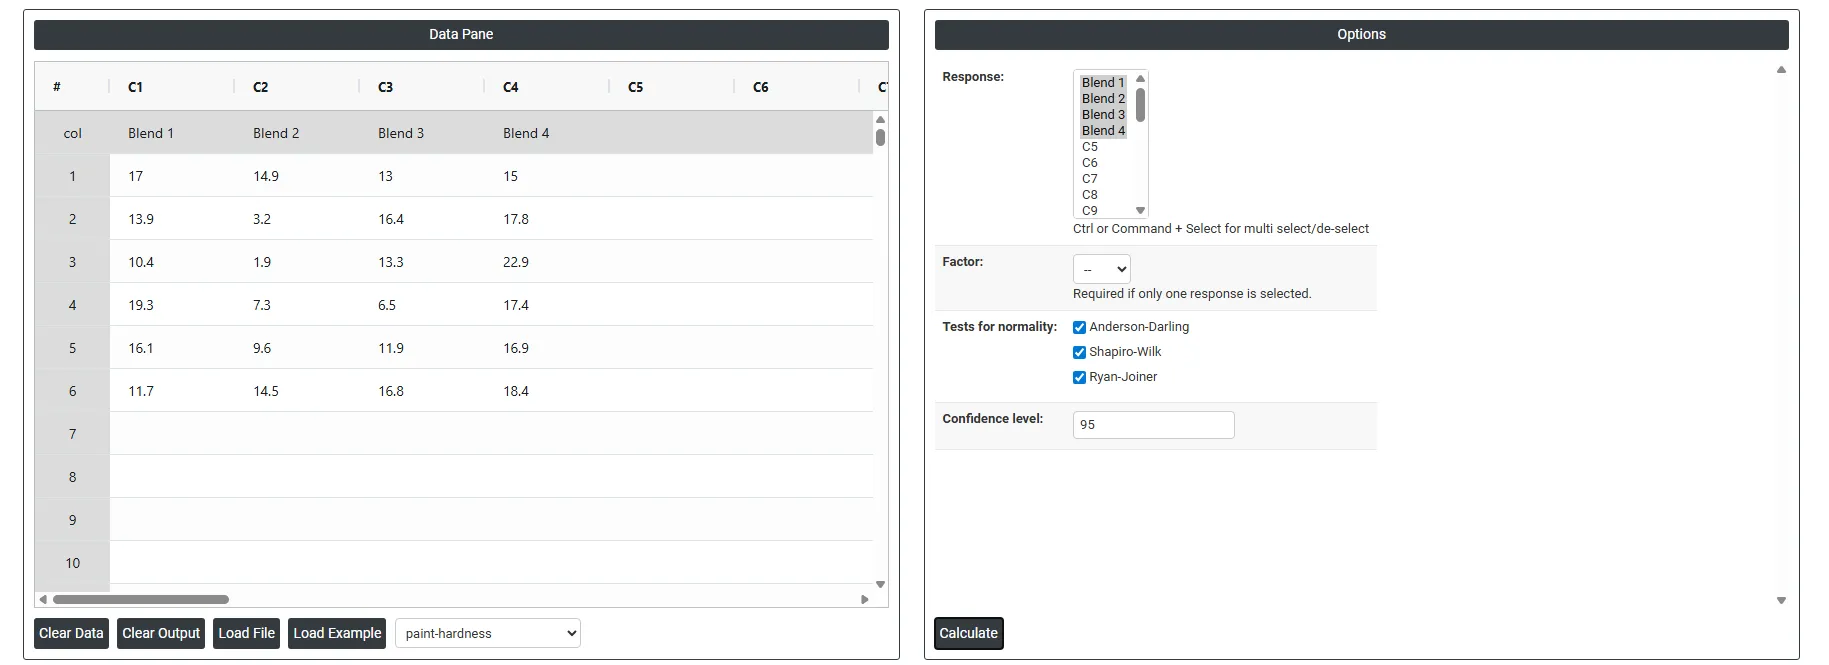
5. Après utilisation de l'outil ci-dessus, les résultats obtenus sont les suivants :
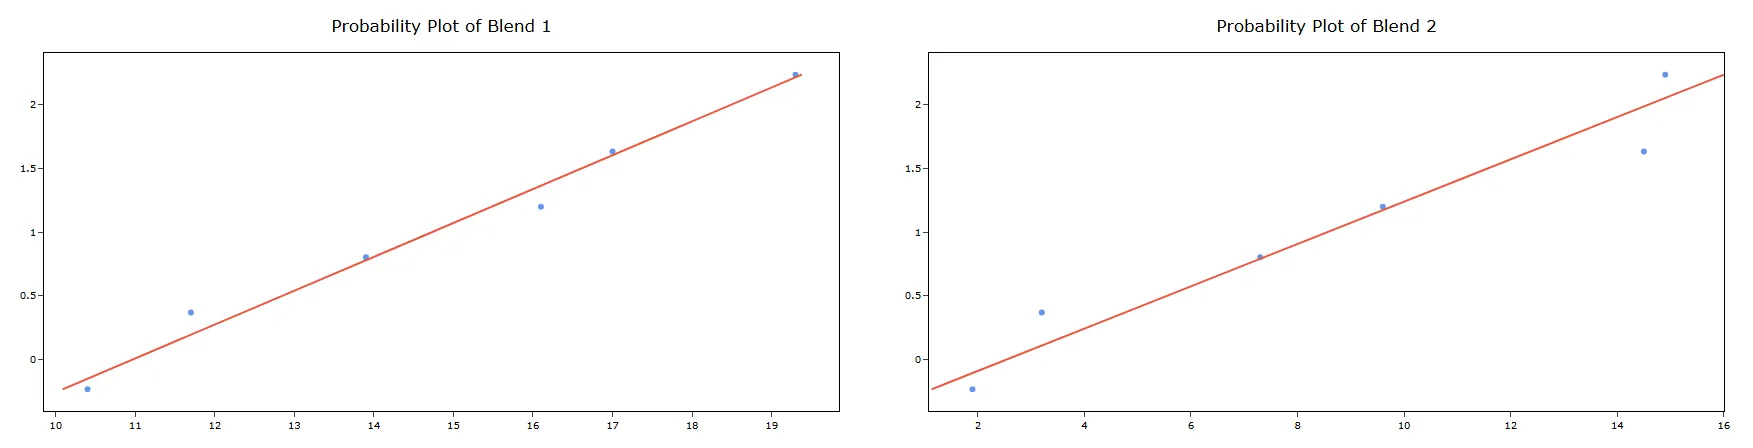
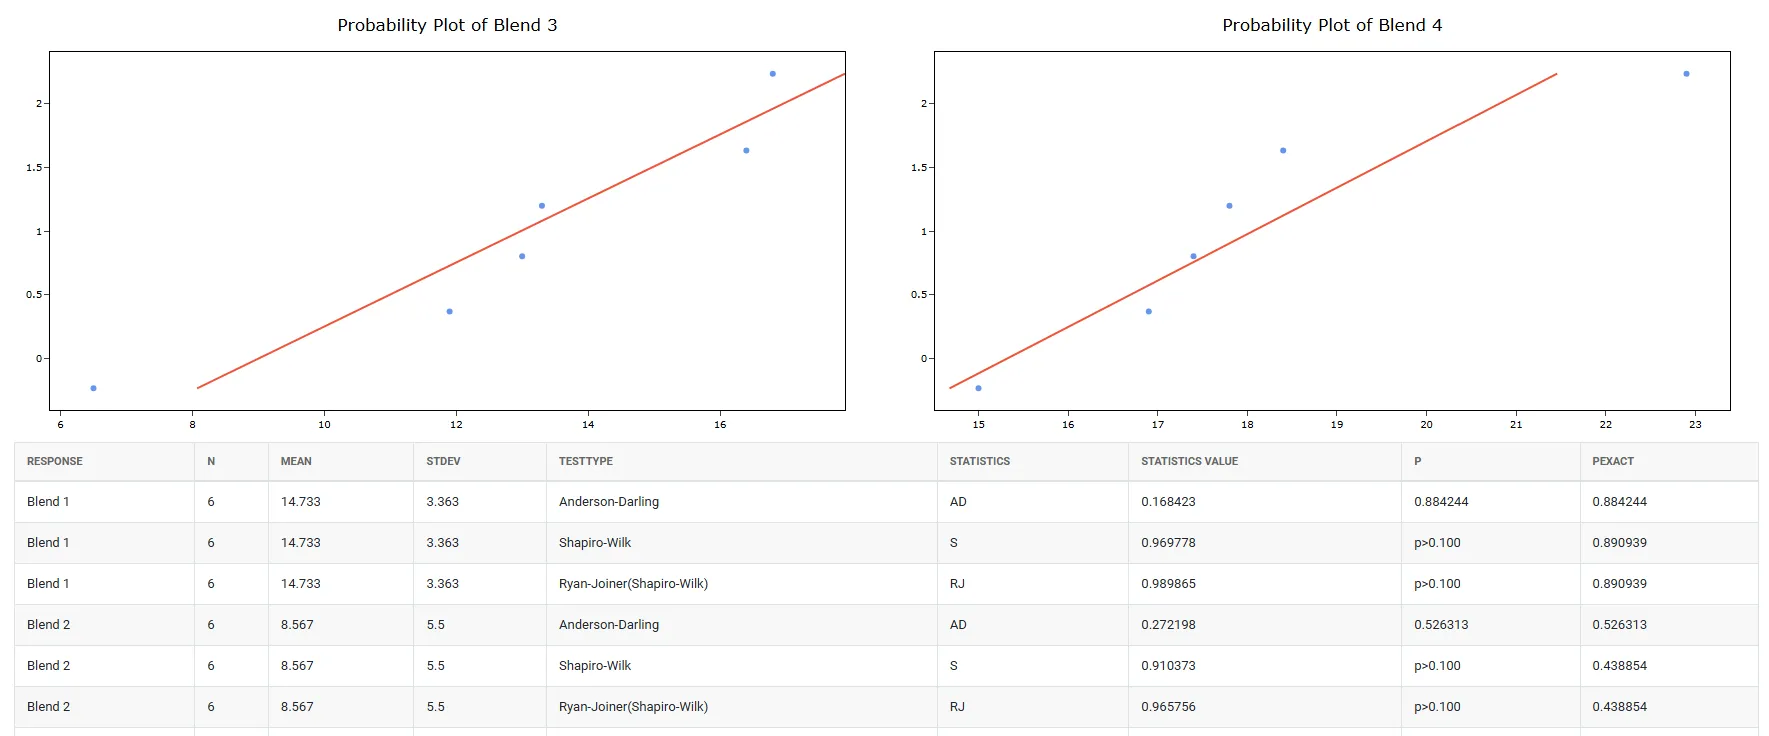
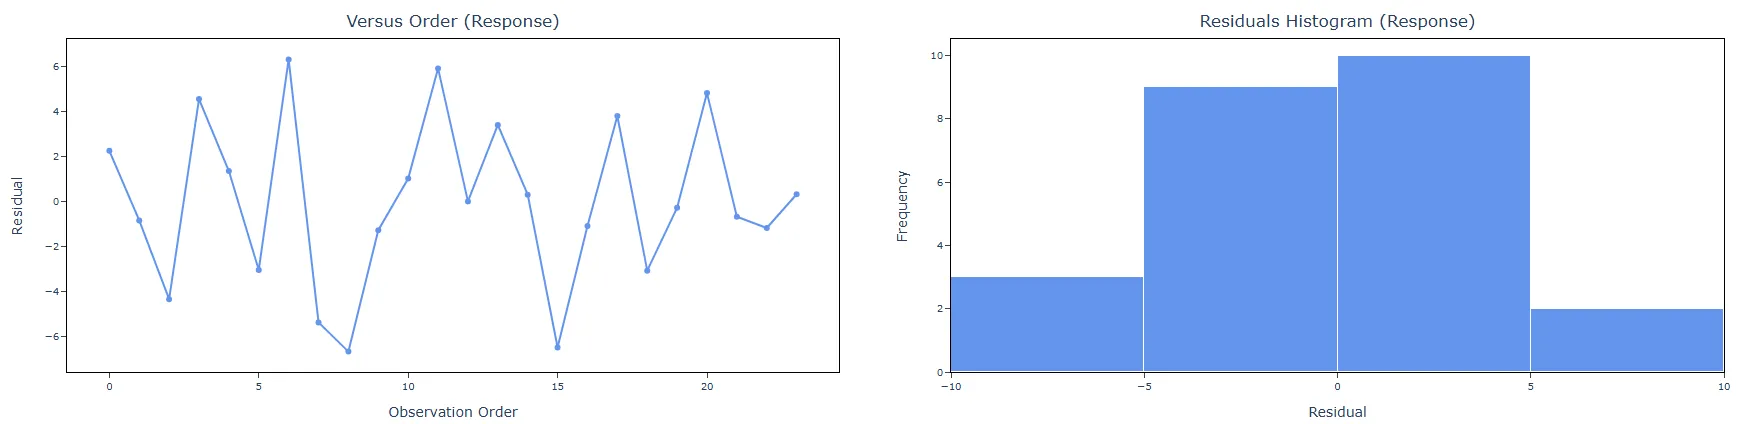
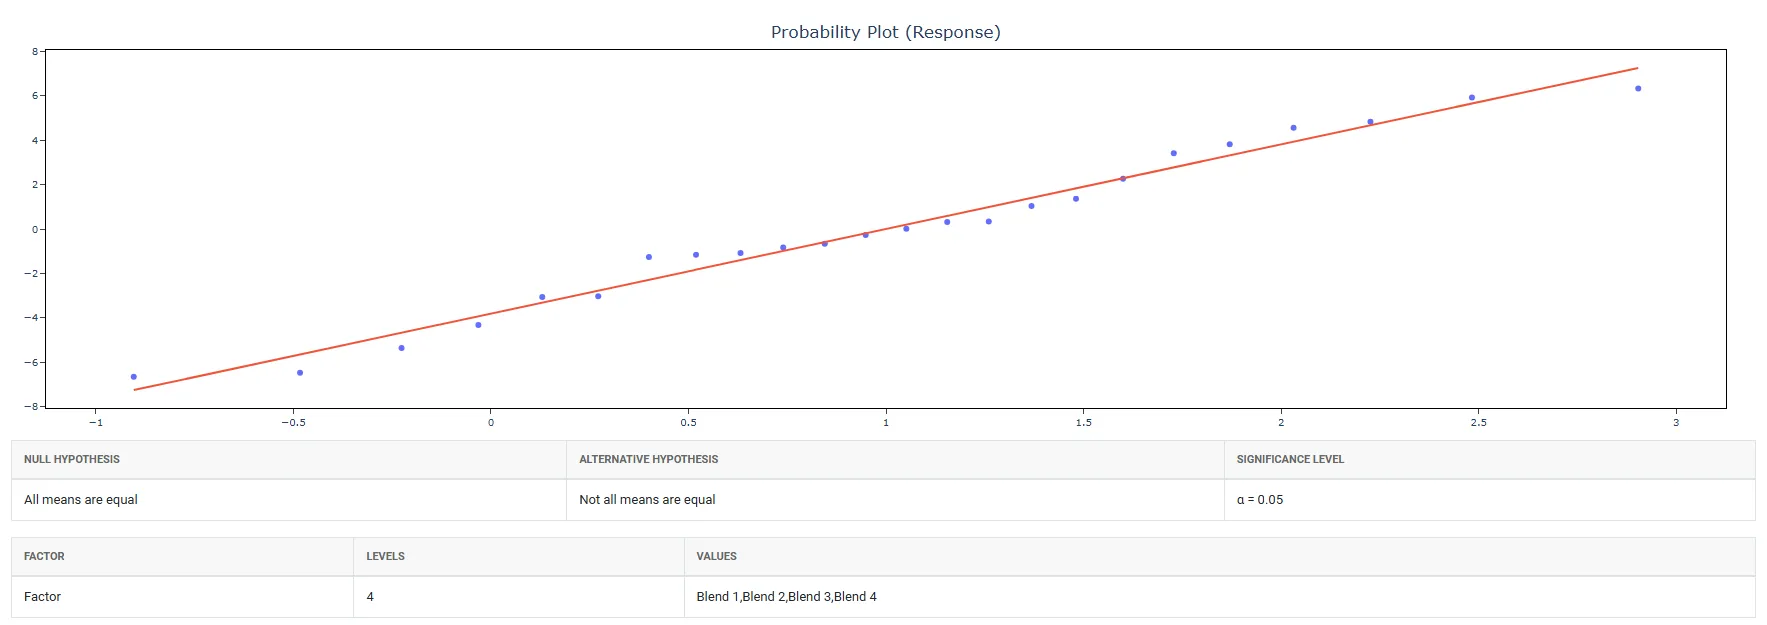
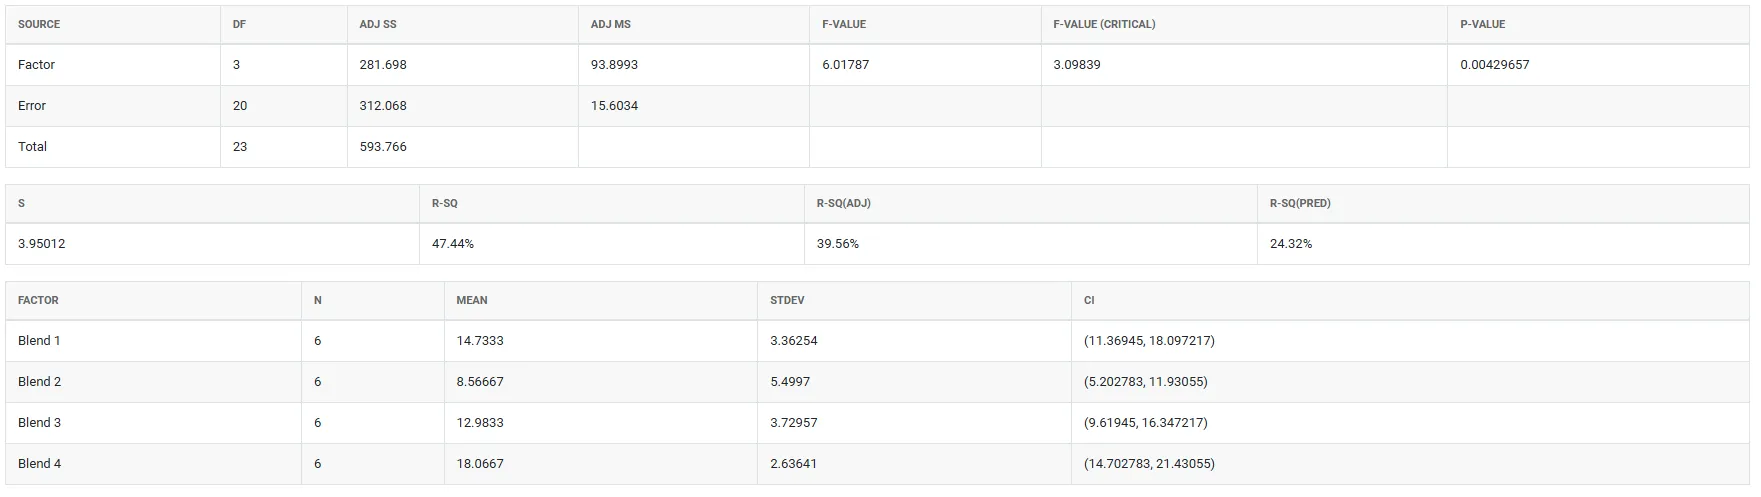
Comment utiliser OECD
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> OECD>OECD.
- Ensuite, saisissez les données manuellement, copiez-les (Ctrl+C) depuis une feuille Excel et collez-les (Ctrl+V), ou encore utilisez l'option Load Example pour charger les données d'exemple.
- Ensuite, renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Dans le tableau de bord de OECD, la fenêtre est divisée en deux parties.
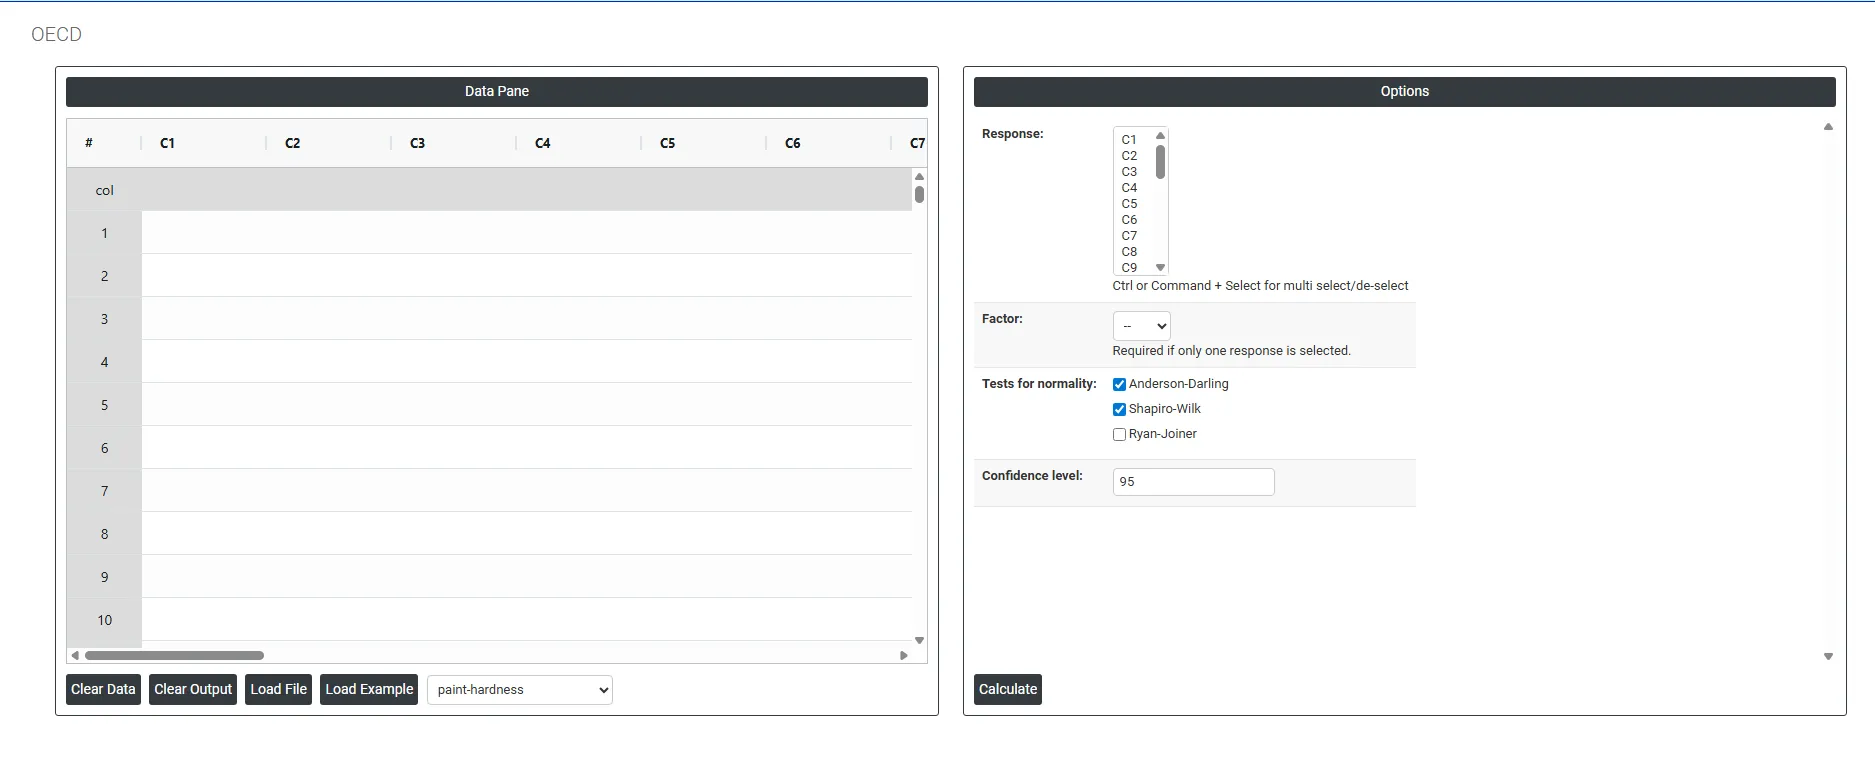
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement ou entièrement copiées (Ctrl+C) depuis une feuille Excel puis collées (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File : permet de charger directement des données Excel.
Dans la partie droite se trouvent de nombreuses options, comme suit :
- Response : sélectionnez la ou les colonnes contenant les mesures de résultat que vous voulez analyser, comme le poids corporel, l'activité enzymatique, l'incidence tumorale, des valeurs hématologiques ou tout autre critère enregistré entre les groupes de l'étude. Utilisez Ctrl ou Command + clic pour sélectionner simultanément plusieurs colonnes de réponse.
Le nombre de colonnes de réponse sélectionnées détermine directement si l'option Factor est requise :
Sélection
Comportement de l'outil
Plusieurs réponses sélectionnées
Chaque colonne sélectionnée représente un groupe distinct. L'outil utilise les colonnes elles-mêmes pour définir les groupes : aucune colonne Factor supplémentaire n'est nécessaire. Les mesures de chaque colonne sont comparées directement entre elles.
Une seule réponse sélectionnée
Toutes les mesures sont empilées dans une seule colonne et une colonne Factor distincte doit être sélectionnée pour identifier le groupe auquel appartient chaque mesure. Sans la colonne Factor, l'outil ne peut pas déterminer quelles observations appartiennent à quel groupe.
⚠ Important : lorsqu'une seule réponse est sélectionnée, le champ Factor devient obligatoire. L'outil vous invite à sélectionner une colonne Factor avant que l'analyse puisse se poursuivre.
- Factor : sélectionnez la colonne qui identifie l'appartenance de chaque observation à un groupe. Cette colonne contient des libellés ou codes qualitatifs indiquant à quel groupe expérimental appartient chaque ligne de données, par exemple Control, Low Dose, Mid Dose, High Dose, ou Group 1, Group 2, Group 3. La colonne de facteur indique à l'outil comment scinder la colonne de réponse unique en groupes distincts à comparer. Sans facteur correctement indiqué, toutes les mesures seraient traitées comme appartenant au même groupe et aucune comparaison significative ne serait possible. Ce champ n'est requis que lorsqu'exactement une colonne de réponse est sélectionnée. Lorsque plusieurs colonnes de réponse sont sélectionnées, chaque colonne représente un groupe et aucun Factor n'est nécessaire. Le champ est grisé ou ignoré lorsque plusieurs réponses sont sélectionnées
- Tests for Normality : définit le ou les tests statistiques utilisés à l'étape 2 de l'arbre de décision pour évaluer si les données de réponse suivent une distribution normale. Le résultat de ce test détermine si le cheminement analytique paramétrique ou non paramétrique est suivi pour toute l'analyse. Trois tests sont disponibles :
- Anderson-Darling : un test de normalité omnibus puissant qui met particulièrement l'accent sur les queues de la distribution, c'est-à-dire les valeurs extrêmes hautes et basses. Il est donc particulièrement sensible aux écarts à la normalité dans les queues, qui sont souvent les zones les plus importantes en pratique dans les données toxicologiques et environnementales. Le test d'Anderson-Darling est recommandé pour un usage général sur un large éventail d'effectifs d'échantillon et est particulièrement efficace lorsque le comportement des queues est censé différer de la distribution normale.
- Shapiro-Wilk : largement considéré comme le test de normalité le plus puissant et le plus fiable pour les petits effectifs d'échantillon (typiquement n < 50), situation la plus courante dans les études selon les lignes directrices de l'OCDE, où la taille des groupes est souvent de 5 à 20 animaux. Le test de Shapiro-Wilk est le principal test de normalité cité dans les recommandations statistiques de l'OCDE et le choix standard en statistique pharmaceutique et toxicologique. Il est vivement recommandé de toujours le garder actif dans les analyses d'études réglementaires.
- Ryan-Joiner : un test de normalité fondé sur la corrélation, qui évalue dans quelle mesure les données suivent le schéma attendu d'une distribution normale en mesurant la corrélation entre les données observées et les quantiles théoriques de la loi normale. Il est conceptuellement proche du test de Shapiro-Wilk mais utilise une approche de calcul différente. Moins souvent exigé dans les travaux réglementaires, il peut être activé lorsqu'une évaluation de la normalité fondée sur la corrélation est expressément demandée ou préférée par l'autorité chargée de l'examen.
- Lorsque plusieurs tests de normalité sont sélectionnés, l'outil exécute tous les tests cochés et rapporte tous les résultats. La décision globale de normalité repose sur le résultat le plus prudent : si l'un des tests sélectionnés indique une non-normalité (p < α), les données sont traitées comme non normales et le cheminement non paramétrique est suivi
Confidence Level (Default: 95) : définit le seuil de signification utilisé de façon cohérente pour chaque test d'hypothèse tout au long de l'arbre de décision, y compris le test de normalité, le test d'homogénéité des variances et le test final de comparaison des groupes. La valeur saisie représente le niveau de confiance en pourcentage, et le niveau alpha (α) correspondant utilisé pour toutes les décisions est calculé comme (100 − Confidence Level) ÷ 100.
Confidence Level
Niveau alpha et quand l'utiliser
95 (par défaut)
Alpha = 0.05. Le niveau de confiance standard pour la plupart des études scientifiques et réglementaires de l'OCDE. Il existe un risque de 5 % de conclure à tort à un effet (faux positif). C'est le niveau le plus souvent exigé par les lignes directrices de l'OCDE et les autorités réglementaires dans le monde entier.
99
Alpha = 0.01. Test plus prudent : il faut des preuves plus fortes avant de déclarer un résultat significatif. Réduit les faux positifs mais peut manquer des effets réels plus faibles. À utiliser lorsque les conséquences d'un faux positif sont particulièrement graves.
90
Alpha = 0.10. Test plus sensible : il détecte de plus petites différences mais augmente le risque de conclusions faussement positives. À réserver aux études exploratoires ou pilotes où manquer un effet réel est la principale crainte.
Questions fréquentes
Qu'est-ce que l'arbre de décision statistique de l'OCDE ?
L'outil OECD Statistical Decision Tree est un système d'analyse guidé qui sélectionne et applique le test statistique adapté à des données expérimentales. Il suit le cheminement décisionnel de l'OCDE en évaluant à chaque étape le type de données, la normalité, l'homogénéité des variances et le nombre de groupes, de sorte que les conclusions sont reproductibles et défendables. Il est utilisé en toxicologie, en sciences de l'environnement, en recherche pharmaceutique et pour les dossiers réglementaires.
Quels tests l'arbre de décision de l'OCDE applique-t-il à des données normales ?
Pour deux groupes, un test F vérifie les variances : des variances égales conduisent au test t de Student et des variances inégales à la méthode de Satterthwaite (test t de Welch). Pour trois groupes ou plus, le test de Bartlett, de Levene ou de Brown-Forsythe vérifie les variances ; avec des variances égales, l'ANOVA est appliquée, suivie du test de Dunnett par rapport au témoin si l'ANOVA est significative.
Que se passe-t-il lorsque les données ne sont pas normales dans l'arbre de décision de l'OCDE ?
Si la normalité est rejetée, une transformation telle que le logarithme ou la racine carrée est tentée et la normalité est vérifiée de nouveau. Si les données transformées ne sont toujours pas normales, le cheminement non paramétrique est suivi : Kruskal-Wallis avec le test post hoc de Dunn pour trois groupes ou plus, le test U de Mann-Whitney pour deux groupes, et le khi-deux pour des données qualitatives ou des indices.
Quand ne pas utiliser l'arbre de décision de l'OCDE ?
Ne l'utilisez pas pour des observations appariées, qui requièrent un test t apparié ou le test des rangs signés de Wilcoxon, pour la régression ou la modélisation dose-réponse, pour des données chronologiques ou longitudinales, ni pour des tests d'équivalence et de non-infériorité. Sans contexte réglementaire OCDE, utiliser directement le test spécifique le plus approprié peut être plus simple.