
Test d'équivalence à 1 échantillon (TOST)
Le test d'équivalence à 1 échantillon vérifie si une moyenne est assez proche d'une cible, dans des limites fixées à l'avance, par exemple une activité à plus ou moins 5 % de la valeur d'étiquette. Il exécute deux tests t unilatéraux ; l'équivalence est établie lorsque les deux valeurs p sont inférieures à alpha. Il suppose des données indépendantes et à peu près normales. Les résultats comprennent les statistiques descriptives, l'intervalle de confiance d'équivalence, le tableau du test et un graphique d'équivalence.
Dernière révision
Point clé
Le test d'équivalence à 1 échantillon utilise deux tests t unilatéraux (TOST) pour montrer si une moyenne d'échantillon se situe dans des limites préfixées autour d'une cible, preuve positive que l'écart est trop faible pour compter.
Sur cette page
Objectif
Le test d'équivalence à 1 échantillon montre si la moyenne d'un échantillon est assez proche d'une cible, dans des limites que vous fixez à l'avance. Un test t à 1 échantillon peut seulement dire si la moyenne diffère de la cible ; un test t non significatif ne prouve pas que la moyenne est sur la cible. Le test d'équivalence inverse la question : l'hypothèse nulle est que la moyenne se situe hors des limites, de sorte qu'un résultat significatif est une preuve positive que l'écart est trop faible pour compter. Utilisez-le pour des questions comme : l'activité moyenne d'un lot est-elle à ±5 % de la valeur d'étiquette, ou la moyenne d'un procédé se situe-t-elle dans une bande convenue autour de la valeur nominale ?
Principales fonctionnalités
- Deux tests unilatéraux (TOST) pour Lower limit < test mean − target < upper limit, avec l'intervalle de confiance pour l'équivalence.
- Alternatives unilatérales : écart supérieur à la limite inférieure, écart inférieur à la limite supérieure, ou moyenne d'essai supérieure ou inférieure à la cible.
- Limites dans les unités des données, ou en fractions de la cible (Multiply by target).
- Choix entre l'intervalle qui inclut le milieu des limites et l'intervalle simple à 100(1 − 2α) %.
- Conclusion en langage clair sous les tableaux de l'intervalle et du test.
- Graphique d'équivalence, histogramme, boîte à moustaches (avec liste des valeurs aberrantes) et graphique des valeurs individuelles.
Méthodes statistiques
À partir des n valeurs, l'outil calcule la moyenne x̄, l'écart-type s et l'erreur-type SE = s / √n. L'écart est D = x̄ − cible. Pour l'alternative par défaut, deux tests t unilatéraux sont exécutés avec n − 1 degrés de liberté : t₁ = (D − limite inférieure) / SE teste l'hypothèse nulle D ≤ limite inférieure (valeur p de la queue supérieure), et t₂ = (D − limite supérieure) / SE teste D ≥ limite supérieure (valeur p de la queue inférieure). L'équivalence est établie lorsque les deux valeurs p sont inférieures à α, ce qui revient à dire que la plus grande des deux est inférieure à α.
L'intervalle de confiance pour l'équivalence part de D ± t(1 − α; n − 1)·SE et est étendu, si nécessaire, pour inclure le milieu des deux limites (zéro pour des limites symétriques) ; son niveau est 100(1 − α) %, comme dans Minitab. L'équivalence est établie lorsque cet intervalle se situe à l'intérieur de l'intervalle d'équivalence. Avec Use 100(1 − 2α)% CI cochée, l'intervalle simple D ± t(1 − α; n − 1)·SE est affiché à la place, étiqueté comme un intervalle à 100(1 − 2α) %. Les alternatives unilatérales utilisent un test t et une borne de confiance unilatérale : test mean − target > lower limit, test mean − target < upper limit, ou, pour Test mean > target et Test mean < target, une borne de zéro (un test de supériorité ou d'infériorité). Avec Multiply by target, les limites saisies sont multipliées par la cible, de sorte que 0.05 signifie 5 % de la cible.
Le test suppose des valeurs indépendantes issues d'une population à peu près normale ; avec 20 valeurs ou plus, une asymétrie modérée a peu d'effet. Choisissez les limites d'après des besoins d'ingénierie ou réglementaires avant d'examiner les données. L'équivalence porte sur la moyenne : elle ne signifie pas que chaque unité est dans les limites.
Champs de saisie et options
Champ | Description |
Sample | Obligatoire. Colonne numérique des mesures ; les cellules vides sont ignorées. |
Target | La valeur à laquelle la moyenne de l'échantillon est comparée, par exemple une valeur nominale ou d'étiquette. Par défaut 0. |
Alpha | Seuil de signification, 0.05 par défaut. |
Alternative hypothesis | Lower limit < test mean − target < upper limit (par défaut, équivalence), test mean − target > lower limit, test mean − target < upper limit, Test mean > target, ou Test mean < target. |
Lower Limit / Upper Limit | Obligatoire. Les limites d'équivalence pour test mean − target ; la limite inférieure doit être inférieure à la limite supérieure. |
Boxplot of Sample / Histogram of Sample / Equivalence plot / Individual value plot | Graphiques à tracer. Seul Equivalence plot est coché par défaut. La boîte à moustaches ajoute aussi une liste des valeurs aberrantes au-delà de 1.5 × IQR. |
Multiply by target | Désactivée par défaut. Les limites sont des fractions de la cible, par exemple −0.05 et 0.05 pour ±5 %. |
Use 100(1 − 2α)% CI | Désactivée par défaut. Affiche l'intervalle simple à 100(1 − 2α) % au lieu de celui qui inclut le milieu des limites. |
Data Options: Subset (optional) | Exclure les lignes correspondantes (par défaut) ou n'inclure que les lignes correspondantes (Include only matching rows), par numéros de lignes (par exemple 3,7,12-15) et/ou selon une condition. |
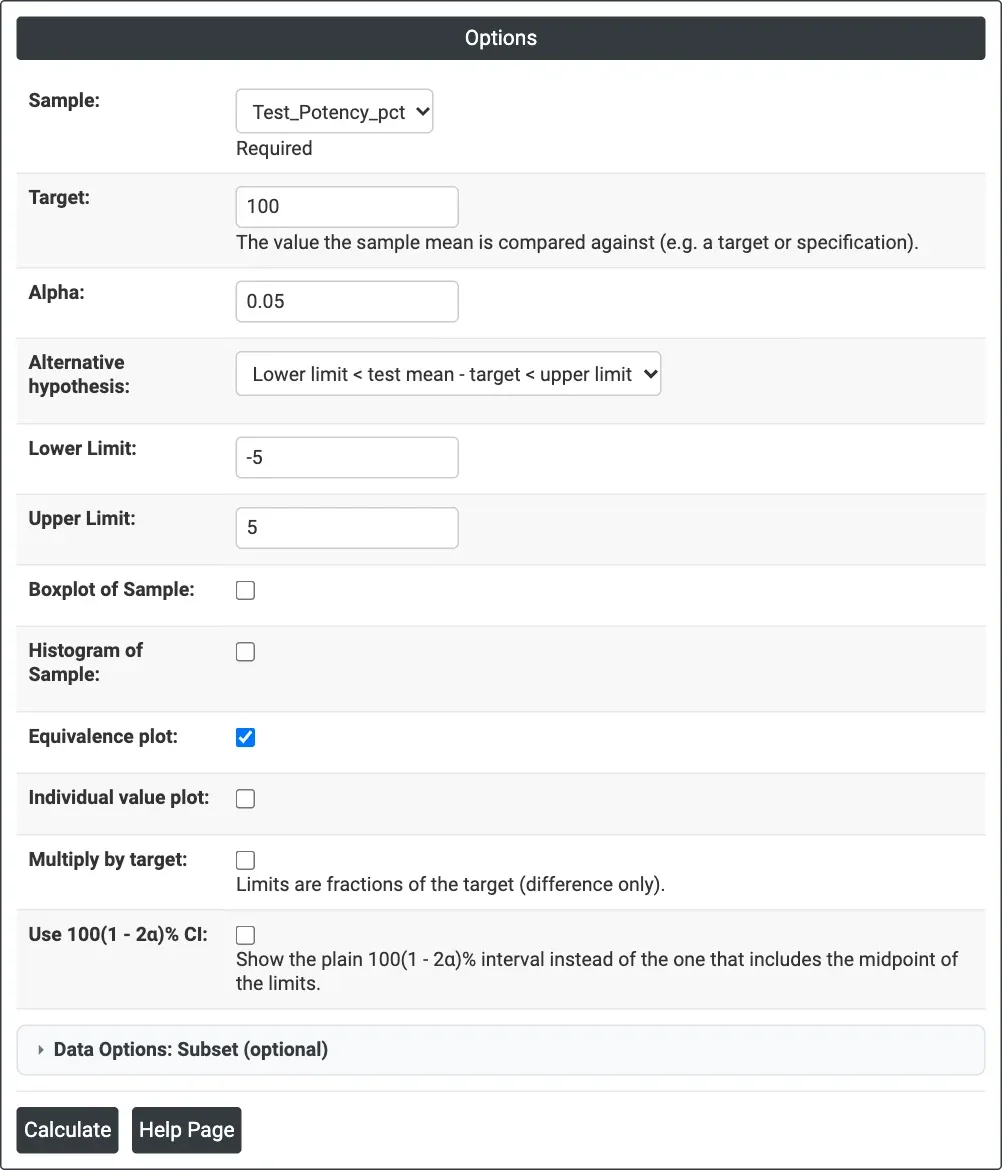
Figure 1 — Options de l'exemple : Test_Potency_pct par rapport à une cible de 100 avec des limites d'équivalence de −5 et 5.
Description des résultats
- Method : la différence testée : Sample mean − Reference value (target).
- Descriptive statistics : N, Mean, StDev et SE Mean.
- Difference table : Difference, StDev, SE, le 95% CI for Equivalence et l'Equivalence Interval, avec une note indiquant si l'IC se situe dans l'intervalle d'équivalence.
- Hypotheses : les hypothèses nulle et alternative et le seuil de signification.
- Test table : DF, T-Value et P-Value pour chaque test unilatéral, avec une note donnant la plus grande valeur p et indiquant si l'équivalence peut être établie.
- Equivalence Test: Mean − <target> : l'intervalle de confiance par rapport aux limites d'équivalence inférieure (LEL) et supérieure (UEL).
- Histogram of Sample, Boxplot of Sample et Individual Value Plot of Sample, lorsqu'ils sont cochés.
- Export PDF via Download.
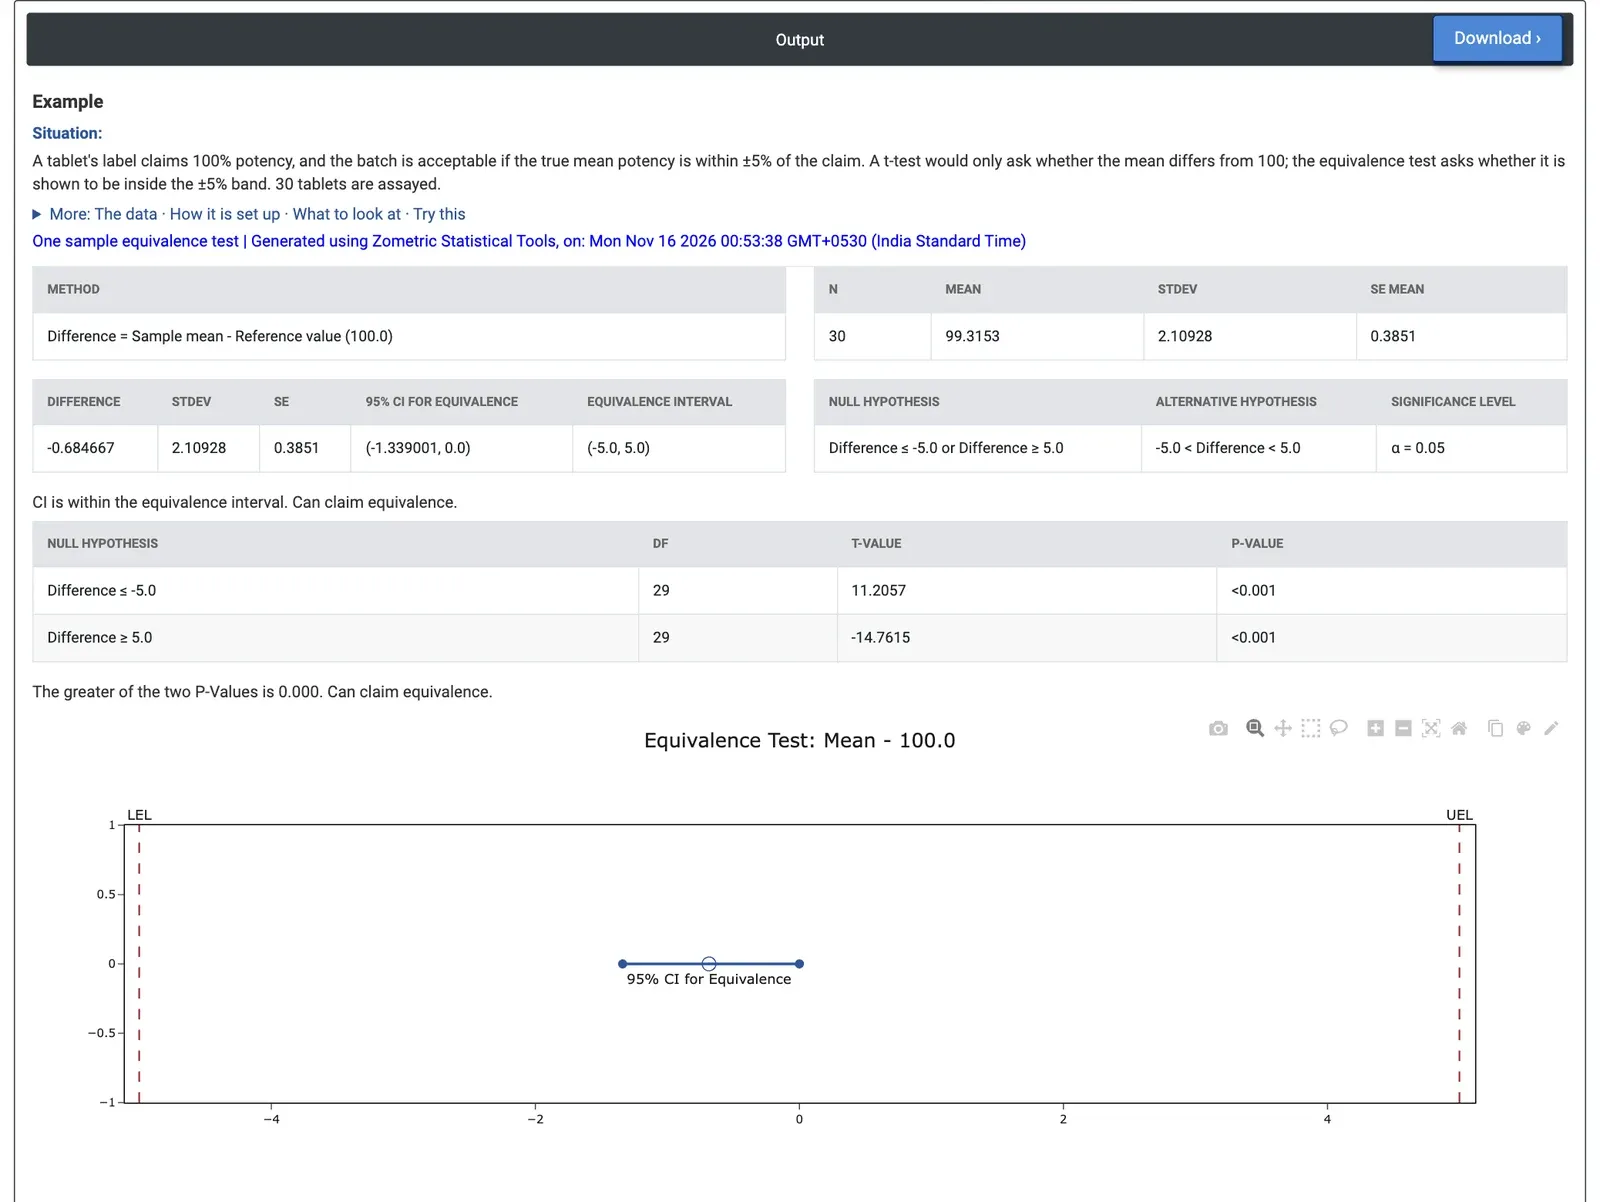
Figure 2 — L'IC à 95 % pour l'équivalence, de −1.339 à 0, se situe bien à l'intérieur des limites −5 à 5, et les deux tests unilatéraux donnent p < 0.001.
Exemple résolu
L'étiquette d'un comprimé annonce une activité de 100 %, et un lot est acceptable si l'activité moyenne réelle est à ±5 % de la valeur annoncée. Le laboratoire qualité dose 30 comprimés. Sample = Test_Potency_pct, Target = 100, Alpha = 0.05, l'alternative d'équivalence par défaut, Lower Limit = −5 et Upper Limit = 5.
L'activité moyenne est de 99.3153 % avec un écart-type de 2.109 et une erreur-type de 0.3851 ; les comprimés vont de 95.19 à 103.86 %. L'écart par rapport à la cible est de −0.6847. Le test par rapport à la limite inférieure donne t = 11.21 et le test par rapport à la limite supérieure t = −14.76, tous deux avec 29 degrés de liberté et p < 0.001. L'IC à 95 % pour l'équivalence est de −1.339 à 0 (étendu pour inclure 0), bien à l'intérieur de −5 à 5 ; la page indique donc que l'équivalence peut être établie : la moyenne du lot est démontrée comme étant à ±5 % de la valeur d'étiquette.
La largeur des limites compte. Avec des limites plus serrées de −1 et 1, le test par rapport à la limite inférieure donne t = 0.82 et p = 0.21 ; l'équivalence ne peut donc pas être établie, bien que la moyenne ne soit que de 0.68 en dessous de la cible : avec cet effectif d'échantillon et cette dispersion, les données ne peuvent pas exclure une moyenne inférieure de 1 %. Si seule une faible activité pose problème, l'alternative test mean − target > lower limit avec une limite inférieure de −5 donne un seul test avec p < 0.001 et une borne inférieure à 95 % de −1.339.
Questions fréquentes
Qu'est-ce qu'un test d'équivalence à 1 échantillon ?
Un test d'équivalence à 1 échantillon montre si la moyenne d'un échantillon est assez proche d'une cible, dans des limites fixées à l'avance. L'hypothèse nulle est que la moyenne se situe hors des limites, de sorte qu'un résultat significatif est une preuve positive que l'écart est trop faible pour compter. Il utilise deux tests t unilatéraux, appelés TOST.
Quelle est la différence entre un test d'équivalence et un test t à 1 échantillon ?
Un test t à 1 échantillon peut seulement dire si la moyenne diffère de la cible ; un test t non significatif ne prouve pas que la moyenne est sur la cible. Le test d'équivalence inverse la question en testant si l'écart se situe à l'intérieur des limites d'équivalence, de sorte qu'un résultat significatif étaye l'affirmation que la moyenne est sur la cible.
Comment interpréter un test d'équivalence à 1 échantillon ?
L'équivalence est établie lorsque les deux valeurs p unilatérales sont inférieures à alpha, ce qui revient à dire que la plus grande valeur p est inférieure à alpha, et lorsque l'intervalle de confiance pour l'équivalence se situe à l'intérieur de l'intervalle d'équivalence. L'équivalence ne concerne que la moyenne ; elle ne montre pas que chaque unité est dans les limites.
Quelles sont les hypothèses du test d'équivalence à 1 échantillon ?
Le test suppose des valeurs indépendantes issues d'une population à peu près normale ; avec 20 valeurs ou plus, une asymétrie modérée a peu d'effet. Les limites d'équivalence doivent être choisies d'après des besoins d'ingénierie ou réglementaires avant d'examiner les données, car la largeur des limites influence fortement la possibilité d'établir l'équivalence.