
Test du taux de Poisson à un échantillon
Le test du taux de Poisson à un échantillon estime un taux d'événements par unité d'exposition et le compare à un taux hypothétique. Utilisez-le pour des comptages d'événements indépendants dans une exposition fixe, et non pour des données conforme/non conforme. Les données peuvent être une colonne de comptages ou un effectif d'échantillon et un total. Il propose la méthode exacte ou l'approximation normale, et fournit le taux de l'échantillon, son intervalle de confiance et une valeur p.
Dernière révision
Point clé
Le test du taux de Poisson à un échantillon estime le taux d'apparition d'événements, comme des défauts par panneau ou des pannes par mois, avec un intervalle de confiance, et teste s'il diffère d'un taux cible ou historique.
Sur cette page
Objectif
Le test du taux de Poisson à un échantillon estime le taux d'apparition d'événements, comme des défauts par panneau, des pannes par mois ou des appels par heure, et le compare à un taux cible ou historique. Il fournit le taux avec un intervalle de confiance et, si vous le souhaitez, un test pour savoir si le taux diffère de la valeur hypothétique, ou lui est supérieur ou inférieur. Utilisez-le pour des comptages d'événements dans une quantité fixe d'exposition (unités, surface, temps) où chaque événement est indépendant, plutôt que pour des résultats conforme/non conforme, qui relèvent du test 1 Proportion.
Principales fonctionnalités
- Données sous forme d'une colonne de comptages (un comptage par unité) ou de données résumées : effectif de l'échantillon et nombre total d'occurrences.
- Méthode exacte (test de Poisson exact et intervalle de confiance exact) ou approximation normale (test z).
- Hypothèses alternatives bilatérale ou unilatérale, avec un intervalle bilatéral ou une borne unilatérale correspondante.
- Taux par unité de toute durée d'observation, p. ex. par panneau, par 100 m² ou par poste.
- Intervalle de confiance seul, sans test, lorsque Perform hypothesis test est décoché.
Méthodes statistiques
Avec N unités, chacune observée sur une durée t (Length of observation, 1 par défaut), l'exposition totale est T = N·t. Si X événements sont comptés au total, le taux de l'échantillon est λ̂ = X / T. Sous l'hypothèse nulle, le comptage X suit une distribution de Poisson de moyenne μ₀ = λ₀·T, où λ₀ est le taux hypothétique.
Méthode exacte : pour Rate > hypothesized rate, la valeur p est P(X ≥ x | μ₀) ; pour Rate < hypothesized rate, elle est P(X ≤ x | μ₀) ; et pour le test bilatéral, la valeur p ajoute la probabilité de la queue opposée au-delà du comptage qui est également peu probable selon la règle du rapport de vraisemblance. L'intervalle de confiance est l'intervalle exact (de Garwood) issu de la distribution du khi-deux : borne inférieure = χ²(α/2; 2x) / (2T), borne supérieure = χ²(1 − α/2; 2x + 2) / (2T), avec α / 2 remplacé par α pour une borne unilatérale.
Approximation normale : z = (λ̂ − λ₀) / √(λ₀ / T), avec la valeur p issue de la distribution normale centrée réduite, et l'intervalle λ̂ ± z·√(λ̂ / T), tronqué à zéro. Elle est proche de la méthode exacte lorsque le comptage attendu est élevé. Les deux méthodes supposent que les événements surviennent indépendamment à un taux constant, de sorte que la variance des comptages égale leur moyenne ; si les comptages varient bien plus que la moyenne (grappes de défauts), la valeur p sera trop petite.
Champs de saisie et options
Champ | Description |
Data | Summarized data (par défaut) ou Counts in a column. |
Sample | Avec Counts in a column : la colonne de comptages, un par unité. Les comptages doivent être des entiers supérieurs ou égaux à 0 ; les cellules vides sont ignorées. |
Sample size / Total occurrences | Avec Summarized data : le nombre d'unités et le nombre total d'événements comptés. |
Perform hypothesis test | Coché par défaut. Décochez-le pour n'obtenir que le taux et son intervalle de confiance. |
Hypothesized rate | Obligatoire pour le test. Le taux cible ou historique par durée d'observation ; supérieur à 0. |
Confidence level | 95 par défaut ; de 75 à 100. |
Alternative hypothesis | Rate ≠ hypothesized rate (par défaut), Rate < hypothesized rate ou Rate > hypothesized rate. |
Method | Exact (par défaut) ou Normal approximation. |
Length of observation | 1 par défaut. La quantité d'exposition de chaque unité, dans les unités dans lesquelles le taux est exprimé. |
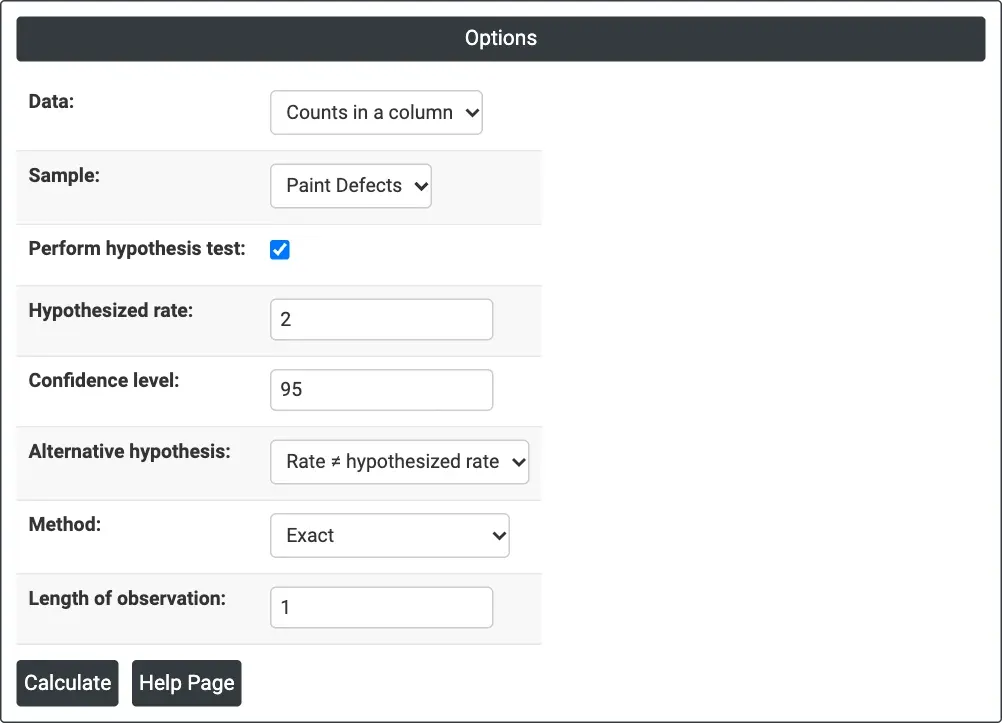
Figure 1 — Options de l'exemple : défauts de peinture comptés sur chaque panneau, taux hypothétique 2, bilatéral, méthode exacte.
Description des résultats
- Descriptive Statistics — N, Total Occurrences, Sample Rate et l'intervalle de confiance de λ (ou une borne inférieure ou supérieure pour un test unilatéral), avec des notes indiquant la colonne, la méthode et toute durée d'observation différente de 1.
- Test — les hypothèses nulle et alternative, et la P-Value (avec la Z-Value pour l'approximation normale).
- Export PDF via Download.
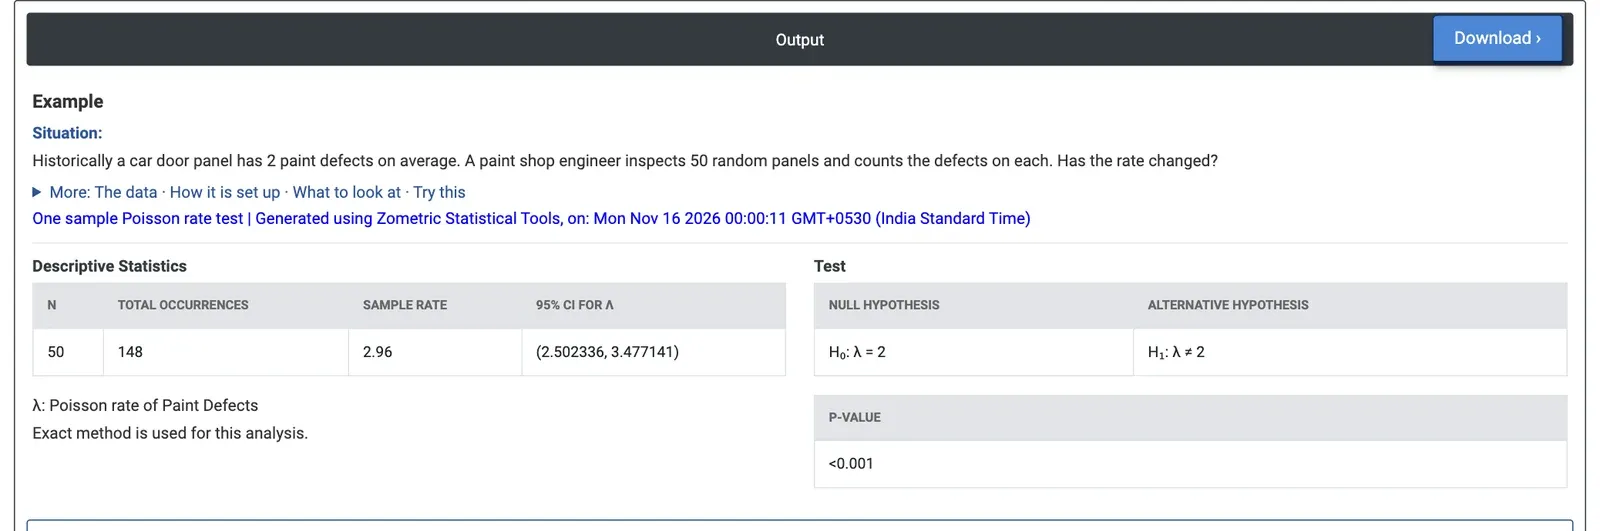
Figure 2 — 148 défauts sur 50 panneaux : un taux de 2.96 par panneau, IC à 95% de 2.502 à 3.477, p < 0.001 par rapport au taux historique de 2.
Exemple résolu
Historiquement, un panneau de porte de voiture présente en moyenne 2 défauts de peinture. Un ingénieur d'un atelier de peinture inspecte 50 panneaux au hasard et compte les défauts de chacun. Le taux a-t-il changé ? Data = Counts in a column, Sample = Paint Defects, Hypothesized rate = 2, Confidence level = 95, Alternative hypothesis = Rate ≠ hypothesized rate, Method = Exact, Length of observation = 1.
Les 50 panneaux présentent 148 défauts au total, soit un taux de 2.96 défauts par panneau. L'intervalle de confiance à 95% de λ va de 2.502 à 3.477 : tout l'intervalle est au-dessus de 2. La valeur p exacte est inférieure à 0.001 : le taux de défauts a donc changé ; il est environ une fois et demie plus élevé qu'avant. Les comptages semblent poissonniens : leur variance (2.37) est proche de leur moyenne, il n'y a donc aucun signe de défauts en grappes qui rendraient le test trop optimiste.
L'approximation normale donne la même conclusion (z = 4.8, p < 0.001, intervalle de 2.483 à 3.437). Si la question est seulement de savoir si le taux a augmenté, Rate > hypothesized rate donne une borne inférieure à 95% de 2.571 défauts par panneau : le taux de défauts est supérieur d'au moins 29% environ au niveau historique, et l'ingénieur devrait chercher ce qui a changé dans le procédé de peinture. On obtient le même résultat avec Data = Summarized data, Sample size = 50 et Total occurrences = 148.
Questions fréquentes
Qu'est-ce qu'un test du taux de Poisson à un échantillon ?
Un test du taux de Poisson à un échantillon estime le taux d'apparition d'événements, comme des défauts par panneau, des pannes par mois ou des appels par heure, et le compare à un taux cible ou historique. Il fournit le taux avec un intervalle de confiance et peut tester si le taux diffère de la valeur hypothétique, ou lui est supérieur ou inférieur.
Quand utiliser un test du taux de Poisson plutôt qu'un test de 1 proportion ?
Utilisez le test du taux de Poisson pour des comptages d'événements dans une quantité fixe d'exposition, comme des unités, une surface ou du temps, où chaque événement est indépendant et où une unité peut présenter plusieurs événements. Pour des résultats conforme/non conforme, où chaque article est simplement conforme ou non, utilisez plutôt le test 1 Proportion.
Quelles sont les hypothèses du test du taux de Poisson ?
La méthode exacte comme l'approximation normale supposent que les événements surviennent indépendamment à un taux constant, de sorte que la variance des comptages égale leur moyenne. Si les comptages varient bien plus que la moyenne, par exemple lorsque les défauts surviennent en grappes, la valeur p sera trop petite.
Quelle différence entre la méthode exacte et l'approximation normale ?
La méthode exacte utilise la distribution de Poisson pour la valeur p et l'intervalle exact de Garwood issu de la distribution du khi-deux. L'approximation normale utilise un test z et l'intervalle taux plus ou moins z fois la racine carrée du taux divisé par l'exposition. Elle est proche de la méthode exacte lorsque le comptage attendu est élevé.