
Régression logistique ordinale
La régression logistique ordinale est un modèle statistique qui analyse la relation entre une ou plusieurs variables prédictives et une variable de réponse à trois catégories ordonnées ou plus. Les catégories ont un rang ou une séquence naturels, comme faible/moyen/élevé ou désaccord/neutre/accord, mais la distance exacte entre elles n'est pas mesurable.
Dernière révision
Point clé
La régression logistique ordinale est un modèle statistique qui analyse la relation entre une ou plusieurs variables prédictives et une variable de réponse à trois catégories ordonnées ou plus.
Sur cette page
- Qu'est-ce que la régression logistique ordinale ?
- Quand utiliser la régression logistique ordinale ?
- Recommandations pour bien utiliser la régression logistique ordinale
- Alternatives : quand ne pas utiliser la régression logistique ordinale
- Exemple de régression logistique ordinale ?
- Comment réaliser une régression logistique ordinale
Qu'est-ce que la régression logistique ordinale ?
La régression logistique ordinale est un modèle statistique qui analyse la relation entre une ou plusieurs variables prédictives et une variable de réponse à trois catégories ordonnées ou plus. Les catégories ont un rang ou une séquence naturels, comme faible/moyen/élevé ou désaccord/neutre/accord, mais la distance exacte entre elles n'est pas mesurable. Elle prédit la probabilité d'appartenir à chaque catégorie à partir des prédicteurs.
Quand utiliser la régression logistique ordinale ?
Variables prédictives
- Les prédicteurs peuvent être continus, catégoriels, ou un mélange des deux
- Les variables discrètes peuvent être traitées comme continues ou catégorielles selon le nombre de niveaux et l'objectif de l'analyse
- Un seul prédicteur continu avec une réponse continue → utilisez Droite d'ajustement (Fit Line Model)
- Plusieurs prédicteurs avec une réponse continue → utilisez Ajuster un modèle de régression (Fit Regression Model)
Variable de réponse
- La réponse doit avoir trois catégories ordonnées ou plus avec un rang naturel (par ex. faible/moyen/élevé, jamais/parfois/toujours)
- L'ordre compte — mais l'écart entre les catégories n'a pas besoin d'être égal
- La réponse n'a que deux catégories (conforme/non conforme) → utilisez Régression logistique binaire (Fit Binary Logistic Model)
- La réponse a des catégories non ordonnées (rayure/bosse/déchirure) → utilisez Régression logistique nominale
- La réponse est continue → utilisez Ajuster un modèle de régression (Fit Regression Model) ou Droite d'ajustement (Fit Line Model)
Recommandations pour bien utiliser la régression logistique ordinale
- Assurez-vous que la variable de réponse a trois catégories ou plus avec un ordre significatif; si l'ordre n'a pas d'importance, utilisez plutôt la régression logistique nominale.
- Les prédicteurs peuvent être continus ou catégoriels; assurez-vous que chaque prédicteur est correctement classé avant d'exécuter le modèle.
- Assurez-vous que les données représentent fidèlement la population cible; des données biaisées ou incomplètes produiront des résultats peu fiables.
- Recueillez suffisamment de points de données par catégorie pour garantir des estimations de probabilité stables et fiables sur tous les niveaux de la réponse.
- Mesurez toutes les variables aussi exactement que possible; les erreurs de classement ou de mesure affectent directement l'exactitude du modèle.
- Enregistrez les données dans l'ordre où elles sont recueillies pour aider à détecter toute tendance ou incohérence liée au temps.
- Après l'ajustement, validez le modèle à l'aide des statistiques d'ajustement et des diagnostics des résidus; un modèle mal ajusté produira des prédictions trompeuses.
- Vérifiez l' hypothèse des cotes proportionnelles — la régression logistique ordinale suppose que la relation entre chaque paire de groupes de résultats est constante. Si cette hypothèse n'est pas respectée, envisagez plutôt la régression logistique nominale.
Alternatives : quand ne pas utiliser la régression logistique ordinale
- Si la réponse n'a que deux catégories (par ex. conforme/non conforme), utilisez plutôt la Régression logistique binaire (Fit Binary Logistic Model) .
- Si les catégories de réponse n'ont aucun ordre naturel (par ex. rayure/bosse/déchirure), utilisez plutôt la Régression logistique nominale .
- Si la variable de réponse est continue, utilisez plutôt Ajuster un modèle de régression (Fit Regression Model) ou Droite d'ajustement (Fit Line Model) .
- Si vous n'avez qu'un seul prédicteur continu et une réponse continue, utilisez plutôt Droite d'ajustement (Fit Line Model) .
- Si vous avez plusieurs prédicteurs et une réponse continue, utilisez plutôt Ajuster un modèle de régression (Fit Regression Model) .
Exemple de régression logistique ordinale ?
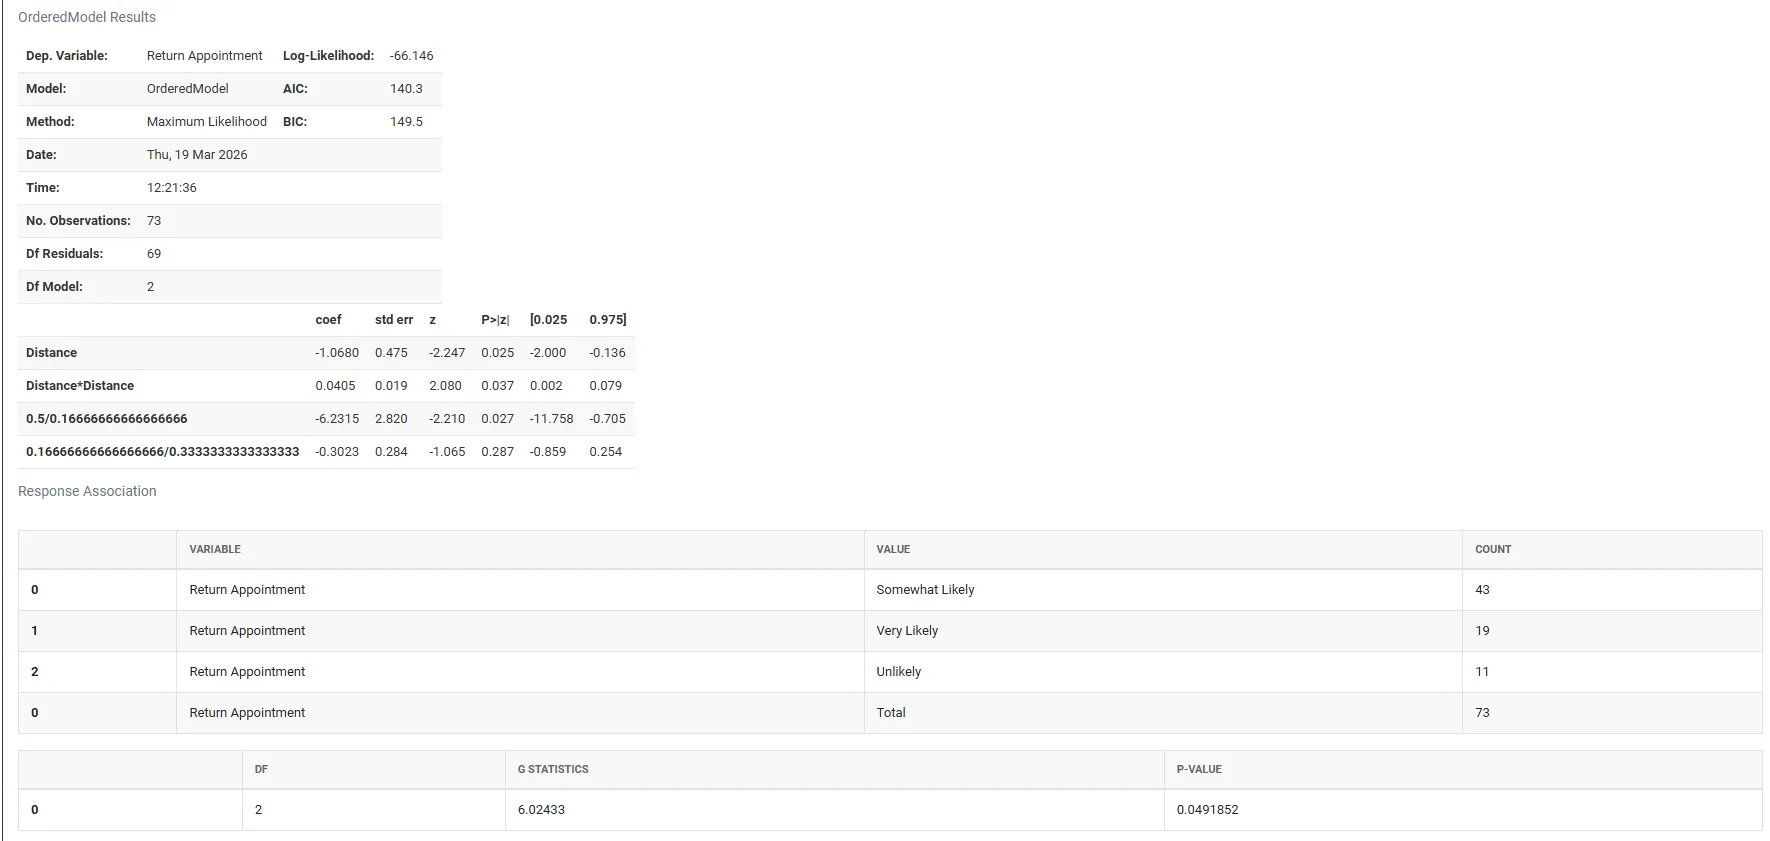
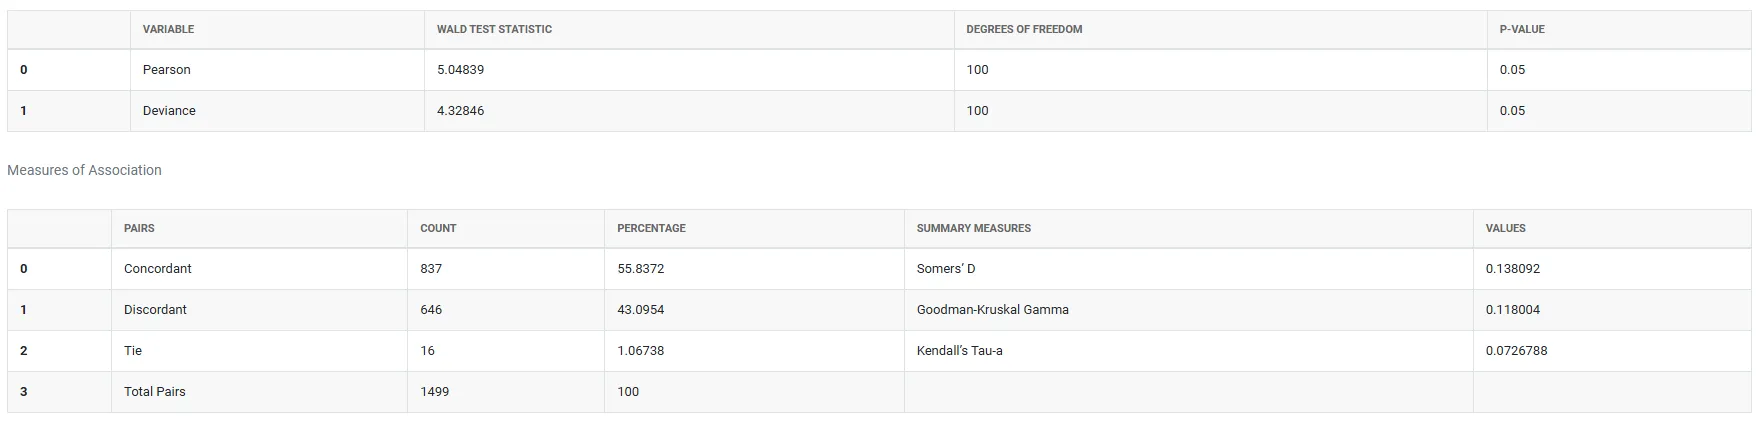
Le responsable d'un cabinet médical veut identifier les facteurs qui influencent la satisfaction des patients. Les patients sont interrogés sur la probabilité qu'ils reviennent pour des soins de suivi, les réponses étant classées en peu probable, assez probable ou très probable. Comme ces catégories de réponse ont un ordre naturel, le responsable traite le résultat comme une variable ordinale et utilise la régression logistique ordinale pour examiner la relation entre la probabilité de retour du patient et des prédicteurs tels que la situation professionnelle, l'âge et la proximité du cabinet. Un seuil de signification de 0.05 sert à évaluer la significativité statistique et la qualité d'ajustement du modèle. Les étapes sont les suivantes :
- Recueillir les données nécessaires.
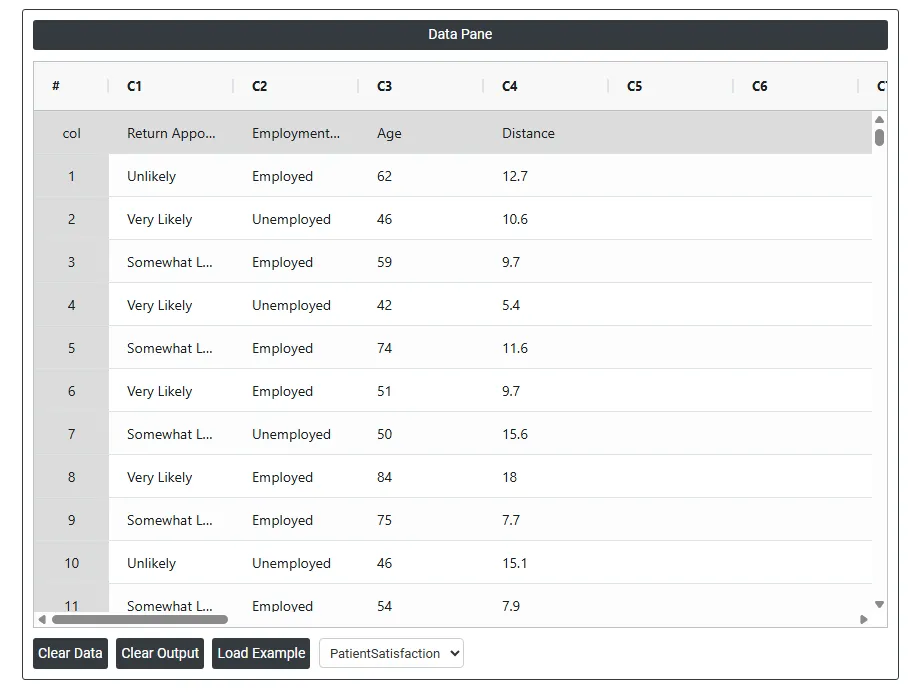
- Analysez ensuite les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver la régression logistique ordinale, choisissez Statistical module> Regression>Ordinal Logistic Regression.
- Dans l'outil, saisissez les données ainsi que les autres paramètres comme suit :
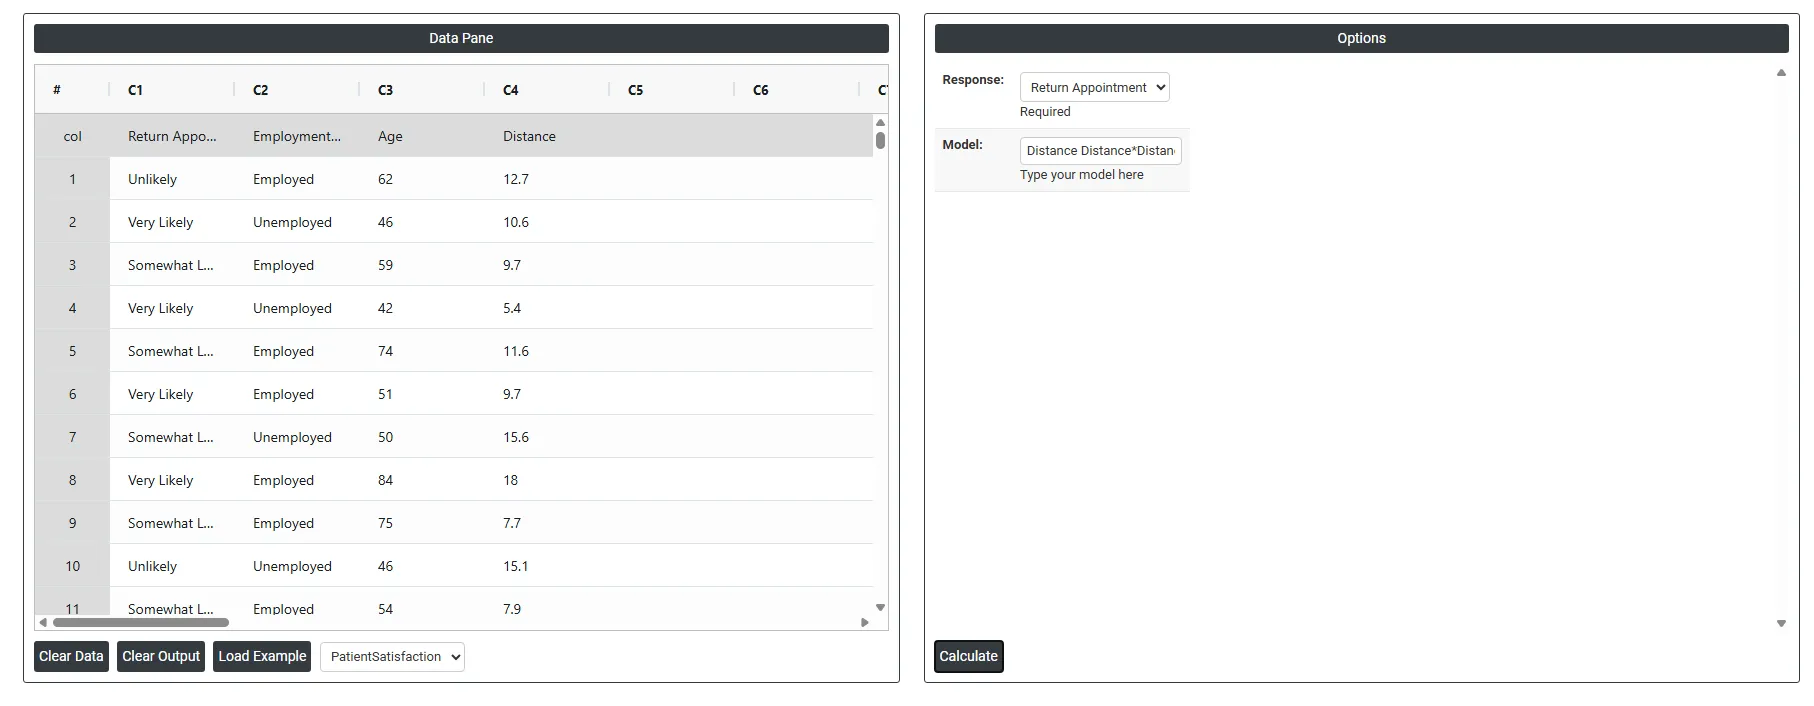
5. Après exécution de l'outil, les résultats obtenus sont les suivants :
Comment réaliser une régression logistique ordinale
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Regression > Ordinal Logistic Regression.
- Ensuite, saisissez les données manuellement, ou copiez (Ctrl+C) l'ensemble des données d'une feuille Excel et collez-les (Ctrl+V) ici, ou encore utilisez l'option Load Example pour charger les données d'exemple.
- Ensuite, renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Dans le tableau de bord de la régression logistique ordinale, la fenêtre est divisée en deux parties.
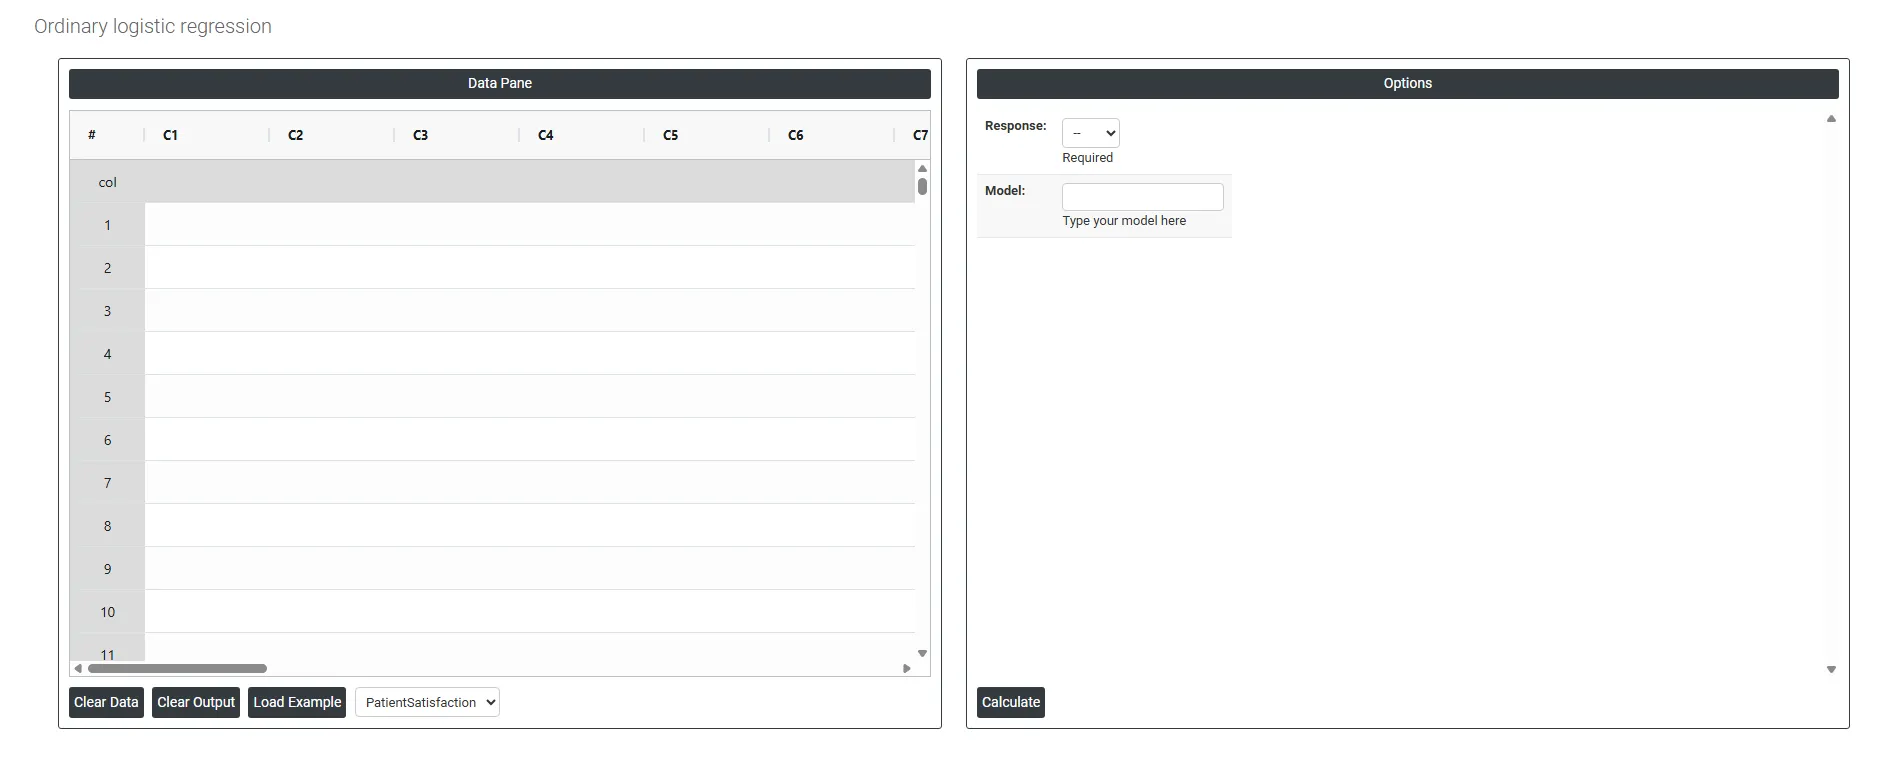
La partie gauche contient le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement, ou vous pouvez copier (Ctrl+C) l'ensemble des données d'une feuille Excel et les coller (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File: permet de charger directement les données Excel.
La partie droite contient de nombreuses options, décrites ci-dessous :
- Response : la réponse est la variable de résultat que vous voulez prédire ou étudier. En régression logistique ordinale, la réponse doit comporter trois catégories ou plus avec un ordre naturel et significatif — où les catégories peuvent être classées mais où l'écart entre elles n'a pas besoin d'être égal.
Par exemple :
Le modèle calcule ensuite la probabilité qu'une observation appartienne à chaque catégorie en fonction des variables prédictives. - Niveau de douleur → Mild / Moderate / Severe
- Réponse à une enquête → Disagree / Neutral / Agree
- Model Définit la structure de votre analyse en précisant quels prédicteurs et termes d'interaction sont inclus dans le modèle. Vous pouvez inclure :
- Continuous predictors — variables numériques comme la température, l'âge ou la dose
- Categorical predictors — variables de groupe comme le sexe, le type de matériau ou la région
- Interaction terms — combinaisons de deux prédicteurs ou plus qui, ensemble, peuvent avoir un effet allant au-delà de leurs contributions individuelles
Questions fréquentes
Qu'est-ce que la régression logistique ordinale ?
La régression logistique ordinale analyse la relation entre un ou plusieurs prédicteurs et une réponse à trois catégories ordonnées ou plus, comme faible/moyen/élevé ou désaccord/neutre/accord, où les catégories ont un rang naturel mais où la distance entre elles n'est pas mesurable. Elle prédit la probabilité d'appartenir à chaque catégorie à partir des prédicteurs.
Quand utiliser la régression logistique ordinale plutôt que nominale ?
Utilisez la régression logistique ordinale lorsque les catégories de réponse ont un ordre significatif, comme jamais/parfois/toujours. Si l'ordre n'a pas d'importance, comme rayure/bosse/déchirure, utilisez la régression logistique nominale. Pour une réponse à deux catégories comme conforme/non conforme, utilisez le modèle logistique binaire, et pour une réponse continue les modèles de régression ou de droite.
Qu'est-ce que l'hypothèse des cotes proportionnelles ?
La régression logistique ordinale suppose que la relation entre chaque paire de groupes de résultats est constante ; c'est l'hypothèse des cotes proportionnelles. Elle doit être vérifiée après l'ajustement ; si elle n'est pas respectée, envisagez plutôt la régression logistique nominale. Validez le modèle avec les statistiques d'ajustement et les diagnostics des résidus.
Quels prédicteurs peut-on utiliser en régression logistique ordinale ?
Les prédicteurs peuvent être continus, comme la température, l'âge ou la dose, catégoriels, comme le type de matériau ou la région, ou un mélange des deux. Les variables discrètes peuvent être traitées comme l'un ou l'autre, selon le nombre de niveaux et l'objectif de l'analyse. Le modèle peut aussi inclure des termes d'interaction entre prédicteurs.