
Régression de Poisson
La régression de Poisson modélise des comptages d'événements sur une durée, une surface ou une quantité de produit fixe en fonction de prédicteurs continus et qualitatifs. Utilisez-la plutôt que la régression ordinaire, car les comptages ne peuvent pas être négatifs et leur dispersion croît avec la moyenne. La réponse est supposée suivre une distribution de Poisson, avec un lien log, racine carrée ou identité. Les résultats comprennent les coefficients, l'analyse de la déviance, des tests d'adéquation et des graphiques des résidus.
Dernière révision
Point clé
La régression de Poisson est un modèle linéaire généralisé qui relie une réponse de comptage (défauts par équipe, pannes par mois) à des prédicteurs continus et qualitatifs, ajusté par maximum de vraisemblance.
Sur cette page
Objectif
Poisson Regression relie une réponse de comptage, comme des défauts par équipe, des pannes par mois ou des imperfections par panneau, à des prédicteurs continus et qualitatifs. Utilisez-la plutôt que la régression ordinaire lorsque la réponse est un nombre d'événements sur une durée, une surface ou une quantité de produit fixe : les comptages ne peuvent pas être négatifs et leur dispersion croît avec leur moyenne, ce que les moindres carrés ne prennent pas en compte.
Principales fonctionnalités
- Prédicteurs continus et qualitatifs, avec interactions et termes au carré issus de la liste des termes.
- Lien log (par défaut), racine carrée ou identité.
- Sélection pas à pas, sélection ascendante ou élimination descendante des termes, avec des termes imposés dans chaque modèle.
- Coefficients avec intervalles de confiance et VIF, équations de régression pour chaque niveau d'un prédicteur qualitatif, récapitulatif du modèle et tests d'adéquation.
- Analyse de la déviance par tests de Wald ou du rapport de vraisemblance (ajustés ou séquentiels).
- Observations inhabituelles, graphiques des résidus, graphiques des effets principaux et des interactions, courbes de niveau et surfaces des comptages ajustés.
- Prédiction aux réglages que vous saisissez et optimiseur de réponse.
Méthodes statistiques
La réponse est supposée suivre une distribution de Poisson de moyenne μ qui dépend des prédicteurs par la fonction de lien : avec le lien log, ln μ = b₀ + b₁x₁ + … , de sorte que chaque coefficient multiplie le comptage espéré par exp(b) par unité de son prédicteur. Le modèle est un modèle linéaire généralisé ajusté par maximum de vraisemblance (moindres carrés repondérés itérativement). Les prédicteurs qualitatifs utilisent un codage (1, 0) par rapport à un niveau de référence, par défaut le premier niveau dans l'ordre de tri. Les lignes avec une valeur manquante sont écartées ; une colonne de fréquences répète les lignes et une colonne de poids donne des poids de variance.
Le tableau des coefficients donne les valeurs z de Wald (Coef / SE Coef) et les intervalles de confiance. L'analyse de la déviance teste chaque terme : par défaut avec un khi-deux de Wald (z² pour un terme continu, un test conjoint pour les colonnes indicatrices d'un terme qualitatif) ; avec le test LR, par la variation de la déviance lorsque le terme est retiré du modèle complet (ajusté, Type III) ou ajouté dans l'ordre (séquentiel, Type I). Deviance R-Sq = 1 − déviance résiduelle / déviance nulle.
Les tests d'adéquation comparent la déviance et le khi-deux de Pearson à une distribution du khi-deux avec les degrés de liberté de l'erreur. Une petite valeur p, ou une Mean (déviance / DF) bien supérieure à 1, signifie que les comptages varient davantage que ne le permet un modèle de Poisson (surdispersion), et les valeurs p des termes sont alors trop petites. Les observations dont le résidu standardisé dépasse ±2 sont signalées R, et celles dont l'effet de levier dépasse 3p/n sont signalées X.
Champs et options de saisie
Champ | Description |
Response | Colonne de comptages. Obligatoire. |
Continuous Predictors / Categorical Predictor | Colonnes de prédicteurs numériques et textuelles (ou codées) ; au moins une. Ctrl ou Command + clic pour en sélectionner plusieurs. |
Model terms (optional) | Liste des termes : cochez des termes, ou utilisez Add all, Interactions et Powers jusqu'à l'ordre choisi dans Terms through order (2 ou 3). Décochez In model pour retirer un terme linéaire en conservant ses interactions. |
Reference level (optional) | Pour les prédicteurs qualitatifs, « Predictor Level », séparés par des virgules. Par défaut : premier niveau dans l'ordre de tri. |
Stepwise method | None (par défaut), Stepwise, Forward selection ou Backward elimination ; avec Alpha to enter et Alpha to remove (0.15), règles de hiérarchie, Terms in every model (E), Initial model terms (I) et Model selection details. |
Frequency (optional) / Weights (optional) | Colonnes de fréquences des lignes et de poids. |
Link function | Log (par défaut), Square root ou Identity. |
Confidence level / Type of confidence interval | Par défaut 95, Two-sided ; ou Lower bound ou Upper bound. |
Fits and diagnostics for all observations | Liste la valeur ajustée et le résidu de chaque ligne, et pas seulement des observations inhabituelles. |
Test for ANOVA table / Type of deviance (LR test only) | Wald test (par défaut) ou LR test ; pour LR, Adjusted (Type III, par défaut) ou Sequential (Type I). |
Residuals for diagnostics/plots | Deviance (par défaut) ou Pearson. |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | Graphiques des résidus. |
Main effects plot / Interaction plot | Comptage ajusté en fonction de chaque prédicteur, les autres étant maintenus à leur moyenne ou à leur niveau de référence. |
Contour plot / Surface plot / Overlaid contour plot of fitted values | Nécessitent les variables d'axe X1 et X2 ; l'Overlaid contour plot nécessite aussi Response low et Response high. |
Prediction / Response Optimizer | Ajoute un panneau pour prédire le comptage moyen (avec SE et intervalle de confiance) aux réglages que vous saisissez, ou pour rechercher les réglages qui atteignent un objectif de comptage. |
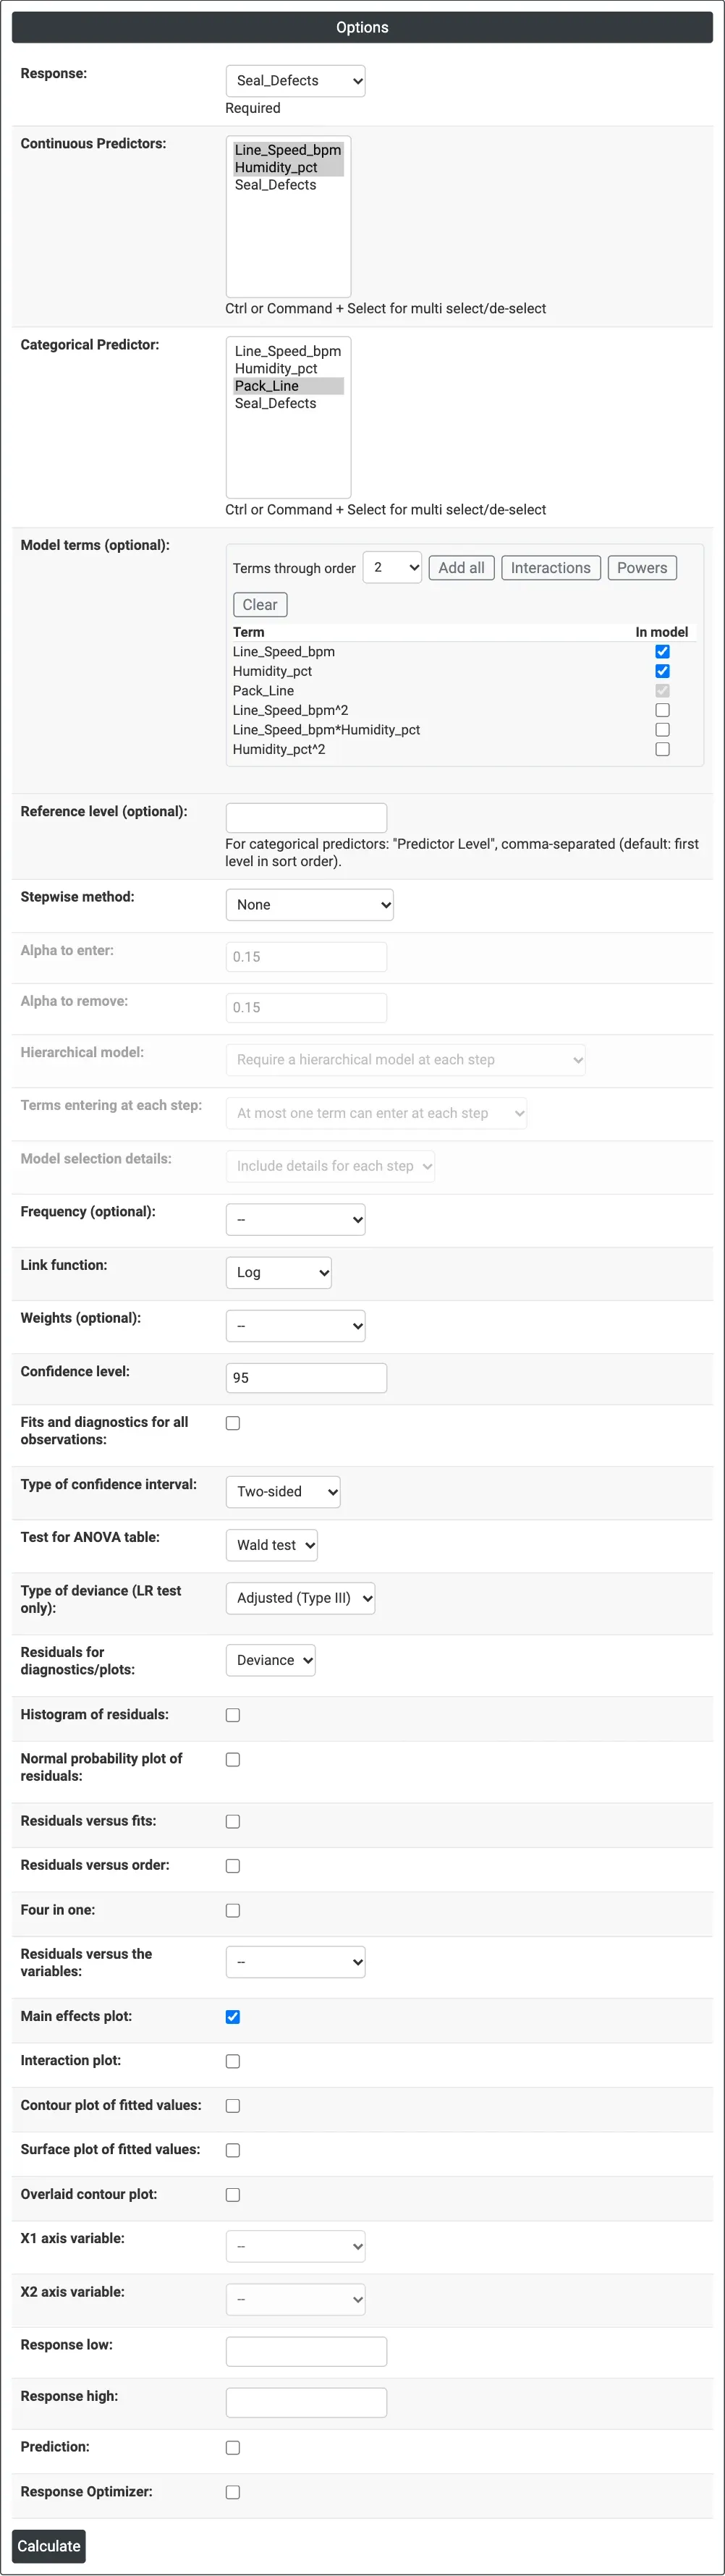
Figure 1 — Options de l'exemple des soudures de sacs : Seal_Defects comme réponse, vitesse de ligne et humidité comme prédicteurs continus, ligne de conditionnement comme prédicteur qualitatif, graphique des effets principaux coché.
Description des résultats
- Method — fonction de lien, codage des variables qualitatives et lignes utilisées.
- Response Information — N, moyenne, écart-type, minimum et maximum des comptages.
- Coefficients — Coef, SE Coef, Z-Value, P-Value, limites de confiance et VIF.
- Regression Equation — le prédicteur linéaire Y' (ln du comptage espéré avec le lien log) pour chaque niveau des prédicteurs qualitatifs.
- Model Summary — deviance R-Sq, Adj R-Sq, AIC, AICc et BIC.
- Goodness-of-Fit Tests — tests du khi-deux de la déviance et de Pearson.
- Fits and Diagnostics for Unusual Observations.
- Analysis of Deviance — khi-deux et valeur p pour la régression et chaque terme.
- Tableau de sélection pas à pas, graphiques des résidus, factoriels, courbes de niveau et surfaces, panneaux de prédiction et d'optimiseur lorsqu'ils sont sélectionnés.
- Export PDF via Download.
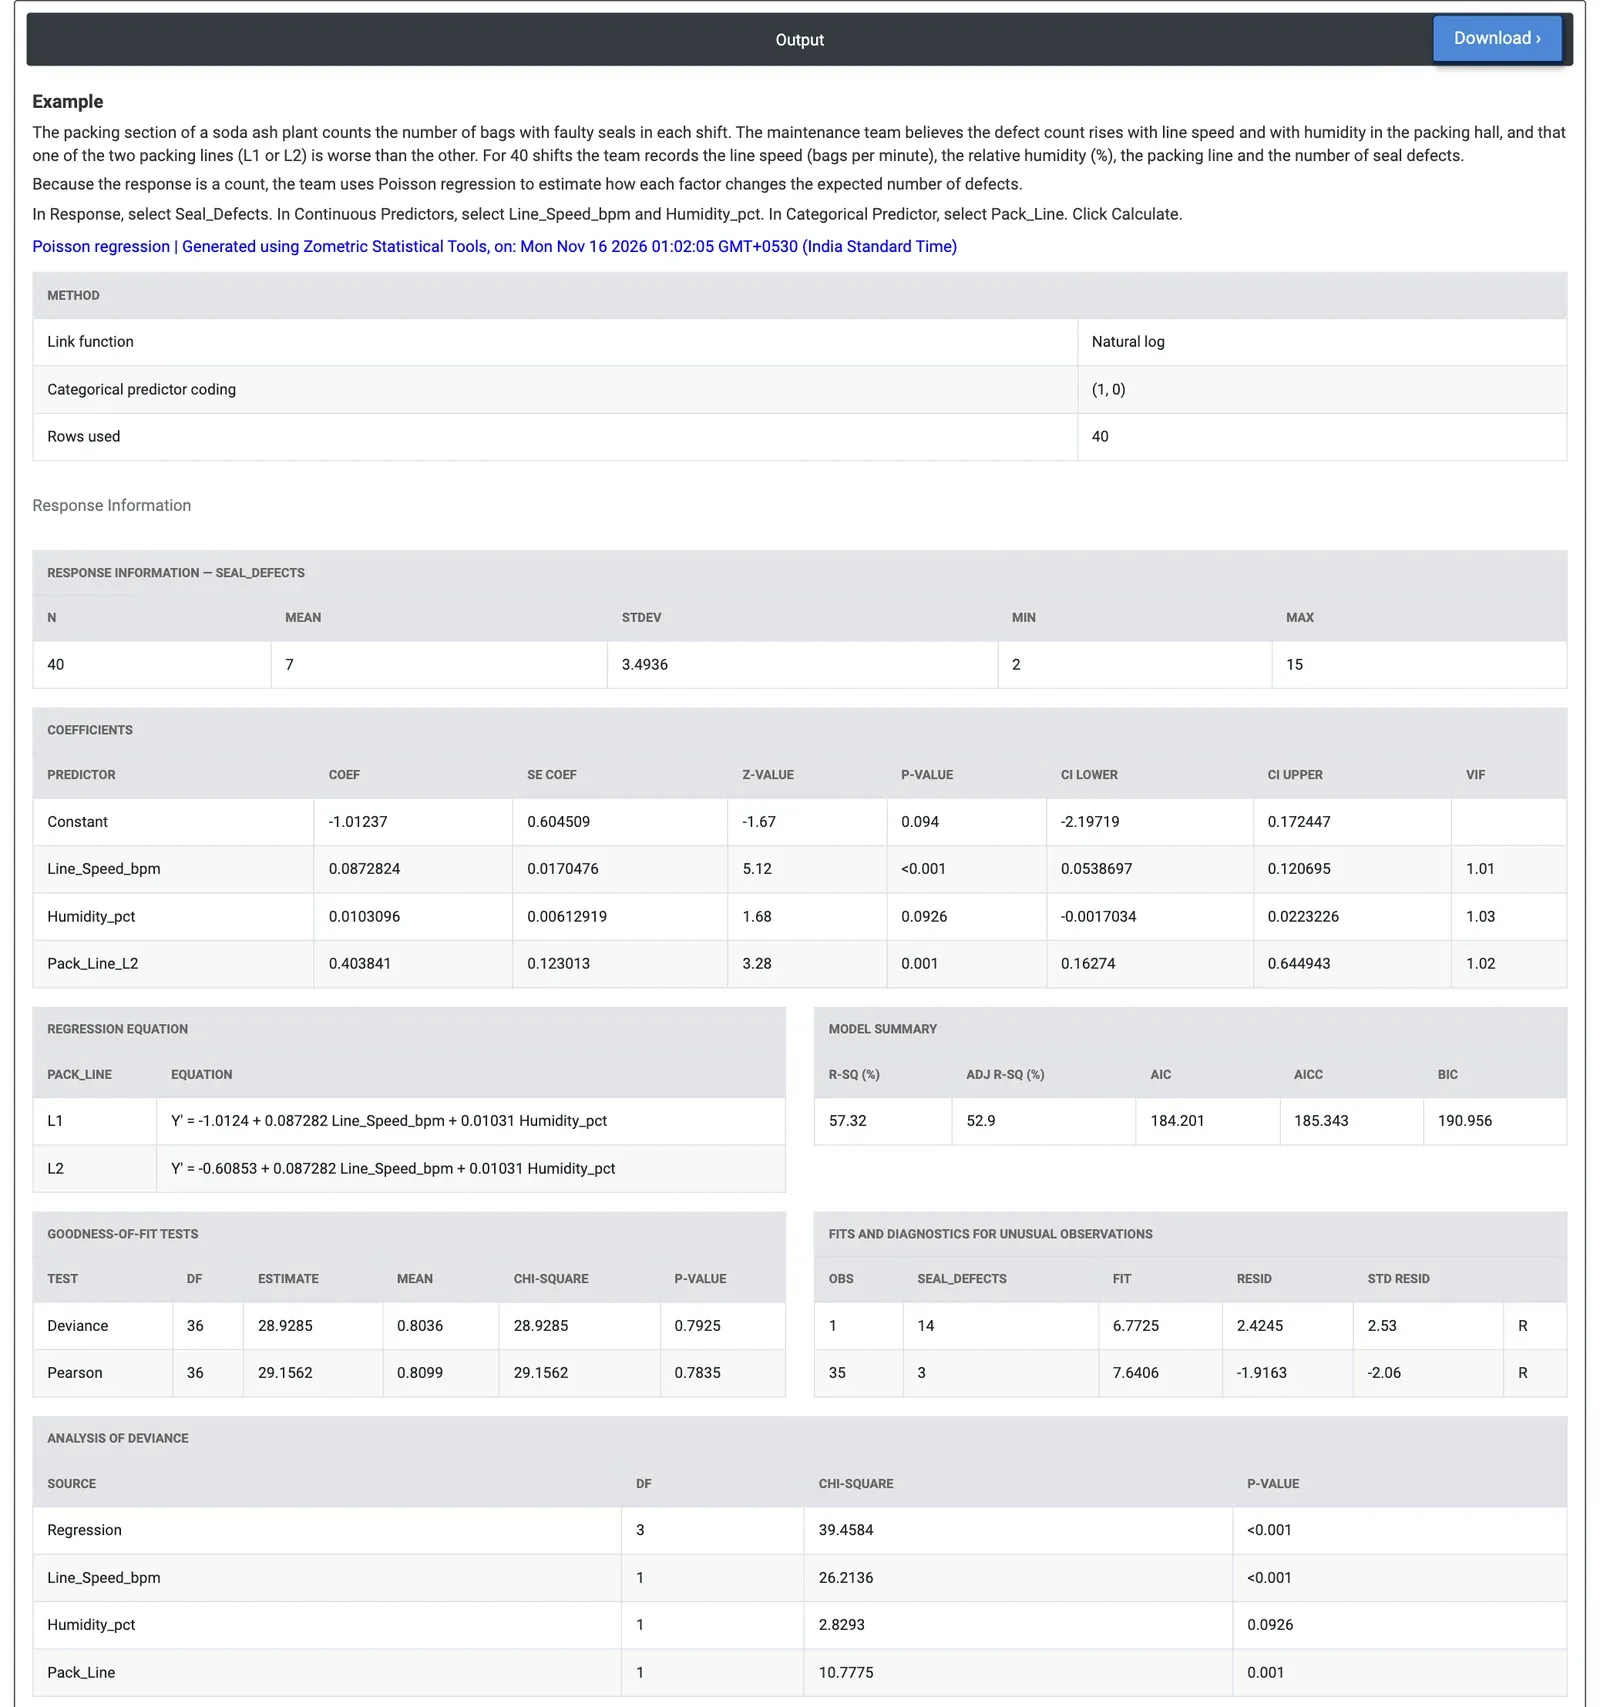
Figure 2 — Régression de Poisson des défauts de soudure par équipe : la vitesse de ligne (p < 0.001) et la ligne de conditionnement (p = 0.001) comptent, l'humidité non au seuil de 5 % (p = 0.0926).
Exemple résolu
Le secteur de conditionnement d'une usine de carbonate de sodium compte les sacs aux soudures défectueuses à chaque équipe. Sur 40 équipes, l'équipe relève la vitesse de ligne (sacs par minute), l'humidité dans la salle de conditionnement (%), la ligne de conditionnement (L1 ou L2) et le nombre de défauts de soudure (de 2 à 15, moyenne 7). Elle sélectionne Seal_Defects comme réponse, la vitesse de ligne et l'humidité comme prédicteurs continus et Pack_Line comme prédicteur qualitatif, et conserve le lien log.
La vitesse de ligne a l'effet le plus fort (khi-deux de Wald 26.21, p < 0.001) : son coefficient 0.0873 signifie que chaque sac par minute supplémentaire multiplie les défauts espérés par exp(0.0873) = 1.09, et 5 sacs par minute de plus par environ 1.55. La ligne L2 a un coefficient de 0.404 (p = 0.001) : à vitesse et humidité égales, elle produit donc environ 1.50 fois plus de défauts de soudure que L1. L'humidité va dans le même sens (environ 11 % de défauts en plus par tranche de 10 % d'HR) mais n'est pas significative au seuil de 5 % (p = 0.0926).
Le modèle s'ajuste bien aux comptages : khi-deux de la déviance 28.93 avec 36 DF (p = 0.7925) et Pearson 29.16 (p = 0.7835), avec une Mean inférieure à 1, il n'y a donc aucun signe de surdispersion. Deux équipes sont signalées : l'équipe 1 avec 14 défauts pour une valeur ajustée de 6.8, et l'équipe 35 avec 3 pour 7.6. L'équipe examine d'abord les mâchoires de soudure de L2 et la consigne de vitesse, et continue de recueillir des données d'humidité avant de décider d'une déshumidification.
Questions fréquentes
Quand utiliser la régression de Poisson plutôt que la régression ordinaire par les moindres carrés ?
Utilisez la régression de Poisson lorsque la réponse est un nombre d'événements sur une durée, une surface ou une quantité de produit fixe, comme des défauts par équipe ou des pannes par mois. Les comptages ne peuvent pas être négatifs et leur dispersion croît avec leur moyenne, ce que la régression par les moindres carrés ne prend pas en compte. La régression de Poisson traite cela comme un modèle linéaire généralisé ajusté par maximum de vraisemblance.
Comment interpréter les coefficients d'une régression de Poisson ?
Avec le lien log par défaut, ln du comptage espéré est égal à b0 + b1x1 + ..., de sorte que chaque coefficient multiplie le comptage espéré par exp(b) par unité d'augmentation de son prédicteur. Par exemple, un coefficient de vitesse de ligne de 0.0873 signifie que chaque sac par minute supplémentaire multiplie les défauts espérés par exp(0.0873) = 1.09. Les prédicteurs qualitatifs sont comparés à un niveau de référence.
Comment vérifier la surdispersion dans une régression de Poisson ?
Les tests d'adéquation comparent la déviance et le khi-deux de Pearson à une distribution du khi-deux avec les degrés de liberté de l'erreur. Une petite valeur p, ou une Mean (déviance divisée par DF) bien supérieure à 1, signifie que les comptages varient davantage que ne le permet un modèle de Poisson. Dans ce cas, les valeurs p des termes du modèle sont trop petites et ne doivent pas être jugées fiables.
Comment les observations inhabituelles sont-elles signalées dans une régression de Poisson ?
Les observations dont le résidu standardisé dépasse plus ou moins 2 sont signalées R, et celles dont l'effet de levier dépasse 3p/n sont signalées X. Elles sont listées dans le tableau Fits and Diagnostics for Unusual Observations, et des graphiques des résidus, comme résidus en fonction des valeurs ajustées et droite de probabilité normale des résidus, peuvent être ajoutés pour les examiner plus en détail.