
Puissance et effectif de l'échantillon pour un test d'équivalence à 1 échantillon
Planifie un test d'équivalence à 1 échantillon qui doit prouver qu'une moyenne est suffisamment proche d'une cible plutôt que différente de celle-ci. Saisissez des limites d'équivalence inférieure et supérieure, un écart-type, et deux éléments parmi l'effectif de l'échantillon, la différence et la puissance ; l'outil calcule le troisième. La puissance est calculée exactement pour la procédure TOST avec la distribution t. Les résultats comprennent un tableau et une courbe de puissance.
Dernière révision
Point clé
Puissance et effectif de l'échantillon pour un test d'équivalence à 1 échantillon calcule le nombre de mesures nécessaires pour montrer, par deux tests t unilatéraux (TOST), qu'une moyenne est dans un intervalle d'équivalence.
Sur cette page
Objectif
Puissance et effectif de l'échantillon pour un test d'équivalence à 1 échantillon planifie une étude qui doit montrer que la moyenne d'un procédé est suffisamment proche d'une cible plutôt que différente de celle-ci. Vous fixez un intervalle d'équivalence (limites inférieure et supérieure sur moyenne − cible) et l'outil vous indique combien de mesures sont nécessaires pour prouver que la moyenne s'y trouve, quelle puissance donne un échantillon prévu, ou à quelle distance de la cible la vraie moyenne peut se situer pour un échantillon et une puissance donnés. Saisissez deux éléments parmi l'effectif de l'échantillon, la différence et la puissance, et l'outil calcule le troisième. Utilisez-le avant un test d'équivalence à 1 échantillon, par exemple pour valider une nouvelle tête de remplissage, un instrument de mesure ou une recette par rapport à une valeur nominale.
Principales fonctionnalités
- Calcule l'effectif de l'échantillon, la puissance ou la différence : laissez vide celui que vous voulez obtenir.
- Plusieurs valeurs à la fois, p. ex. des différences « 0 0.5 1 » et des puissances « 0.8 0.9 », donnent une ligne pour chaque combinaison.
- Tout intervalle d'équivalence : symétrique (−2 à 2) ou non (−1 à 3).
- Puissance exacte pour la procédure des deux tests unilatéraux (TOST), avec la distribution t plutôt qu'une approximation normale.
- Courbe de puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points calculés marqués.
Méthodes statistiques
Le test d'équivalence utilise deux tests t unilatéraux (TOST). Avec n mesures, un écart-type σ, une erreur-type SE = σ/√n et n − 1 degrés de liberté, l'équivalence est établie lorsque la moyenne moins la cible est montrée supérieure à la limite inférieure L et inférieure à la limite supérieure U, chacune au seuil de signification α (le champ Significance level (alpha), 0.05 par défaut ; il n'est pas divisé en deux).
La puissance est la probabilité que les deux tests unilatéraux réussissent lorsque la vraie différence (moyenne − cible) est δ. L'outil la calcule exactement : pour un écart-type d'échantillon donné, la probabilité de succès est une différence de deux probabilités normales, Φ(−t·s/σ − (δ − U)/SE) − Φ(t·s/σ − (δ − L)/SE) avec t = t₁₋α,n−1, et elle est moyennée sur la distribution du khi-deux de la variance d'échantillon par intégration numérique. Pour l'effectif de l'échantillon, le n qui atteint la puissance cible est trouvé puis arrondi à l'entier supérieur, et la puissance à ce n est indiquée comme puissance réelle. Lors du calcul de la différence, l'outil cherche entre le milieu des limites et la limite supérieure, car la puissance est la plus élevée lorsque la vraie différence se situe au milieu et diminue vers l'une ou l'autre limite.
La différence à détecter doit se situer strictement entre les limites : une vraie moyenne située à une limite ou au-delà ne peut jamais être montrée équivalente. La puissance augmente avec l'effectif de l'échantillon et la largeur de l'intervalle, et diminue lorsque σ augmente ou que la vraie différence se rapproche d'une limite.
Champs de saisie et options
Champ | Description |
Sample sizes | Séparées par des espaces ou des virgules, p. ex. « 20 30 40 ». Laissez vide pour calculer l'effectif de l'échantillon. |
Difference(s) to detect | Séparées par des espaces ou des virgules, p. ex. « 0.5 0.7 ». La vraie différence (moyenne − cible) que vous attendez ; elle doit se situer strictement entre les limites inférieure et supérieure. Laissez vide pour la calculer (recherche entre le milieu des limites et la limite supérieure). |
Power values | Séparées par des espaces ou des virgules, p. ex. « 0.8 0.9 ». Laissez vide pour calculer la puissance. |
Lower equivalence limit / Upper equivalence limit | Obligatoire. La plus petite et la plus grande différence acceptables par rapport à la cible, en unités de mesure ; la limite inférieure doit être inférieure à la limite supérieure. |
Standard deviation | Obligatoire. Écart-type supposé ou historique des mesures. |
Significance level (alpha) | 0.05 par défaut. Appliqué à chacun des deux tests unilatéraux. |
Power curve | Cochée par défaut : trace la puissance en fonction de l'effectif de l'échantillon. |
Title | Titre affiché sur les résultats et sur la courbe de puissance. |
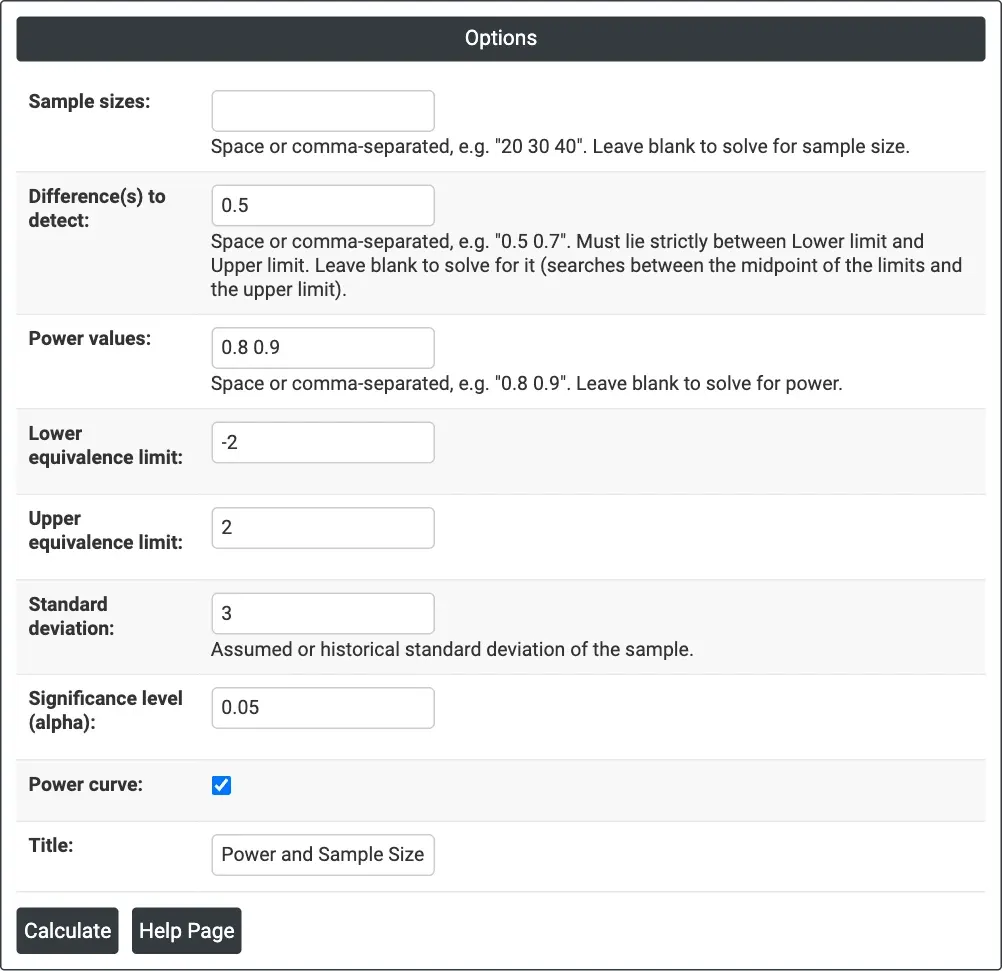
Figure 1 — Calcul de l'effectif de l'échantillon : Difference(s) to detect = 0.5, Power values = 0.8 0.9, limites −2 et 2, Standard deviation = 3, alpha = 0.05.
Description des résultats
- Settings — ce qui a été calculé, les limites d'équivalence inférieure et supérieure, l'écart-type et le seuil de signification.
- Results — une ligne par combinaison : différence, effectif de l'échantillon, et puissance cible et réelle lors du calcul de l'effectif de l'échantillon, ou puissance lors du calcul de la puissance, ou différence lors du calcul de la différence.
- Power Curve — la puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points calculés marqués.
- Export PDF via Download.
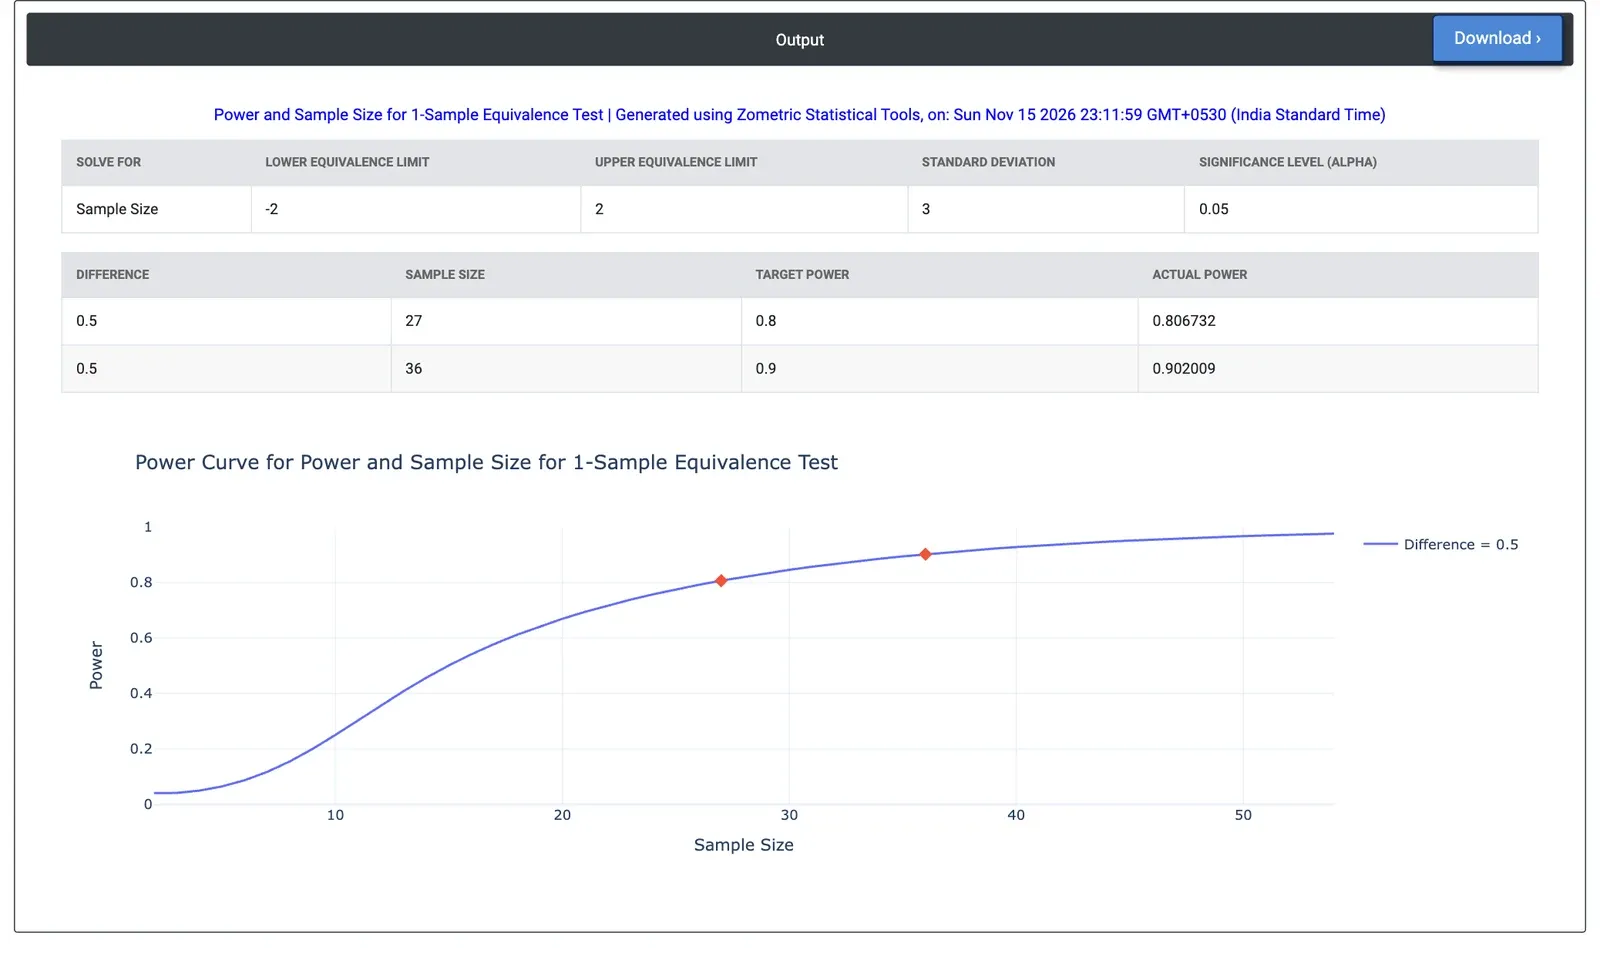
Figure 2 — Résultats de l'exemple : 27 remplissages pour une puissance de 80 % et 36 pour une puissance de 90 % lorsque le vrai décalage est de 0.5 g dans un intervalle de ±2 g.
Exemple résolu
Une ligne d'emballage installe une nouvelle tête de remplissage et doit montrer que son remplissage moyen est à ±2 g de la cible de 500 g avant la mise en service. Les données historiques situent l'écart-type du remplissage à 3 g, et les ingénieurs s'attendent à ce que la nouvelle tête s'écarte de la cible jusqu'à 0.5 g. Ils laissent Sample sizes vide et saisissent Difference(s) to detect = 0.5, Power values = 0.8 0.9, Lower equivalence limit = −2, Upper equivalence limit = 2 et Standard deviation = 3, avec alpha = 0.05.
L'outil exige 27 remplissages pour une puissance de 80 % (puissance réelle 0.807) et 36 remplissages pour une puissance de 90 % (puissance réelle 0.902). Avec seulement 20 remplissages, la puissance est de 0.669, soit une chance sur trois qu'une tête réellement acceptable échoue au test d'équivalence. Le décalage compte : une tête réglée exactement sur la cible exige 21 remplissages pour une puissance de 80 %, tandis qu'une tête à 1 g de la cible en exige 58. Si l'équipe n'est pas sûre du décalage, planifier avec la valeur la plus grande protège l'étude.
Questions fréquentes
En quoi un test d'équivalence diffère-t-il d'un test t à 1 échantillon classique ?
Un test classique cherche à montrer qu'une moyenne est différente d'une cible, tandis qu'un test d'équivalence montre qu'elle en est suffisamment proche. Il utilise deux tests t unilatéraux (TOST) : l'équivalence est établie lorsque la moyenne moins la cible est montrée supérieure à la limite inférieure et inférieure à la limite supérieure, chacune au seuil de signification choisi, qui n'est pas divisé en deux.
Pourquoi la différence à détecter doit-elle se situer entre les limites d'équivalence ?
Une vraie moyenne située à une limite d'équivalence ou au-delà ne peut jamais être montrée équivalente : la différence attendue doit donc se situer strictement entre les limites inférieure et supérieure. La puissance est la plus élevée lorsque la vraie différence se situe au milieu des limites et diminue lorsqu'elle se rapproche de l'une ou l'autre limite. La puissance augmente aussi avec l'effectif de l'échantillon et la largeur de l'intervalle, et diminue lorsque l'écart-type augmente.
Combien d'échantillons faut-il pour un test d'équivalence à 1 échantillon ?
Cela dépend de l'intervalle, de l'écart-type et du décalage attendu. Dans un exemple résolu avec un intervalle de plus ou moins 2 g, un écart-type de 3 g et un décalage attendu de 0.5 g, 27 remplissages donnent une puissance de 80 % et 36 donnent 90 %. Une tête réglée exactement sur la cible exige 21 remplissages, tandis qu'une tête à 1 g de la cible en exige 58.
Comment réaliser cette analyse de puissance dans Zometric Statistical Software ?
Saisissez les limites d'équivalence inférieure et supérieure et l'écart-type, qui sont obligatoires, puis deux éléments parmi les effectifs d'échantillon, les différences à détecter et les valeurs de puissance, en laissant vide celui à calculer. Réglez le seuil de signification (0.05 par défaut) et lancez le calcul. Les résultats affichent les paramètres, une ligne de résultats pour chaque combinaison avec la puissance cible et réelle, et une courbe de puissance.