
Puissance et effectif de l'échantillon : taux de Poisson à 1 échantillon
Planifie un test du taux de Poisson à 1 échantillon avant la collecte des données. Saisissez deux valeurs parmi l'effectif de l'échantillon, le taux de comparaison et la puissance, ainsi que le taux hypothétique et la durée d'observation par unité ; l'outil calcule la troisième. Il utilise une approximation normale de la loi de Poisson et suppose un taux constant par unité. Il fournit un tableau de résultats avec la puissance réelle et une courbe de puissance.
Dernière révision
Point clé
Puissance et effectif de l'échantillon pour un taux de Poisson à 1 échantillon planifie un test d'un taux de comptage, comme des défauts par m², face à une cible : effectif de l'échantillon, puissance ou taux détectable.
Sur cette page
Objectif
Puissance et effectif de l'échantillon pour un taux de Poisson à 1 échantillon planifie un test d'un taux de comptage, comme des défauts par mètre carré, des pannes par mois ou des erreurs par lot, face à une cible ou à un taux historique. Saisissez deux valeurs parmi l'effectif de l'échantillon, le taux de comparaison et la puissance, et l'outil calcule la troisième : combien d'unités observer, quelle probabilité un échantillon prévu donne de détecter le changement de taux, ou le plus petit changement qu'un échantillon donné peut détecter. Utilisez-le avant un test du taux de Poisson à 1 échantillon.
Principales fonctionnalités
- Détermine l'effectif de l'échantillon, la puissance ou le taux de comparaison : laissez vide celui que vous cherchez.
- Plusieurs valeurs à la fois, par ex. des taux de comparaison « 1 1.2 » et des puissances « 0.8 0.9 », donnent une ligne pour chaque combinaison.
- Durée d'observation par unité, pour étudier un même taux avec des unités plus grandes ou plus petites (par exemple des tôles de 1 m² ou de 2 m²).
- Alternatives bilatérale (taux ≠ taux hypothétique) ou unilatérales (inférieur, supérieur), au niveau de confiance de votre choix.
- Courbe de puissance en fonction de l'effectif de l'échantillon pour chaque taux de comparaison, avec les points calculés repérés.
Méthodes statistiques
L'outil utilise une approximation normale de la distribution de Poisson. Les comptages sont supposés suivre une distribution de Poisson de taux constant par unité d'observation, de sorte que la variance d'un comptage est égale à sa moyenne. Avec n unités observées chacune sur une durée t, l'exposition totale est n·t. Le seuil de signification est α = 1 − niveau de confiance / 100, et z est z₁₋α/₂ pour l'alternative bilatérale ou z₁₋α pour une alternative unilatérale.
Pour un taux hypothétique λ₀ et un taux de comparaison λ₁, posons Δ = λ₁ − λ₀ pour l'alternative « supérieur à », Δ = λ₀ − λ₁ pour « inférieur à » et Δ = |λ₁ − λ₀| pour l'alternative bilatérale. La puissance est Φ((Δ·√(n·t) − z·√λ₀) / √λ₁). L'exposition nécessaire pour une puissance cible est ((z·√λ₀ + z_β·√λ₁) / Δ)², où z_β est le quantile normal de la puissance ; diviser par t et arrondir à l'entier supérieur donne le nombre d'unités, et la puissance à ce nombre entier est indiquée comme puissance réelle. Lorsque l'outil détermine le taux de comparaison, il cherche en dessous de λ₀ pour l'alternative « inférieur à » et au-dessus de λ₀ sinon.
Un test unilatéral n'a de puissance que si le taux de comparaison se situe du côté que désigne l'alternative : avec Rate < hypothesized rate, un taux de comparaison supérieur à λ₀ donne une puissance proche de 0, et la détermination de l'effectif de l'échantillon à partir de celui-ci renvoie un message d'erreur. Ce qui compte est l'exposition totale : doubler la durée d'observation par unité divise à peu près par deux le nombre d'unités nécessaires. Les taux doivent être dans la même unité que la durée d'observation (par exemple des défauts par m² avec des durées en m²).
Champs de saisie et options
Champ | Description |
Sample sizes | Nombre d'unités observées. Séparées par des espaces ou des virgules, par ex. « 20 30 40 ». Laissez vide pour déterminer l'effectif de l'échantillon. |
Hypothesized rate | Obligatoire. Le taux cible ou historique λ₀ par unité de durée d'observation. |
Comparison rate(s) | Séparés par des espaces ou des virgules, par ex. « 1.5 2 ». Le ou les taux dont vous voulez détecter l'écart. Laissez vide pour le déterminer. |
Power values | Séparées par des espaces ou des virgules, par ex. « 0.8 0.9 ». Laissez vide pour déterminer la puissance. |
Length of observation | 1 par défaut. Durée d'observation (temps, espace, surface ou volume) par unité échantillonnée. |
Confidence level | 95 par défaut (α = 0.05) ; de 75 à 100. |
Alternative hypothesis | Rate ≠ hypothesized rate (par défaut), Rate < hypothesized rate ou Rate > hypothesized rate. |
Power curve | Cochée par défaut : trace la puissance en fonction de l'effectif de l'échantillon. |
Title | Titre affiché sur les résultats et la courbe de puissance. |
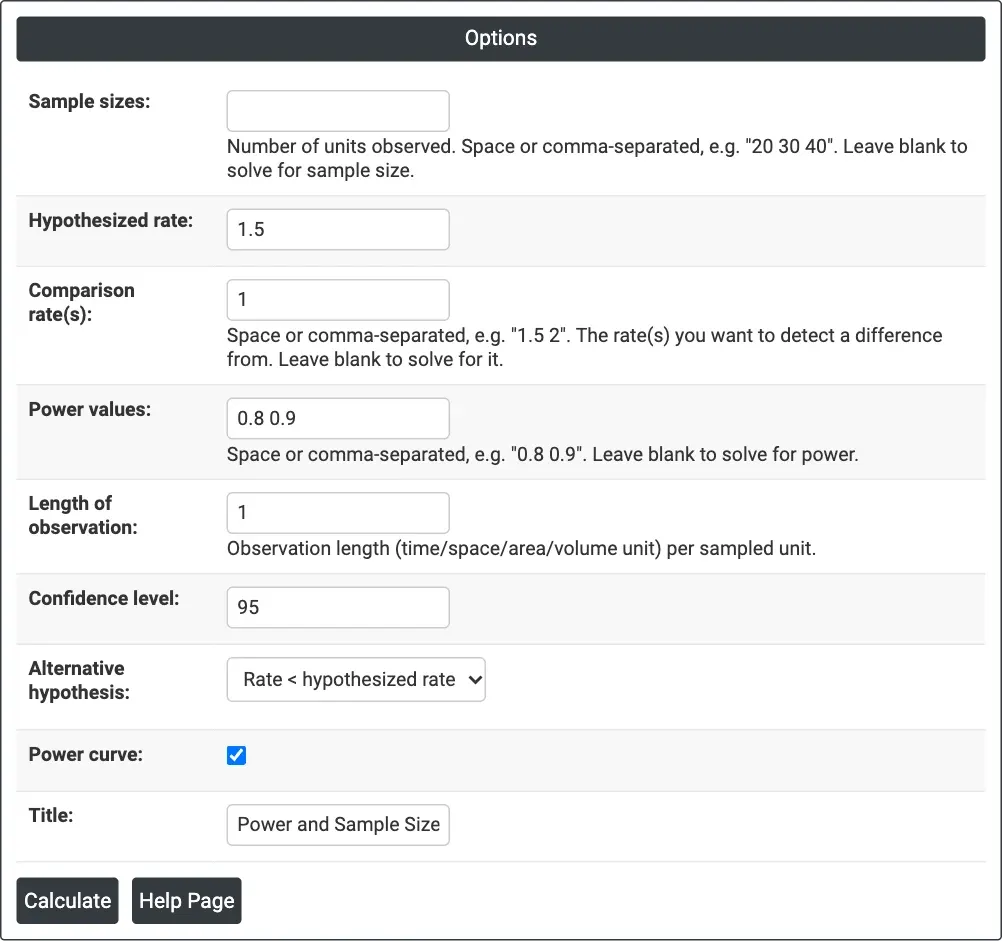
Figure 1 — Détermination de l'effectif de l'échantillon : Hypothesized rate = 1.5, Comparison rate(s) = 1, Power values = 0.8 0.9, Length of observation = 1, unilatéral (Rate < hypothesized rate) à un niveau de confiance de 95 %.
Description des résultats
- Settings — ce qui a été déterminé, le taux hypothétique, la durée d'observation, le niveau de confiance et l'hypothèse alternative.
- Results — une ligne par combinaison : taux de comparaison, effectif de l'échantillon, et puissance cible et réelle lorsque l'on détermine l'effectif de l'échantillon, ou puissance lorsque l'on détermine la puissance, ou taux de comparaison lorsque l'on détermine celui-ci.
- Power Curve — puissance en fonction de l'effectif de l'échantillon pour chaque taux de comparaison, avec les points calculés repérés.
- Export PDF via Download.
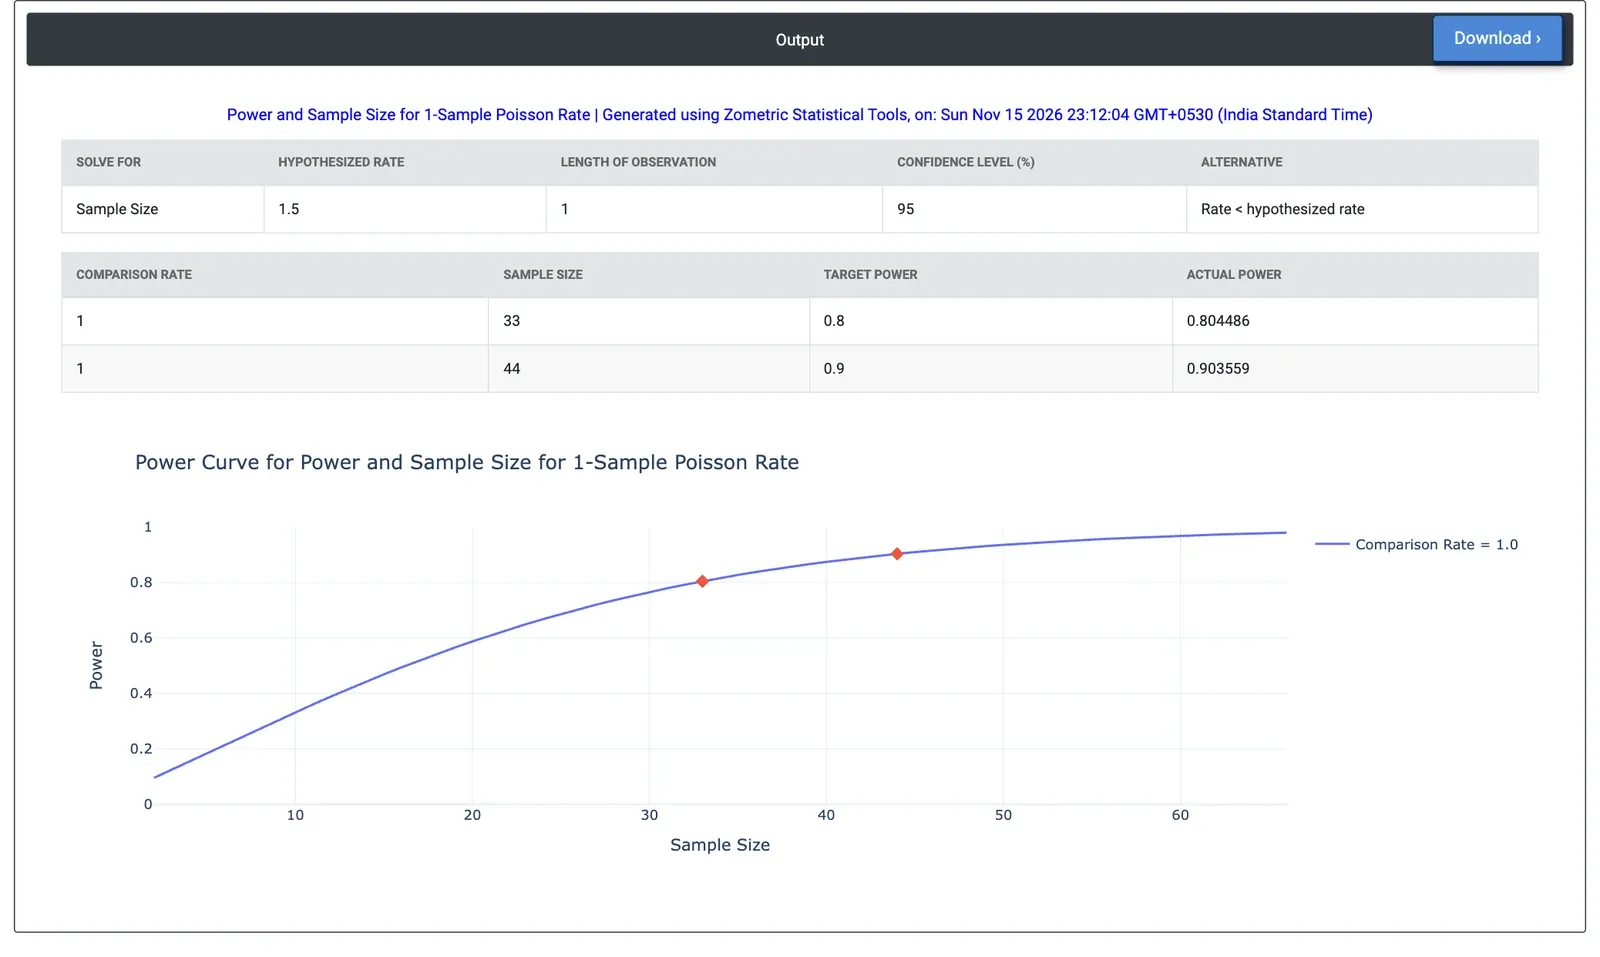
Figure 2 — Résultats de l'exemple : 33 tôles pour une puissance de 80 % et 44 pour 90 % afin de détecter une baisse de 1.5 à 1.0 défaut par m².
Exemple résolu
Une ligne de revêtement présente en moyenne 1.5 défaut de surface par mètre carré de tôle. Une nouvelle sous-couche devrait le ramener à 1.0 défaut par m², et l'ingénieur qualité veut savoir combien de tôles d'essai de 1 m² contrôler pour démontrer la réduction. Seule une baisse compte ; l'ingénieur choisit donc Rate < hypothesized rate. Il laisse Sample sizes vide et saisit Hypothesized rate = 1.5, Comparison rate(s) = 1, Power values = 0.8 0.9 et Length of observation = 1, à un niveau de confiance de 95 %.
L'outil exige 33 tôles pour une puissance de 80 % (puissance réelle 0.804) et 44 tôles pour une puissance de 90 % (puissance réelle 0.904). Si seules 20 tôles sont contrôlées, la puissance tombe à 0.588. Contrôler de plus grandes tôles de 2 m² (Length of observation = 2) ramène le nombre à 17 tôles pour une puissance de 80 % et 22 pour 90 %, car c'est la surface totale contrôlée qui détermine la puissance. Un test bilatéral, qui signalerait aussi une hausse, exige 43 tôles de 1 m² pour une puissance de 80 %.
Questions fréquentes
Quelles sont les hypothèses de la puissance et de l'effectif de l'échantillon pour un taux de Poisson à 1 échantillon ?
Les comptages sont supposés suivre une distribution de Poisson de taux constant par unité d'observation, de sorte que la variance d'un comptage est égale à sa moyenne. Le calcul utilise une approximation normale de la distribution de Poisson. Les taux doivent être dans la même unité que la durée d'observation, par exemple des défauts par mètre carré avec des durées en mètres carrés.
Comment la durée d'observation influence-t-elle l'effectif de l'échantillon ?
La puissance dépend de l'exposition totale, c'est-à-dire du nombre d'unités multiplié par la durée d'observation par unité. Doubler la durée par unité divise à peu près par deux le nombre d'unités nécessaires. Dans un exemple résolu, détecter une baisse de 1.5 à 1.0 défaut par mètre carré exige 33 tôles de 1 mètre carré pour une puissance de 80 %, mais seulement 17 tôles de 2 mètres carrés.
Combien d'unités faut-il pour détecter un changement de taux de défauts ?
Dans un exemple résolu avec un taux hypothétique de 1.5 défaut par mètre carré et un taux de comparaison de 1.0, un test unilatéral à un niveau de confiance de 95 % exige 33 tôles pour une puissance de 80 % et 44 pour 90 %. Contrôler seulement 20 tôles donne une puissance de 0.588, et un test bilatéral exige 43 tôles pour une puissance de 80 %.
Que se passe-t-il si le taux de comparaison est du mauvais côté pour un test unilatéral ?
Un test unilatéral n'a de puissance que si le taux de comparaison se situe du côté que désigne l'alternative. Avec Rate < hypothesized rate, un taux de comparaison supérieur au taux hypothétique donne une puissance proche de 0, et la détermination de l'effectif de l'échantillon à partir de celui-ci renvoie un message d'erreur. Utilisez l'alternative bilatérale si un changement dans l'un ou l'autre sens compte.