
Puissance et effectif de l'échantillon : test t à 1 échantillon
Planifie un test t à 1 échantillon d'une moyenne par rapport à une valeur cible ou nominale. Saisissez deux éléments parmi l'effectif de l'échantillon, la différence et la puissance, plus un écart-type supposé : l'outil résout le troisième. Il suppose des données normales dont l'écart-type est estimé à partir de l'échantillon et calcule la puissance à partir de la distribution t non centrée. Les résultats comprennent un tableau avec la puissance réelle et une courbe de puissance.
Dernière révision
Point clé
Power and Sample Size for 1-Sample t calcule combien de mesures un test t à 1 échantillon exige pour détecter un décalage par rapport à une moyenne cible, la puissance d'un échantillon prévu, ou le plus petit décalage détectable.
Sur cette page
Objectif
Power and Sample Size for 1-Sample t planifie, avant le recueil des données, un test d'une moyenne par rapport à une valeur cible ou nominale : combien de mesures sont nécessaires pour détecter un décalage qui compte, quelle probabilité (puissance) un échantillon prévu a de le détecter, ou quel est le plus petit décalage qu'un échantillon donné peut détecter. Saisissez deux éléments parmi l'effectif de l'échantillon, la différence et la puissance : l'outil résout le troisième. Utilisez-le avant un test t à 1 échantillon, par exemple pour vérifier si une machine est centrée sur la valeur nominale ou si un matériau respecte une moyenne spécifiée.
Principales fonctionnalités
- Résout l'effectif de l'échantillon, la puissance ou la différence : laissez vide celui que vous voulez obtenir.
- Plusieurs valeurs à la fois, par ex. des différences « 0.01 0.02 » et des puissances « 0.8 0.9 », donnent une ligne pour chaque combinaison.
- Hypothèses alternatives bilatérale (Mean ≠ hypothesized mean) ou unilatérales (Mean < hypothesized mean, Mean > hypothesized mean), au niveau de confiance de votre choix.
- Pour la résolution de l'effectif de l'échantillon, indique le nombre entier de mesures et la puissance réelle qu'il procure.
- Courbe de puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points résolus repérés.
Méthodes statistiques
Le calcul suppose que les mesures proviennent d'une population normale dont l'écart-type σ est estimé à partir de l'échantillon, comme dans le test t à 1 échantillon. Le seuil de signification est α = 1 − niveau de confiance / 100, et la différence standardisée est d = différence / σ, la différence étant la moyenne vraie moins la moyenne hypothétique.
La puissance est la probabilité que le test t rejette l'hypothèse nulle lorsque la moyenne vraie diffère de la moyenne hypothétique de la différence saisie. Elle est calculée à partir de la distribution t non centrée à n − 1 degrés de liberté et de paramètre de non-centralité δ = d·√n : pour un test bilatéral, puissance = P(T > t₁₋α/₂) + P(T < −t₁₋α/₂), où T suit cette distribution t non centrée ; pour un test unilatéral, seule la queue du côté de l'hypothèse alternative compte. Pour l'effectif de l'échantillon, on cherche le n qui donne la puissance cible, arrondi à l'entier supérieur, et la puissance à ce n est indiquée comme puissance réelle. Pour la différence, on cherche la plus petite différence qui atteint la puissance cible avec le n donné.
La puissance augmente avec l'effectif de l'échantillon et l'ampleur de la différence, et diminue lorsque σ augmente ou que le niveau de confiance s'élève. Un test unilatéral exige moins de mesures pour la même puissance mais ne détecte qu'un décalage dans le sens indiqué : avec Mean > hypothesized mean, une différence négative donne une puissance proche de 0, et la résolution de l'effectif de l'échantillon à partir de lui renvoie un message d'erreur. Pour le test bilatéral, seule compte l'ampleur de la différence. La résolution de la différence avec Mean < hypothesized mean renvoie une différence négative.
Champs de saisie et options
Champ | Description |
Sample sizes | Séparées par des espaces ou des virgules, par ex. « 10 20 30 ». Laissez vide pour résoudre l'effectif de l'échantillon. |
Differences | Séparées par des espaces ou des virgules, par ex. « 1 2 3 ». La différence par rapport à la moyenne hypothétique que vous voulez détecter, en unités de mesure. Laissez vide pour résoudre la différence. |
Power values | Séparées par des espaces ou des virgules, par ex. « 0.8 0.9 ». Laissez vide pour résoudre la puissance. |
Standard deviation | Obligatoire. Écart-type supposé ou historique de la population, par ex. issu de données passées ou d'un essai pilote. |
Confidence level | 95 par défaut (α = 0.05) ; de 75 à 100. |
Alternative hypothesis | Mean ≠ hypothesized mean (par défaut), Mean < hypothesized mean ou Mean > hypothesized mean. |
Power curve | Cochée par défaut : trace la puissance en fonction de l'effectif de l'échantillon. |
Title | Titre affiché sur les résultats et la courbe de puissance. |
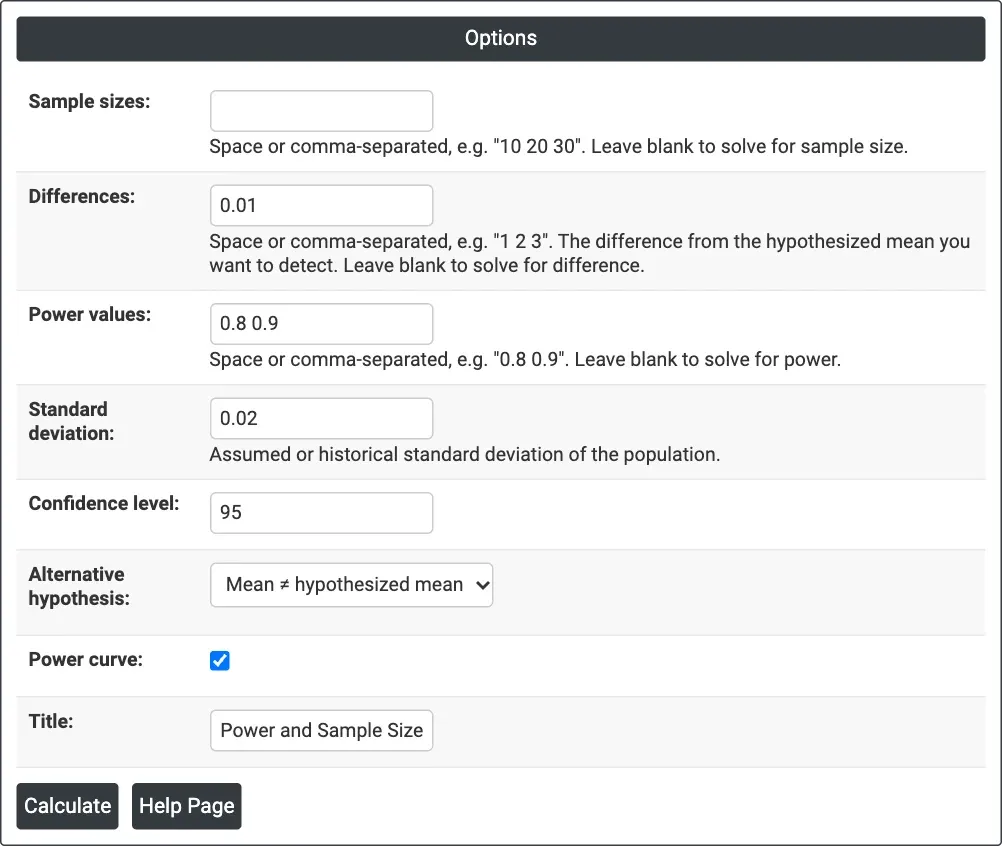
Figure 1 — Résolution de l'effectif de l'échantillon : Differences = 0.01, Power values = 0.8 0.9, Standard deviation = 0.02, bilatéral à 95% de confiance.
Description des résultats
- Settings — ce qui a été résolu, l'écart-type, le niveau de confiance et l'hypothèse alternative.
- Results — une ligne par combinaison : différence, effectif de l'échantillon, et puissance cible et réelle lorsque l'on résout l'effectif de l'échantillon, ou puissance lorsque l'on résout la puissance, ou différence lorsque l'on résout la différence.
- Power Curve — puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points calculés repérés.
- Export PDF via Download.
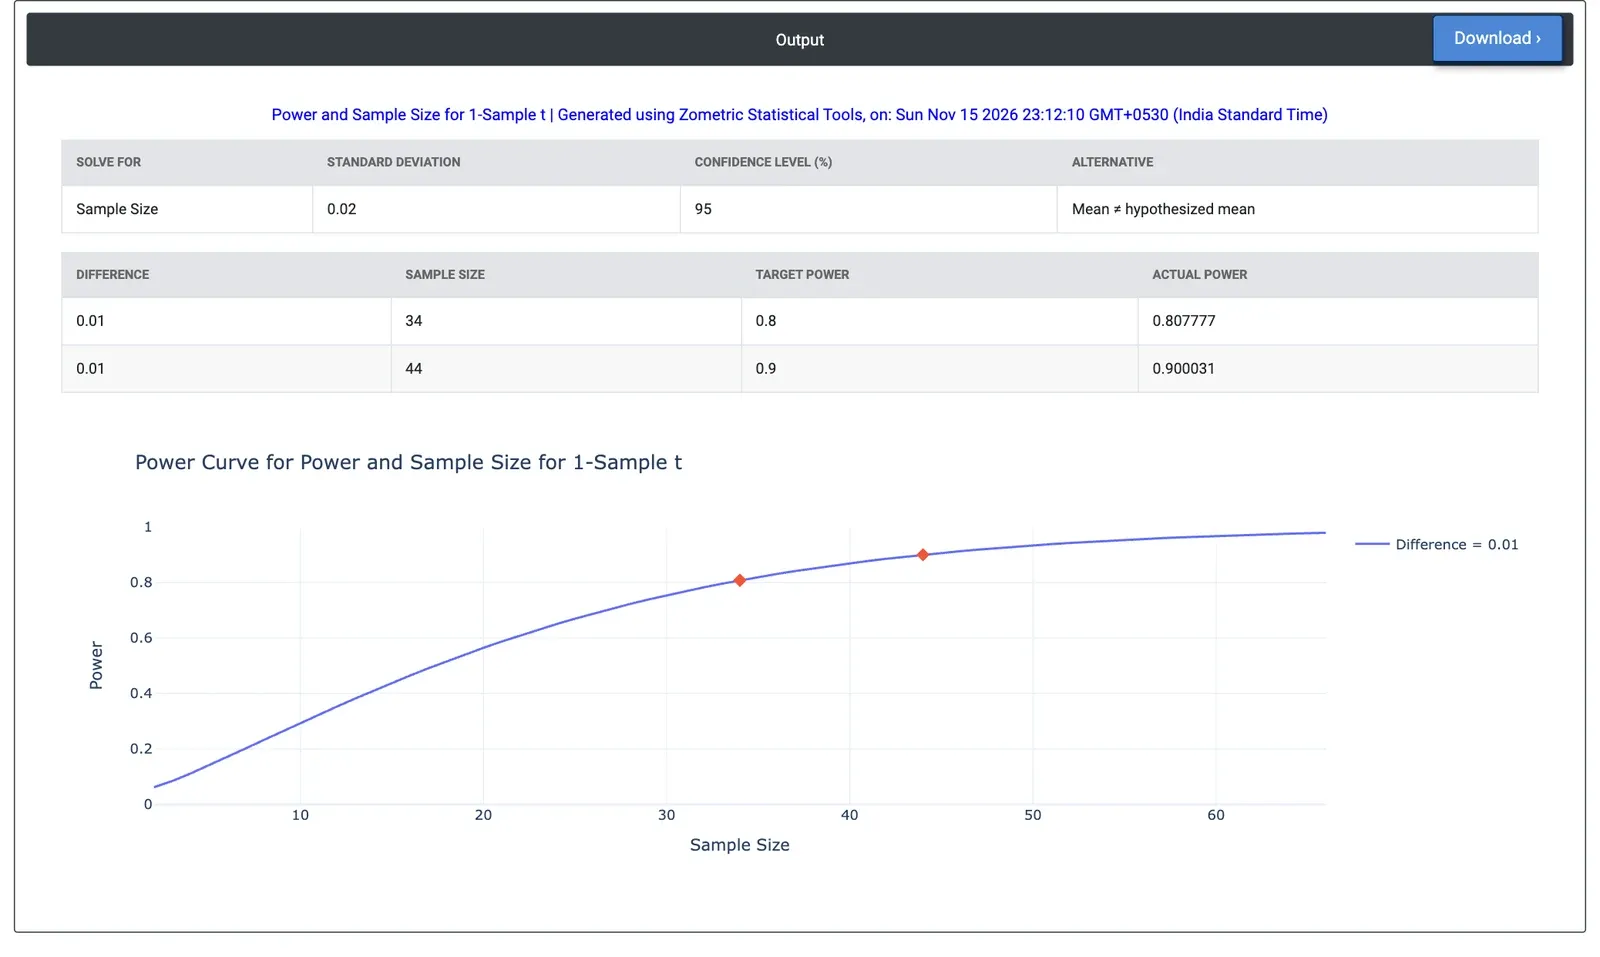
Figure 2 — Résultats de l'exemple : 34 arbres pour 80% de puissance et 44 pour 90% de puissance afin de détecter un décalage de 0.01 mm par rapport à la valeur nominale.
Exemple résolu
Une cellule de tournage fabrique des arbres de diamètre nominal 25.00 mm. Après un changement d'outil, le superviseur veut vérifier que le procédé est toujours centré, et un décalage de 0.01 mm dans un sens ou dans l'autre aurait de l'importance. Les données passées situent l'écart-type du diamètre à 0.02 mm. Le superviseur laisse Sample sizes vide, saisit Differences = 0.01, Power values = 0.8 0.9 et Standard deviation = 0.02, et conserve l'hypothèse alternative bilatérale à 95% de confiance.
L'outil exige 34 arbres pour 80% de puissance (puissance réelle 0.808) et 44 arbres pour 90% de puissance (puissance réelle 0.900). Le contrôle habituel de 20 arbres ne donne qu'une puissance de 0.565 pour un décalage de 0.01 mm ; avec 20 arbres et 80% de puissance, le plus petit décalage que le test peut détecter de façon fiable est de 0.0132 mm. Si seul un décalage vers le surdimensionné compte (Mean > hypothesized mean), 27 arbres donnent 80% de puissance.
Questions fréquentes
Comment calcule-t-on la puissance d'un test t à 1 échantillon ?
La puissance est la probabilité que le test t rejette l'hypothèse nulle lorsque la moyenne vraie diffère de la moyenne hypothétique de la différence saisie. Elle est calculée à partir de la distribution t non centrée à n - 1 degrés de liberté et de paramètre de non-centralité d fois la racine carrée de n, où d est la différence divisée par l'écart-type. Un test bilatéral compte les deux queues.
Quel écart-type saisir pour une analyse de puissance d'un test t à 1 échantillon ?
Saisissez un écart-type supposé ou historique de la population, par exemple issu de données passées ou d'un essai pilote. Il est obligatoire, car la puissance dépend de la différence relativement à l'écart-type. La puissance augmente avec l'effectif de l'échantillon et l'ampleur de la différence, et diminue lorsque l'écart-type augmente ou que le niveau de confiance s'élève.
Combien de mesures faut-il pour un test t à 1 échantillon ?
Dans un exemple résolu, détecter un décalage de 0.01 mm par rapport au diamètre nominal d'un arbre, avec un écart-type de 0.02 mm, bilatéral à 95% de confiance, exige 34 arbres pour 80% de puissance et 44 pour 90% de puissance. Un contrôle de 20 arbres ne donne qu'une puissance de 0.565. Si seul un décalage vers le surdimensionné compte, 27 arbres donnent 80% de puissance.
Faut-il choisir une hypothèse alternative unilatérale ou bilatérale ?
Un test unilatéral exige moins de mesures pour la même puissance mais ne détecte qu'un décalage dans le sens indiqué. Avec Mean > hypothesized mean, une différence négative donne une puissance proche de 0, et la résolution de l'effectif de l'échantillon à partir de lui renvoie un message d'erreur. Pour le test bilatéral, seule compte l'ampleur de la différence, pas son signe.