
Puissance et effectif de l'échantillon pour un test z à 1 échantillon
Planifie un test z à 1 échantillon d'une moyenne lorsque l'écart-type est connu, par exemple grâce à un long historique stable de carte de contrôle. Saisissez deux éléments parmi l'effectif de l'échantillon, la différence et la puissance, ainsi que l'écart-type connu, et l'outil calcule le troisième par des formules normales exactes. Fournit un tableau de résultats avec la puissance réelle et une courbe de puissance. Si l'écart-type sera estimé, utilisez 1-Sample t.
Dernière révision
Point clé
Power and Sample Size for 1-Sample Z planifie un test d'une moyenne par rapport à une cible lorsque l'écart-type du procédé est connu, en cherchant l'effectif de l'échantillon, la puissance ou la plus petite différence détectable.
Sur cette page
Objectif
Power and Sample Size for 1-Sample Z planifie un test d'une moyenne par rapport à une cible lorsque l'écart-type du procédé est connu, par exemple grâce à un long historique stable de carte de contrôle. Il répond aux questions suivantes : combien de mesures faut-il pour détecter un décalage qui compte, quelle puissance procure un échantillon prévu, ou quel est le plus petit décalage qu'un échantillon donné peut détecter. Saisissez deux éléments parmi l'effectif de l'échantillon, la différence et la puissance, et l'outil calcule le troisième. Utilisez-le avant un test z à 1 échantillon ; si l'écart-type sera estimé à partir de l'échantillon, utilisez plutôt Power and Sample Size for 1-Sample t.
Principales fonctionnalités
- Calcule l'effectif de l'échantillon, la puissance ou la différence : laissez vide celui que vous cherchez.
- Plusieurs valeurs à la fois, p. ex. des effectifs d'échantillon « 10 20 30 », donnent une ligne par combinaison.
- Hypothèses alternatives bilatérale (Mean ≠ hypothesized mean) ou unilatérales (Mean < hypothesized mean, Mean > hypothesized mean), au niveau de confiance de votre choix.
- Calcul normal exact, donc des résultats exacts pour un écart-type connu.
- Courbe de puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points calculés repérés.
Méthodes statistiques
La statistique de test est Z = (x̄ − μ₀) / (σ/√n), σ étant considéré comme connu, de sorte que le calcul utilise la distribution normale centrée réduite de bout en bout. Le seuil de signification est α = 1 − niveau de confiance / 100, la différence standardisée est d = différence / σ (la différence étant la vraie moyenne moins μ₀), et z est z₁₋α/₂ pour l'alternative bilatérale ou z₁₋α pour une alternative unilatérale.
Pour un test bilatéral, puissance = Φ(|d|·√n − z) + Φ(−|d|·√n − z) ; pour Mean > hypothesized mean, puissance = Φ(d·√n − z), et pour Mean < hypothesized mean, puissance = Φ(−d·√n − z), de sorte qu'un test unilatéral a une puissance proche de 0 pour une différence du mauvais côté. L'effectif de l'échantillon pour une puissance cible est n = ((z + z_β) / d)², où z_β est le quantile normal de la puissance cible ; n est arrondi à l'entier supérieur et la puissance à cet entier est indiquée comme puissance réelle. La plus petite différence détectable pour un n et une puissance donnés est σ·(z + z_β)/√n, indiquée comme différence négative pour l'alternative « inférieur à ».
Comme σ n'est pas estimé, le calcul z donne une puissance légèrement supérieure à celle du calcul t à effectif égal, de façon plus marquée pour les petits échantillons. Ne l'utilisez que si l'écart-type est réellement connu et stable. Avec une alternative unilatérale, calculer l'effectif de l'échantillon à partir d'une différence du mauvais côté renvoie un message d'erreur.
Champs et options de saisie
Champ | Description |
Sample sizes | Séparées par des espaces ou des virgules, p. ex. « 10 20 30 ». Laissez vide pour calculer l'effectif de l'échantillon. |
Differences | Séparées par des espaces ou des virgules, p. ex. « 1 2 3 ». La différence par rapport à la moyenne hypothétique que vous voulez détecter. Laissez vide pour calculer la différence. |
Power values | Séparées par des espaces ou des virgules, p. ex. « 0.8 0.9 ». Laissez vide pour calculer la puissance. |
Known standard deviation | Obligatoire. L'écart-type de la population, supposé connu (non estimé à partir de l'échantillon). |
Confidence level | Par défaut 95 (α = 0.05) ; de 75 à 100. |
Alternative hypothesis | Mean ≠ hypothesized mean (par défaut), Mean < hypothesized mean ou Mean > hypothesized mean. |
Power curve | Coché par défaut : trace la puissance en fonction de l'effectif de l'échantillon. |
Title | Titre affiché sur les résultats et sur la courbe de puissance. |
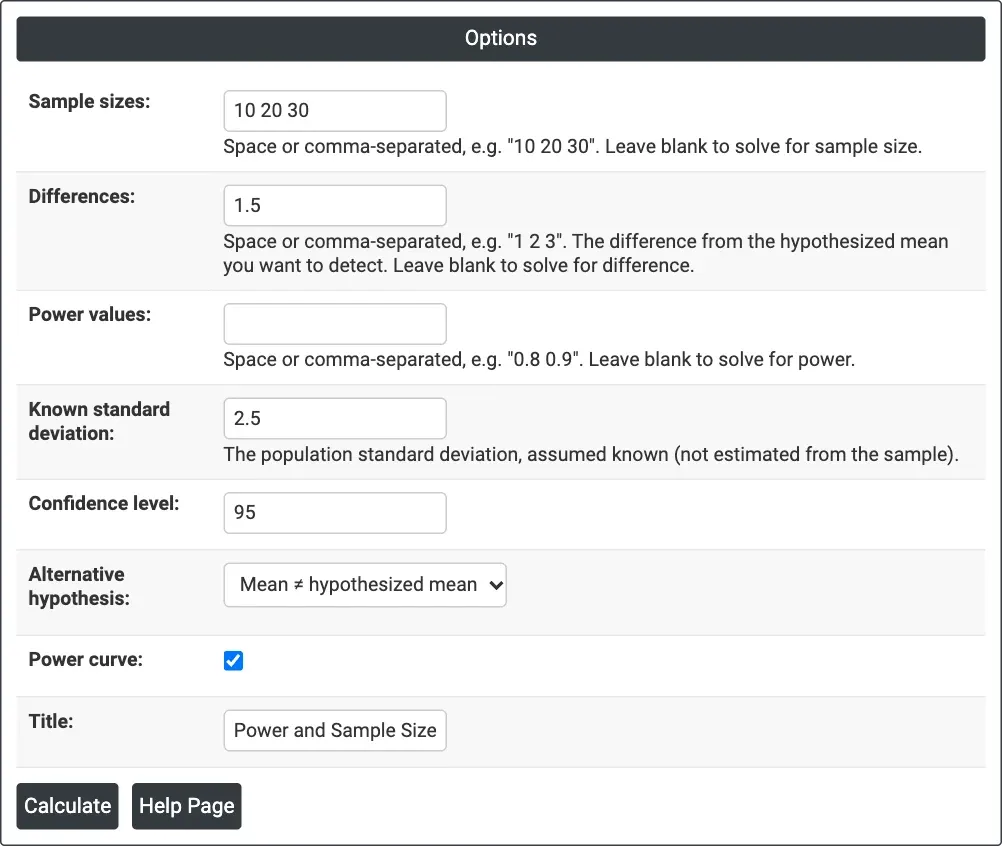
Figure 1 — Calcul de la puissance : Sample sizes = 10 20 30, Differences = 1.5, Known standard deviation = 2.5, bilatéral à 95% de confiance.
Description des résultats
- Settings — ce qui a été calculé, l'écart-type connu, le niveau de confiance et l'hypothèse alternative.
- Results — une ligne par combinaison : différence, effectif de l'échantillon, et puissance lorsque la puissance est calculée, puissance cible et réelle lorsque l'effectif de l'échantillon est calculé, ou différence lorsque la différence est calculée.
- Power Curve — puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points calculés repérés.
- Export PDF via Download.
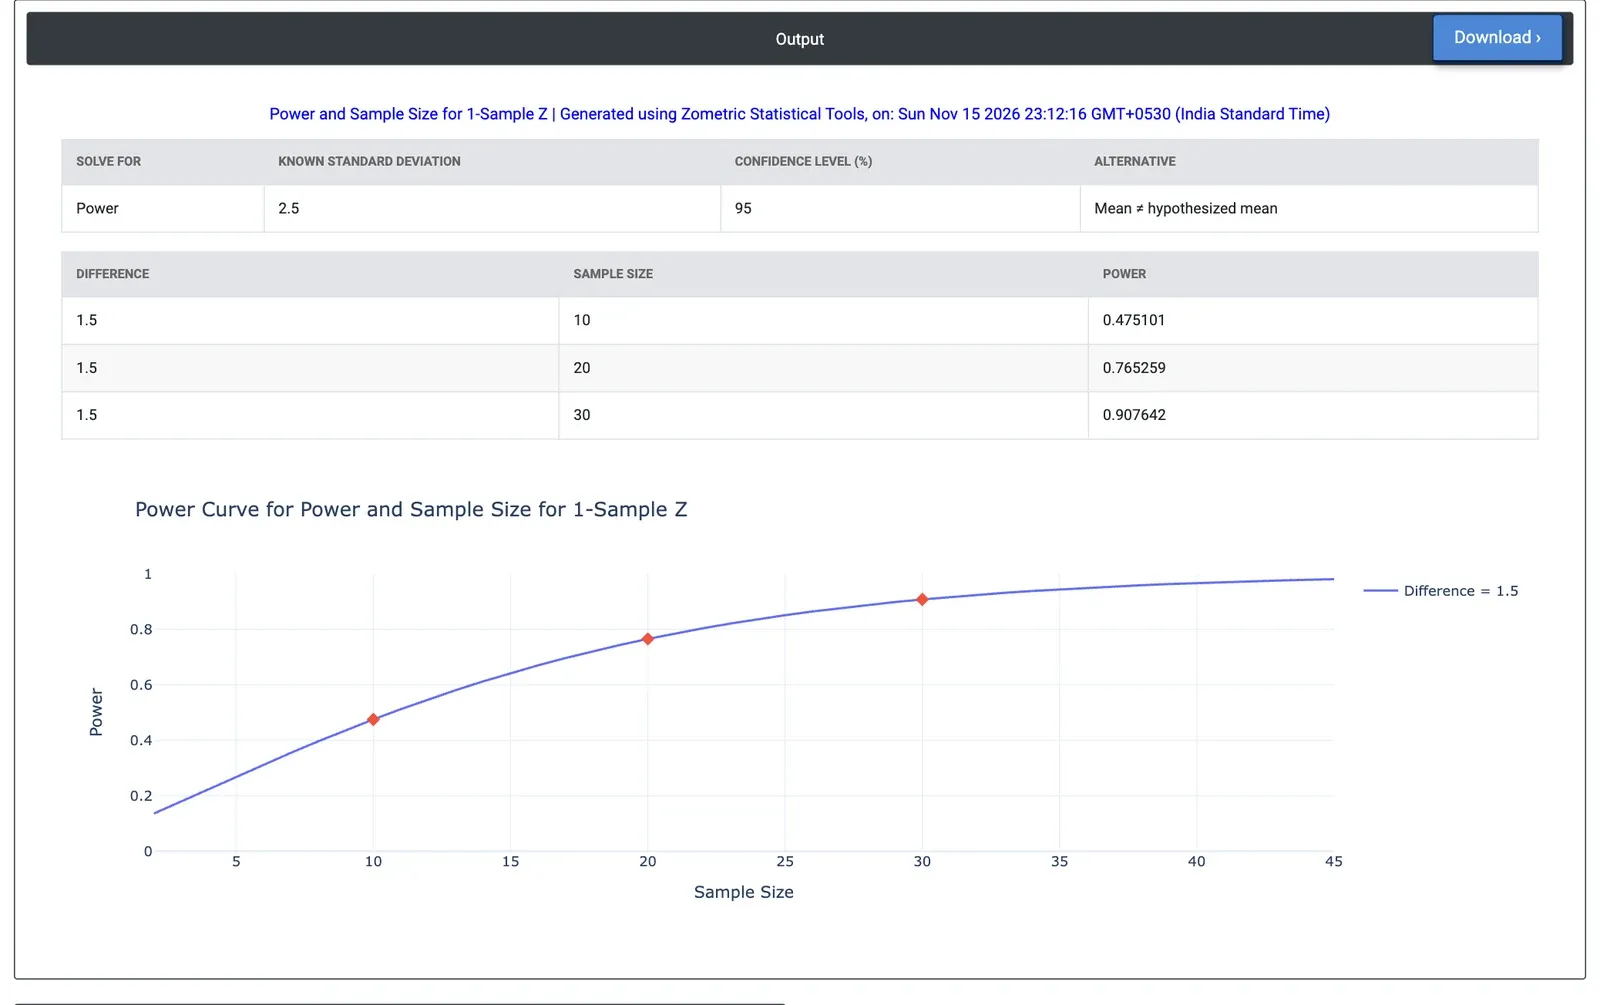
Figure 2 — Résultats de l'exemple : puissance de 0.475, 0.765 et 0.908 pour 10, 20 et 30 paquets avec un décalage de 1.5 g.
Exemple résolu
Un conditionneur alimentaire contrôle la masse moyenne de paquets de 250 g. Des années de données stables de carte de contrôle fixent l'écart-type à 2.5 g, qui est donc considéré comme connu. Un décalage de 1.5 g dans un sens ou dans l'autre serait important, et l'équipe d'audit veut comparer des échantillons de 10, 20 et 30 paquets. Elle saisit Sample sizes = 10 20 30, Differences = 1.5 et Known standard deviation = 2.5, laisse Power values vide et conserve l'alternative bilatérale à 95% de confiance.
La puissance est de 0.475 avec 10 paquets, 0.765 avec 20 et 0.908 avec 30. Un audit de 10 paquets manquerait un vrai décalage de 1.5 g plus d'une fois sur deux ; l'équipe passe donc à 30 paquets ; le calcul de l'effectif de l'échantillon avec Power values = 0.9 confirme que 30 paquets sont le minimum pour une puissance de 90 %. Avec 20 paquets et une puissance de 80 %, le plus petit décalage détectable est 1.57 g. Si l'écart-type avait été estimé à partir de chaque échantillon (calcul 1-Sample t), les puissances seraient plus faibles : 0.396, 0.721 et 0.888.
Questions fréquentes
Quand utiliser le calcul de puissance z à 1 échantillon plutôt que 1-Sample t ?
N'utilisez le calcul z que si l'écart-type du procédé est réellement connu et stable, par exemple grâce à des années de données de carte de contrôle. Si l'écart-type sera estimé à partir de l'échantillon, utilisez Power and Sample Size for 1-Sample t. Comme l'écart-type n'est pas estimé, z donne une puissance légèrement supérieure à t à effectif égal, de façon plus marquée pour les petits échantillons.
Quelle est la formule de l'effectif de l'échantillon pour un test z à 1 échantillon ?
L'effectif de l'échantillon pour une puissance cible est n = ((z + z_bêta) / d) au carré, où d est la différence divisée par l'écart-type connu, z est la valeur critique de l'alternative choisie et z_bêta est le quantile normal de la puissance cible. Le résultat est arrondi à l'entier supérieur et la puissance à cet entier est indiquée comme puissance réelle.
Comment trouver la plus petite différence détectable ?
Pour un effectif d'échantillon et une puissance donnés, la plus petite différence détectable est l'écart-type multiplié par (z + z_bêta) et divisé par la racine carrée de n. Elle est indiquée comme différence négative pour l'alternative « inférieur à ». Dans un exemple résolu avec un écart-type connu de 2.5 g, 20 paquets à 80 % de puissance peuvent détecter un décalage de 1.57 g.
Comment l'effectif de l'échantillon influe-t-il sur la puissance d'un test z à 1 échantillon ?
La puissance croît avec l'effectif de l'échantillon. Dans un exemple résolu avec un écart-type connu de 2.5 g et un décalage de 1.5 g, bilatéral à 95% de confiance, la puissance est de 0.475 avec 10 paquets, 0.765 avec 20 et 0.908 avec 30. Estimer plutôt l'écart-type, comme dans le calcul 1-Sample t, donnerait des puissances plus faibles de 0.396, 0.721 et 0.888.