
Puissance et effectif de l'échantillon pour un test d'équivalence à 2 échantillons
Planifie un test d'équivalence à 2 échantillons qui doit montrer que deux groupes indépendants ont pratiquement la même moyenne, par exemple deux fournisseurs. Saisissez les limites d'équivalence, un écart-type groupé et deux valeurs parmi l'effectif de l'échantillon par groupe, la différence et la puissance ; l'outil détermine la troisième. La puissance est calculée exactement pour le TOST avec des groupes de tailles égales. Résultats : un tableau et une courbe de puissance.
Dernière révision
Point clé
Calcule le nombre d'unités nécessaires dans chacun de deux groupes indépendants pour montrer, par deux tests t unilatéraux (TOST), que leurs moyennes diffèrent de moins d'une fenêtre d'équivalence.
Sur cette page
Objectif
Power and Sample Size for 2-Sample Equivalence Test planifie une étude qui doit montrer que deux groupes indépendants ont pratiquement la même moyenne, par exemple un second fournisseur par rapport au fournisseur actuel, une nouvelle machine par rapport à une ancienne, ou un matériau moins cher par rapport au matériau standard. Vous fixez une fenêtre d'équivalence pour la différence (moyenne d'essai − moyenne de référence), et l'outil vous indique combien d'unités chaque groupe doit compter pour prouver que la différence se situe à l'intérieur, quelle puissance donne un échantillon prévu, ou quelle ampleur de différence réelle peut être tolérée. Saisissez deux valeurs parmi l'effectif de l'échantillon, la différence et la puissance, et l'outil détermine la troisième. Utilisez-le avant un test d'équivalence à 2 échantillons.
Principales fonctionnalités
- Détermine l'effectif de l'échantillon, la puissance ou la différence : laissez vide celui que vous voulez obtenir.
- Plusieurs valeurs à la fois, par ex. des différences « 0 0.5 » et des puissances « 0.8 0.9 », donnent une ligne pour chaque combinaison.
- Toute fenêtre d'équivalence, symétrique ou non.
- Puissance exacte pour la procédure des deux tests unilatéraux (TOST) avec un écart-type groupé et des groupes de tailles égales.
- Courbe de puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points déterminés repérés.
Méthodes statistiques
Le test d'équivalence utilise deux tests t unilatéraux (TOST) sur la différence des deux moyennes. Avec n unités dans chaque groupe et un écart-type commun σ, l'erreur-type de la différence est SE = σ·√(2/n) et les tests t groupés ont 2(n − 1) degrés de liberté. L'équivalence est établie lorsqu'il est montré que la différence est supérieure à la limite inférieure L et inférieure à la limite supérieure U, chaque test unilatéral étant réalisé au seuil de signification α (le champ Significance level (alpha), 0.05 par défaut).
La puissance est la probabilité que les deux tests unilatéraux réussissent lorsque la vraie différence est δ. Elle est calculée exactement : pour un écart-type d'échantillon groupé s donné, la probabilité de succès est Φ(−t·s/σ − (δ − U)/SE) − Φ(t·s/σ − (δ − L)/SE), avec t = t₁₋α,2(n−1), et elle est moyennée sur la distribution du khi-deux de la variance groupée par intégration numérique. Pour l'effectif de l'échantillon, le n par groupe qui atteint la puissance cible est trouvé et arrondi à l'entier supérieur, et la puissance à ce n est indiquée comme puissance réelle. Pour déterminer la différence, l'outil cherche entre le milieu des limites et la limite supérieure.
La différence à détecter doit se situer strictement entre les limites. La puissance est la plus élevée lorsque la vraie différence se trouve au milieu de la fenêtre et diminue vers l'une ou l'autre limite. Par rapport à une étude à un échantillon, deux groupes indépendants exigent environ deux fois plus d'unités par groupe, car les deux moyennes comportent une erreur d'échantillonnage.
Champs de saisie et options
Champ | Description |
Sample sizes | Par groupe. Valeurs séparées par des espaces ou des virgules, par ex. « 20 30 40 ». Laissez vide pour déterminer l'effectif de l'échantillon. |
Difference(s) to detect | Valeurs séparées par des espaces ou des virgules, par ex. « 0.5 0.7 ». La vraie différence (moyenne d'essai − moyenne de référence) que vous attendez ; elle doit se situer strictement entre les limites. Laissez vide pour la déterminer (recherche entre le milieu des limites et la limite supérieure). |
Power values | Valeurs séparées par des espaces ou des virgules, par ex. « 0.8 0.9 ». Laissez vide pour déterminer la puissance. |
Lower equivalence limit / Upper equivalence limit | Obligatoire. La plus petite et la plus grande différence acceptables entre les moyennes ; la limite inférieure doit être inférieure à la limite supérieure. |
Standard deviation | Obligatoire. Écart-type commun (groupé) supposé ou historique des deux populations. |
Significance level (alpha) | Par défaut 0.05. Appliqué à chacun des deux tests unilatéraux. |
Power curve | Cochée par défaut : trace la puissance en fonction de l'effectif de l'échantillon. |
Title | Titre affiché sur les résultats et sur la courbe de puissance. |
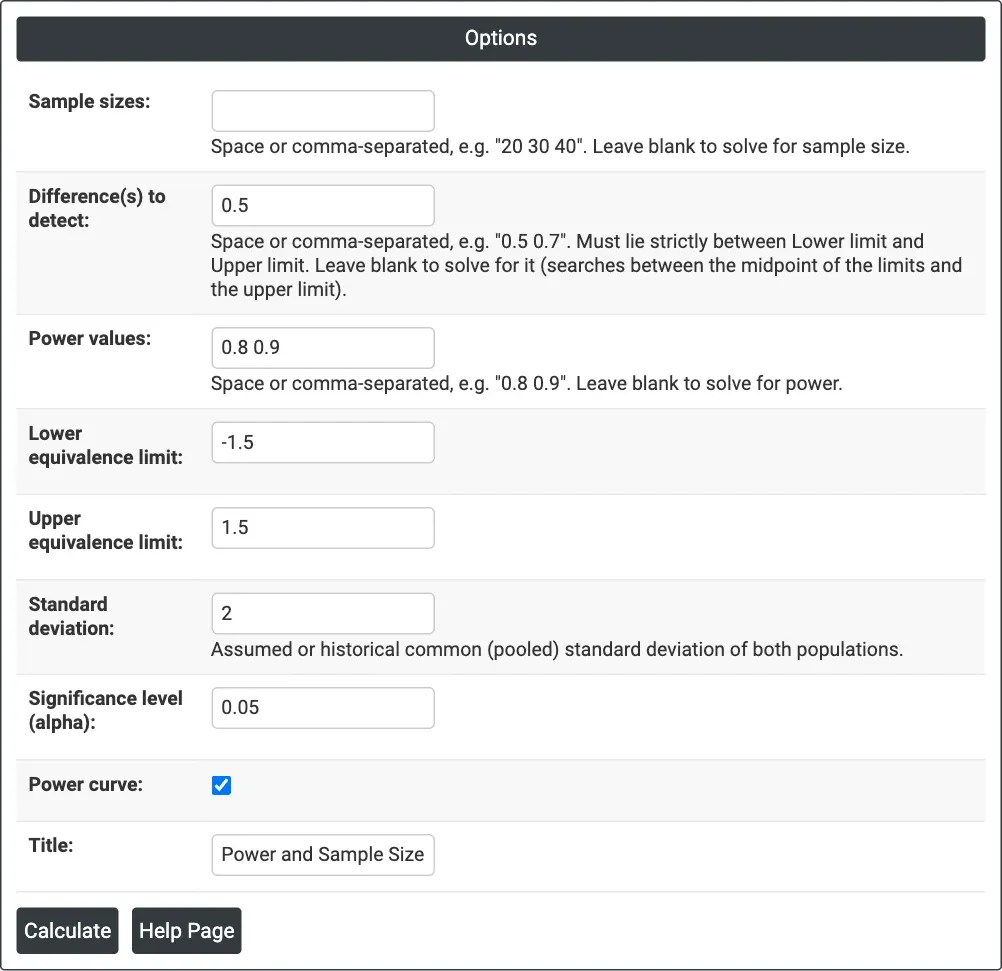
Figure 1 — Détermination de l'effectif de l'échantillon : Difference(s) to detect = 0.5, Power values = 0.8 0.9, limites −1.5 et 1.5, Standard deviation = 2, alpha = 0.05.
Description des résultats
- Settings — ce qui a été déterminé, les limites d'équivalence inférieure et supérieure, l'écart-type et le seuil de signification.
- Results — une ligne par combinaison : différence, effectif de l'échantillon par groupe, et puissance cible et réelle lors de la détermination de l'effectif de l'échantillon, ou puissance lors de la détermination de la puissance, ou différence lors de la détermination de la différence.
- Power Curve — puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points calculés repérés.
- Export PDF via Download.
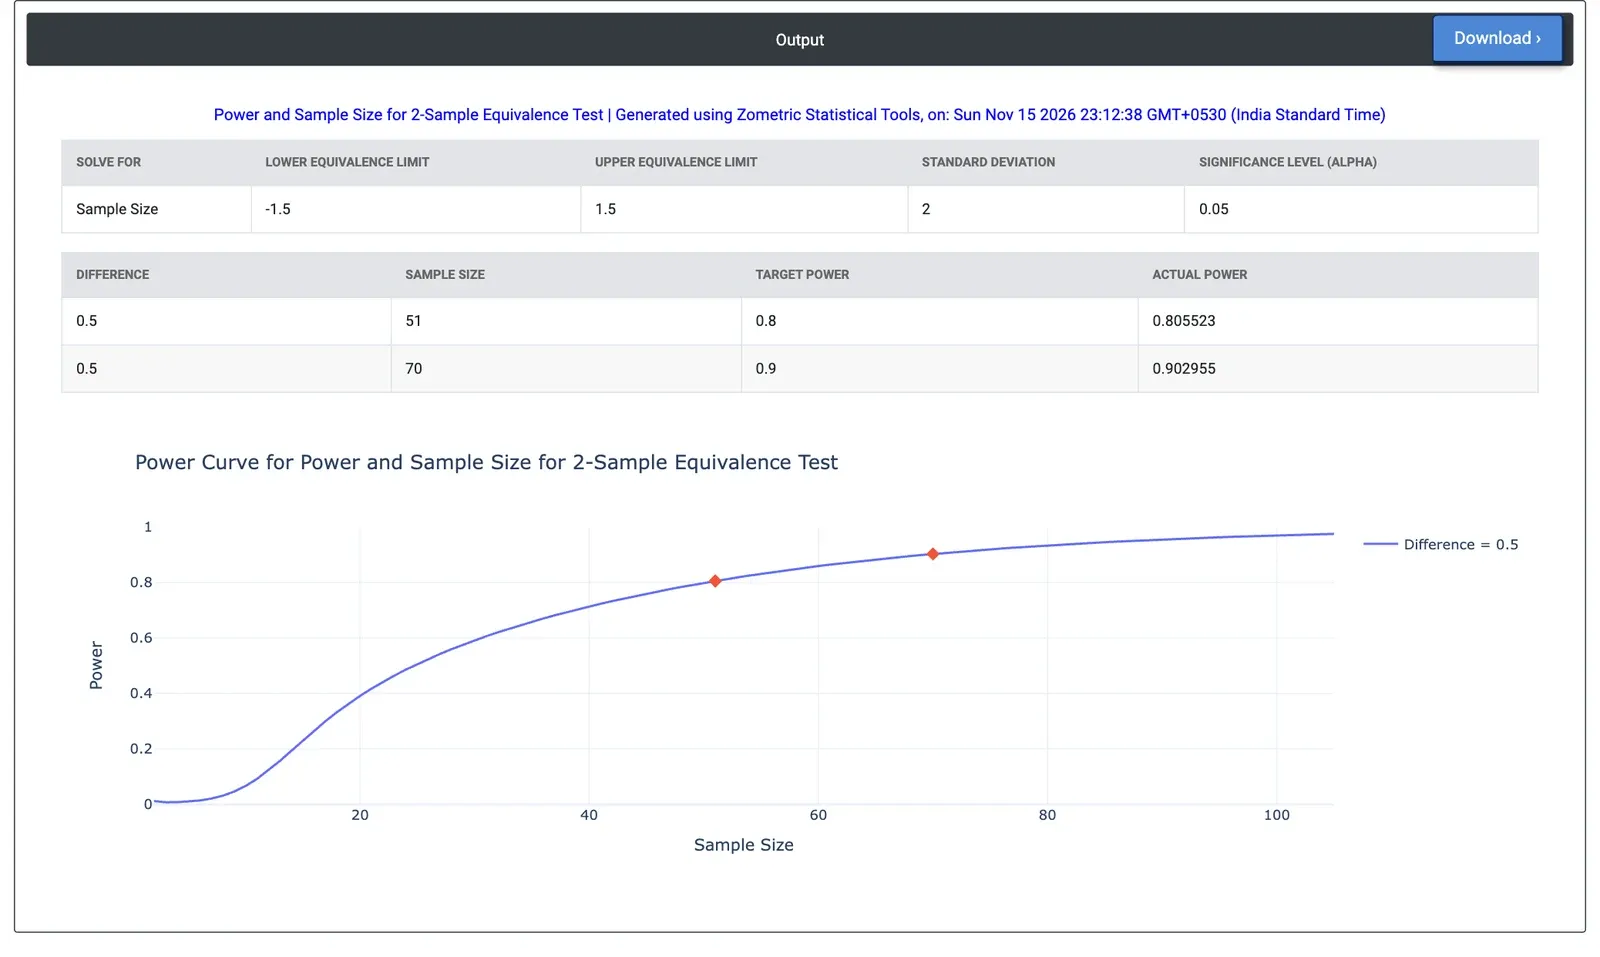
Figure 2 — Résultats de l'exemple : 51 barres par fournisseur pour une puissance de 80% et 70 pour une puissance de 90%, avec une fenêtre de ±1.5 MPa et une vraie différence de 0.5 MPa.
Exemple résolu
Une équipe achats veut homologuer un second fournisseur de barres d'acier. La limite d'élasticité moyenne du nouveau fournisseur doit se situer à ±1.5 MPa de celle du fournisseur actuel. Les données passées donnent un écart-type de 2 MPa pour les deux, et l'équipe s'attend à une vraie différence pouvant atteindre 0.5 MPa. Elle laisse Sample sizes vide et saisit Difference(s) to detect = 0.5, Power values = 0.8 0.9, Lower equivalence limit = −1.5, Upper equivalence limit = 1.5 et Standard deviation = 2, avec alpha = 0.05.
L'outil exige 51 barres de chaque fournisseur pour une puissance de 80% (puissance réelle 0.806) et 70 de chacun pour une puissance de 90% (puissance réelle 0.903). Avec 30 barres par fournisseur, la puissance n'est que de 0.591. Si les fournisseurs ont réellement la même moyenne (différence 0), 32 barres chacun donnent une puissance de 80% et 40 en donnent 90%. Élargir la fenêtre à ±2 MPa, si la conception le permet, ramène l'exigence à 24 barres par fournisseur pour une puissance de 80% avec une différence de 0.5 MPa.
Questions fréquentes
Que vous apprend une analyse de puissance pour l'équivalence à 2 échantillons ?
Elle vous indique combien d'unités chacun de deux groupes indépendants doit compter pour prouver que la différence entre leurs moyennes (moyenne d'essai moins moyenne de référence) se situe à l'intérieur d'une fenêtre d'équivalence, quelle puissance donne un échantillon prévu, ou quelle ampleur de différence réelle peut être tolérée. L'équivalence est établie lorsque deux tests t unilatéraux montrent que la différence est supérieure à la limite inférieure et inférieure à la limite supérieure.
Combien d'échantillons par groupe faut-il pour un test d'équivalence à 2 échantillons ?
Dans un exemple résolu avec une fenêtre de plus ou moins 1.5 MPa, un écart-type de 2 MPa et une différence attendue de 0.5 MPa, 51 barres par fournisseur donnent une puissance de 80% et 70 en donnent 90%. Si les moyennes sont réellement égales, 32 barres chacun donnent une puissance de 80%, et élargir la fenêtre à plus ou moins 2 MPa ramène l'exigence à 24 barres.
Pourquoi une étude d'équivalence à deux échantillons exige-t-elle plus d'unités qu'une étude à un échantillon ?
Les moyennes des deux groupes comportent une erreur d'échantillonnage : l'erreur-type de la différence est donc l'écart-type multiplié par la racine carrée de 2/n. Par conséquent, deux groupes indépendants exigent environ deux fois plus d'unités par groupe qu'une étude à un échantillon. La puissance est la plus élevée lorsque la vraie différence se trouve au milieu de la fenêtre et diminue vers l'une ou l'autre limite.
De quelles saisies le calcul de puissance pour l'équivalence à 2 échantillons a-t-il besoin ?
Il faut les limites d'équivalence inférieure et supérieure, la première étant inférieure à la seconde, et un écart-type commun (groupé) supposé ou historique. Saisissez ensuite deux valeurs parmi les effectifs d'échantillon par groupe, les différences à détecter et les puissances. La différence doit se situer strictement entre les limites. Le seuil de signification, 0.05 par défaut, s'applique à chaque test unilatéral.