
Puissance et effectif de l'échantillon pour 2 variances
Planifie un test de 2 variances comparant la dispersion de deux groupes, comme deux machines ou deux instruments de mesure. Saisissez deux éléments parmi l'effectif de l'échantillon par groupe, le rapport des écarts-types et la puissance, et l'outil calcule le troisième par un calcul exact avec la distribution F et des groupes de même taille. Suppose des données normales et est sensible à la non-normalité. Fournit un tableau de résultats avec la puissance réelle et une courbe de puissance.
Dernière révision
Point clé
Power and Sample Size for 2 Variances planifie un test F comparant la dispersion de deux groupes indépendants, en cherchant l'effectif de l'échantillon par groupe, la puissance ou le rapport détectable des écarts-types.
Sur cette page
Objectif
Power and Sample Size for 2 Variances planifie la comparaison de la dispersion de deux groupes indépendants, par exemple la répétabilité de deux machines, de deux instruments de mesure ou de deux fournisseurs. La différence de dispersion est saisie sous forme du rapport des deux écarts-types (σ₁/σ₂), vous n'avez donc pas besoin de saisir les écarts-types eux-mêmes. Saisissez deux éléments parmi l'effectif de l'échantillon, le rapport et la puissance, et l'outil calcule le troisième : combien d'unités chaque groupe requiert, quelle puissance procure un échantillon prévu, ou le plus petit rapport qu'un échantillon donné peut détecter. Utilisez-le avant un test de 2 variances.
Principales fonctionnalités
- Calcule l'effectif de l'échantillon, la puissance ou le rapport : laissez vide celui que vous cherchez.
- Plusieurs valeurs à la fois, p. ex. des rapports « 1.5 2 » et des puissances « 0.8 0.9 », donnent une ligne par combinaison.
- Hypothèses alternatives bilatérale ou unilatérales, au niveau de confiance de votre choix.
- Calcul exact avec la distribution F et des effectifs d'échantillon égaux dans les deux groupes.
- Courbe de puissance en fonction de l'effectif de l'échantillon pour chaque rapport, avec les points calculés repérés.
Méthodes statistiques
Le test sous-jacent au calcul est le test F de deux variances : avec n unités dans chaque groupe issues de populations normales, F = S₁²/S₂² suit une distribution F à (n − 1, n − 1) degrés de liberté lorsque les écarts-types sont égaux. Si le vrai rapport est r = σ₁/σ₂, F est r² fois une telle variable. Le seuil de signification est α = 1 − niveau de confiance / 100.
Pour l'alternative « supérieur à » (σ₁ > σ₂), puissance = P(F > f₁₋α / r²) ; pour « inférieur à », puissance = P(F < f_α / r²) ; pour le test bilatéral, les deux queues comptent, avec f_α/2 et f₁₋α/2, les quantiles de F à (n − 1, n − 1) degrés de liberté. L'effectif de l'échantillon pour une puissance cible est trouvée numériquement et arrondie à l'entier supérieur, et la puissance à cet entier est indiquée comme puissance réelle. Lors du calcul du rapport, l'outil cherche en dessous de 1 pour l'alternative « inférieur à » et au-dessus de 1 sinon.
Les groupes étant de même taille, un rapport r et un rapport 1/r donnent le même résultat bilatéral (1.5 et 0.667 requièrent tous deux 50 par groupe pour une puissance de 80 %). Le test F suppose des données normales et est sensible aux écarts à la normalité.
Champs et options de saisie
Champ | Description |
Sample sizes | Par groupe. Séparées par des espaces ou des virgules, p. ex. « 10 20 30 ». Laissez vide pour calculer l'effectif de l'échantillon. |
Ratio(s) | Séparés par des espaces ou des virgules, p. ex. « 1.5 2 ». Rapport des deux vrais écarts-types (σ₁/σ₂) que vous voulez détecter. Laissez vide pour le calculer. |
Power values | Séparées par des espaces ou des virgules, p. ex. « 0.8 0.9 ». Laissez vide pour calculer la puissance. |
Confidence level | Par défaut 95 (α = 0.05) ; de 75 à 100. |
Alternative hypothesis | σ1/σ2 ≠ 1 (par défaut), σ1/σ2 < 1 (σ₁ < σ₂) ou σ1/σ2 > 1 (σ₁ > σ₂). |
Power curve | Coché par défaut : trace la puissance en fonction de l'effectif de l'échantillon. |
Title | Titre affiché sur les résultats et sur la courbe de puissance. |
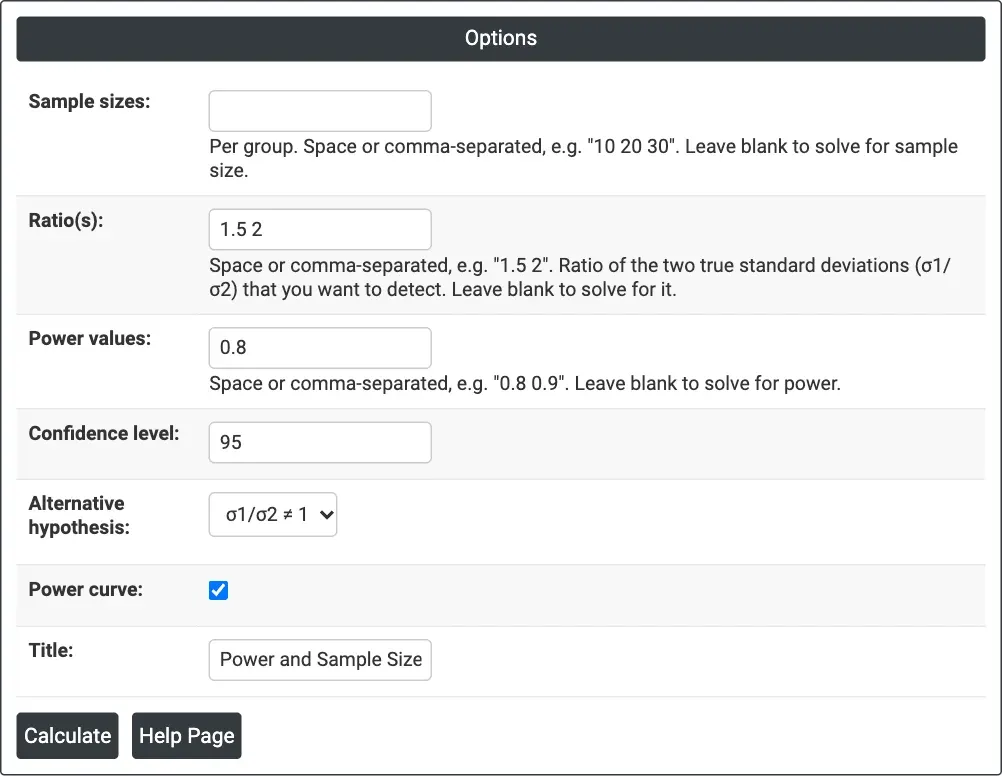
Figure 1 — Calcul de l'effectif de l'échantillon : Ratio(s) = 1.5 2, Power values = 0.8, bilatéral à 95% de confiance.
Description des résultats
- Settings — ce qui a été calculé, le niveau de confiance et l'hypothèse alternative.
- Results — une ligne par combinaison : rapport, effectif de l'échantillon par groupe, et puissance cible et réelle lorsque l'effectif de l'échantillon est calculé, ou puissance lorsque la puissance est calculée, ou rapport lorsque le rapport est calculé.
- Power Curve — puissance en fonction de l'effectif de l'échantillon pour chaque rapport, avec les points calculés repérés.
- Export PDF via Download.
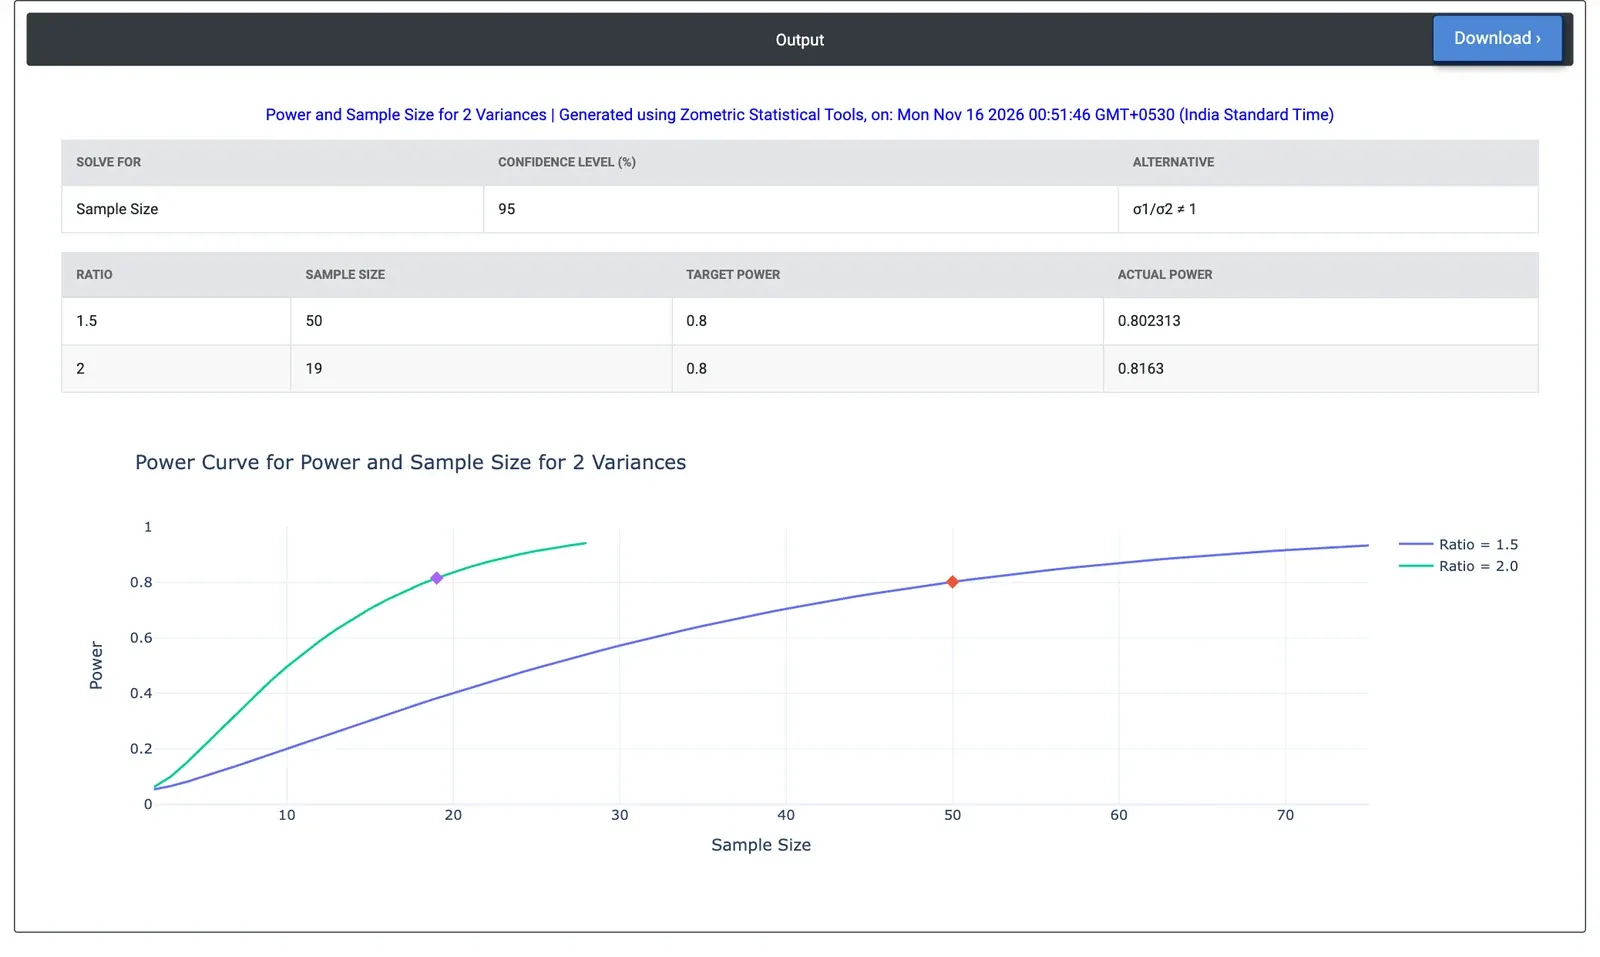
Figure 2 — Résultats de l'exemple : 50 pièces par machine pour détecter un rapport de 1.5 et 19 par machine pour un rapport de 2, tous deux à une puissance de 80 %.
Exemple résolu
Un atelier d'usinage veut comparer la variation du diamètre d'alésage d'une ancienne et d'une nouvelle machine CNC. Un rapport d'écarts-types de 1.5 justifierait de confier les travaux critiques à la meilleure machine, et un rapport de 2 serait grave. L'ingénieur laisse Sample sizes vide, saisit Ratio(s) = 1.5 2 et Power values = 0.8, et conserve l'alternative bilatérale à 95% de confiance.
L'outil requiert 50 pièces par machine pour détecter un rapport de 1.5 avec une puissance de 80 % (puissance réelle 0.802), et 19 pièces chacune pour un rapport de 2 (puissance réelle 0.816). Pour une puissance de 90 %, les chiffres passent à 66 et 24 pièces par machine. Un essai de 20 pièces par machine n'a qu'une puissance de 0.402 pour un rapport de 1.5 ; un résultat non significatif issu d'un tel essai dit donc peu de chose. Si la question est seulement de savoir si l'ancienne machine est moins bonne (alternative σ1/σ2 > 1), 40 pièces par machine donnent une puissance de 80 % pour un rapport de 1.5.
Questions fréquentes
Pourquoi la différence de dispersion est-elle saisie sous forme de rapport d'écarts-types ?
Le test F de deux variances utilise F = S1 au carré divisé par S2 au carré. Si le vrai rapport des écarts-types est r, F est r au carré fois une variable F à (n - 1, n - 1) degrés de liberté, de sorte que seul le rapport compte. Vous saisissez le rapport sigma1/sigma2 et n'avez pas besoin des écarts-types eux-mêmes.
Combien d'échantillons faut-il pour comparer deux variances ?
Dans un exemple résolu, bilatéral à 95% de confiance, détecter un rapport d'écarts-types de 1.5 requiert 50 pièces par machine pour une puissance de 80 % et 66 pour 90 %, tandis qu'un rapport de 2 en requiert 19 et 24. Un essai de 20 pièces par machine n'a qu'une puissance de 0.402 pour un rapport de 1.5 ; un résultat non significatif dit donc peu de chose.
Un rapport et son inverse sont-ils traités de la même façon ?
Pour le test bilatéral, oui. Les deux groupes étant de même taille, un rapport r et un rapport 1/r donnent le même résultat : 1.5 et 0.667 requièrent tous deux 50 unités par groupe pour une puissance de 80 %. Pour les alternatives unilatérales, l'outil cherche en dessous de 1 pour l'alternative « inférieur à » et au-dessus de 1 sinon.
Quelles sont les hypothèses du calcul de puissance pour 2 variances ?
Il suppose que les deux groupes proviennent de populations normales et ont des effectifs d'échantillon égaux. Le test F est sensible aux écarts à la normalité ; vérifiez donc la forme des données lorsque vous exécutez le test. Si un seul sens compte, une alternative unilatérale requiert moins d'unités : 40 pièces par machine donnent une puissance de 80 % pour un rapport de 1.5 dans l'exemple résolu.