
Puissance et effectif de l'échantillon : test d'équivalence apparié
Planifie un test d'équivalence apparié où chaque unité est mesurée deux fois, par exemple avec un nouvel instrument et un instrument de référence, et où la différence moyenne doit être montrée assez petite pour être négligée. Saisissez les limites d'équivalence, l'écart-type des différences appariées et deux des trois valeurs parmi nombre de paires, différence et puissance ; l'outil résout la troisième avec la puissance TOST exacte. Résultats : un tableau et une courbe de puissance.
Dernière révision
Point clé
Power and Sample Size for Paired Equivalence Test calcule le nombre de paires nécessaires pour montrer, avec deux tests t unilatéraux (TOST), que la différence moyenne appariée se situe dans une fenêtre d'équivalence.
Sur cette page
Objectif
Power and Sample Size for Paired Equivalence Test planifie une étude où chaque unité est mesurée deux fois, par exemple avec une nouvelle méthode et une méthode de référence, avant et après un changement de procédé, ou sur deux montages, l'objectif étant de montrer que la différence moyenne appariée est assez petite pour être négligée. Vous fixez une fenêtre d'équivalence pour la différence moyenne, et l'outil vous indique combien de paires sont nécessaires, quelle puissance donne un nombre de paires prévu, ou quelle différence réelle peut être tolérée. Saisissez deux des trois valeurs parmi effectif de l'échantillon, différence et puissance, et l'outil résout la troisième. Utilisez-le avant un test d'équivalence apparié.
Fonctionnalités principales
- Résout l'effectif de l'échantillon (nombre de paires), la puissance ou la différence : laissez vide celui que vous voulez.
- Plusieurs valeurs à la fois, par ex. des effectifs d'échantillon « 10 20 30 », donnent une ligne par combinaison.
- Toute fenêtre d'équivalence, symétrique ou non.
- Puissance exacte de la procédure des deux tests unilatéraux (TOST) sur les différences appariées.
- Courbe de puissance en fonction du nombre de paires pour chaque différence, avec les points résolus marqués.
Méthodes statistiques
Une étude appariée est analysée à partir des différences au sein de chaque paire (essai − référence) ; le calcul est donc le TOST à un échantillon appliqué à ces différences. Avec n paires et un écart-type des différences σ_d, l'erreur-type est SE = σ_d/√n avec n − 1 degrés de liberté. L'équivalence est établie lorsque la différence moyenne est montrée supérieure à la limite inférieure L et inférieure à la limite supérieure U, chaque test t unilatéral étant réalisé au seuil de signification α (le champ Significance level (alpha), 0.05 par défaut).
La puissance est la probabilité que les deux tests unilatéraux réussissent lorsque la vraie différence moyenne est δ. Elle est calculée exactement : pour un écart-type d'échantillon des différences s donné, la probabilité de succès est Φ(−t·s/σ_d − (δ − U)/SE) − Φ(t·s/σ_d − (δ − L)/SE), avec t = t₁₋α,n−1, et elle est moyennée sur la distribution du khi-deux de la variance d'échantillon par intégration numérique. Pour l'effectif de l'échantillon, le nombre de paires qui atteint la puissance cible est trouvé et arrondi à l'entier supérieur, et la puissance à ce nombre est fournie comme puissance réelle. Pour la résolution en différence, l'outil recherche entre le milieu des limites et la limite supérieure.
L'écart-type à saisir est celui des différences appariées, et non celui des mesures individuelles. L'appariement est payant lorsque les deux mesures d'une unité sont fortement liées, car σ_d est alors bien plus petit que la dispersion d'une unité à l'autre. La différence doit se situer strictement entre les limites ; la puissance est maximale au milieu de la fenêtre.
Champs de saisie et options
Champ | Description |
Sample sizes | Nombre de paires. Séparées par des espaces ou des virgules, par ex. « 20 30 40 ». Laissez vide pour résoudre l'effectif de l'échantillon. |
Difference(s) to detect | Séparées par des espaces ou des virgules, par ex. « 0.5 0.7 ». La vraie différence moyenne appariée attendue ; doit se situer strictement entre les limites. Laissez vide pour la résoudre (recherche entre le milieu des limites et la limite supérieure). |
Power values | Séparées par des espaces ou des virgules, par ex. « 0.8 0.9 ». Laissez vide pour résoudre la puissance. |
Lower equivalence limit / Upper equivalence limit | Obligatoire. La plus petite et la plus grande différence moyenne acceptables ; la limite inférieure doit être inférieure à la limite supérieure. |
Standard deviation of the differences | Obligatoire. Écart-type supposé ou historique des différences appariées. |
Significance level (alpha) | 0.05 par défaut. Appliqué à chacun des deux tests unilatéraux. |
Power curve | Coché par défaut : trace la puissance en fonction de l'effectif de l'échantillon. |
Title | Titre affiché sur les résultats et la courbe de puissance. |
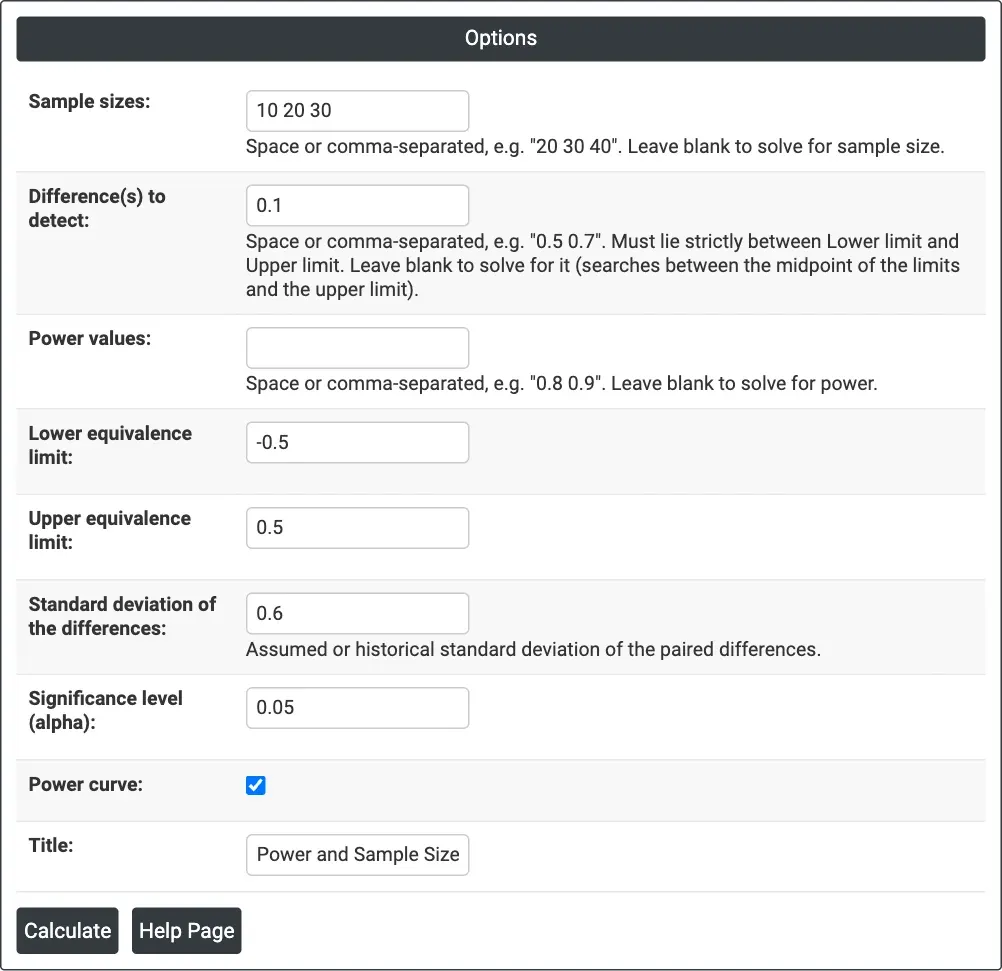
Figure 1 — Résolution de la puissance : Sample sizes = 10 20 30, Difference(s) to detect = 0.1, limites −0.5 et 0.5, Standard deviation of the differences = 0.6, alpha = 0.05.
Description des résultats
- Settings — ce qui a été résolu, les limites d'équivalence inférieure et supérieure, l'écart-type des différences et le seuil de signification.
- Results — une ligne par combinaison : différence, effectif de l'échantillon (paires), et puissance lors de la résolution de la puissance, puissance cible et réelle lors de la résolution de l'effectif de l'échantillon, ou différence lors de la résolution de la différence.
- Power Curve — puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points calculés marqués.
- Export PDF via Download.
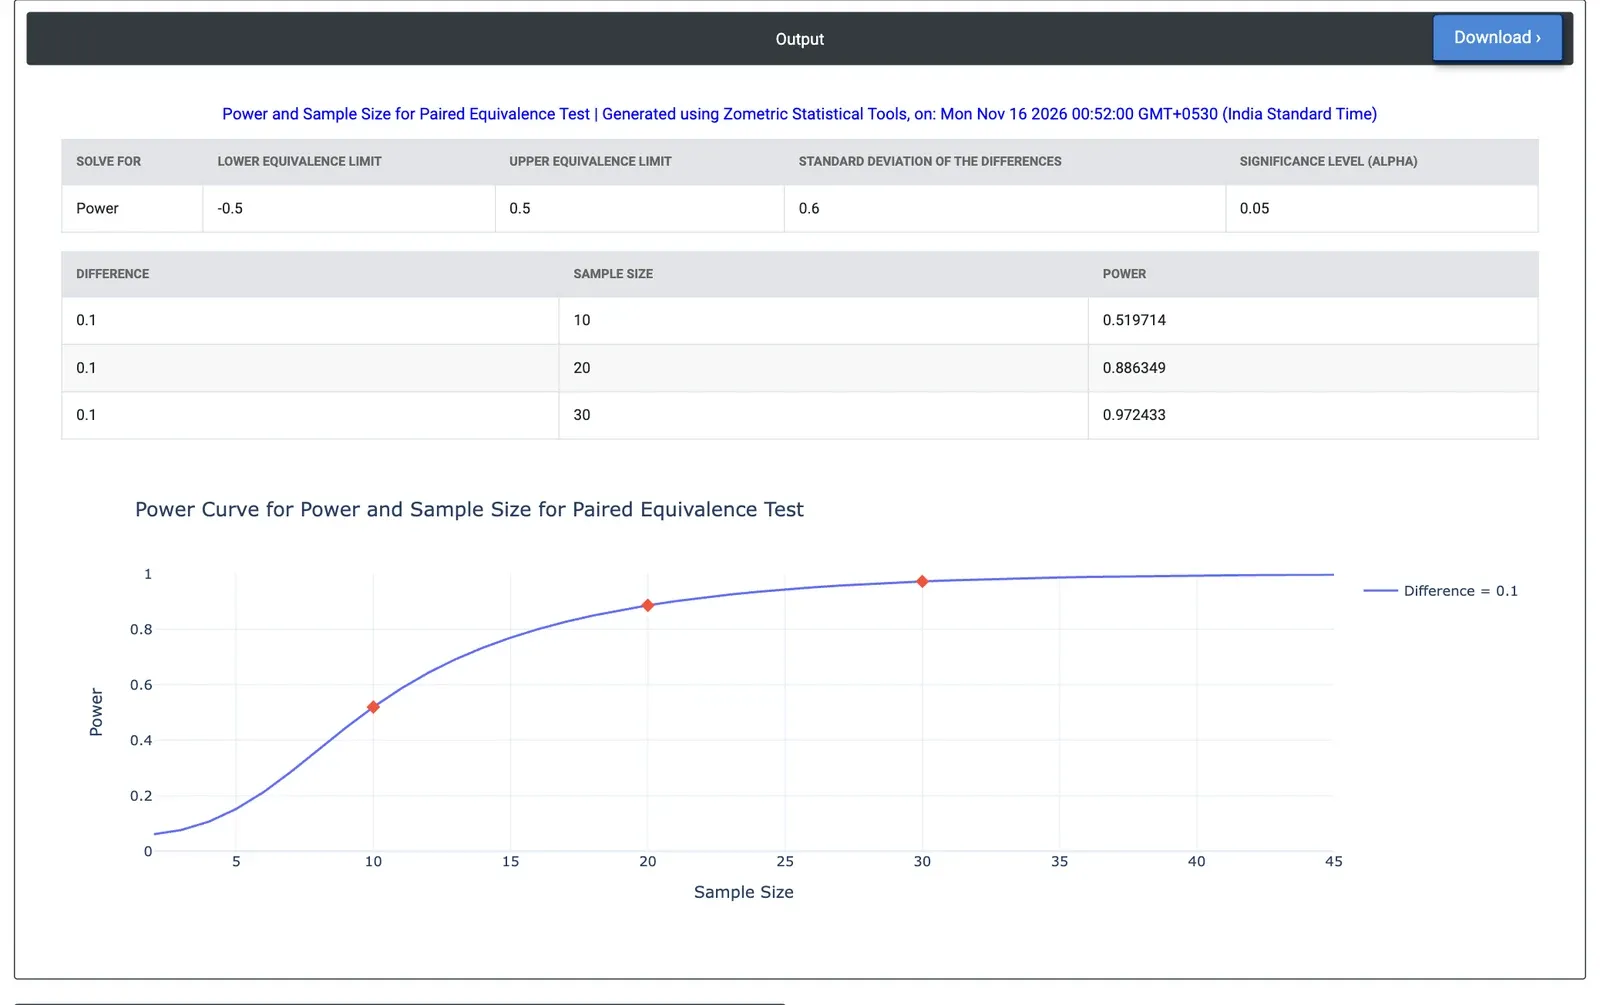
Figure 2 — Résultats de l'exemple : puissance 0.520, 0.886 et 0.972 pour 10, 20 et 30 panneaux lorsque le vrai biais est de 0.1 µm dans une fenêtre de ±0.5 µm.
Exemple résolu
Un atelier de peinture veut remplacer son instrument de référence de mesure d'épaisseur de revêtement par un appareil portable moins cher. Chaque panneau d'essai sera mesuré avec les deux instruments, et l'appareil portable est acceptable si son biais moyen est dans ±0.5 µm. Un essai pilote a fixé l'écart-type des différences appariées à 0.6 µm, et le biais attendu est d'environ 0.1 µm. Le métrologue saisit Sample sizes = 10 20 30, Difference(s) to detect = 0.1, Lower equivalence limit = −0.5, Upper equivalence limit = 0.5 et Standard deviation of the differences = 0.6, laisse Power values vide et conserve alpha = 0.05.
La puissance est de 0.520 avec 10 panneaux, de 0.886 avec 20 et de 0.972 avec 30. Dix panneaux laisseraient environ une chance sur deux de rejeter un instrument qui est en réalité acceptable. En résolvant plutôt l'effectif de l'échantillon (Power values = 0.8 0.9), on obtient 16 panneaux pour une puissance de 80 % et 21 pour 90 %. Si le biais s'avère être de 0.2 µm, 20 panneaux donnent une puissance de 0.695 ; sans aucun biais, ils donnent 0.948.
Questions fréquentes
Comment se calcule une analyse de puissance pour un test d'équivalence apparié ?
Une étude appariée est analysée à partir des différences au sein de chaque paire, essai moins référence ; le calcul est donc un TOST à un échantillon appliqué à ces différences. L'équivalence est établie lorsque la différence moyenne est montrée supérieure à la limite inférieure et inférieure à la limite supérieure, chaque test t unilatéral étant réalisé au alpha choisi. La puissance est calculée exactement par intégration numérique.
Quel écart-type saisir pour un test d'équivalence apparié ?
Saisissez l'écart-type des différences appariées, et non celui des mesures individuelles. L'appariement est payant lorsque les deux mesures d'une unité sont fortement liées, car l'écart-type des différences est alors bien plus petit que la dispersion d'une unité à l'autre, ce qui réduit le nombre de paires nécessaires.
Combien de paires faut-il pour un test d'équivalence apparié ?
Dans un exemple résolu avec une fenêtre de plus ou moins 0.5 micromètre, un écart-type des différences de 0.6 et un biais attendu de 0.1, 16 panneaux donnent une puissance de 80 % et 21 de 90 %. La puissance est de 0.520 avec 10 panneaux, de 0.886 avec 20 et de 0.972 avec 30. Un biais plus grand de 0.2 abaisse la puissance avec 20 panneaux à 0.695.
Pourquoi la différence doit-elle se situer strictement entre les limites d'équivalence ?
Une vraie différence moyenne située sur une limite ou au-delà ne pourra jamais être déclarée équivalente ; la différence attendue doit donc se situer strictement entre les limites inférieure et supérieure. La puissance est maximale lorsque la vraie différence se situe au milieu de la fenêtre et diminue lorsqu'elle se rapproche de l'une ou l'autre limite.