
Puissance et effectif de l'échantillon pour le test t apparié
Planifie un test t apparié où chaque unité est mesurée deux fois, par exemple avant et après une modification. Saisissez l'écart-type des différences appariées et deux éléments parmi le nombre de paires, la différence de moyennes et la puissance ; l'outil calcule le troisième. Il suppose des différences à peu près normales et utilise la distribution t non centrée. Les résultats comprennent un tableau avec la puissance réelle et une courbe de puissance.
Dernière révision
Point clé
Power and Sample Size for Paired t calcule combien de paires un test t apparié exige pour détecter une différence de moyennes significative, la puissance d'un nombre de paires prévu, ou la plus petite différence détectable.
Sur cette page
Objectif
Power and Sample Size for Paired t planifie une étude dans laquelle chaque unité est mesurée deux fois, par exemple avant et après une modification, avec deux méthodes ou sur deux montages, et où la question est de savoir si la différence de moyennes est nulle. Il répond à : combien de paires faut-il pour détecter une différence de moyennes significative, quelle puissance donne un nombre de paires prévu, ou quelle est la plus petite différence de moyennes qu'un nombre de paires donné peut détecter. Saisissez deux éléments parmi l'effectif de l'échantillon, la différence et la puissance, et l'outil calcule le troisième. Utilisez-le avant un test t apparié.
Principales fonctionnalités
- Calcule le nombre de paires, la puissance ou la différence : laissez vide celui que vous voulez obtenir.
- Plusieurs valeurs à la fois, par ex. des différences « 0.5 1 » et des puissances « 0.8 0.9 », donnent une ligne pour chaque combinaison.
- Hypothèses alternatives bilatérale (Mean difference ≠ 0) ou unilatérales (Mean difference < 0, Mean difference > 0), au niveau de confiance que vous choisissez.
- Lors du calcul de l'effectif de l'échantillon, donne le nombre entier de paires et la puissance réelle qu'il procure.
- Courbe de puissance en fonction du nombre de paires pour chaque différence, avec les points calculés repérés.
Méthodes statistiques
Un test t apparié est un test t à un échantillon appliqué aux différences au sein de chaque paire ; le calcul est donc celui du test t à 1 échantillon appliqué aux différences. Il suppose que les différences sont à peu près normales, d'écart-type σ_d. Le seuil de signification est α = 1 − niveau de confiance / 100, et la différence standardisée est d = différence de moyennes / σ_d.
La puissance est calculée à partir de la distribution t non centrée à n − 1 degrés de liberté et de paramètre de non-centralité δ = d·√n, où n est le nombre de paires : pour un test bilatéral, puissance = P(T > t₁₋α/₂) + P(T < −t₁₋α/₂) ; pour un test unilatéral, seule compte la queue du côté de l'hypothèse alternative, de sorte qu'une différence de moyennes de l'autre côté donne une puissance proche de 0 (et le calcul de l'effectif de l'échantillon à partir de celui-ci renvoie un message d'erreur). Pour l'effectif de l'échantillon, on trouve le n qui donne la puissance cible, arrondi à l'entier supérieur, et la puissance obtenue à ce n est indiquée comme puissance réelle. Pour la différence, on trouve la plus petite différence de moyennes qui atteint la puissance cible avec le n donné.
L'écart-type à saisir est celui des différences appariées, et non celui des relevés individuels. Lorsque les deux relevés d'une unité évoluent ensemble, σ_d est bien inférieur à la dispersion entre unités, ce qui explique qu'un plan apparié exige généralement beaucoup moins d'unités que deux groupes indépendants. La puissance augmente avec le nombre de paires et la différence, et diminue lorsque σ_d augmente.
Champs de saisie et options
Champ | Description |
Sample sizes | Nombre de paires. Séparées par des espaces ou des virgules, par ex. « 10 20 30 ». Laissez vide pour calculer l'effectif de l'échantillon. |
Differences | Séparées par des espaces ou des virgules, par ex. « 1 2 3 ». La différence moyenne appariée que vous voulez détecter. Laissez vide pour calculer la différence. |
Power values | Séparées par des espaces ou des virgules, par ex. « 0.8 0.9 ». Laissez vide pour calculer la puissance. |
Standard deviation of the differences | Obligatoire. Écart-type supposé ou historique des différences appariées, par ex. issu d'un essai pilote. |
Confidence level | 95 par défaut (α = 0.05) ; de 75 à 100. |
Alternative hypothesis | Mean difference ≠ 0 (par défaut), Mean difference < 0 ou Mean difference > 0. |
Power curve | Cochée par défaut : trace la puissance en fonction de l'effectif de l'échantillon. |
Title | Titre affiché sur les résultats et sur la courbe de puissance. |
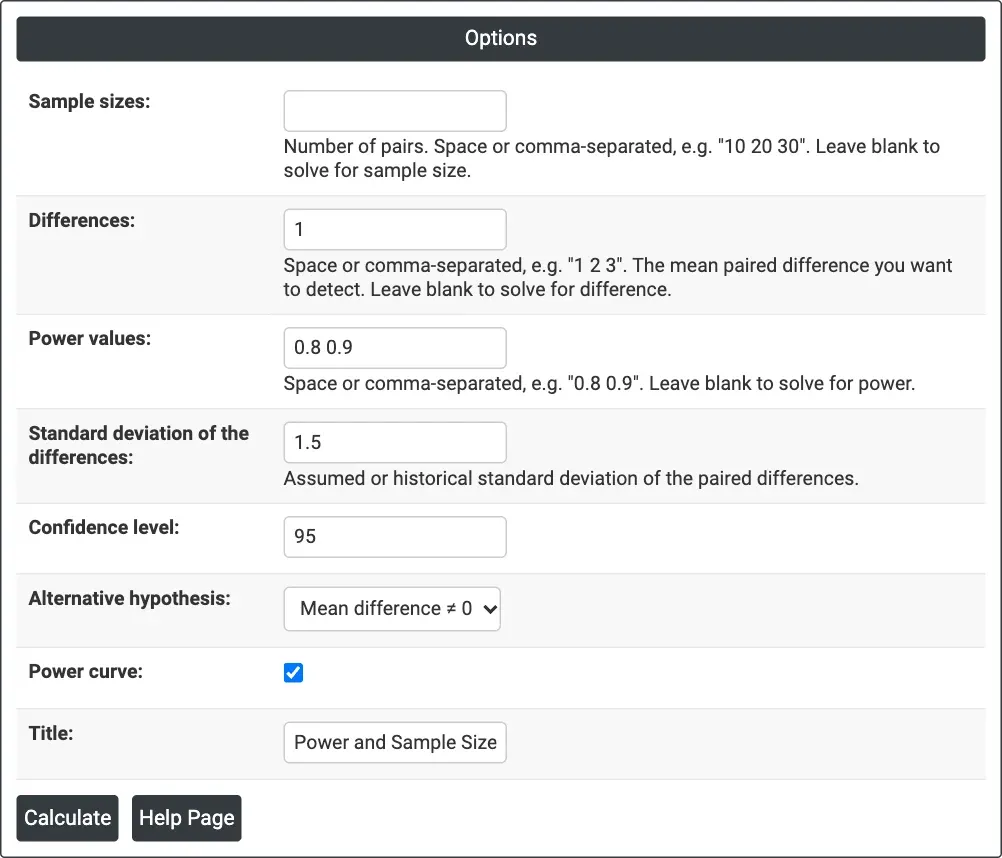
Figure 1 — Calcul de l'effectif de l'échantillon : Differences = 1, Power values = 0.8 0.9, Standard deviation of the differences = 1.5, bilatéral à 95 % de confiance.
Description des résultats
- Settings — ce qui a été calculé, l'écart-type des différences, le niveau de confiance et l'hypothèse alternative.
- Results — une ligne par combinaison : différence, effectif de l'échantillon (paires), et puissance cible et réelle lors du calcul de l'effectif de l'échantillon, ou puissance lors du calcul de la puissance, ou différence lors du calcul de la différence.
- Power Curve — puissance en fonction de l'effectif de l'échantillon pour chaque différence, avec les points calculés repérés.
- Export PDF via Download.
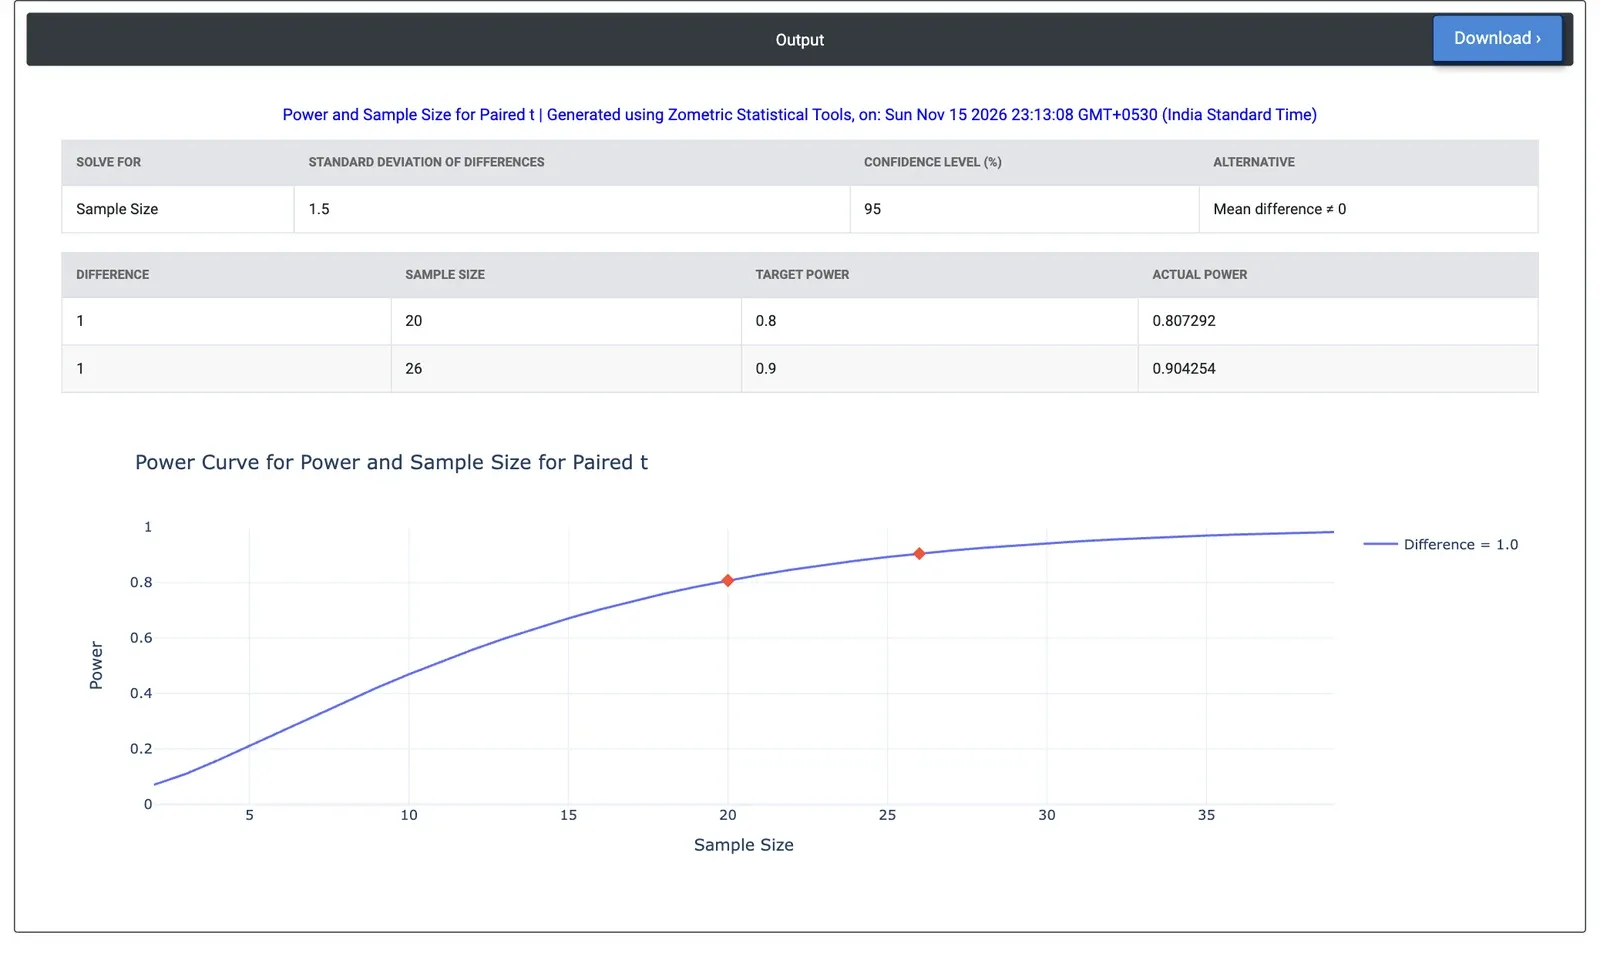
Figure 2 — Résultats de l'exemple : 20 moteurs pour 80 % de puissance et 26 pour 90 % de puissance afin de détecter une variation de 1 g/kWh de la consommation de carburant.
Exemple résolu
Une usine de moteurs teste un nouveau logiciel de calibration et essaiera chaque moteur au banc avant et après la mise à jour. Une variation de 1 g/kWh de la consommation spécifique de carburant serait significative, et des essais avant/après antérieurs ont situé l'écart-type des différences à 1.5 g/kWh. L'ingénieur d'essais laisse Sample sizes vide, saisit Differences = 1, Power values = 0.8 0.9 et Standard deviation of the differences = 1.5, et conserve l'hypothèse alternative bilatérale à 95 % de confiance.
L'outil exige 20 moteurs pour 80 % de puissance (puissance réelle 0.807) et 26 pour 90 % de puissance (puissance réelle 0.904). Les 12 moteurs disponibles en une semaine donneraient une puissance de 0.558. Si les résultats au banc sont plus bruités que prévu, avec σ_d = 2 g/kWh, il faut 34 moteurs pour 80 % de puissance. Si la seule question est de savoir si la consommation s'améliore, une hypothèse alternative unilatérale exige 16 moteurs pour 80 % de puissance.
Questions fréquentes
Comment la puissance est-elle calculée pour un test t apparié ?
Un test t apparié est un test t à un échantillon appliqué aux différences au sein de chaque paire ; la puissance est donc calculée à partir de la distribution t non centrée à n - 1 degrés de liberté et de paramètre de non-centralité d multiplié par la racine carrée de n, où n est le nombre de paires et d la différence de moyennes divisée par l'écart-type des différences.
Pourquoi un plan apparié exige-t-il moins d'unités que deux groupes indépendants ?
Lorsque les deux relevés d'une unité évoluent ensemble, l'écart-type des différences appariées est bien inférieur à la dispersion entre unités. Comme la puissance dépend de la différence de moyennes rapportée à cet écart-type, un plan apparié exige généralement beaucoup moins d'unités que deux groupes indépendants. Saisissez l'écart-type des différences, et non celui des relevés individuels.
Combien de paires faut-il pour un test t apparié ?
Dans un exemple résolu visant à détecter une variation de 1 g/kWh avec un écart-type des différences de 1.5 g/kWh, bilatéral à 95 % de confiance, 20 moteurs donnent 80 % de puissance et 26 en donnent 90 %. Douze moteurs donnent une puissance de 0.558. Si les différences sont plus bruitées, à 2 g/kWh, il faut 34 moteurs pour 80 % de puissance.
Un test t apparié doit-il être unilatéral ou bilatéral ?
Utilisez une hypothèse alternative unilatérale lorsque seule une direction compte, par exemple si la consommation s'améliore ; dans l'exemple résolu, elle exige 16 moteurs au lieu de 20 pour 80 % de puissance. Un test unilatéral ne compte que la queue du côté de l'hypothèse alternative ; une différence de moyennes de l'autre côté donne donc une puissance proche de 0 et le calcul de l'effectif de l'échantillon renvoie une erreur.