
Droite de probabilité
La droite de probabilité teste si des données s'ajustent à une distribution en traçant les valeurs ordonnées sur une échelle où la distribution apparaît comme une droite, avec des bornes de confiance. Elle prend en charge neuf distributions, dont Normal, Lognormal, Weibull et Exponential, et fournit la statistique d'Anderson-Darling et la valeur p pour chacune. Utilisez-la avant une analyse de capabilité, des limites de contrôle ou des tests t qui supposent la normalité, et pour choisir une distribution de fiabilité.
Dernière révision
Point clé
Une droite de probabilité vérifie si des données suivent une distribution choisie, le plus souvent la normale, en les traçant sur une échelle où cette distribution est une droite, avec la statistique d'Anderson-Darling et sa valeur p.
Sur cette page
Objectif
La droite de probabilité vérifie si des données suivent une distribution choisie, le plus souvent la distribution normale. Les données ordonnées sont tracées sur une échelle où la distribution choisie apparaît comme une droite : si les points suivent la droite, la distribution s'ajuste. Utilisez-la avant une analyse de capabilité, des limites de contrôle, des intervalles de tolérance ou des tests t qui supposent la normalité, et pour choisir une distribution (Weibull, lognormale, exponentielle) pour des travaux de fiabilité ou de capabilité non normale.
Principales fonctionnalités
- Neuf distributions : Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic et Loglogistic.
- Droite de référence ajustée avec bornes de confiance ponctuelles à un niveau choisi (95% par défaut).
- Statistique d'Anderson-Darling (AD) et sa valeur p dans la légende pour chaque distribution, afin de pouvoir comparer les ajustements.
- Plusieurs variables superposées sur un même graphique, ou une variable divisée en groupes par une colonne By, chacune avec sa propre droite ajustée.
- Axe des données logarithmique pour Lognormal, Weibull et Loglogistic, comme sur le papier de probabilité standard.
Méthodes statistiques
Pour chaque variable ou groupe (au moins 3 valeurs), les données sont triées, x₍₁₎ ≤ … ≤ x₍ₙ₎, et chacune reçoit la position de tracé pᵢ = (i − 0.3) / (n + 0.4), approximation du rang médian de Benard. L'axe vertical est l'inverse de la fonction de répartition de la distribution choisie, gradué en pourcentage, de sorte qu'un échantillon issu de cette distribution se place près d'une droite. La droite de référence est la fonction de répartition ajustée : pour la distribution normale, la moyenne de l'échantillon et l'écart-type (diviseur n − 1) ; pour les autres distributions, le maximum de vraisemblance, avec le seuil fixé à 0 pour Lognormal, Weibull, Exponential et Loglogistic (qui exigent des valeurs positives).
Les bornes de confiance sont tracées à travers chaque point : au niveau C, la borne inférieure est le quantile α/2 d'une distribution Bêta(i, n − i + 1) et la borne supérieure le quantile 1 − α/2 d'une distribution Bêta(i + 1, n − i), où α = 1 − C/100. Les points qui sortent des bornes sont un indice contre la distribution.
La statistique d'Anderson-Darling AD = −n − (1/n) Σ (2i − 1)[ln F(x₍ᵢ₎) + ln(1 − F(x₍ₙ₊₁₋ᵢ₎))] mesure l'écart entre les points et la fonction de répartition ajustée F, avec un poids supplémentaire dans les queues ; plus elle est petite, mieux c'est. La légende affiche cette AD non ajustée pour chaque distribution, comme le fait Minitab. La valeur p provient d'une statistique modifiée, comme chez D'Agostino et Stephens : pour Normal et Lognormal (sur les logarithmes), AD·(1 + 0.75/n + 2.25/n²) converti avec l'approximation de Stephens ; pour Weibull et les deux distributions de valeurs extrêmes, AD·(1 + 0.2/√n) ; pour Exponential, AD·(1 + 0.6/n) ; pour Logistic et Loglogistic, AD·(1 + 0.25/n). Les trois dernières sont lues dans les tables de valeurs critiques de Stephens et interpolées ; une valeur p hors de la table est donc affichée comme une borne, telle que >0.250 ou <0.010. Pour 2-Parameter Exponential, les n − 1 écarts x₍ᵢ₎ − x₍₁₎ sont testés comme exponentiels. Une valeur p inférieure à 0.05 indique que les données ne suivent pas la distribution ; entre distributions, la plus grande valeur p signifie généralement l'ajustement le plus proche.
Champs de saisie et options
Champ | Description |
Variables | Obligatoire. Une colonne numérique, ou plusieurs à superposer (une droite de probabilité « Multiple »). |
By (grouping) column | Facultatif. Une droite ajustée par groupe. Utilisé uniquement lorsqu'une seule variable est sélectionnée. |
Distribution | Normal (par défaut), Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic ou Loglogistic. |
Confidence level (%) | 95 par défaut ; de 1 à 99.99. Niveau des bornes de confiance. |
Display confidence interval bounds | Coché par défaut. Trace les bornes en pointillés. |
Title | Titre du graphique. Par défaut « Probability Plot ». |
Data Options: Subset (optional) | Exclude matching rows (par défaut) ou Include only matching rows ; Row numbers (p. ex. 3,7,12-15) et/ou une Condition (p. ex. Tensile_Strength_MPa > 205) sélectionnent les lignes. |
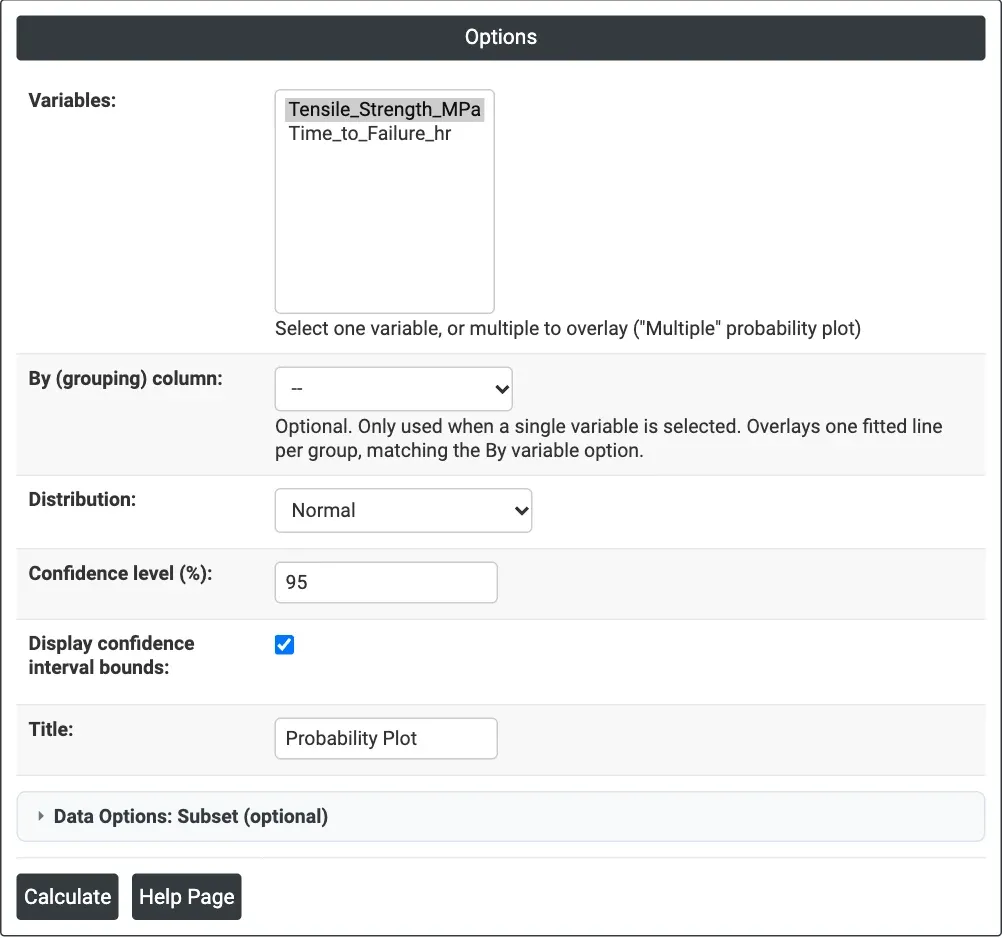
Figure 1 — Options de l'exemple : Tensile_Strength_MPa sur une droite de probabilité Normal avec bornes à 95%.
Description des résultats
- Probability Plot — les données (axe horizontal) en fonction du pourcentage sur l'échelle de probabilité de la distribution, avec la droite ajustée et les bornes de confiance en pointillés. La légende donne la statistique AD de chaque série et sa valeur p.
- Export PDF via Download.
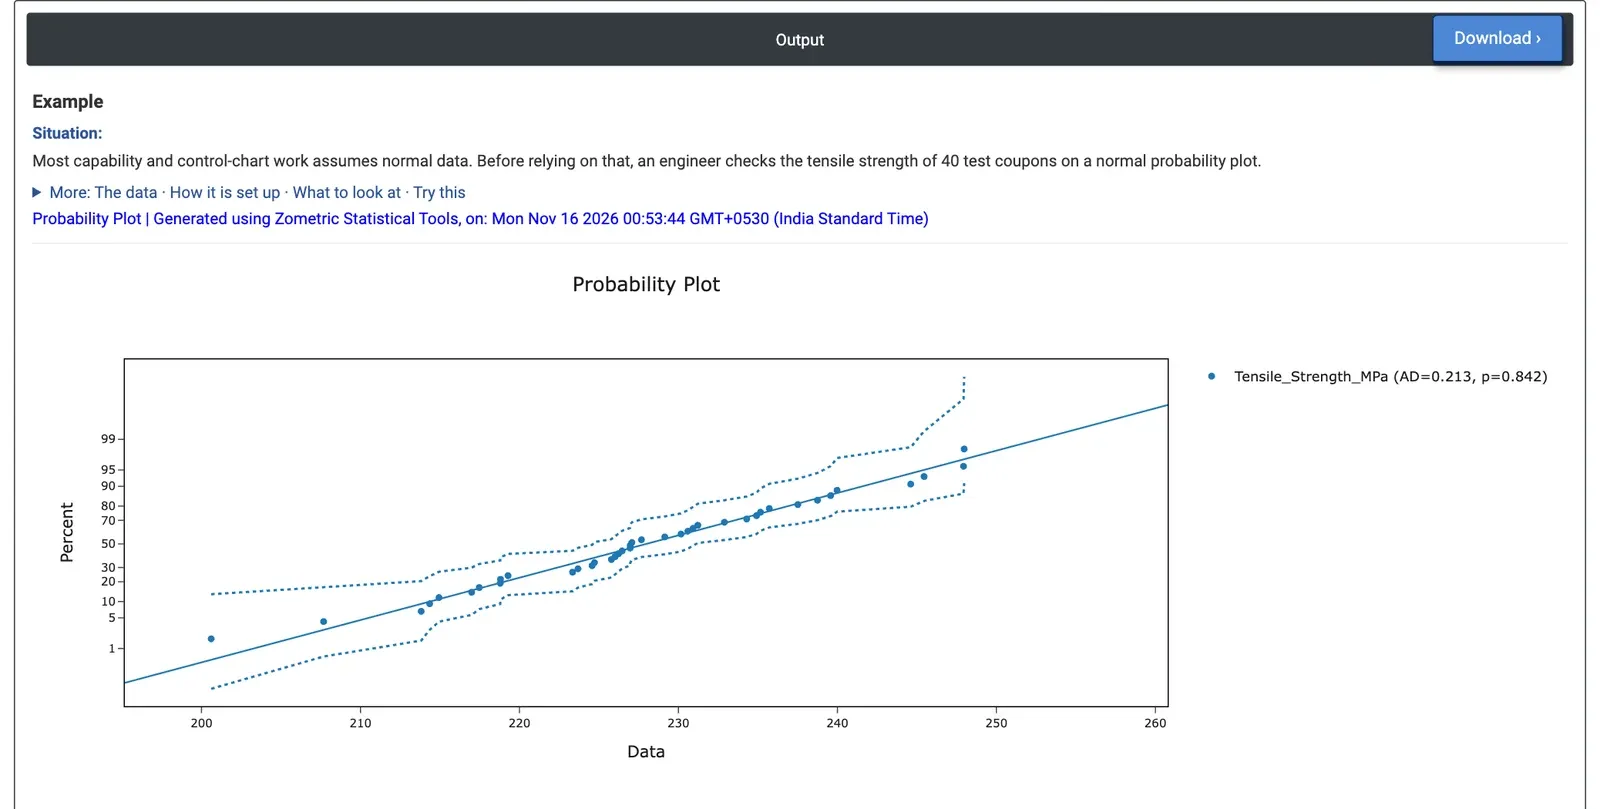
Figure 2 — Droite de probabilité normale de la résistance à la traction de 40 éprouvettes : AD = 0.213, p = 0.842.
Exemple résolu
Avant de fixer des limites de contrôle et de calculer la capabilité, un ingénieur vérifie si la résistance à la traction de 40 éprouvettes d'essai peut être considérée comme normale. Variables = Tensile_Strength_MPa, Distribution = Normal, Confidence level 95, bornes affichées.
Les points suivent la droite et restent à l'intérieur des bornes en pointillés sur toute la plage, de 200.61 à 247.97 MPa. La légende affiche AD = 0.213 avec p = 0.842, bien au-dessus de 0.05 : rien ne s'oppose à la normalité. La droite ajustée a une moyenne de 227.97 MPa et un écart-type de 10.61 MPa ; les méthodes de capabilité et de cartes de contrôle fondées sur la normalité peuvent donc être utilisées. Des points s'écartant de la droite à l'une ou l'autre extrémité auraient indiqué une distribution asymétrique ou à queues lourdes.
La même feuille contient 40 temps jusqu'à la défaillance (heures). Le tracé de Time_to_Failure_hr pour plusieurs distributions donne AD = 0.210 avec p > 0.250 pour Weibull (forme 3.23, échelle 192.96 heures), AD = 0.158 avec p = 0.947 pour Normal, AD = 1.228 avec p < 0.005 pour Lognormal et AD = 7.628 avec p < 0.010 pour Exponential. La distribution exponentielle, qui suppose un taux de défaillance constant, ne s'ajuste clairement pas, ni la lognormale. Weibull et Normal s'ajustent tous deux bien ; pour des temps de défaillance, Weibull est le choix habituel, puisque sa forme supérieure à 1 décrit l'usure et qu'elle ne peut pas prédire de durées de vie négatives.
Questions fréquentes
Comment interpréter une droite de probabilité ?
Si les points suivent la droite ajustée et restent à l'intérieur des bornes de confiance, la distribution s'ajuste. Les points qui sortent des bornes sont un indice contre elle, et des points s'écartant de la droite à l'une ou l'autre extrémité suggèrent une distribution asymétrique ou à queues lourdes. La légende donne la statistique d'Anderson-Darling et la valeur p ; une valeur p inférieure à 0.05 indique que les données ne suivent pas la distribution.
Quand utiliser une droite de probabilité ?
Utilisez-la pour vérifier la normalité avant une analyse de capabilité, des limites de contrôle, des intervalles de tolérance ou des tests t qui supposent des données normales. Elle sert aussi à choisir une distribution, comme Weibull, lognormale ou exponentielle, pour des travaux de fiabilité ou de capabilité non normale. Chaque variable ou groupe exige au moins 3 valeurs, et plusieurs variables ou groupes peuvent être superposés.
Comment comparer des distributions sur une droite de probabilité ?
Tracez les mêmes données pour plusieurs distributions et comparez les statistiques d'Anderson-Darling et les valeurs p ; une AD plus petite et une valeur p plus grande signifient généralement un ajustement plus proche. Dans un exemple résolu sur 40 temps de défaillance, Weibull (p > 0.250) et Normal (p = 0.947) s'ajustent bien, alors que Lognormal et Exponential (p < 0.010) ne s'ajustent pas.
Quelles distributions une droite de probabilité peut-elle tester ?
Neuf : Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic et Loglogistic. Lognormal, Weibull, Exponential et Loglogistic exigent des valeurs positives, et Lognormal, Weibull et Loglogistic utilisent un axe des données logarithmique, comme sur le papier de probabilité standard.