
Données aléatoires
Random Data génère de 10 à 10,000 lignes dans un maximum de 10 colonnes indépendantes selon l'une de 26 distributions, dont Normal, Lognormal, Weibull, Triangular, Binomial, Poisson et Multivariate Normal. Les valeurs sont tirées sans graine fixe : chaque exécution donne de nouveaux nombres. Un arrondi facultatif et un résumé graphique (histogramme, test de normalité d'Anderson-Darling, intervalles de confiance, droite de probabilité) décrivent les données générées.
Dernière révision
Point clé
Random Data génère des nombres aléatoires selon l'une de 26 distributions continues, discrètes ou normales multivariées, pour la formation, la simulation, les études « et si » et l'observation de la variation des échantillons.
Sur cette page
Objectif
Random Data génère des nombres aléatoires selon l'une de 26 distributions et les place dans le volet de données (data pane), prêts à être copiés ou utilisés dans d'autres outils. Utilisez-le pour créer des données d'entraînement pour la formation, pour voir à quel point un échantillon issu d'un procédé connu varie (un histogramme de 30 valeurs issues d'un procédé parfaitement normal a rarement une forme de cloche), pour essayer une analyse avant l'arrivée des données réelles, ou pour simuler un procédé dans une étude « et si », par exemple des temps de cycle à partir d'une estimation triangulaire ou des temps de défaillance à partir d'un modèle de Weibull. Un résumé graphique facultatif décrit les nombres que vous avez générés.
Principales fonctionnalités
- 26 distributions dans une seule liste Distribution : continues (Normal, Lognormal, Weibull, Exponential, Gamma, Uniform, Triangular et autres), discrètes (Binomial, Poisson, Geometric, Hypergeometric, Integer, Discrete et autres) et Multivariate Normal.
- Seuls les champs de paramètres de la distribution choisie sont affichés.
- De 10 à 10,000 lignes et de 1 à 10 colonnes indépendantes (data_1, data_2, …).
- Arrondi facultatif à un nombre de décimales fixé.
- Résumé graphique facultatif de toutes les valeurs générées : histogramme, statistiques descriptives, test de normalité d'Anderson-Darling, intervalles de confiance et droite de probabilité.
- Multivariate Normal : colonnes corrélées à partir d'un vecteur de moyennes et d'une matrice de covariance, avec les matrices de corrélation et de covariance de l'échantillon pour vérification.
Méthodes statistiques
Les valeurs sont tirées de façon indépendante avec les générateurs de nombres aléatoires de NumPy et SciPy, sans graine fixe : chaque Calculate donne donc de nouveaux nombres. Chaque colonne est un échantillon distinct de la taille choisie issu de la même distribution. Les paramètres suivent les définitions usuelles : par exemple Normal (moyenne μ, écart-type σ), Weibull (forme β, échelle η, seuil facultatif ajouté à chaque valeur), Exponential (échelle = moyenne, seuil facultatif), Integer (nombres entiers de Minimum à Maximum, bornes incluses), Geometric (nombre d'essais jusqu'au premier événement inclus) et Negative Binomial (nombre de non-événements avant le nombre d'événements requis). Pour Lognormal, vous saisissez la moyenne et l'écart-type des données elles-mêmes : l'outil les convertit en paramètres d'échelle logarithmique σ = √ln(1 + (s/m)²) et μ = ln(m) − σ²/2. Pour Discrete, les probabilités sont remises à l'échelle pour que leur somme soit égale à 1.
Lorsque Graphical Summary est coché, toutes les colonnes sont regroupées en un seul échantillon, décrit par : moyenne, écart-type, variance, asymétrie, aplatissement, N, minimum, quartiles, médiane, maximum et coefficient de variation (%) ; le test de normalité d'Anderson-Darling (A au carré et valeur p) ; des intervalles de confiance à 95% pour la moyenne (t), la médiane (Hettmansperger-Sheather) et l'écart-type (khi-deux). Lorsque Exclude outliers est coché, les valeurs situées en dehors de Q1 − 1.5×IQR ou de Q3 + 1.5×IQR sont exclues du résumé uniquement ; les données générées les conservent. Pour Multivariate Normal, la matrice de covariance doit être carrée, symétrique, semi-définie positive et correspondre au nombre de moyennes.
Champs de saisie et options
Champ | Description |
Distribution | Obligatoire. L'une des 26 distributions ; les champs de paramètres ci-dessous changent en conséquence. |
Number of rows of data to generate | Obligatoire, de 10 à 10,000. |
Number of columns | Par défaut 1, jusqu'à 10. Chaque colonne est un échantillon indépendant. Non utilisé pour Multivariate Normal (une colonne par moyenne). |
Graphical Summary | Décoché par défaut. Ajoute aux résultats le résumé graphique des valeurs générées. |
Exclude outliers (1.5×IQR rule) | Facultatif. Sans effet si Graphical Summary n'est pas coché ; il retire alors les valeurs aberrantes du résumé uniquement. |
Decimals | Facultatif, de 0 à 10. Arrondit les valeurs générées pour les distributions continues (Normal, Lognormal, Weibull, Exponential, T, F, Beta, Cauchy, Chi-Square, Gamma, Laplace, les distributions des valeurs extrêmes, Logistic, Loglogistic, Triangular et Uniform). Pour Normal, au moins assez de décimales pour afficher l'écart-type sont conservées. Non affiché pour les distributions qui donnent des nombres entiers ou des valeurs listées (Binomial, Poisson, Bernoulli, Discrete, Geometric, Hypergeometric, Integer et Negative Binomial) ni pour Multivariate Normal. |
Mean / Standard Deviation | Normal ; Lognormal (moyenne et écart-type des données) ; Poisson utilise uniquement Mean. |
Number of trials / Event probability | Binomial. Event probability seule : Bernoulli et Geometric ; avec Number of events (nombre de succès requis) : Negative Binomial. |
Shape parameter / Scale parameter / Threshold parameter | Weibull (seuil facultatif) ; Gamma et Loglogistic utilisent la forme et l'échelle. |
Scale parameter / Threshold parameter | Exponential (seuil facultatif). |
Location parameter / Scale parameter | Cauchy, Laplace, Largest Extreme Value, Smallest Extreme Value et Logistic. |
Degrees of freedom / Numerator and Denominator degrees of freedom | T et Chi-Square ; F. |
First shape parameter / Second shape parameter | Beta. |
Values / Probabilities | Discrete. Valeurs séparées par des virgules ou des espaces, en nombre identique, par exemple « 1 2 3 » et « 0.2 0.3 0.5 » (renormalisées si leur somme n'est pas égale à 1). |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric. Le nombre d'événements et l'effectif de l'échantillon ne peuvent pas dépasser la taille de la population. |
Minimum / Maximum / Mode (most likely value) | Integer (minimum et maximum) ; Triangular (les trois, avec le mode entre les deux autres). |
Lower endpoint / Upper endpoint | Uniform. |
Means / Covariance matrix | Multivariate Normal. Means, une par variable, par exemple « 10 20 30 » ; lignes de covariance séparées par des points-virgules, par exemple « 4,2,0; 2,9,1; 0,1,1 ». |
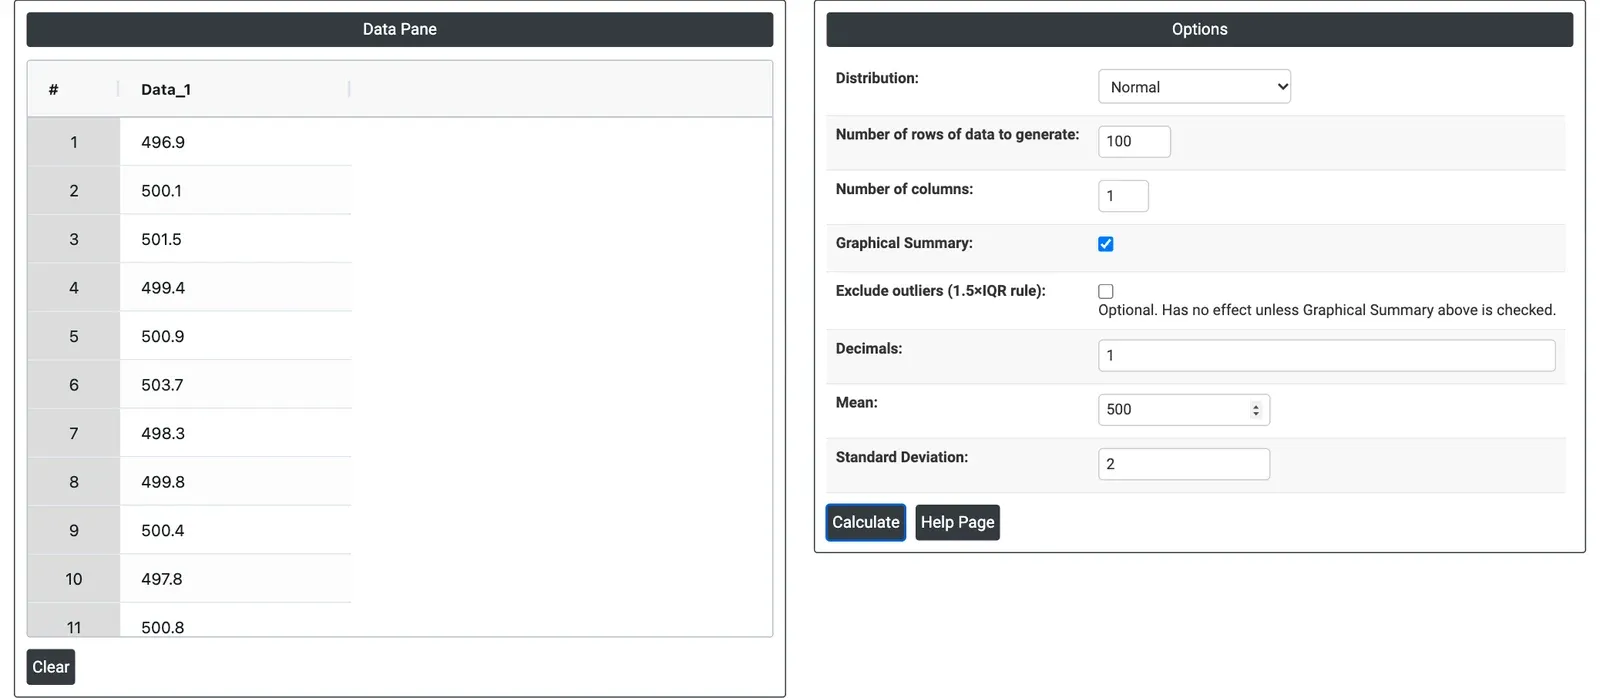
Figure 1 — 100 valeurs issues d'une distribution Normal de moyenne 500 et d'écart-type 2, arrondies à 1 décimale, dans le data pane (à gauche) avec les Options (à droite).
Description des résultats
- Data Pane — les valeurs générées, une colonne par échantillon (data_1, data_2, …), qui remplacent le contenu précédent.
- Graphical summary (lorsque la case est cochée) — histogramme avec courbe normale ajustée et boîte à moustaches ; tableau récapitulatif avec A-Squared, p-value, Mean, StDev, Variance, Skewness, Kurtosis, N, Minimum, 1st Quartile, Median, 3rd Quartile, Maximum et Coeff Var ; graphique des intervalles de confiance à 95% pour la moyenne et la médiane ; Probability Plot avec le résultat d'Anderson-Darling ; et un tableau des limites inférieure et supérieure à 95% pour la moyenne, la médiane et l'écart-type, avec la demi-largeur de chaque intervalle.
- Multivariate Normal — matrices de corrélation et de covariance de l'échantillon pour les colonnes générées.
- Export PDF via Download as PDF.
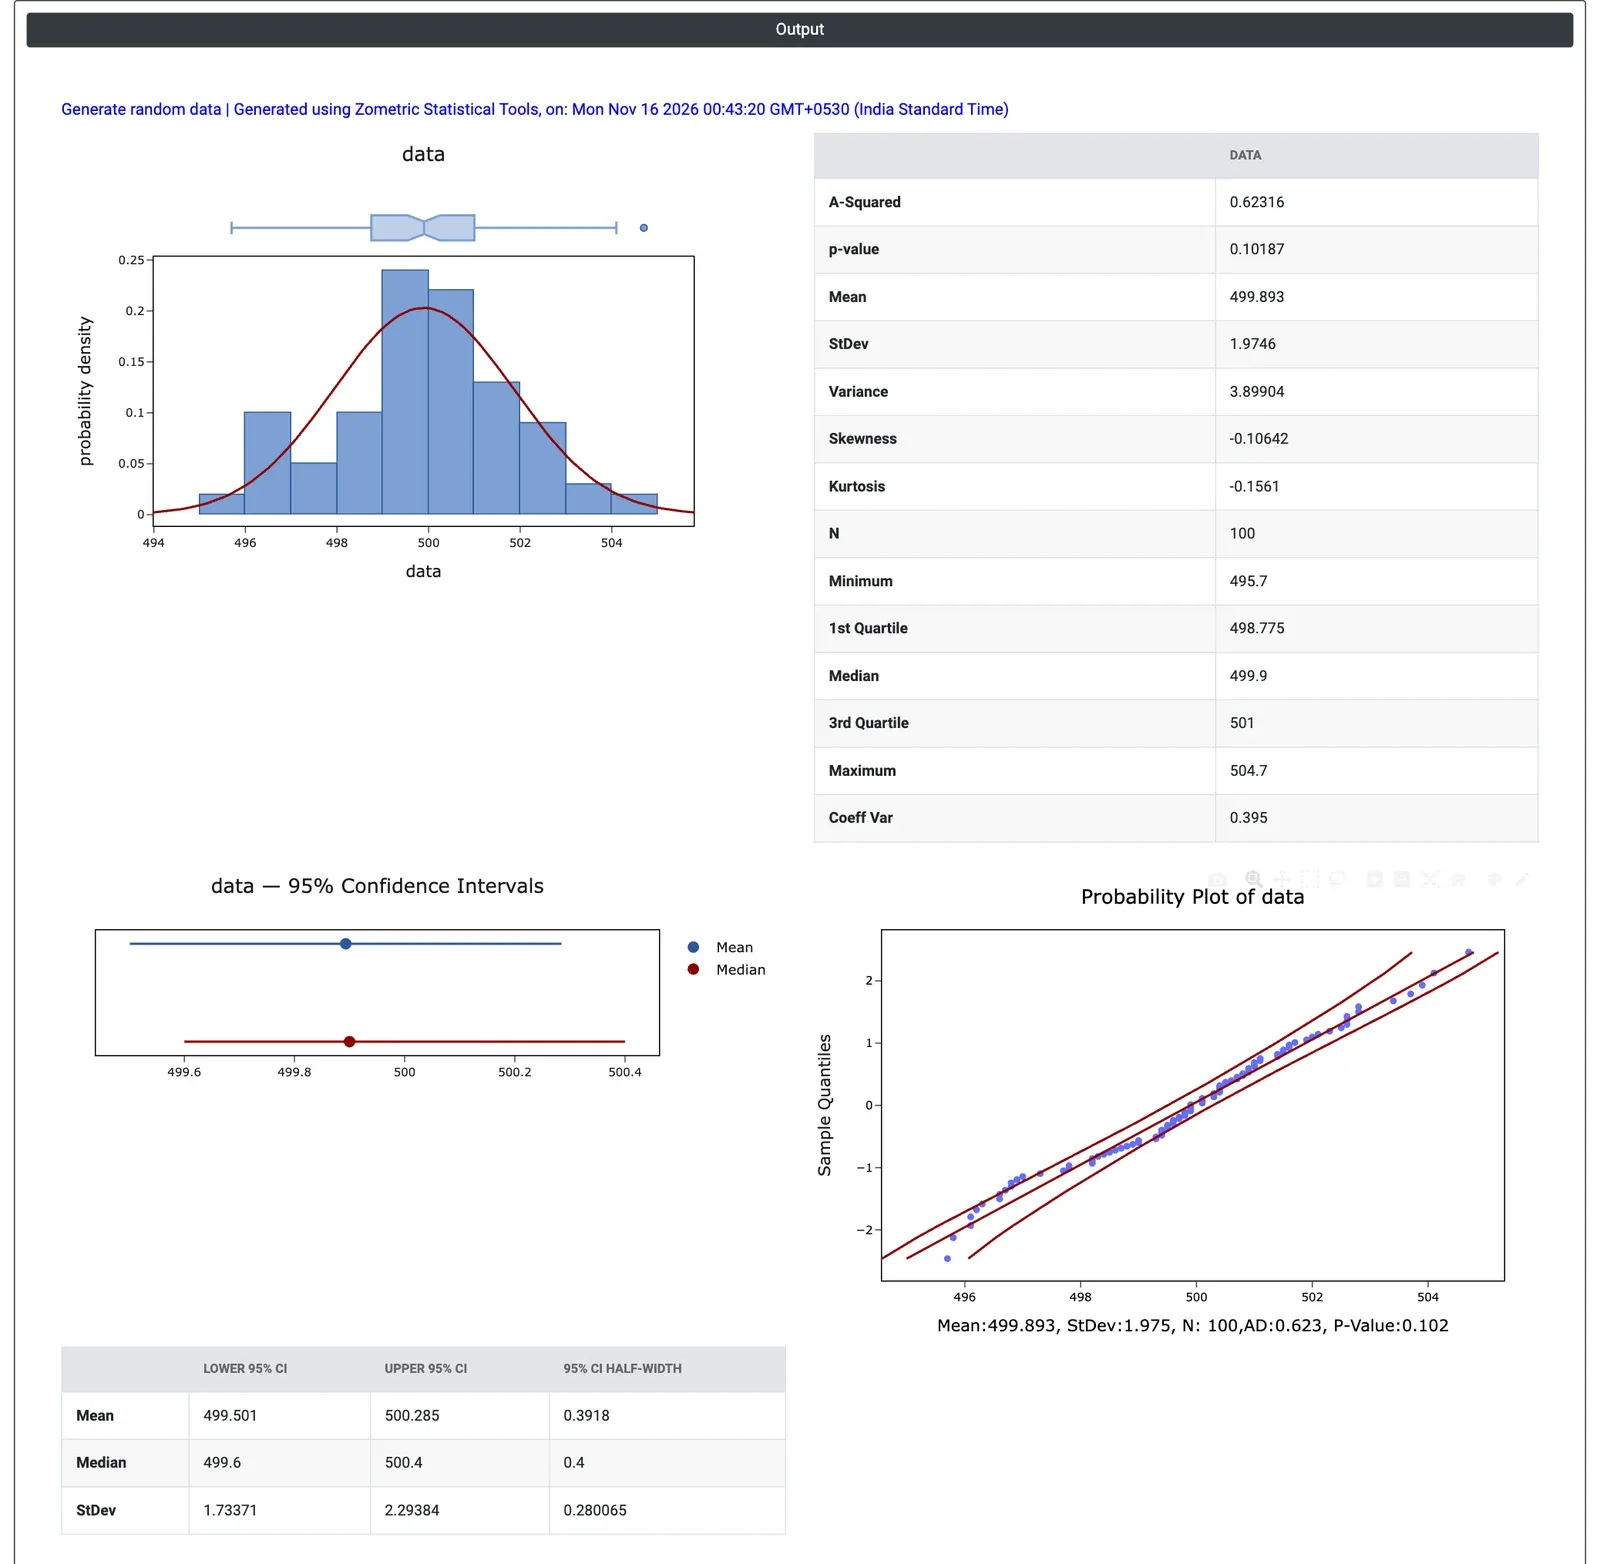
Figure 2 — Résumé graphique des 100 valeurs générées : moyenne 499.89, StDev 1.97, valeur p d'Anderson-Darling 0.102.
Exemple résolu
Un formateur qualité prépare une session sur la variation des procédés pour des opérateurs d'une ligne de remplissage. La ligne remplit des bouteilles de 500 g avec un écart-type d'environ 2 g. Pour montrer à quoi ressemble la seule variation normale, le formateur choisit Distribution = Normal, Number of rows = 100, Number of columns = 1, Mean = 500, Standard Deviation = 2 et Decimals = 1, et coche Graphical Summary.
Les 100 poids de remplissage simulés vont de 495.7 à 504.7 g, avec une moyenne de 499.89 g et un écart-type de 1.97 g, soit pas exactement 500 et 2 alors que le procédé était réglé exactement. L'histogramme est irrégulier plutôt qu'une courbe en cloche nette, mais le test d'Anderson-Darling donne p = 0.102 : rien n'indique que les données s'écartent de la normalité. L'intervalle de confiance à 95% de la moyenne, de 499.50 à 500.29 g (demi-largeur 0.39 g), contient la vraie valeur 500, et l'intervalle de l'écart-type, de 1.73 à 2.29 g, contient la vraie valeur 2.
Ce que les opérateurs doivent retenir : un procédé stable et centré produit quand même des bouteilles isolées à 4 g de la cible et des statistiques d'échantillon qui diffèrent des vraies valeurs. Chaque Calculate tire un nouvel échantillon aux nombres légèrement différents, que le formateur peut utiliser pour montrer la variation d'un échantillon à l'autre. Générer 5 colonnes de 20 lignes donne cinq petits échantillons à comparer, ou bien les données peuvent être copiées dans un outil de capabilité ou de carte de contrôle pour s'entraîner.
Questions fréquentes
À quoi sert la génération de données aléatoires en qualité ?
Elle sert à créer des données d'entraînement pour la formation, à voir à quel point des échantillons issus d'un procédé connu varient, à essayer une analyse avant l'arrivée des données réelles, et à simuler un procédé dans des études « et si », comme des temps de cycle à partir d'une estimation triangulaire ou des temps de défaillance à partir d'un modèle de Weibull. Les données générées peuvent être copiées dans d'autres outils, comme les outils de capabilité ou de cartes de contrôle.
Selon quelles distributions peut-on générer des données aléatoires ?
Il y en a 26 : des distributions continues comme Normal, Lognormal, Weibull, Exponential, Gamma, Uniform et Triangular ; des distributions discrètes comme Binomial, Poisson, Geometric, Hypergeometric, Integer et Discrete ; et Multivariate Normal, qui produit des colonnes corrélées à partir d'un vecteur de moyennes et d'une matrice de covariance. Seuls les champs de paramètres de la distribution choisie sont affichés.
Pourquoi un échantillon aléatoire ne correspond-il pas exactement à la moyenne et à l'écart-type de la population ?
Chaque échantillon varie par le simple effet du hasard. Dans un exemple résolu, 100 valeurs issues d'un procédé normal de moyenne 500 et d'écart-type 2 avaient une moyenne d'échantillon de 499.89 et un écart-type de 1.97, et l'histogramme était irrégulier plutôt qu'en cloche, mais le test d'Anderson-Darling donnait p = 0.102, sans indice d'écart à la normalité.
Comment saisir les paramètres d'une distribution log-normale lors de la génération de données aléatoires ?
Pour la distribution Lognormal, vous saisissez la moyenne et l'écart-type des données elles-mêmes, et non ceux des logarithmes. L'outil les convertit en paramètres d'échelle logarithmique : sigma est égal à la racine carrée de ln(1 + (s/m) au carré) et mu est égal à ln(m) moins sigma au carré sur 2.