
Données aléatoires exponentielles
Random Exponential Data simule des temps d'attente entre événements indépendants, comme des pannes de machines ou des arrivées de clients, en supposant un taux de défaillance constant (propriété d'absence de mémoire). Vous fixez le nombre de lignes et de colonnes, l'échelle (scale), qui est le temps moyen entre événements (1/taux), et un seuil (threshold) facultatif qui décale les valeurs vers le haut. Si le taux de défaillance change dans le temps, utilisez plutôt Random Weibull Data.
Dernière révision
Point clé
Random Exponential Data génère des valeurs strictement positives de la distribution exponentielle, à partir de son temps moyen entre événements, pour simuler des temps entre défaillances, arrivées ou fins de service à taux constant.
Sur cette page
Qu'est-ce que Random Exponential Data ?
Random Exponential Data génère des valeurs de la distribution exponentielle, qui modélise le temps entre événements indépendants consécutifs, comme le temps entre pannes de machines, arrivées de clients ou fins de service. Vous indiquez la moyenne (temps moyen entre événements), et l'outil génère des durées aléatoires entre événements.
Définitions simples : génère des temps d'attente aléatoires entre événements, largement utilisés en fiabilité et en théorie des files d'attente pour simuler le temps restant avant la prochaine défaillance ou arrivée.
Quand utiliser Random Exponential Data ?
- Utilisez-le pour simuler des temps entre défaillances, arrivées ou fins de service.
- Utilisez-le pour tester des analyses de fiabilité qui supposent un taux de défaillance constant (modèle de défaillance exponentiel).
Recommandations pour bien utiliser Random Exponential Data
- La distribution exponentielle suppose un taux de défaillance constant (propriété d'absence de mémoire) : si le taux de défaillance change dans le temps, utilisez plutôt la distribution de Weibull.
- Toutes les valeurs générées sont strictement positives.
- Fixez la moyenne égale au temps moyen connu entre événements issu des données historiques.
Alternatives : quand ne pas utiliser Random Exponential Data
- Si le taux de défaillance change au fil du temps, utilisez Random Weibull Data (données aléatoires de Weibull)
- Pour des mesures continues positives asymétriques (non liées au temps), utilisez Random Lognormal Data (données aléatoires log-normales)
Exemple de Random Exponential Data
Voici les étapes pour générer des Random Exponential Data :
- Pour générer des Random Exponential Data, renseignez les options requises.
- Analysez maintenant les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver Random Exponential Data, choisissez Statistical module> Random Data > Random Exponential Data
4. Après avoir utilisé l'outil ci-dessus, récupérez les résultats comme suit :
Comment générer des Random Exponential Data
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Random Data>Random Exponential Data.
- Ensuite, renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
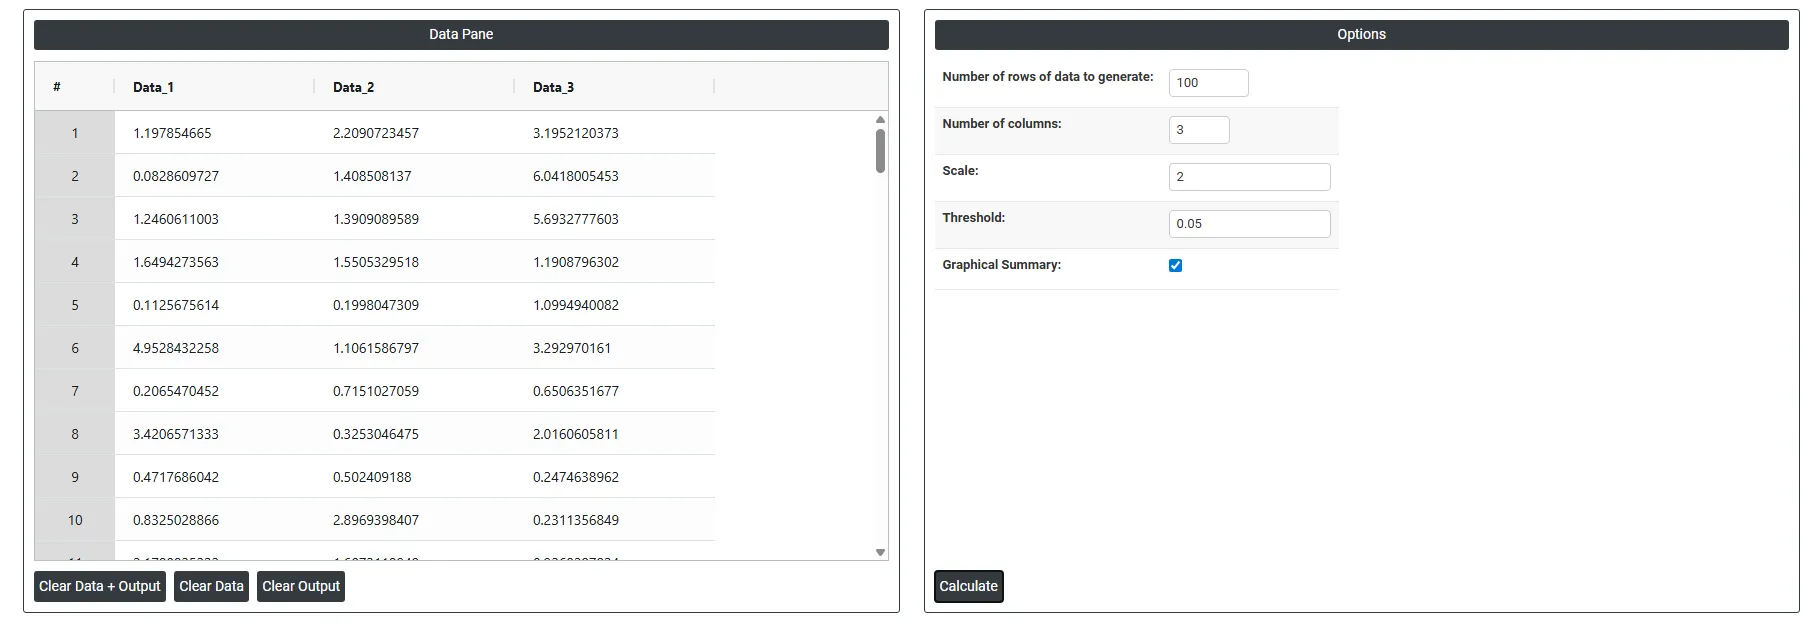
Sur le tableau de bord de Random Exponential Data, la fenêtre est divisée en deux parties.
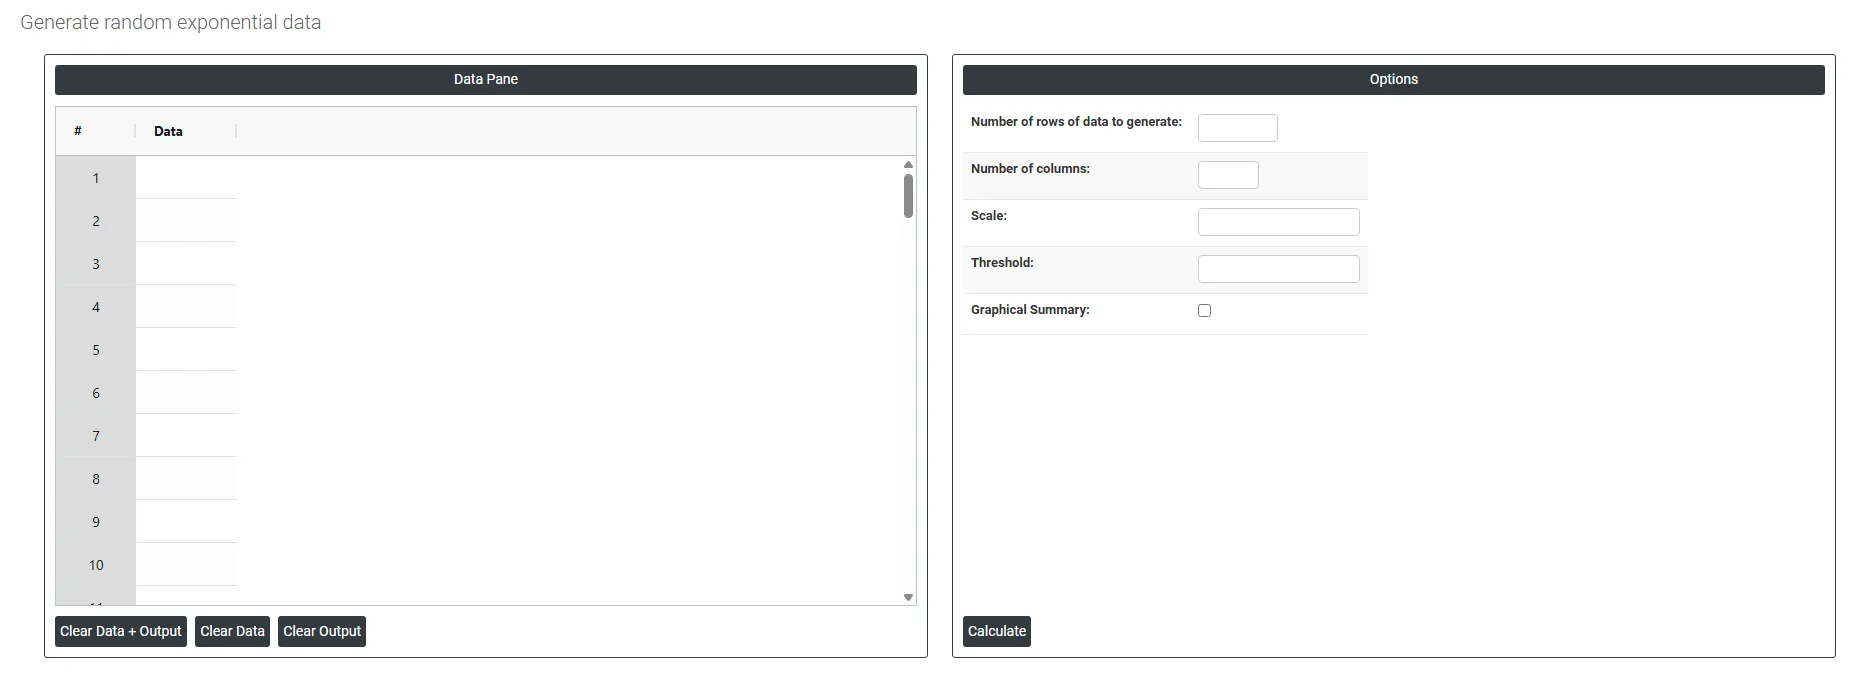
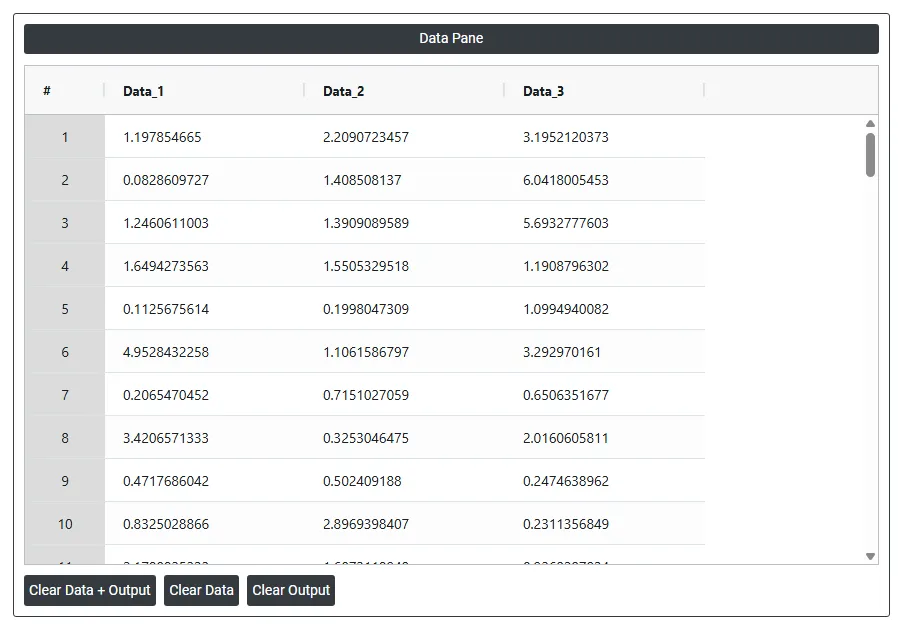
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne correspond à une donnée aléatoire générée. Les données sont générées une fois les options requises renseignées.
Dans la partie droite se trouvent plusieurs options, comme suit :
- Number of rows of data to generate : indique combien de points de données aléatoires générer. Par exemple, saisir 10 produit exactement 10 lignes de valeurs aléatoires, toutes visibles dans le volet de données.
- Number of columns : indique combien de variables (colonnes) chaque ligne comportera. Par exemple, saisir 3 produit 3 colonnes de données générées aléatoirement côte à côte dans le volet de données.
- Scale : la moyenne de la distribution exponentielle, c'est-à-dire le temps moyen entre événements (égal à 1/taux). Une valeur d'échelle plus grande produit des nombres plus grands et plus dispersés ; une valeur plus petite produit des valeurs qui se regroupent plus près de zéro. Tous les points de données générés dans le volet de données reflèteront cette dispersion.
- Threshold : fixe un point de départ minimal pour les données générées. Au lieu de commencer à zéro, les nombres générés sont décalés vers le haut de cette valeur. Par exemple, un seuil de 10 signifie que toutes les valeurs générées commencent à 10 et augmentent, au lieu de commencer à 0.
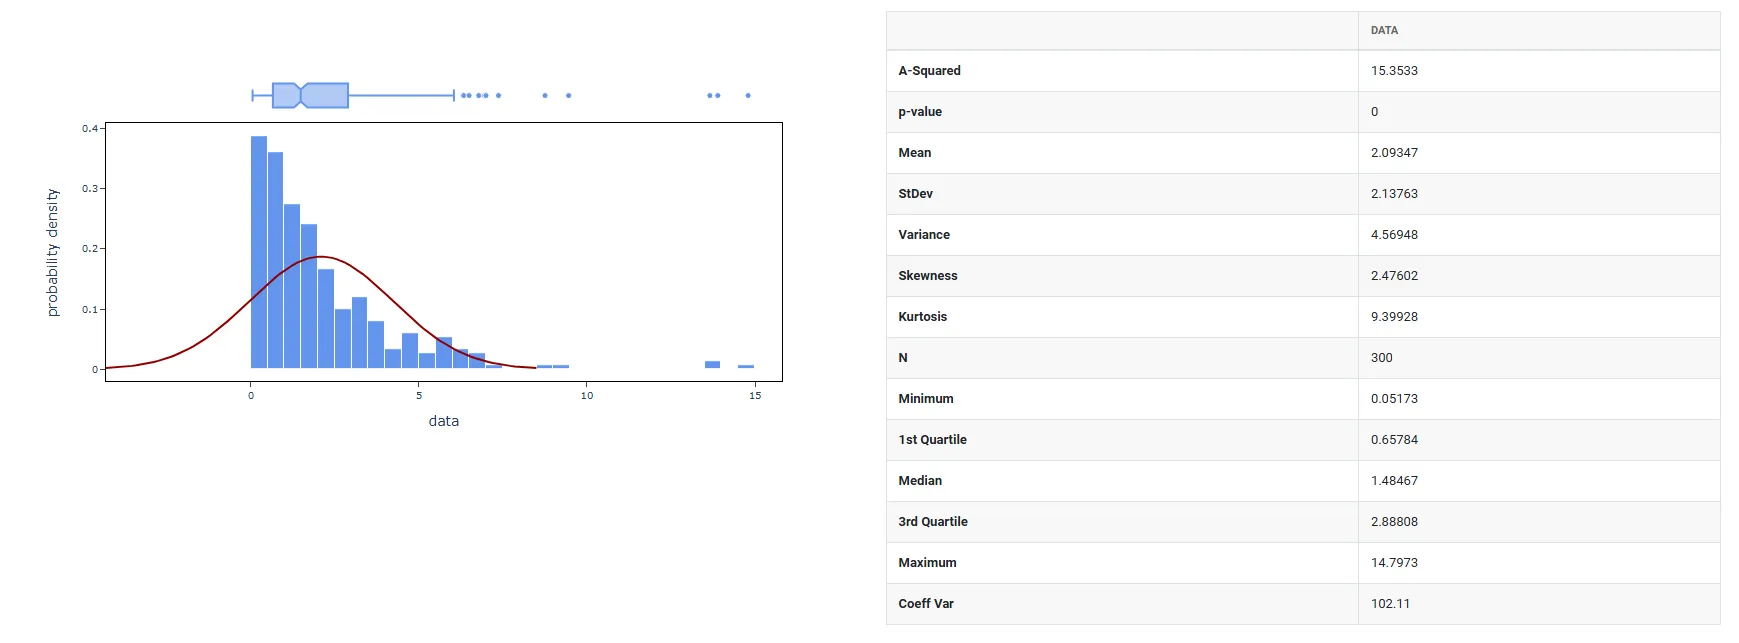
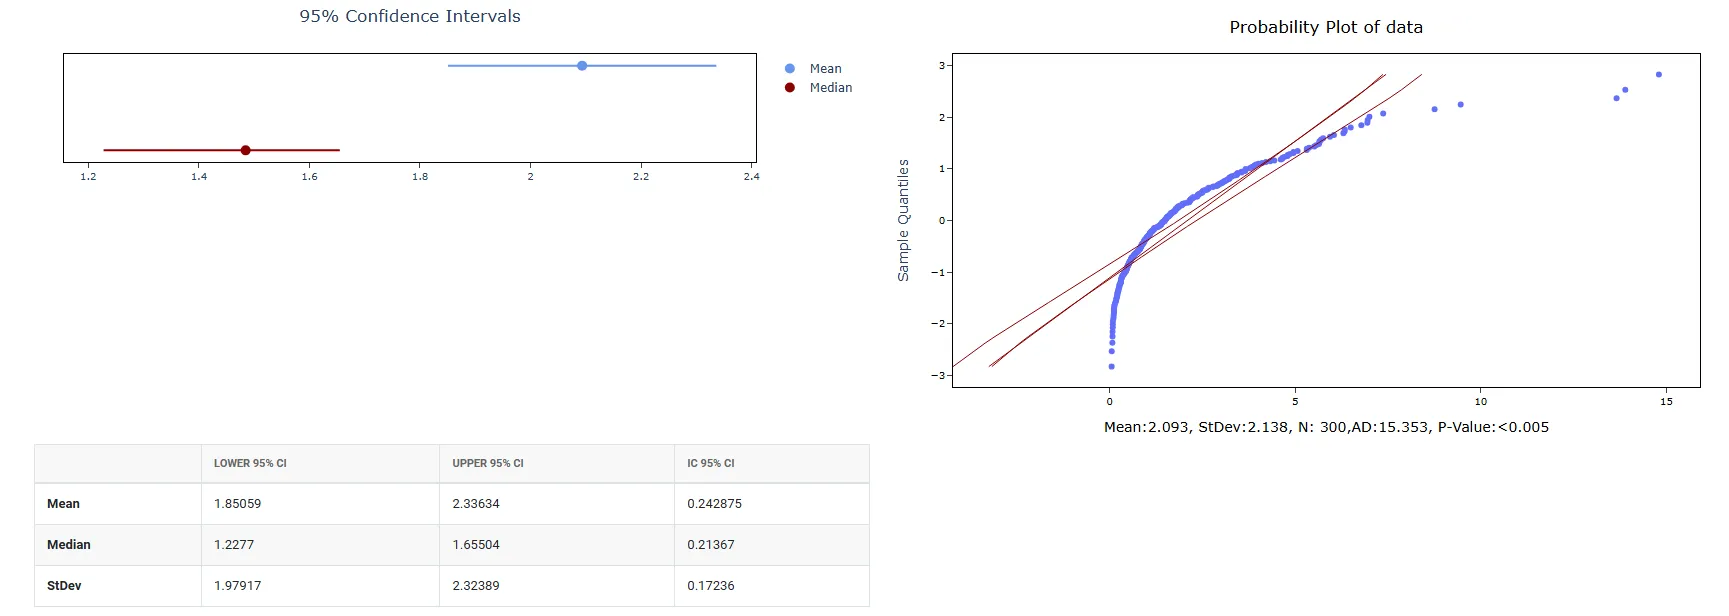
- Graphical summary : lorsque cette option est sélectionnée, toutes les valeurs générées sont regroupées et résumées : un histogramme avec une courbe normale ajustée et une boîte à moustaches, des statistiques descriptives, un test de normalité d'Anderson-Darling, une droite de probabilité, et des intervalles de confiance à 95 % pour la moyenne, la médiane et l'écart-type. C'est un résultat visuel fondé sur les données qui viennent d'être créées.
Questions fréquentes
Que simulent des données aléatoires exponentielles ?
Les données aléatoires exponentielles simulent le temps entre événements indépendants consécutifs, comme le temps entre pannes de machines, arrivées de clients ou fins de service. Elles sont largement utilisées en fiabilité et en théorie des files d'attente pour modéliser le temps restant avant la prochaine défaillance ou arrivée, et pour tester des analyses de fiabilité qui supposent un taux de défaillance constant.
Quand utiliser la distribution de Weibull plutôt que la distribution exponentielle ?
La distribution exponentielle suppose un taux de défaillance constant, la propriété d'absence de mémoire. Si le taux de défaillance change dans le temps, en augmentant ou en diminuant, utilisez plutôt Random Weibull Data. Pour des mesures positives asymétriques non liées au temps, Random Lognormal Data est le meilleur choix.
À quoi servent les paramètres scale et threshold pour des données aléatoires exponentielles ?
L'échelle (scale) est la moyenne de la distribution exponentielle, le temps moyen entre événements, égal à 1/taux. Une échelle plus grande donne des nombres plus grands et plus dispersés, et une échelle plus petite donne des valeurs regroupées plus près de zéro ; fixez-la d'après le temps moyen connu entre événements dans les données historiques. Le seuil (threshold) décale toutes les valeurs vers le haut : un seuil de 10 signifie que les valeurs commencent à 10 plutôt qu'à 0.