
Données F aléatoires
Random F Data simule des statistiques F comme celles des comparaisons de variances, de l'ANOVA et de la régression. Vous réglez le nombre de lignes et de colonnes, les degrés de liberté du numérateur et du dénominateur, et le nombre de décimales. Les deux degrés de liberté déterminent la forme de la distribution ; en augmentant, elle devient moins asymétrique et plus concentrée autour de 1. Les valeurs sont toujours non négatives. Utilisez-la pour la validation, les simulations de puissance et l'enseignement.
Dernière révision
Point clé
Random F Data génère des valeurs de la distribution F, asymétrique à droite et non négative, définie par les degrés de liberté du numérateur et du dénominateur, pour valider comparaisons de variances, ANOVA et tests F de régression.
Sur cette page
Que sont les données F aléatoires (Random F data) ?
Random F Data génère des valeurs de la distribution F, une distribution asymétrique à droite et toujours positive, définie par deux paramètres de degrés de liberté (ddl du numérateur et ddl du dénominateur). La distribution F apparaît naturellement lorsqu'on compare deux variances ou qu'on évalue les statistiques F de l'ANOVA et de la régression.
Définition simple : génère des valeurs aléatoires de la distribution F, utilisées pour valider des comparaisons de variances, des résultats d'ANOVA et des statistiques F de régression.
Quand utiliser Random F data ?
- Utilisez-la pour valider des analyses d'ANOVA et de régression dont les propriétés de la distribution F sont connues.
- Utilisez-la dans des simulations d'analyse de puissance pour estimer l'effectif de l'échantillon d'études de comparaison de variances.
- Utilisez-la pour des démonstrations pédagogiques de la façon dont les distributions F changent avec les degrés de liberté.
Recommandations pour bien utiliser Random F data
- Indiquez correctement les degrés de liberté du numérateur et du dénominateur : ils modifient fortement la forme de la distribution.
- Les valeurs F sont toujours non négatives.
Alternatives : quand ne pas utiliser Random F data
- Pour des simulations de tests t à distribution normale, utilisez les données normales aléatoires
- Pour des simulations de statistiques t, utilisez les données T aléatoires
Exemple de Random F data
Voici les étapes pour générer des données F aléatoires :
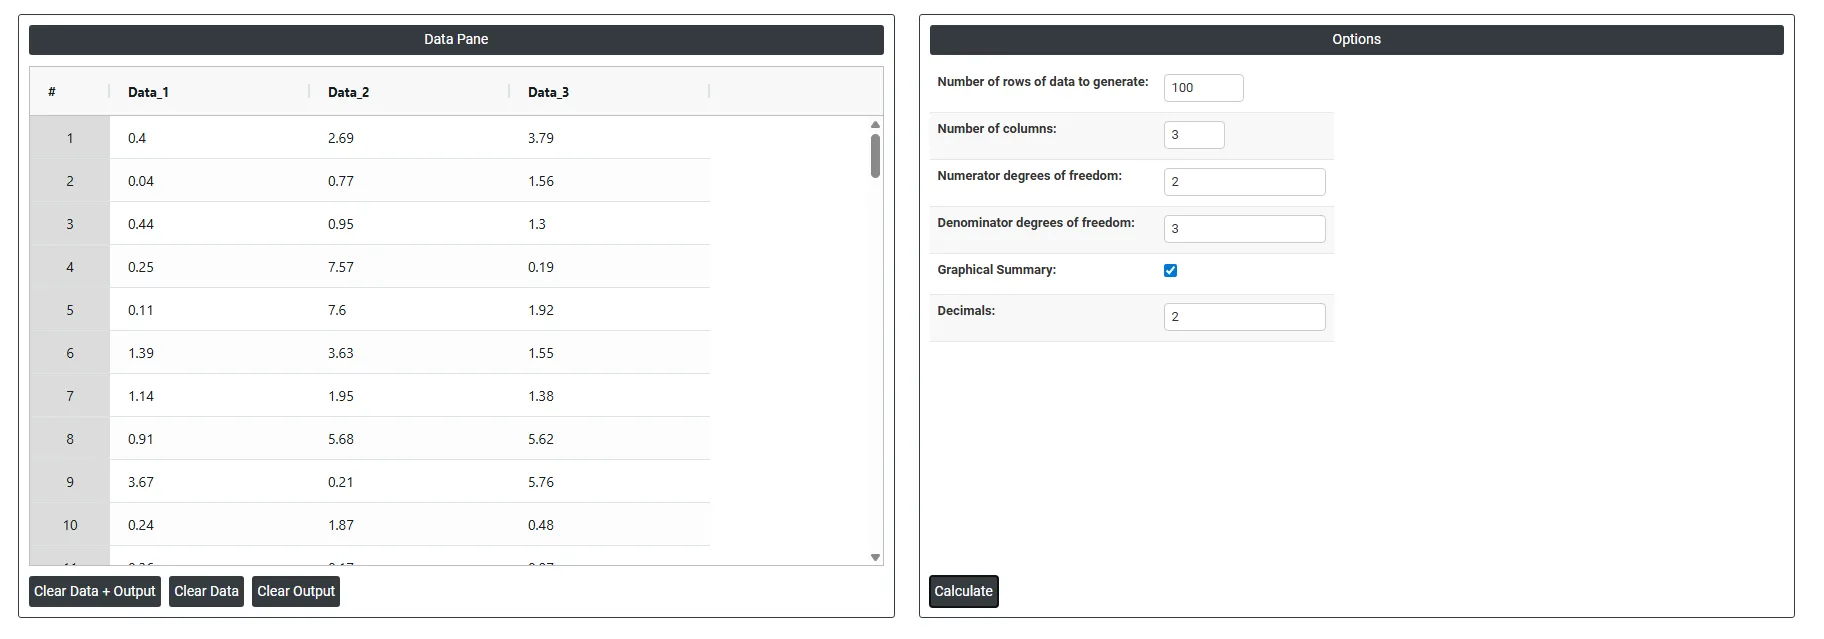
- Pour générer des données F aléatoires, renseignez les options requises.
- Analysez ensuite les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver Random F data, choisissez Statistical module> Random Data > Random F data
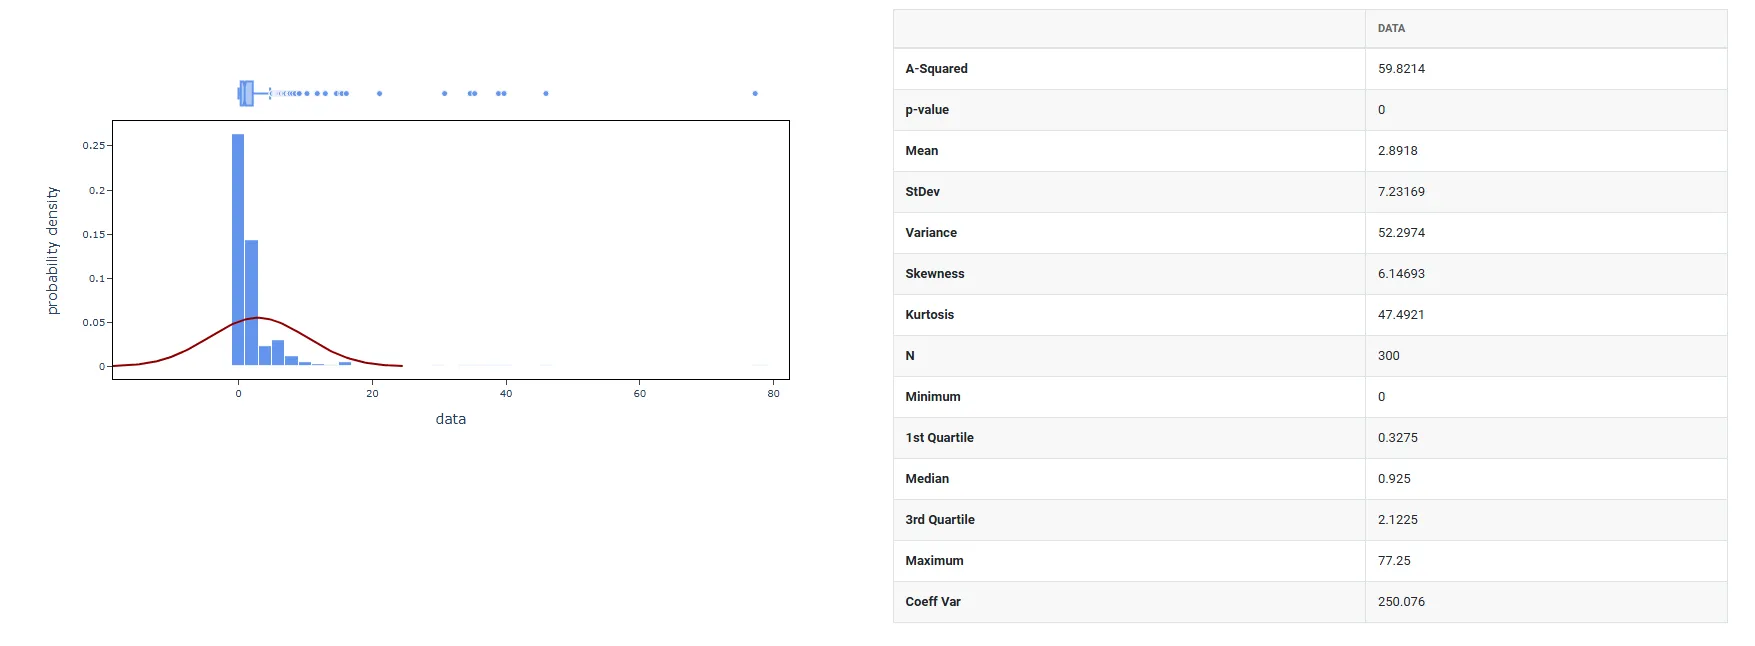
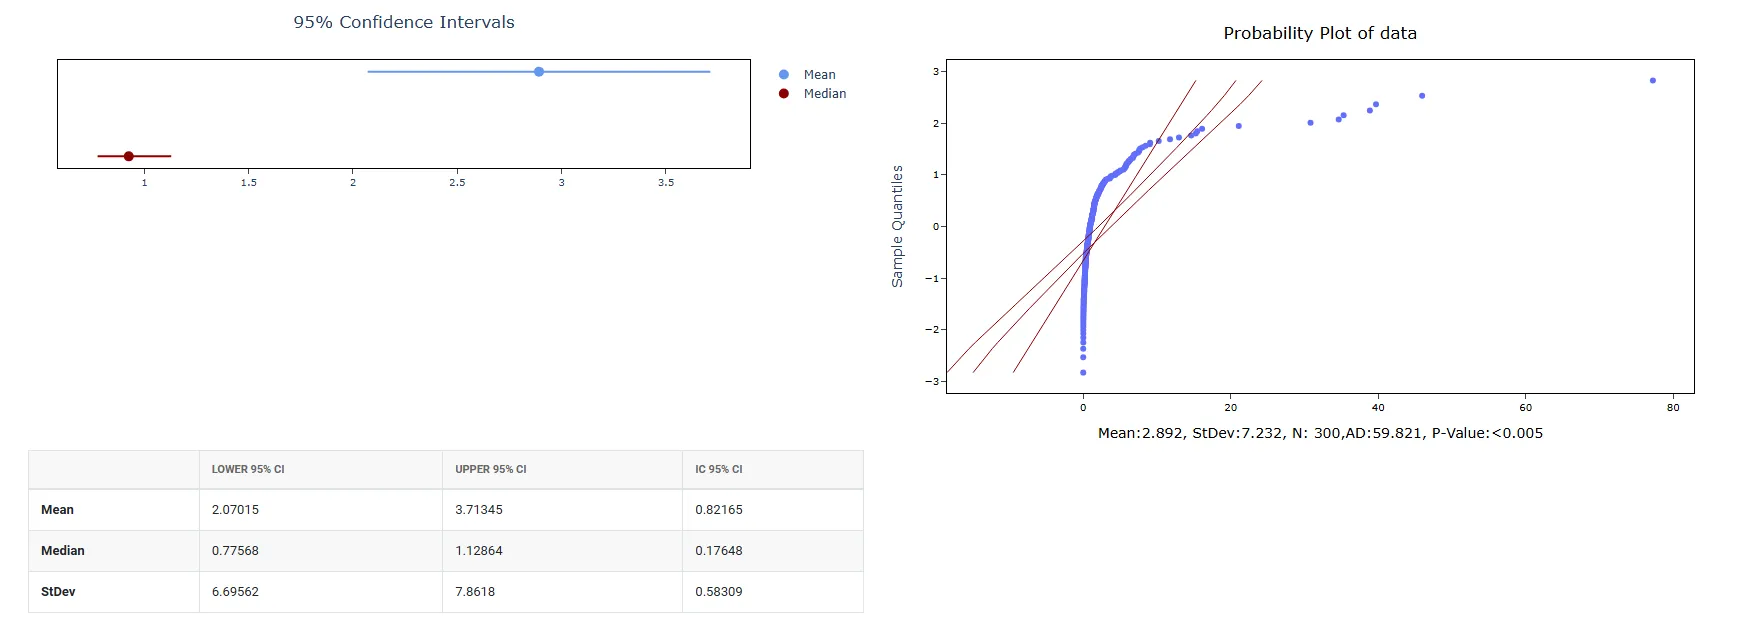
4. Après exécution de l'outil, les résultats obtenus sont les suivants :
Comment réaliser Random F data
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Random Data>Random F data.
- Ensuite, renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Dans le tableau de bord de Random F data, la fenêtre est divisée en deux parties.
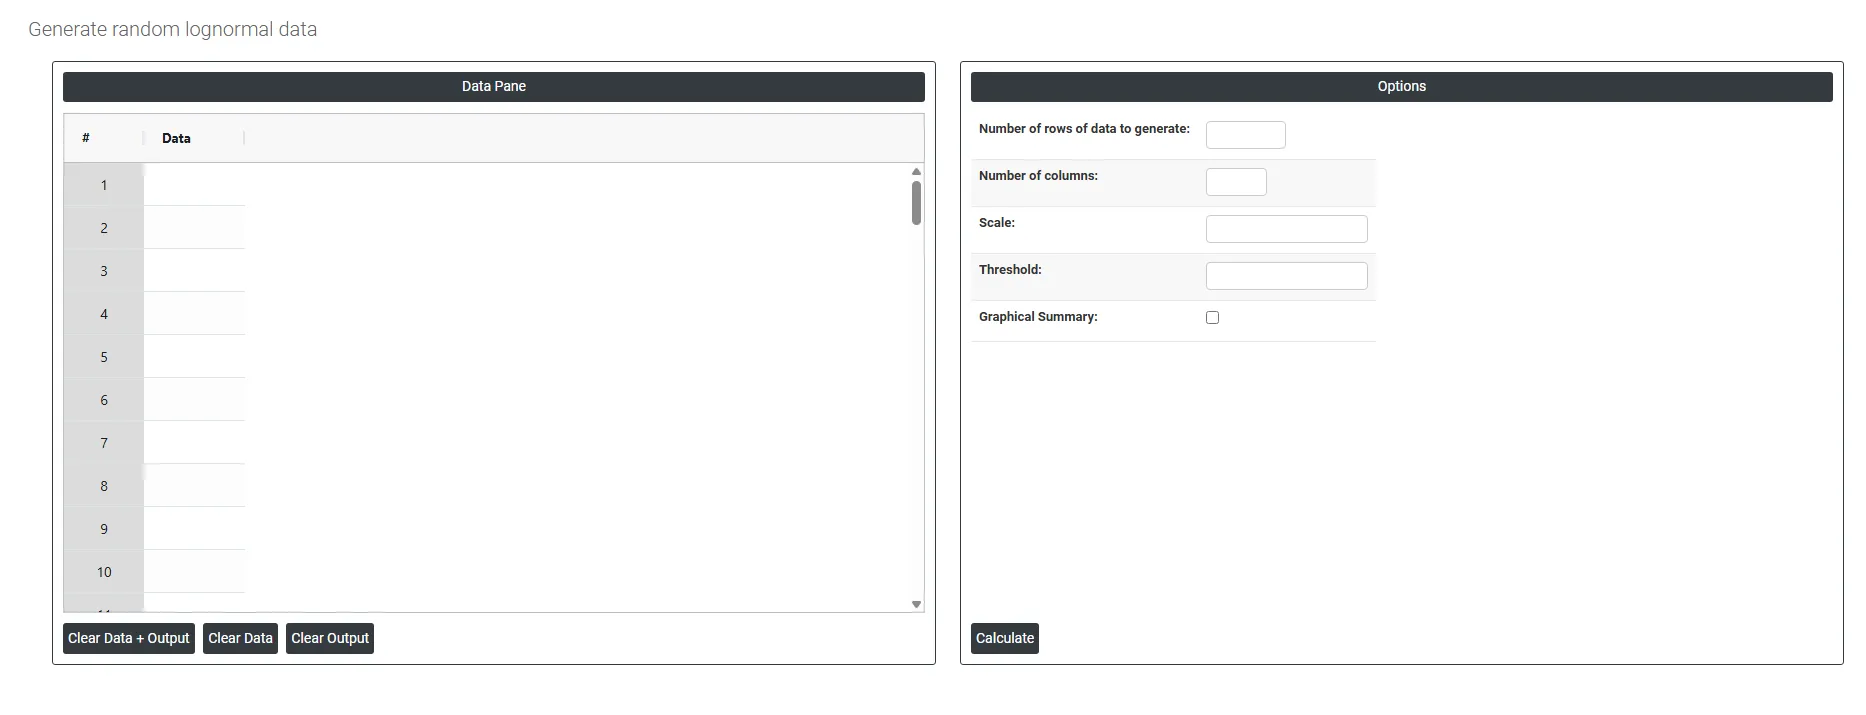
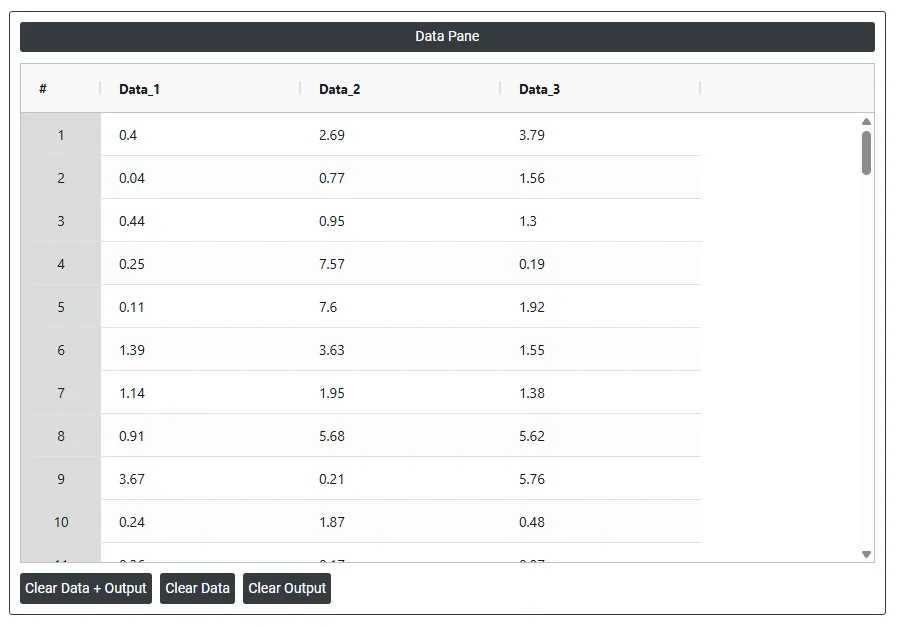
La partie gauche contient le Data Pane (volet de données). Dans le Data Pane, chaque ligne contient des données aléatoires générées. Les données sont générées une fois les options requises renseignées.
La partie droite contient de nombreuses options, décrites ci-dessous :
- Number of rows of data to generate : indique combien de points de données aléatoires générer. Par exemple, saisir 10 produit exactement 10 lignes de valeurs aléatoires, toutes visibles dans le volet de données.
- Number of columns : indique combien de variables (colonnes) chaque ligne comporte. Par exemple, saisir 3 produit 3 colonnes de données générées aléatoirement, côte à côte dans le volet de données.
- Numerator degrees of freedom : le premier paramètre de forme de la distribution F, correspondant aux degrés de liberté de la variance du numérateur. Il contrôle la forme globale de la distribution générée. Par exemple, saisir 2 génère des valeurs F aléatoires fondées sur un numérateur à 2 degrés de liberté.
- Denominator degrees of freedom : le second paramètre de forme de la distribution F, correspondant aux degrés de liberté de la variance du dénominateur. Avec les degrés de liberté du numérateur, il définit entièrement la forme de la distribution F dont sont tirées les données aléatoires. À mesure que les deux degrés de liberté augmentent, la distribution devient moins asymétrique et plus concentrée autour de 1.
- Graphical summary : lorsque cette option est sélectionnée, toutes les valeurs générées sont regroupées et résumées : un histogramme avec une courbe normale ajustée et une boîte à moustaches, des statistiques descriptives, un test de normalité d'Anderson-Darling, une droite de probabilité, et des intervalles de confiance à 95 % de la moyenne, de la médiane et de l'écart-type. C'est un résultat visuel fondé sur les données qui viennent d'être créées.
- Decimals : contrôle le nombre de décimales des valeurs aléatoires générées elles-mêmes. Par exemple, le régler à 2 signifie que chaque nombre généré sera arrondi à 2 décimales, comme 47.83 ou 52.16. Le régler à 0 produit uniquement des nombres entiers.
Questions fréquentes
À quoi sert la distribution F ?
La distribution F est une distribution asymétrique à droite et toujours non négative, définie par les degrés de liberté du numérateur et du dénominateur. Elle apparaît lorsqu'on compare deux variances et lorsqu'on évalue les statistiques F de l'ANOVA et de la régression. Random F data sert à valider ces analyses, dans des simulations d'analyse de puissance pour des études de comparaison de variances, et à enseigner comment la distribution change avec les degrés de liberté.
Comment les degrés de liberté modifient-ils la distribution F ?
Les degrés de liberté du numérateur et du dénominateur modifient fortement la forme de la distribution F ; il faut donc les indiquer correctement. Les degrés de liberté du numérateur correspondent à la variance du numérateur et ceux du dénominateur à la variance du dénominateur. À mesure que les deux augmentent, la distribution devient moins asymétrique et plus concentrée autour de 1.
Comment générer des données F aléatoires dans Zometric Statistical Software ?
Choisissez Statistical Tool > Random Data > Random F data, puis saisissez le nombre de lignes et de colonnes à générer, les degrés de liberté du numérateur et du dénominateur, et éventuellement le nombre de décimales et un graphical summary. Cliquez sur calculate : les valeurs générées apparaissent dans le volet de données, prêtes à être utilisées dans d'autres outils.