
Données aléatoires lognormales (Random Lognormal Data)
Random Lognormal Data simule des mesures continues toujours positives et asymétriques à droite. Vous définissez le nombre de lignes et de colonnes, la moyenne et l'écart-type des données elles-mêmes (et non de leur logarithme) et un seuil facultatif qui décale les valeurs vers le haut. L'outil convertit la moyenne et l'écart-type en paramètres à l'échelle logarithmique. Aucune graine fixe n'est utilisée : copiez les données pour les réutiliser. Une synthèse graphique facultative montre la distribution.
Dernière révision
Point clé
Random Lognormal Data génère des valeurs strictement positives, asymétriques à droite, dont le logarithme suit une distribution normale, pour simuler des tailles de particules, des temps de réponse ou des concentrations.
Sur cette page
Qu'est-ce que Random Lognormal Data ?
Random Lognormal Data génère des valeurs issues de la distribution lognormale, une distribution asymétrique à droite dans laquelle le logarithme népérien des données suit une distribution normale. Le résultat est un ensemble de valeurs toujours positives et asymétriques à droite, que l'on observe couramment dans des mesures comme les tailles de particules, les distributions de revenus et les concentrations biologiques.
Définition simple : Génère des valeurs positives aléatoires selon une distribution asymétrique à droite, naturelle pour des mesures comme les tailles de particules, les temps de réponse et les concentrations de matériaux, qui ne peuvent être ni nulles ni négatives.
Quand utiliser Random Lognormal Data ?
- À utiliser pour simuler des mesures continues asymétriques à droite toujours positives.
- À utiliser lorsque la transformation logarithmique de vos données les rend approximativement normales, et que vous voulez générer des valeurs brutes réalistes pour une simulation.
- À utiliser dans des simulations environnementales, pharmaceutiques et financières.
Recommandations pour bien utiliser Random Lognormal Data
- Les paramètres sont saisis à l'échelle des données : la moyenne et l'écart-type sont ceux de x lui-même, et non de log(x) ; l'outil les convertit en paramètres à l'échelle logarithmique.
- Toutes les valeurs générées sont strictement positives.
- Aucune graine fixe n'est utilisée : chaque calcul (Calculate) donne de nouvelles valeurs ; copiez les données générées si vous devez réutiliser le même jeu de données.
Alternatives : quand ne pas utiliser Random Lognormal Data
- Si les données sont symétriques et en forme de cloche, utilisez Random Normal Data
- Pour un temps jusqu'à la défaillance avec un taux de risque variable, utilisez Random Weibull Data
Exemple de Random Lognormal Data
Voici les étapes pour générer des données lognormales aléatoires :
- Pour générer des données lognormales aléatoires, renseignez les options requises.
- Analysez ensuite les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver Random Lognormal Data, choisissez Statistical module> Random Data > Random Lognormal Data
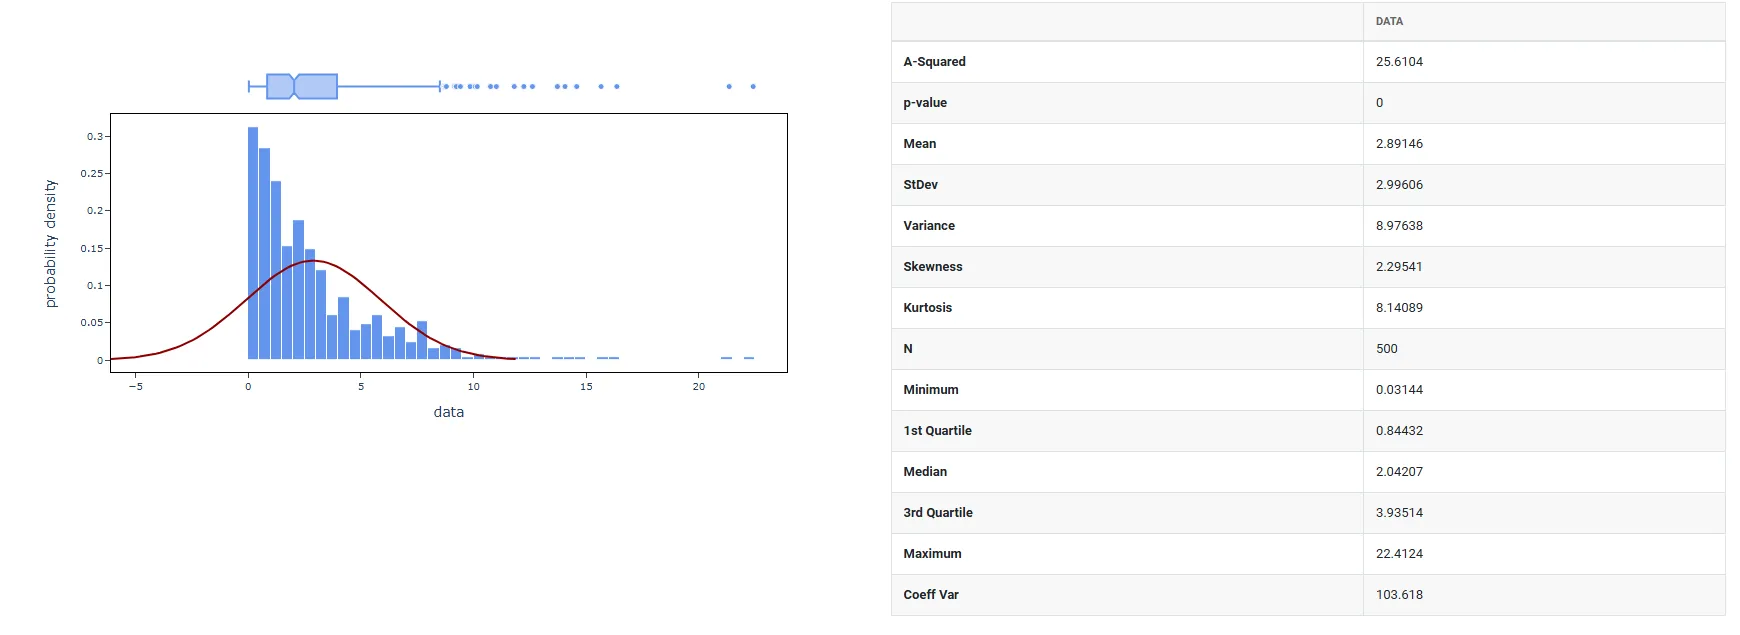
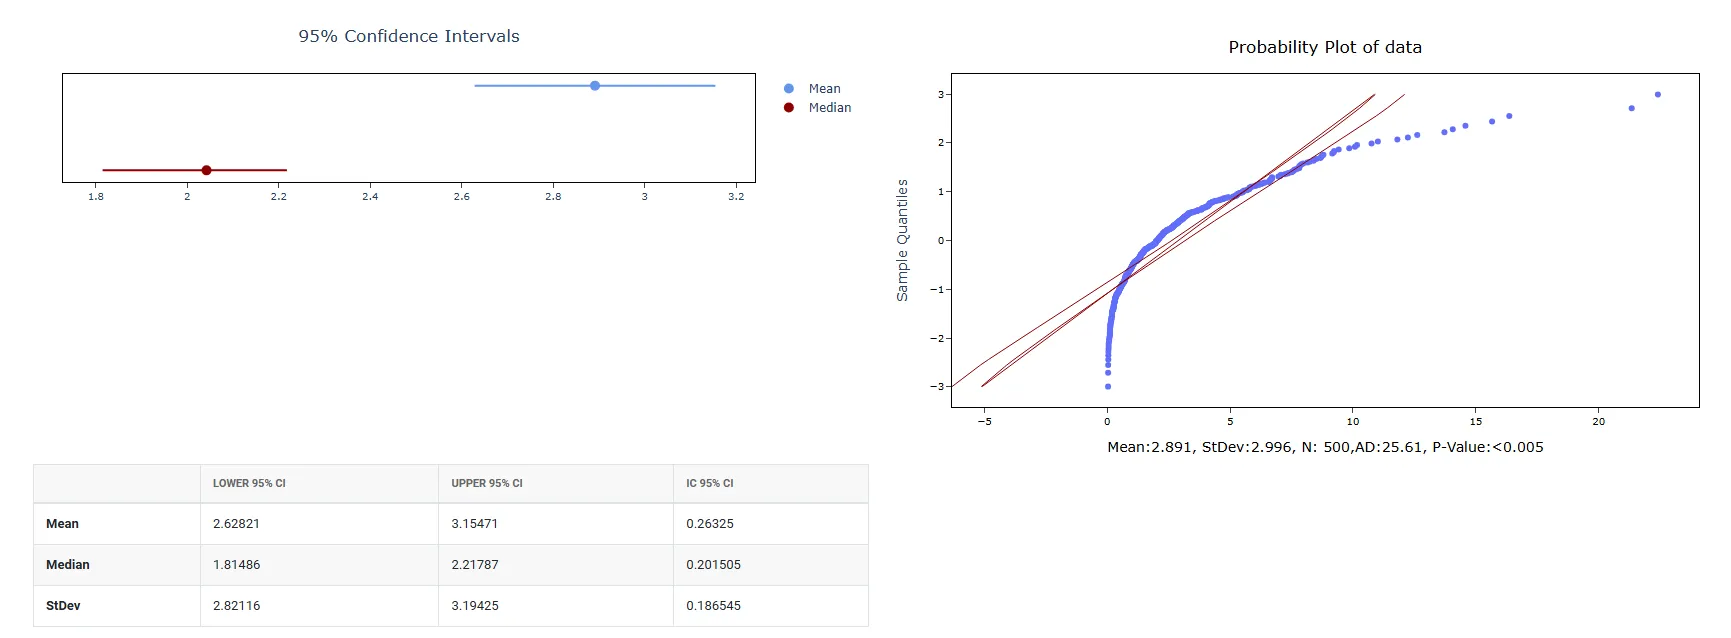
4. Après avoir utilisé l'outil ci-dessus, vous obtenez les résultats suivants :
Comment générer Random Lognormal Data
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Random Data>Random Lognormal Data.
- Ensuite, renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
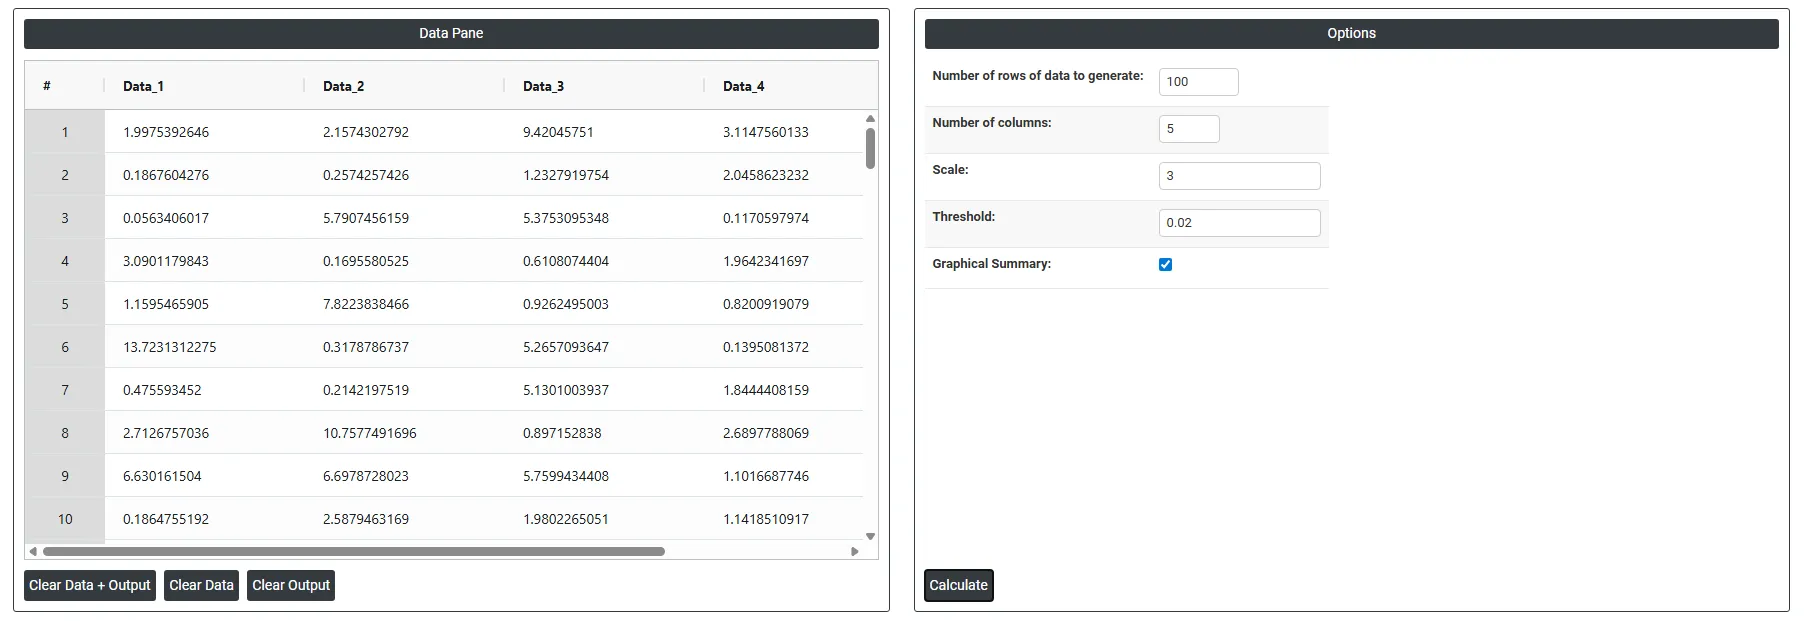
Dans le tableau de bord de Random Lognormal Data, la fenêtre est divisée en deux parties.
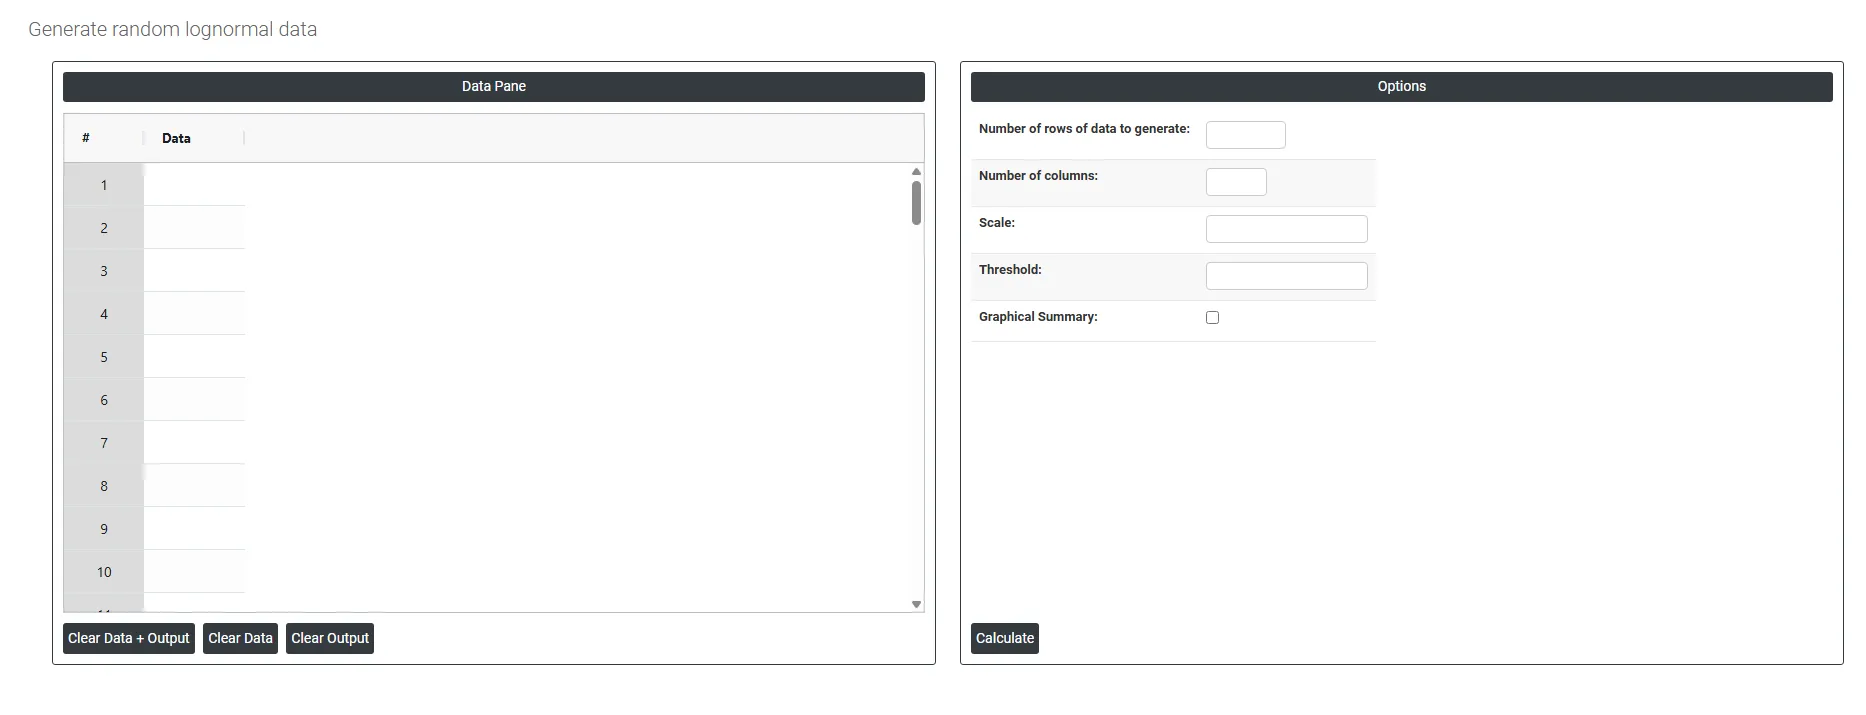
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne contient des données aléatoires générées. Les données sont générées une fois les options requises renseignées.
Dans la partie droite, plusieurs options sont proposées :
- Number of rows of data to generate : indique combien de points de données aléatoires générer. Par exemple, saisir 100 produit exactement 100 lignes de valeurs aléatoires, toutes visibles dans le volet de données.
- Number of columns : indique combien de variables (colonnes) comportera chaque ligne. Par exemple, saisir 5 produit 5 colonnes de données générées aléatoirement, côte à côte dans le volet de données.
- Mean and Standard Deviation : la moyenne et l'écart-type des données générées elles-mêmes (et non de leurs logarithmes). L'outil les convertit en paramètres à l'échelle logarithmique σ = √ln(1 + (s/m)²) et μ = ln(m) − σ²/2. Un écart-type plus grand par rapport à la moyenne produit des valeurs plus fortement asymétriques à droite.
- Threshold : définit un point de départ minimal pour les données générées. Au lieu de partir de zéro, les valeurs générées sont décalées vers le haut de ce montant. Par exemple, un seuil de 10 signifie que toutes les valeurs générées partent de 10 et montent, au lieu de partir de 0.
- Graphical summary : une fois les données aléatoires générées avec la moyenne et l'écart-type que vous avez indiqués, cette option produit une analyse graphique de ces données, par exemple un histogramme montrant comment les valeurs générées sont distribuées. C'est un résultat visuel fondé sur les données qui viennent d'être créées.
Questions fréquentes
Qu'est-ce qu'une distribution lognormale ?
Une distribution lognormale est une distribution asymétrique à droite dans laquelle le logarithme népérien des données suit une distribution normale. Ses valeurs sont toujours positives, ce qui convient à des mesures comme les tailles de particules, les temps de réponse, les revenus et les concentrations biologiques ou de matériaux, qui ne peuvent être ni nulles ni négatives.
Quand faut-il générer des données lognormales aléatoires ?
Utilisez-les pour simuler des mesures continues asymétriques à droite et toujours positives, ou lorsque la transformation logarithmique de vos données les rend approximativement normales et que vous voulez des valeurs brutes réalistes pour une simulation. C'est courant dans les simulations environnementales, pharmaceutiques et financières. Si les données sont symétriques et en forme de cloche, utilisez Random Normal Data ; pour un temps jusqu'à la défaillance avec un taux de risque variable, utilisez Random Weibull Data.
La moyenne et l'écart-type lognormaux sont-ils saisis à l'échelle logarithmique ?
Non. Dans cet outil, la moyenne et l'écart-type sont ceux des données générées elles-mêmes, et non de leurs logarithmes. L'outil les convertit en paramètres à l'échelle logarithmique σ = √ln(1 + (s/m)²) et μ = ln(m) − σ²/2. Un écart-type plus grand par rapport à la moyenne produit des valeurs plus fortement asymétriques à droite, et un seuil facultatif décale toutes les valeurs vers le haut.
Peut-on régénérer exactement le même jeu de données lognormales aléatoires ?
Non : aucune graine fixe n'est utilisée, donc chaque calcul produit de nouvelles valeurs aléatoires. Si vous devez réutiliser le même jeu de données, par exemple pour répéter une analyse ou le partager avec des collègues, copiez les données générées depuis le volet de données avant de recalculer. Toutes les valeurs générées sont strictement positives.