
Données aléatoires de distribution t (Random T Data)
Random T Data simule des valeurs de la distribution t pour valider des tests t et des intervalles de confiance, analyser la puissance et enseigner. Vous réglez le nombre de lignes et de colonnes, les degrés de liberté, typiquement n - 1, et le nombre de décimales. De faibles degrés de liberté donnent des queues plus lourdes et des valeurs plus extrêmes ; au-delà de 30, la distribution t est presque identique à la normale. Une synthèse graphique facultative est disponible.
Dernière révision
Point clé
Random T Data génère des valeurs de la distribution t, distribution symétrique en cloche aux queues plus lourdes que la normale, définie par ses degrés de liberté, pour simuler des statistiques t et des études sur petits échantillons.
Sur cette page
Qu'est-ce que Random T Data ?
Random T Data génère des valeurs de la distribution t — une distribution symétrique en cloche, semblable à la distribution normale mais aux queues plus lourdes, régie par un paramètre de degrés de liberté. Lorsque les degrés de liberté augmentent, la distribution t converge vers la loi normale centrée réduite. Elle est très utilisée pour simuler des statistiques de test t et modéliser l'incertitude dans les études sur petits échantillons.
Définition simple :génère des valeurs aléatoires de la distribution t — une courbe en cloche aux queues plus lourdes que la normale, idéale pour les simulations sur petits échantillons et la validation de tests t.
Quand utiliser Random T Data ?
- À utiliser pour valider des tests t et des calculs d'intervalles de confiance avec des propriétés de distribution connues.
- À utiliser pour des simulations d'analyse de puissance afin de déterminer des effectifs d'échantillon adéquats pour des études par test t.
- À utiliser dans des démonstrations pédagogiques montrant comment la distribution t se rapproche de la normalité lorsque l'effectif de l'échantillon augmente.
Recommandations pour bien utiliser Random T Data
- Réglez les degrés de liberté selon l'effectif de l'échantillon de votre étude (typiquement n − 1).
- Pour de grands degrés de liberté (> 30), la distribution t est presque identique à la distribution normale.
Alternatives : quand ne pas utiliser Random T Data
- Pour des simulations sur grands échantillons où la normalité convient, utilisez Random Normal Data
- Pour des simulations de comparaison de variances, utilisez Random F Data
Exemple de Random T Data
Voici les étapes pour générer des données Random T Data :
- Pour générer des données Random T Data, renseignez les options requises.
- Analysez ensuite les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour trouver Random T Data, choisissez Statistical module> Random Data > Random T Data
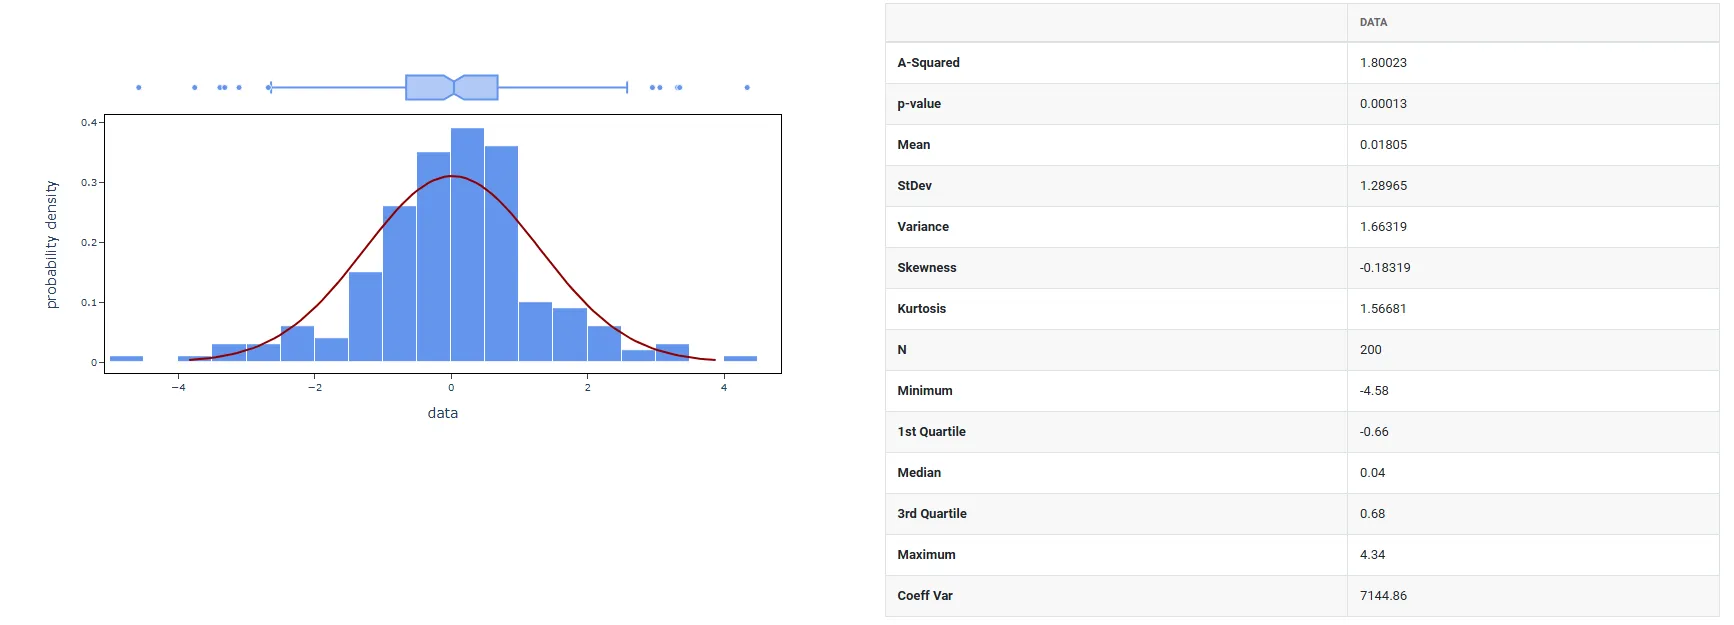
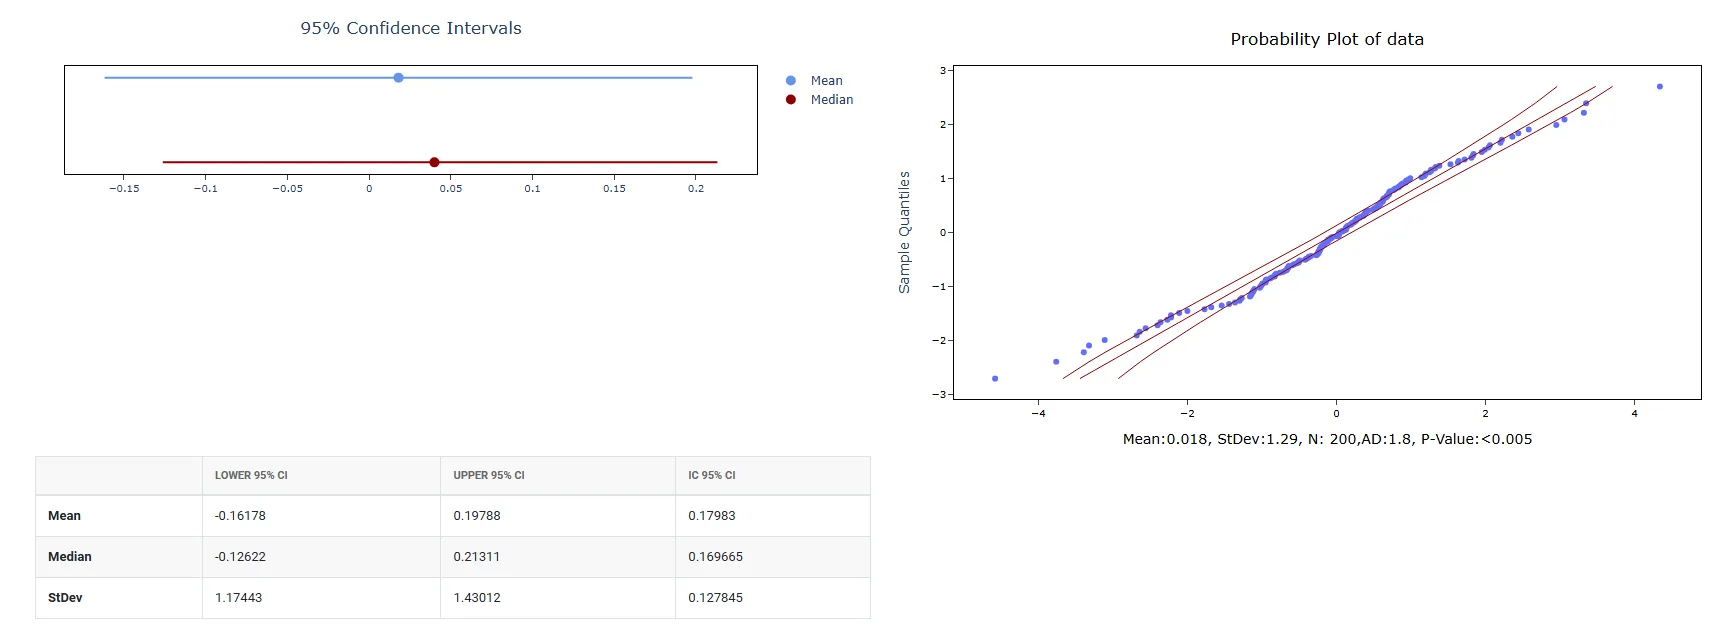
4. Après exécution de l'outil, les résultats obtenus sont les suivants :
Comment utiliser Random T Data
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Random Data>Random T Data.
- Ensuite, renseignez les options requises.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
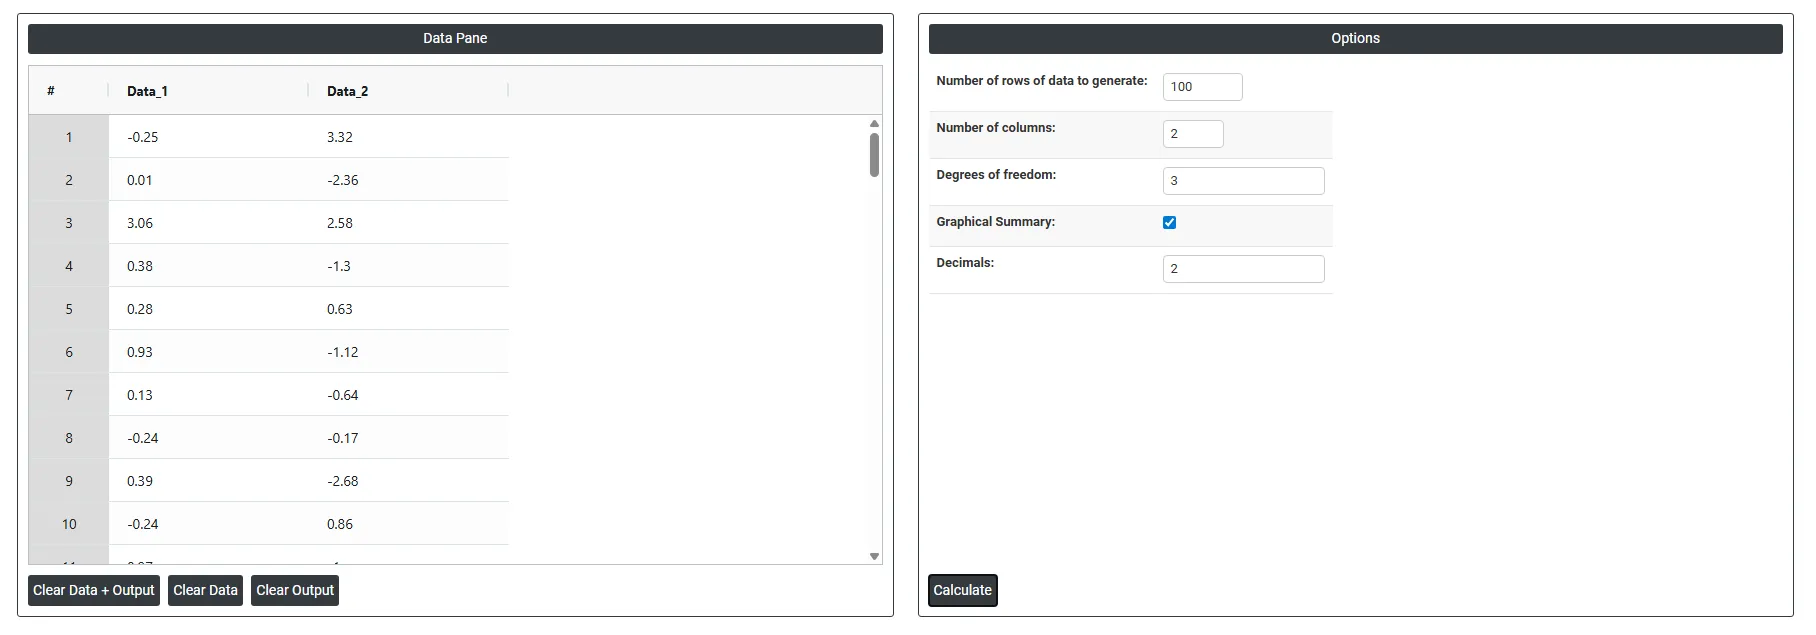
Dans le tableau de bord de Random T Data, la fenêtre est divisée en deux parties.
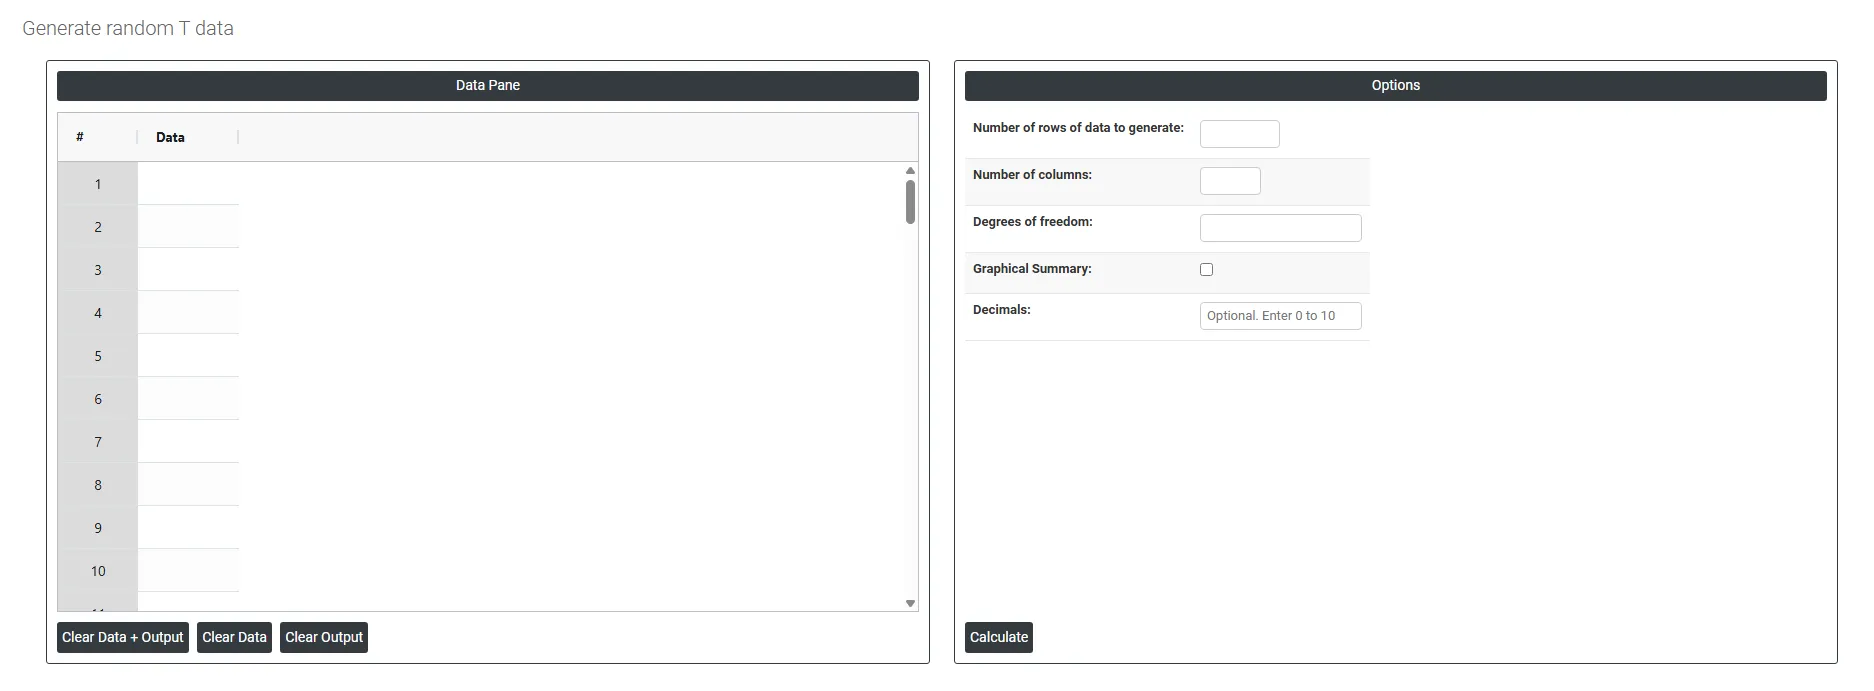
La partie gauche contient le Data Pane (volet de données). Dans le Data Pane, chaque ligne contient des données aléatoires générées. Les données sont générées une fois les options requises renseignées.
La partie droite contient de nombreuses options, décrites ci-dessous :
- Number of rows of data to generate : indique combien de points de données aléatoires générer. Par exemple, saisir 10 produit exactement 10 lignes de valeurs aléatoires, toutes visibles dans le volet de données.
- Number of columns : indique combien de variables (colonnes) comportera chaque ligne. Par exemple, saisir 3 produit 3 colonnes de données générées aléatoirement, côte à côte dans le volet de données.
- Degrees of freedom : détermine la forme de la distribution t utilisée pour générer les données aléatoires. Avec de faibles degrés de liberté (comme 1 ou 2), la distribution a des queues plus lourdes, ce qui signifie que des valeurs plus extrêmes apparaîtront dans les données générées. Lorsque les degrés de liberté augmentent, la distribution t se rapproche progressivement de la forme d'une distribution normale. Par exemple, saisir 30 génère des données aléatoires d'une distribution t à 30 degrés de liberté, produisant des valeurs qui ressemblent beaucoup à des données distribuées normalement.
- Graphical summary : lorsque cette option est sélectionnée, toutes les valeurs générées sont regroupées et résumées : un histogramme avec courbe normale ajustée et une boîte à moustaches, des statistiques descriptives, un test de normalité d'Anderson-Darling, une droite de probabilité, et des intervalles de confiance à 95 % pour la moyenne, la médiane et l'écart-type. C'est un résultat visuel fondé sur les données qui viennent d'être créées.
- Decimals : détermine le nombre de décimales des valeurs aléatoires générées elles-mêmes. Par exemple, le régler sur 2 signifie que chaque nombre généré sera arrondi à 2 décimales, comme 47.83 ou 52.16. Le régler sur 0 ne produit que des nombres entiers.
Questions fréquentes
Qu'est-ce que la distribution t ?
La distribution t est une distribution symétrique en cloche, semblable à la normale mais aux queues plus lourdes, régie par un paramètre de degrés de liberté. Lorsque les degrés de liberté augmentent, elle converge vers la loi normale centrée réduite. Elle est très utilisée pour simuler des statistiques de test t et modéliser l'incertitude dans les études sur petits échantillons.
Quels degrés de liberté utiliser pour des données aléatoires t ?
Réglez les degrés de liberté selon l'effectif de l'échantillon de votre étude, typiquement n - 1. De faibles valeurs, comme 1 ou 2, donnent des queues plus lourdes et des valeurs plus extrêmes. Pour de grands degrés de liberté, au-dessus de 30, la distribution t est presque identique à la normale ; Random Normal Data peut donc être utilisé à la place pour des simulations sur grands échantillons.
Quand faut-il générer des données aléatoires t ?
Utilisez-les pour valider des tests t et des calculs d'intervalles de confiance avec des propriétés de distribution connues, dans des simulations d'analyse de puissance pour trouver des effectifs d'échantillon adéquats pour des études par test t, et pour enseigner comment la distribution t se rapproche de la normalité lorsque l'effectif de l'échantillon augmente. Pour des simulations de comparaison de variances, utilisez plutôt Random F Data.