
Lissage exponentiel simple
Le lissage exponentiel simple (Single Exponential Smoothing) lisse une série chronologique avec St = alpha·yt + (1 - alpha)·St-1 et prévoit le dernier niveau lissé pour chaque période future. Utilisez-le pour des séries qui oscillent autour d'une valeur stable, sans tendance ni saisonnalité. La série ne doit pas avoir de valeurs manquantes et comporter au moins 4 valeurs. Les résultats sont les valeurs ajustées, les prévisions avec limites de prévision, et MAPE, MAD et MSD.
Dernière révision
Point clé
Le lissage exponentiel simple lisse une série chronologique avec un seul niveau, mis à jour à chaque période d'une fraction (alpha) de la dernière erreur, et prévoit ce niveau ; il convient aux séries sans tendance ni saisonnalité.
Sur cette page
Objectif
Le lissage exponentiel simple (Single Exponential Smoothing) lisse une série chronologique avec un seul niveau courant, mis à jour à chaque période d'une fraction de la dernière erreur, et prévoit ce niveau pour chaque période future. Il convient à une série qui oscille autour d'une valeur assez stable, sans tendance ni saisonnalité nettes, comme la demande hebdomadaire d'une pièce de rechange en fin de cycle de vie, un taux de rebut quotidien ou le poids de remplissage d'une ligne stable. Pour des données avec tendance, utilisez le lissage exponentiel double ; pour des données avec saisonnalité, utilisez la méthode de Winters ou la décomposition.
Principales fonctionnalités
- Poids de lissage (alpha) que vous spécifiez, ou poids optimal issu d'un ajustement ARIMA(0,1,1) lorsqu'il est laissé vide.
- Valeur de départ issue des données ou saisie par vos soins.
- Prévisions avec limites de prévision au niveau de confiance de votre choix, à partir de la fin de la série ou d'une ligne antérieure pour tester la méthode sur des données connues.
- Mesures de précision MAPE, MAD et MSD, et graphique des données, des valeurs ajustées et des prévisions.
- Tableau de résultats facultatif (valeur lissée, prédiction et erreur pour chaque période) et graphiques des résidus quatre-en-un.
Méthodes statistiques
La valeur lissée est Sₜ = α·yₜ + (1 − α)·Sₜ₋₁. La valeur ajustée (prédiction à un pas) pour la période t est Sₜ₋₁, la valeur lissée à la fin de la période précédente, et l'erreur est yₜ moins cette valeur ajustée. Un petit α (p. ex. 0.1–0.3) donne une courbe lisse qui réagit lentement ; un grand α suit de près les dernières valeurs.
Avec un poids spécifié, la valeur de départ S₀ est la moyenne des K premières observations (K = 6 par défaut). Lorsque le poids est laissé vide, l'outil ajuste un modèle ARIMA(0,1,1) aux différences premières par les moindres carrés et pose α = 1 − θ, où θ est le coefficient MA ; la valeur de départ provient alors de cet ajustement. Cet α optimal peut dépasser 1, ce qui signifie que le niveau réagit de façon excessive à chaque nouvelle valeur ; considérez cela comme un signe que la série a une tendance. Avec Starting values = User-specified, l'Initial level que vous saisissez est utilisé comme S₀.
Toutes les prévisions sont égales à la dernière valeur lissée à l'origine de prévision. Les limites de prévision sont prévision ± z × 1.25 × MAD, où z est le quantile de la loi normale pour le niveau de confiance et MAD est l'erreur absolue moyenne des valeurs ajustées ; elles ont la même largeur pour chaque période à venir. Précision : MAPE = moyenne de |erreur / donnée| × 100, MAD = moyenne de |erreur|, MSD = moyenne de erreur². La série ne doit pas avoir de valeurs manquantes et comporter au moins 4 valeurs.
Champs de saisie et options
Champ | Description |
Variable (Y) | Obligatoire. La série numérique, dans l'ordre chronologique. |
Weight to use in smoothing (alpha) | 0.0001 à 1. Laissez vide pour utiliser le poids optimal ARIMA(0,1,1). |
Starting values | From the data (par défaut) : le poids optimal part de l'ajustement ARIMA ; un poids spécifié part de la moyenne des K premières observations. Ou User-specified. |
Initial level | Utilisé lorsque Starting values est User-specified (alors obligatoire). |
Initial smoothed value: average of first K observations, K = | Par défaut 6. Actif lorsqu'un poids est saisi. |
Number of forecasts | Par défaut 0 (aucune), jusqu'à 1000. |
Confidence level (%) for forecast interval | Par défaut 95. Actif lorsque des prévisions sont demandées. |
Forecast origin (row) | Facultatif, actif lorsque des prévisions sont demandées. Les prévisions commencent après cette ligne, à partir des données jusqu'à celle-ci ; vide = fin de la série. |
Results to display | Summary table (par défaut) ou Summary table and results table. |
Residual plots (four in one) | Décoché par défaut. Droite de probabilité normale, résidus en fonction des valeurs ajustées, histogramme et résidus en fonction de l'ordre. |
Title | Titre des résultats. Par défaut : Single Exponential Smoothing. |
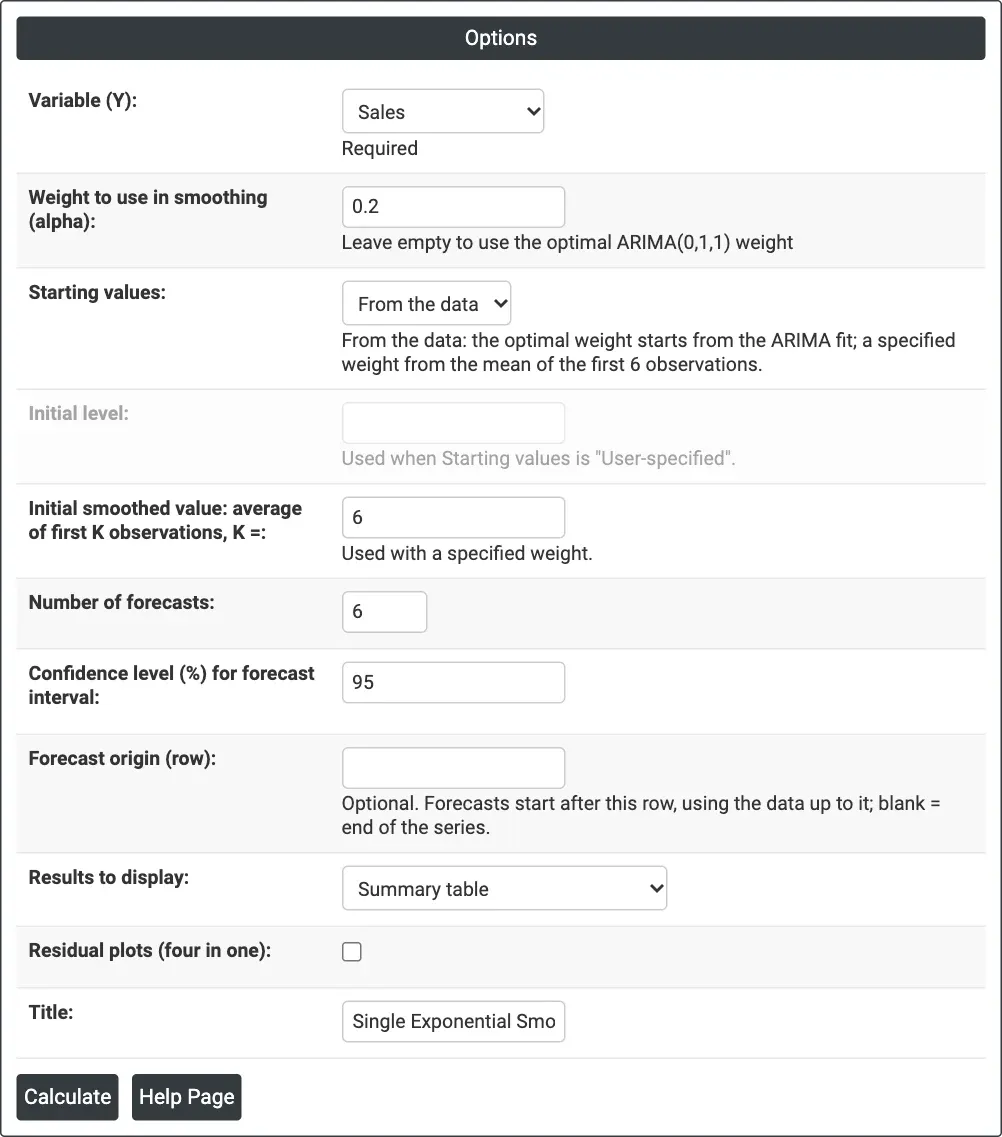
Figure 1 — Monthly Sales lissées avec alpha = 0.2 et six prévisions.
Description des résultats
- Single Exponential Smoothing (graphique) — données réelles, valeurs ajustées, prévisions et bande de prévision, avec MAPE, MAD et MSD dans le titre et le poids utilisé au-dessus du graphique.
- Method — colonne de données, longueur et indication que le poids a été spécifié ou optimal (plus l'origine de prévision lorsqu'elle est définie).
- Smoothing Constants — la valeur de α utilisée.
- Accuracy Measures — MAPE, MAD et MSD.
- Forecasts — période, prévision, limites inférieure et supérieure.
- Results — lorsque choisi : Period, data, Smooth, Predict et Error pour chaque période.
- Residual Plots — lorsque coché.
- Export PDF via Download.
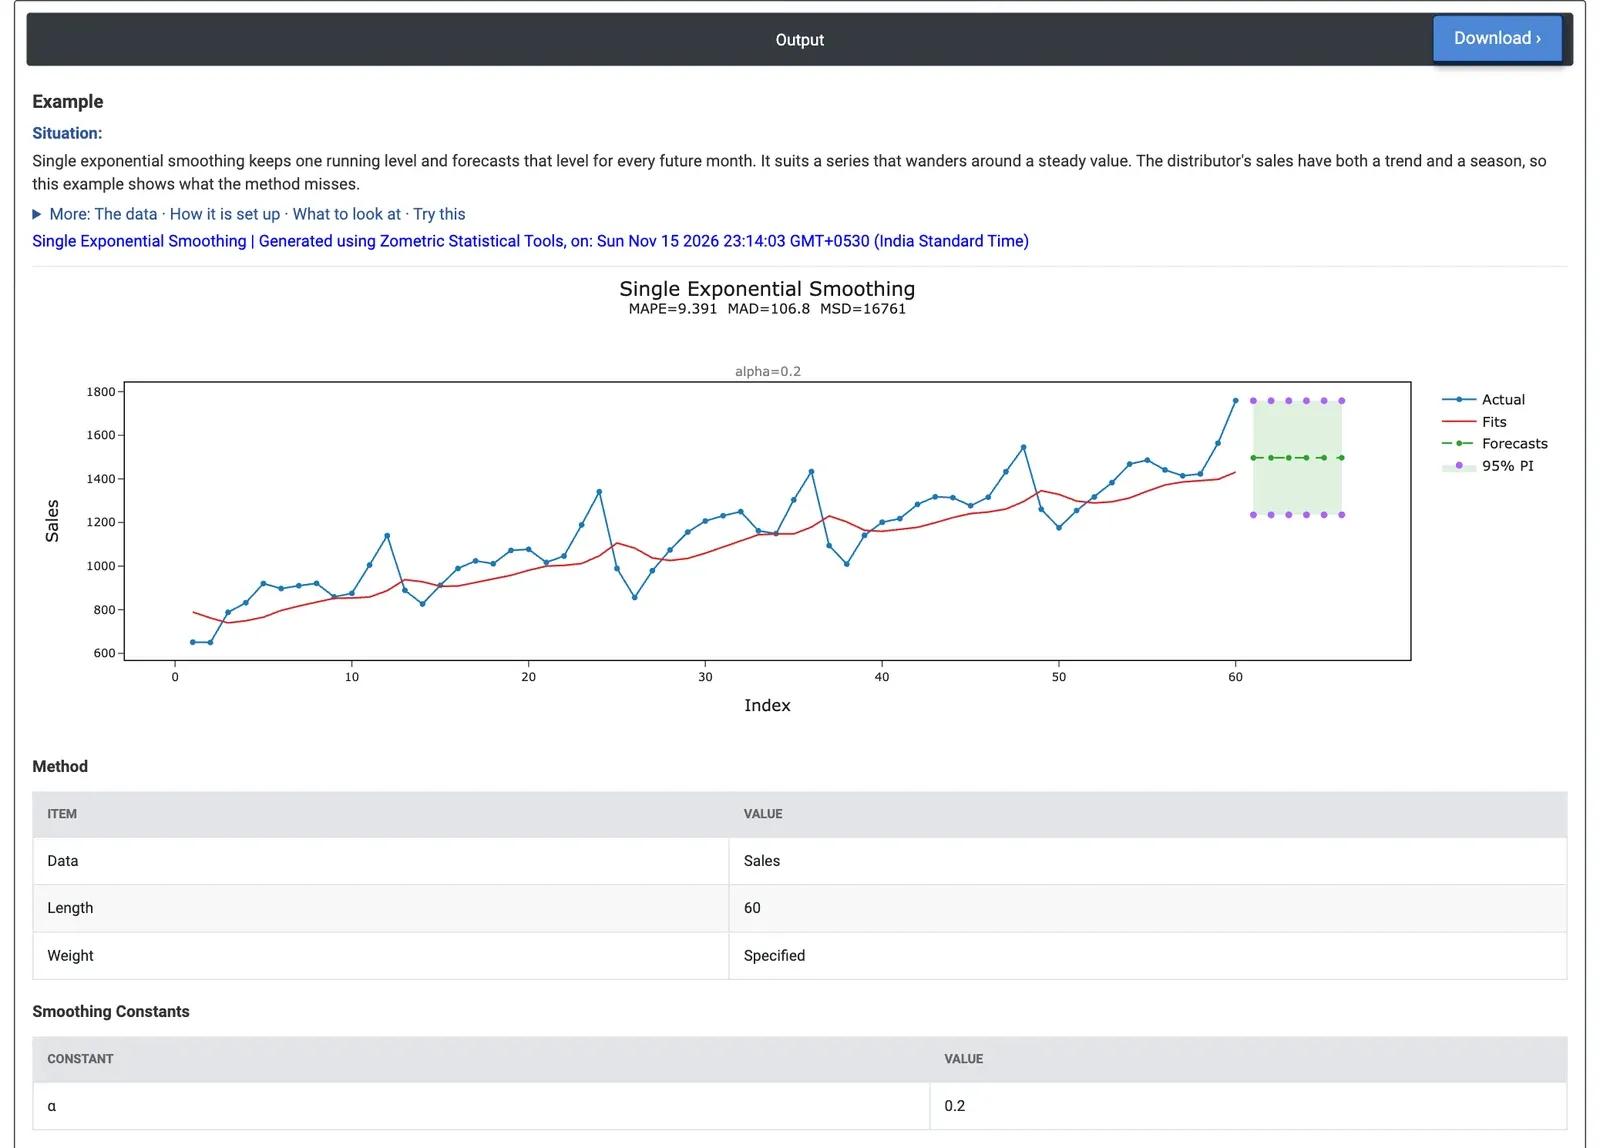
Figure 2 — La courbe lissée est en retard sur la croissance des ventes, et les six prévisions sont identiques, 1,496.7.
Exemple résolu
Un distributeur d'électronique grand public dispose de 60 mois de ventes unitaires (de janvier 2020 à décembre 2024). L'analyste des ventes essaie d'abord la méthode de prévision la plus simple pour voir ce qu'elle manque. Il sélectionne Variable (Y) = Sales, saisit Weight to use in smoothing (alpha) = 0.2, conserve Starting values = From the data et K = 6, et définit Number of forecasts = 6 pour janvier à juin 2025.
Les six prévisions sont identiques : 1,496.7 unités, avec un intervalle à 95 % de 1,234.9 à 1,758.4. La méthode n'a ni tendance ni saisonnalité ; elle ne peut donc pas voir que les ventes augmentent et que janvier et février sont toujours faibles. Sur le graphique, la courbe lissée est en retard sur les données en hausse et coupe les pics et les creux. Le MAPE est de 9.4 % (MAD 106.8 unités), l'ajustement le plus faible des outils de prévision sur ces données : la méthode de Winters atteint 4.2 % et la décomposition 2.2 %.
Lorsque alpha est laissé vide, le poids ARIMA optimal est de 1.43, supérieur à 1 : le niveau réagit de façon excessive à chaque mois pour tenter de suivre la croissance. Le MAPE tombe à 6.7 %, mais chaque mois de 2025 est alors prévu à 1,817, le niveau laissé par le pic de décembre. Les deux résultats disent la même chose pour la décision : cette série a besoin d'une méthode avec tendance et saisonnalité. Le lissage simple n'est l'outil adapté que lorsque les données n'ont ni l'une ni l'autre.
Questions fréquentes
Quand faut-il utiliser le lissage exponentiel simple ?
Utilisez le lissage exponentiel simple pour une série qui oscille autour d'une valeur assez stable, sans tendance ni saisonnalité nettes, comme la demande hebdomadaire d'une pièce de rechange en fin de cycle de vie, un taux de rebut quotidien ou le poids de remplissage d'une ligne stable. Pour des données avec tendance, utilisez le lissage exponentiel double ; pour des données avec saisonnalité, utilisez la méthode de Winters ou la décomposition.
Comment choisir le poids de lissage alpha ?
Un petit alpha, comme 0.1 à 0.3, donne une courbe lisse qui réagit lentement, tandis qu'un grand alpha suit de près les dernières valeurs. Si alpha est laissé vide, le poids optimal provient d'un ajustement ARIMA(0,1,1), avec alpha = 1 moins le coefficient MA. Un alpha optimal supérieur à 1 est un signe que la série a une tendance.
Pourquoi toutes les prévisions du lissage exponentiel simple sont-elles identiques ?
Toutes les prévisions sont égales à la dernière valeur lissée à l'origine de prévision, car la méthode n'a qu'un niveau et aucune composante de tendance ou de saisonnalité. Les limites de prévision valent la prévision plus ou moins z fois 1.25 fois MAD ; elles ont donc aussi la même largeur pour chaque période à venir.
Comment la précision des prévisions est-elle mesurée ?
La précision est donnée par trois mesures fondées sur les erreurs entre les données et les valeurs ajustées à un pas : MAPE, l'erreur absolue moyenne en pourcentage ; MAD, l'erreur absolue moyenne ; et MSD, l'erreur quadratique moyenne. Des valeurs plus faibles indiquent un ajustement plus proche, et elles permettent de comparer des méthodes de prévision sur les mêmes données.