
Test du taux de Poisson à deux échantillons
Le test du taux de Poisson à deux échantillons compare les taux d'événements entre deux groupes à partir de comptages d'événements indépendants sur une exposition connue. Il estime la différence de taux avec un intervalle de confiance et la teste par une approximation normale et, lorsque la différence hypothétique est 0, par un test binomial exact. Il suppose que les événements surviennent indépendamment à un taux constant. Les données peuvent être résumées, en deux colonnes ou empilées.
Dernière révision
Point clé
Le test du taux de Poisson à deux échantillons compare la fréquence des événements dans deux groupes, comme des défauts par unité ou des arrêts par poste, avec un intervalle de confiance de la différence et un test exact ou normal.
Sur cette page
Objectif
Le test du taux de Poisson à deux échantillons compare les taux d'apparition d'événements dans deux groupes, comme des arrêts par poste entre les équipes de jour et de nuit, des défauts par unité de deux lignes, ou des réclamations par mois avant et après un changement. Il estime la différence entre les deux taux avec un intervalle de confiance et teste si elle diffère de zéro ou d'une autre différence hypothétique. Utilisez-le pour des comptages d'événements indépendants sur une quantité d'exposition connue ; pour des résultats conforme/non conforme, utilisez le test 2 Proportions.
Principales fonctionnalités
- Données sous forme de comptages résumés, de deux colonnes de comptages, ou d'une colonne de comptages avec une colonne d'identifiants d'échantillon.
- Test exact (binomial conditionnel) et approximation normale côte à côte lorsque la différence hypothétique est 0.
- Variance de la différence calculée à partir des taux séparés ou du taux groupé.
- Hypothèses alternatives bilatérale ou unilatérale, avec un intervalle de confiance ou une borne unilatérale pour la différence.
- Durées d'observation différentes pour les deux échantillons, p. ex. des postes de 8 heures et de 12 heures.
Méthodes statistiques
Pour l'échantillon i comportant Nᵢ unités, chacune observée sur une durée tᵢ (Observation length), l'exposition est Tᵢ = Nᵢ·tᵢ et, avec Xᵢ événements au total, le taux est λ̂ᵢ = Xᵢ / Tᵢ. La différence estimée est D = λ̂₁ − λ̂₂, Sample 1 moins Sample 2. Avec des données en deux colonnes ou empilées, Nᵢ est le nombre de comptages non vides de l'échantillon et Xᵢ leur somme.
Approximation normale : z = (D − D₀) / SE, où D₀ est la différence hypothétique. Avec Estimate the rates separately, SE = √(λ̂₁ / T₁ + λ̂₂ / T₂) ; avec Use the pooled estimate of the rates, SE = √[λ̂ₚ(1 / T₁ + 1 / T₂)] avec λ̂ₚ = (X₁ + X₂) / (T₁ + T₂). Lorsque les deux expositions sont égales, les deux méthodes donnent le même SE. La valeur p provient de la distribution normale centrée réduite, et l'intervalle de confiance de la différence est D ± z·SE (ou une borne unilatérale).
Test exact, fourni uniquement lorsque D₀ = 0 : si les taux sont égaux, le comptage X₁ parmi le total X₁ + X₂ suit une distribution binomiale de probabilité T₁ / (T₁ + T₂). Les valeurs p unilatérales sont les queues de la loi binomiale, et la valeur p bilatérale est le double de la plus petite queue. Le test exact est préférable lorsque les comptages sont petits. Les deux méthodes supposent que les événements surviennent indépendamment à un taux constant au sein de chaque groupe.
Champs de saisie et options
Champ | Description |
Data | Summarized data (par défaut), Each sample is in its own column ou Both samples are in one column. |
Sample 1 / Sample 2 | Avec Each sample is in its own column : les deux colonnes de comptages. |
Samples / Sample IDs | Avec Both samples are in one column : la colonne de comptages et la colonne nommant l'échantillon de chaque ligne (exactement deux valeurs distinctes ; la première trouvée est Sample 1). |
Sample 1 sample size / Sample 1 total occurrences / Sample 2 sample size / Sample 2 total occurrences | Avec Summarized data : le nombre d'unités et le nombre total d'événements de chaque échantillon. |
Hypothesized difference | 0 par défaut. La valeur de λ₁ − λ₂ sous l'hypothèse nulle ; le test exact n'est fourni que pour 0. |
Confidence level | 95 par défaut ; de 75 à 100. |
Alternative hypothesis | Difference ≠ hypothesized difference (par défaut), Difference < hypothesized difference ou Difference > hypothesized difference. |
Test method | Estimate the rates separately (par défaut) ou Use the pooled estimate of the rates, pour l'approximation normale. |
Observation length (Sample 1) / Observation length (Sample 2) | 1 par défaut. L'exposition de chaque unité ; Sample 2 utilise la durée de Sample 1 lorsqu'elle est laissée vide. |
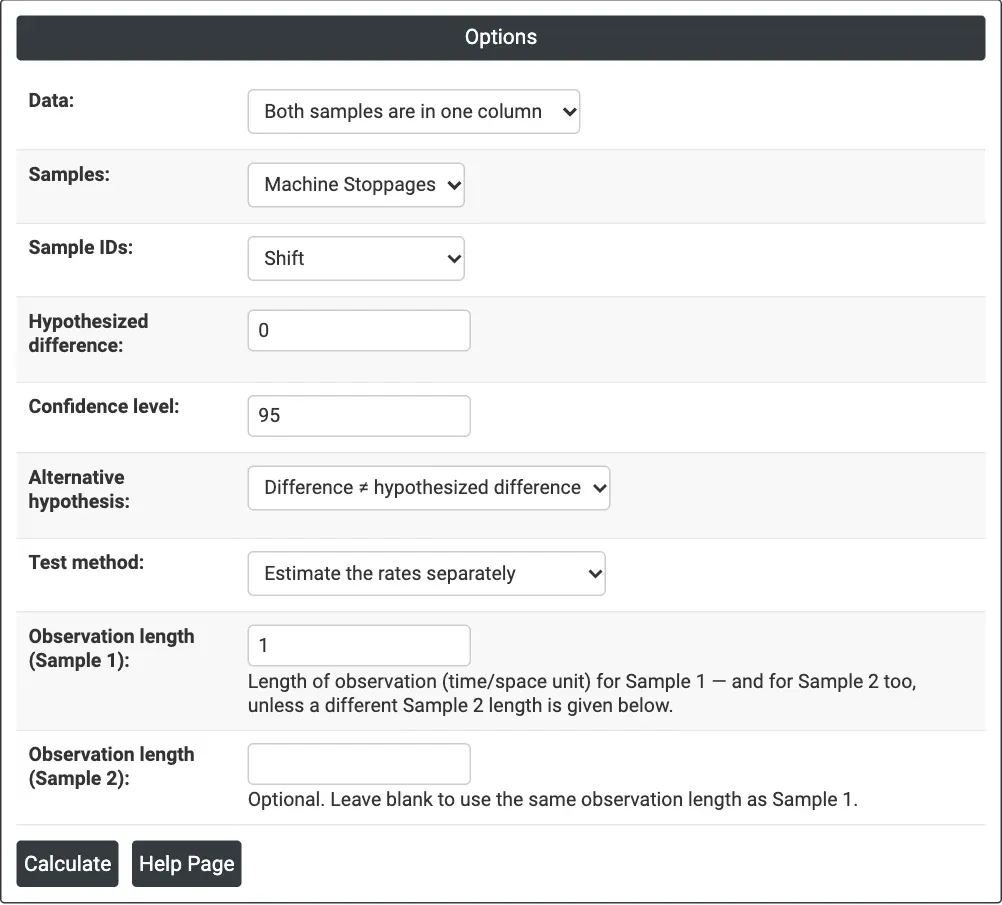
Figure 1 — Options de l'exemple : Machine Stoppages empilés dans une colonne avec Shift comme identifiants d'échantillon, bilatéral, taux estimés séparément.
Description des résultats
- Method — quel échantillon est λ₁ et lequel est λ₂, et la différence λ₁ − λ₂.
- Descriptive Statistics — Sample, N, Total Occurrences et Sample Rate pour chaque échantillon.
- Estimation for Difference — l'Estimated Difference et son intervalle de confiance (ou borne supérieure ou inférieure).
- Test — les hypothèses nulle et alternative, et un tableau avec la Z-Value et la P-Value pour les méthodes Exact et Normal approximation, avec une note lorsque l'estimation groupée est utilisée.
- Export PDF via Download.
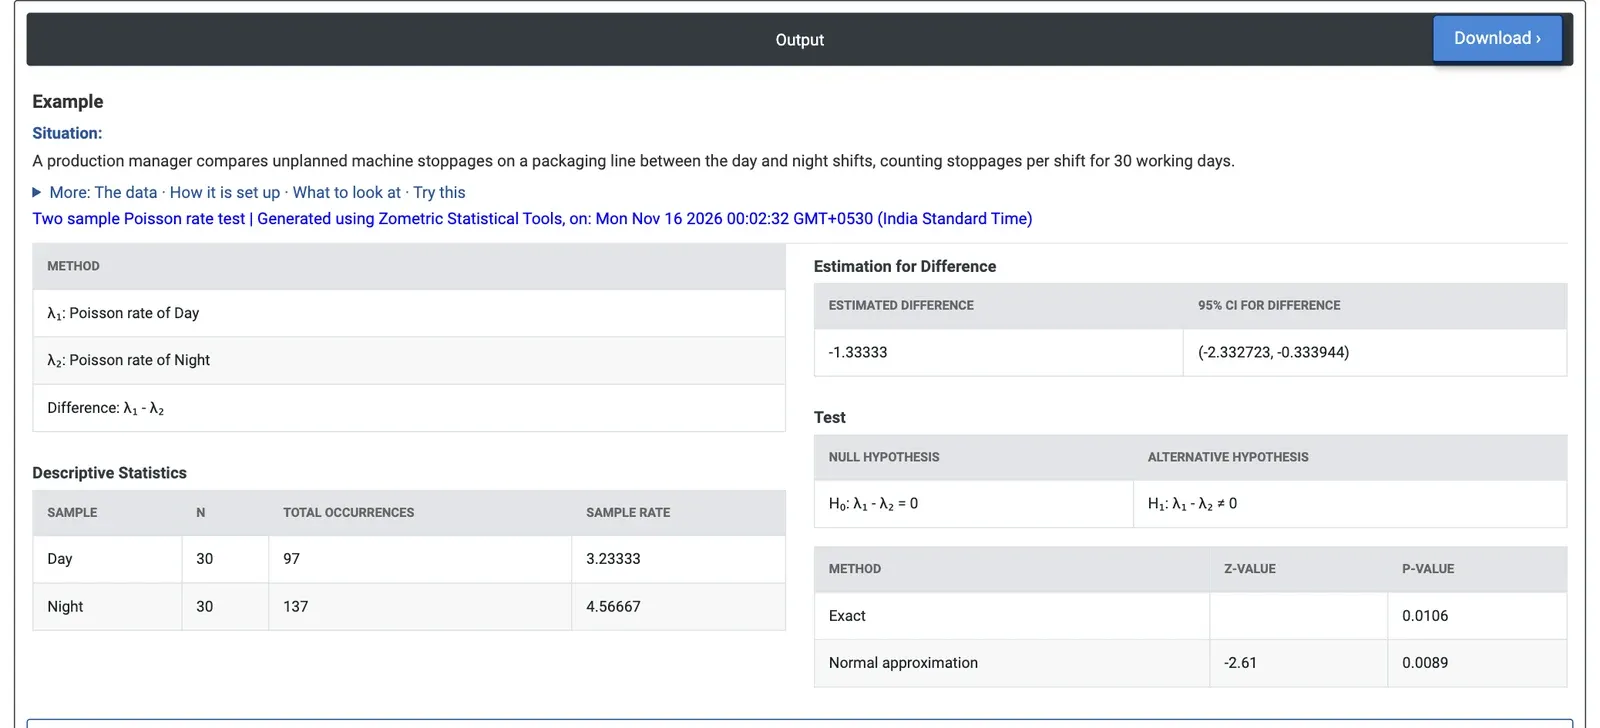
Figure 2 — Les postes de jour comptent en moyenne 3.233 arrêts et les postes de nuit 4.567 ; l'IC à 95% de la différence, de −2.333 à −0.334, exclut 0 (p exacte = 0.0106).
Exemple résolu
Un responsable de production compare les arrêts machine imprévus d'une ligne de conditionnement entre les postes de jour et de nuit, en comptant les arrêts de chaque poste sur 30 jours ouvrés. Data = Both samples are in one column, Samples = Machine Stoppages, Sample IDs = Shift, Hypothesized difference = 0, Confidence level = 95, bilatéral, Test method = Estimate the rates separately, Observation length = 1 (un poste).
Les postes de jour ont eu 97 arrêts en 30 postes, soit un taux de 3.233 par poste, et les postes de nuit 137 en 30 postes, soit 4.567 par poste. La différence estimée, jour moins nuit, est de −1.333 arrêt par poste, avec un IC à 95% de −2.333 à −0.334 : l'intervalle exclut 0. Le test exact donne p = 0.0106 et l'approximation normale z = −2.61, p = 0.0089. Le poste de nuit a plus d'arrêts, environ 40% de plus que le poste de jour.
Comme les deux échantillons couvrent 30 postes, Use the pooled estimate of the rates donne ici le même z et la même valeur p. Si le responsable s'était attendu à ce que le poste de nuit soit pire avant de collecter les données, Difference < hypothesized difference donne p = 0.0053 (exact) et une borne supérieure à 95% de −0.495 pour la différence. L'étape suivante consiste à chercher ce qui diffère la nuit, par exemple les effectifs, les changements de série ou les matières, avant que les arrêts supplémentaires ne coûtent davantage de production.
Questions fréquentes
Quand utiliser un test du taux de Poisson à deux échantillons ?
Utilisez-le pour comparer les taux d'apparition d'événements dans deux groupes, pour des comptages d'événements indépendants sur une quantité d'exposition connue, comme des arrêts par poste entre les équipes de jour et de nuit, des défauts par unité de deux lignes, ou des réclamations par mois avant et après un changement. Pour des résultats conforme/non conforme, utilisez plutôt le test 2 Proportions.
Quelle différence entre le test exact et l'approximation normale ?
Le test exact conditionne sur le comptage total : si les taux sont égaux, le comptage de Sample 1 suit une distribution binomiale dont la probabilité égale sa part de l'exposition totale. Il n'est fourni que lorsque la différence hypothétique est 0 et est préférable lorsque les comptages sont petits. L'approximation normale utilise une statistique z avec une erreur type séparée ou groupée.
Quelles sont les hypothèses du test du taux de Poisson à deux échantillons ?
Les méthodes exacte et normale supposent toutes deux que les événements surviennent indépendamment à un taux constant au sein de chaque groupe. Le taux de chaque échantillon est son nombre total d'événements divisé par son exposition, le nombre d'unités multiplié par la durée d'observation ; les deux échantillons peuvent donc avoir des durées d'observation différentes, comme des postes de 8 heures et de 12 heures.
Comment interpréter les résultats du test du taux de Poisson à deux échantillons ?
Le résultat donne le taux de chaque échantillon, la différence estimée, Sample 1 moins Sample 2, avec son intervalle de confiance, et les valeurs p des méthodes exacte et normale. Si l'intervalle de confiance de la différence exclut 0 et que la valeur p est petite, les deux taux d'événements diffèrent.