
Test t à deux échantillons
Le test t à deux échantillons compare les moyennes de deux groupes indépendants avec une réponse continue, comme deux machines, fournisseurs ou réglages de procédé. Chaque groupe doit suivre approximativement une distribution normale ou compter au moins 30 observations, sans appariement entre groupes ni valeurs aberrantes évidentes. Vous choisissez un test groupé (variances égales) ou le test de Welch. Les résultats incluent la valeur p et un intervalle de confiance pour la différence des moyennes.
Dernière révision
Point clé
Le test t à deux échantillons détermine si les moyennes de deux groupes indépendants, comme deux machines ou deux fournisseurs, diffèrent significativement ou si l'écart observé est dû à la variation aléatoire.
Sur cette page
Qu'est-ce que le test t à deux échantillons ?
Le test t à deux échantillons est une méthode statistique qui permet de déterminer si les moyennes de deux groupes indépendants diffèrent significativement l'une de l'autre. Il compare les valeurs moyennes de deux populations ou conditions de procédé distinctes et calcule la probabilité que l'écart observé soit dû au hasard plutôt qu'à une différence réelle sous-jacente.
Vous pouvez par exemple l'utiliser pour comparer la production moyenne de la machine A et celle de la machine B, ou le temps de réponse moyen avant et après une modification du procédé — lorsque les deux groupes n'ont aucun lien entre eux.
Définition simple : un test qui vous indique si deux groupes indépendants ont réellement des moyennes différentes, ou si l'écart constaté est simplement dû à la variation aléatoire des données.
Quand utiliser le test t à deux échantillons ?
- Utilisez-le lorsque vous disposez de deux groupes indépendants, sans lien entre eux, et que vous voulez comparer leurs moyennes — par exemple deux machines, deux fournisseurs ou deux réglages de procédé.
- Utilisez-le lorsque la variable de réponse est continue — mesures, masses, températures ou dimensions, par exemple.
- Utilisez-le lorsque les deux groupes sont mesurés séparément , sans appariement ni correspondance entre observations individuelles.
- Utilisez-le lorsque vous voulez déterminer si une modification du procédé, un changement de matière ou une différence opérationnelle a entraîné un décalage significatif du résultat moyen.
Recommandations pour bien utiliser le test t à deux échantillons
- Les données de chaque groupe doivent suivre approximativement une distribution normale, ou chaque groupe doit compter au moins 30 observations pour que le théorème central limite s'applique.
- Les deux groupes doivent être indépendants — aucune observation d'un groupe ne doit être liée ou appariée à une observation de l'autre groupe.
- Vérifiez si les deux groupes ont des variances égales ou inégales avant d'effectuer le test — utilisez pour cela un test F ou le test de Levene, car cela détermine la version du test t à appliquer.
- Recueillez une effectif de l'échantillon suffisant dans chaque groupe — au moins 20 à 30 observations par groupe sont recommandées pour des résultats fiables.
- Fixez le seuil de signification (alpha) avant de recueillir les données — la valeur par défaut usuelle est 0.05, soit un risque de 5 % de conclure à une différence qui n'existe pas.
- Vérifiez que les données sont exemptes de valeurs aberrantes évidentes — les valeurs extrêmes peuvent fausser la moyenne et gonfler ou réduire le résultat du test.
Alternatives : quand ne pas utiliser le test t à deux échantillons
- Si les deux groupes sont appariés ou mis en correspondance (par ex. mesures avant et après sur le même sujet), utilisez le test t apparié
- Si vous comparez plus de deux groupes, utilisez l' ANOVA à un facteur
- Si l'objectif est de prouver que deux groupes sont pratiquement équivalents plutôt que différents, utilisez le test d'équivalence à deux échantillons
- Si les données sont fortement non normales et les échantillons de petite taille, utilisez plutôt le test de Mann-Whitney (une alternative non paramétrique).
- Si vous ne disposez que de données résumées (moyenne, écart-type, n) plutôt que des observations brutes, utilisez le test t à deux échantillons (résumé)
Comment réaliser un test t à deux échantillons
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Hypothesis Test >Two sample t test .
- Ensuite, saisissez les données manuellement, ou copiez (Ctrl+C) l'ensemble des données d'une feuille Excel et collez-les (Ctrl+V) ici.
- Ensuite, saisissez les valeurs du niveau de confiance et de la différence hypothétique.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Dans le tableau de bord du test t à deux échantillons, la fenêtre est divisée en deux parties.
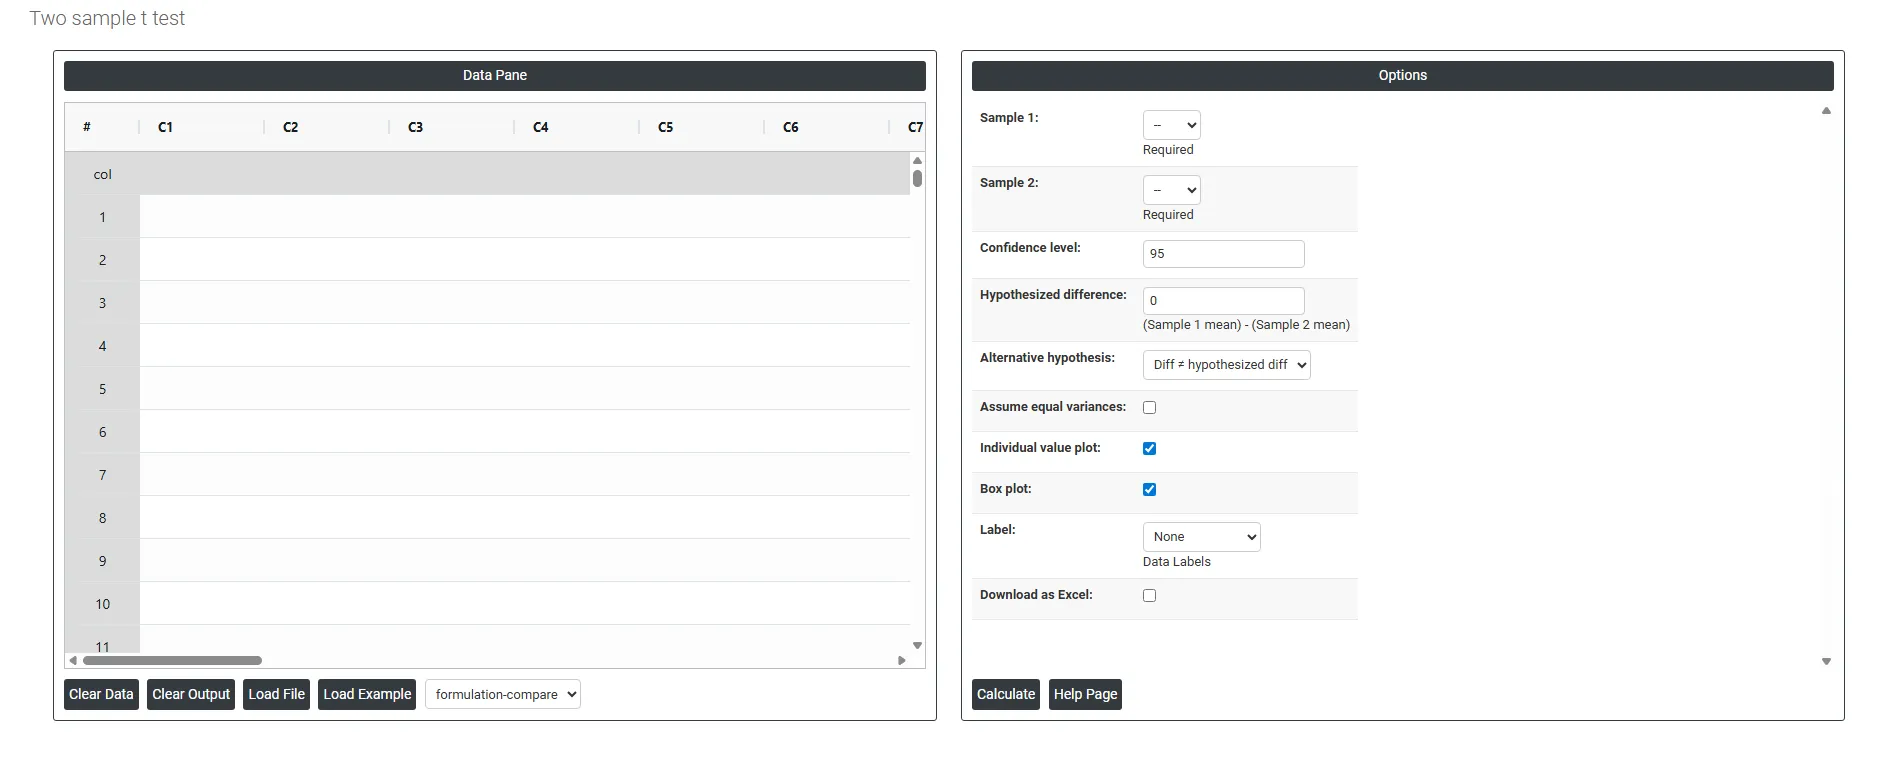
La partie gauche contient le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement, ou vous pouvez copier (Ctrl+C) l'ensemble des données d'une feuille Excel et les coller (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File : permet de charger directement les données Excel.
La partie droite contient de nombreuses options, décrites ci-dessous :
- Sample 1 : sélectionnez la colonne contenant les données du premier groupe à comparer — par exemple les mesures de la machine A, du fournisseur 1 ou de la formulation A. Ce champ est obligatoire et doit contenir des valeurs numériques continues.
- Sample 2 : sélectionnez la colonne contenant les données du second groupe — par exemple les mesures de la machine B, du fournisseur 2 ou de la formulation B. Ce champ est également obligatoire et doit être indépendant de Sample 1, c'est-à-dire sans appariement ni correspondance entre observations individuelles des deux jeux de données.
- Confidence Level : définit le niveau de certitude de l'intervalle de confiance calculé autour de la différence entre les deux moyennes. La valeur par défaut usuelle est 95%, ce qui signifie que vous êtes confiant à 95 % que la vraie différence entre les moyennes des deux groupes se trouve dans l'intervalle affiché. Un niveau de confiance plus élevé (par ex. 99 %) donne un intervalle plus large ; un niveau plus faible (par ex. 90 %) donne un intervalle plus étroit.
- Hypothesized Difference : la valeur testée — elle représente la différence attendue ou supposée entre les moyennes des deux groupes (moyenne de Sample 1 moins moyenne de Sample 2). La fixer à 0 teste si les deux moyennes sont égales. Toute autre valeur teste si la différence est égale à ce montant précis — par exemple, saisir 5 teste si la moyenne du groupe 1 dépasse exactement de 5 unités celle du groupe 2.
- Alternative Hypothesis ; définit le sens du test — ce que vous cherchez à démontrer au sujet de la différence entre les deux moyennes. Trois options sont proposées :
- Diff ≠ Hypothesized Diff — test bilatéral qui vérifie si la différence est simplement différente de la valeur hypothétique, dans un sens ou dans l'autre. À utiliser lorsque vous n'avez pas d'attente préalable sur le groupe qui sera le plus grand.
- Diff < Hypothesized Diff — test unilatéral qui vérifie si la différence réelle est inférieure à la valeur hypothétique. À utiliser lorsque vous vous attendez précisément à ce que Sample 1 soit inférieur à Sample 2.
- Diff > Hypothesized Diff — test unilatéral qui vérifie si la différence réelle est supérieure à la valeur hypothétique. À utiliser lorsque vous vous attendez précisément à ce que Sample 1 soit supérieur à Sample 2.
- Assume Equal Variances : lorsque cette case est cochée, le test suppose que les deux groupes ont la même variance de population sous-jacente et utilise un écart-type groupé pour calculer la statistique de test — ce qui donne un test légèrement plus puissant lorsque l'hypothèse est vérifiée. Lorsqu'elle est décochée, le test utilise des estimations de variance distinctes pour chaque groupe (test t de Welch), plus fiable lorsque les deux groupes ont des dispersions nettement différentes. En cas de doute, laissez-la décochée : c'est l'approche la plus sûre et la plus prudente.
- Individual Value Plot : lorsque cette option est activée, affiche un graphique présentant côte à côte chaque point de données des deux groupes. Il donne une vue claire de la distribution complète des données, de leur dispersion et des valeurs inhabituelles, ce qui permet d'évaluer visuellement plus facilement si les deux groupes diffèrent et s'il existe des valeurs aberrantes.
- Box Plot : lorsque cette option est activée, affiche une boîte à moustaches pour chaque groupe, qui résume la médiane, l'écart interquartile et la dispersion globale. Les boîtes à moustaches permettent de comparer d'un coup d'œil la position centrale et la variabilité des deux groupes, et de repérer une asymétrie ou des valeurs aberrantes susceptibles d'influencer les résultats du test.
- Label : détermine les informations supplémentaires affichées sur l'Individual Value Plot ou le Box Plot. Les options sont les suivantes :
- None — aucune étiquette supplémentaire sur le graphique
- Outliers — met en évidence uniquement les points de données statistiquement extrêmes
- Individual Data — étiquette chaque point de données tracé
- All Quartiles — affiche les valeurs de Q1, de la médiane et de Q3
- Means — marque la moyenne de chaque groupe sur le graphique
- Data Labels — affiche les valeurs réelles des points tracés
- Download as Excel : exporte les résultats du test, les statistiques descriptives, les intervalles de confiance et la valeur p dans un fichier Excel. C'est utile pour intégrer les résultats à des rapports, les partager avec des collègues ou conserver une trace formelle de l'analyse.
Questions fréquentes
Qu'est-ce qu'un test t à deux échantillons ?
Un test t à deux échantillons détermine si les moyennes de deux groupes indépendants diffèrent significativement. Il compare les moyennes de deux populations ou conditions de procédé distinctes, comme la machine A et la machine B, et calcule la probabilité que l'écart observé soit dû au hasard plutôt qu'à une différence réelle sous-jacente.
Quelles sont les hypothèses d'application du test t à deux échantillons ?
La réponse doit être continue, les deux groupes doivent être indépendants et sans appariement, et chaque groupe doit suivre approximativement une distribution normale ou compter au moins 30 observations pour que le théorème central limite s'applique. Les données doivent être exemptes de valeurs aberrantes évidentes, et au moins 20 à 30 observations par groupe sont recommandées.
Faut-il supposer des variances égales dans un test t à deux échantillons ?
Si les groupes ont la même variance, un écart-type groupé donne un test légèrement plus puissant. Sinon, le test t de Welch utilise des estimations de variance distinctes et est plus fiable lorsque les dispersions diffèrent. Vérifiez-le avec un test F ou le test de Levene ; en cas de doute, laissez Assume Equal Variances décoché, c'est le choix le plus sûr.
Quand ne pas utiliser un test t à deux échantillons ?
Utilisez un test t apparié pour des données appariées ou des mesures avant/après sur les mêmes sujets, l'ANOVA à un facteur pour plus de deux groupes, un test d'équivalence à deux échantillons pour prouver que des groupes sont pratiquement équivalents, et le test de Mann-Whitney lorsque les données sont fortement non normales et les échantillons petits. Si vous ne disposez que de données résumées, utilisez la version résumée.