
Xbar-S-kaart
De Xbar-S-kaart bewaakt zowel het procesgemiddelde als de procesvariatie voor continue gegevens die in rationele subgroepen van 9 of meer waarnemingen zijn verzameld. Gebruik een Xbar-R-kaart voor subgroepen van 2 tot 8 en een I-MR-kaart zonder subgroepen. Verzamel ten minste 60 waarnemingen in tijdsvolgorde. Sigma wordt geschat met de Sbar-methode of de methode van de gepoolde standaardafwijking, en toetsregels signaleren speciale oorzaken.
Laatst beoordeeld
Belangrijkste conclusie
Een Xbar-S-kaart is een paar regelkaarten voor continue gegevens in subgroepen van 9 of meer: de Xbar-kaart volgt de subgroepgemiddelden en de S-kaart de standaardafwijkingen van de subgroepen in de tijd.
Op deze pagina
Wat is een Xbar-S-kaart?
De Xbar-S-kaart is een geavanceerd statistisch beheersingsinstrument om het gemiddelde en de variatie van een proces te bewaken bij continue gegevens en een subgroepgrootte van negen of meer. De kaart bestaat uit twee kernonderdelen: de Xbar-kaart, die de gemiddelde waarden in de tijd volgt om verschuivingen in het procesgemiddelde te herkennen, en de S-kaart, die de standaardafwijking in de tijd weergeeft om veranderingen in de procesvariatie op te sporen.
Xbar-S-kaarten zijn bijzonder geschikt voor grotere steekproeven en geven een nauwkeuriger beeld van de spreiding van de gegevens dan kaarten op basis van de spreidingsbreedte. Ze worden veel gebruikt in kwaliteitsbeheersing en procesverbetering om de processtabiliteit te waarborgen en mogelijke problemen snel te herkennen en aan te pakken. Doordat de Xbar-S-kaart variaties en trends in procesgegevens zichtbaar maakt, speelt hij een cruciale rol bij het behouden en verbeteren van de algehele procesprestatie.
Wanneer gebruikt u een Xbar-S-kaart?
- Rationele subgroepvorming: Wanneer u metingen logisch in groepen (subgroepen) kunt verzamelen, die elk een "momentopname" van het proces op bepaalde tijdstippen vormen.
- Gegevens in tijdsvolgorde: Wanneer uw gegevens in tijdsvolgorde staan, dat wil zeggen ingevoerd in de volgorde waarin ze zijn ontstaan, zodat trends of verschuivingen in het proces nauwkeurig worden opgespoord.
- Subgroepgrootte van negen of meer: kies X-bar- en S-kaarten bij een subgroepgrootte van negen of meer, omdat de spreidingsbreedte een minder efficiënte schatter van de processigma wordt naarmate de subgroepen groter worden. De standaardafwijking van de subgroep geeft een betere schatting van de variatie dan de spreidingsbreedte van de subgroep.
- Continue en normaal verdeelde gegevens: Wanneer de verzamelde gegevens continu en normaal verdeeld zijn.
- Detectie van grote verschuivingen: Wanneer u relatief grote verschuivingen in het procesgemiddelde moet opsporen, doorgaans verschuivingen van ±1.5 sigma of groter. X-bar- en S-kaarten zijn hiervoor efficiënt.
- Grotere gevoeligheid: Voor een grotere gevoeligheid voor verschuivingen, vooral bij grotere subgroepen, zijn X-bar- en S-kaarten effectiever, mits een rationele subgroep kan worden gevormd.
- Instabiele processen: Wanneer het proces niet stabiel is, dat wil zeggen dat het procesgemiddelde en de standaardafwijking niet bekend zijn of in de tijd veranderen.
- Toepassingen in de industrie: Geschikt voor productie, gezondheidszorg, financiële dienstverlening en andere sectoren waar kwaliteitsbeheersing van processen belangrijk is.
Als de subgroepgrootte één is, overweeg dan voor een passendere bewaking een kaart voor individuele waarden en voortschrijdende spreidingsbreedte (Individual-X / Moving Range), een EWMA- of een CUSUM-kaart. Voor meer gevoeligheid voor kleinere procesverschuivingen worden EWMA- of CUSUM-kaarten aanbevolen.
Richtlijnen voor correct gebruik van de Xbar-S-kaart
- Gebruik regelkaarten voor attributen, zoals de P-kaart of de U-kaart, voor aantallen defecte eenheden of defecten.
- Voer de gegevens in tijdsvolgorde in om veranderingen in de tijd op te sporen.
- Verzamel gegevens met gelijke tijdsintervallen om veranderingen snel na het optreden te herkennen.
- Gebruik rationele subgroepen die de output van het proces representeren.
- Gebruik de Xbar-R-kaart voor subgroepen met 2-8 waarnemingen; gebruik de Xbar-S-kaart voor subgroepen met 9 of meer waarnemingen; gebruik de I-MR-kaart als u geen subgroepen hebt.
- Verzamel in totaal ten minste 60 waarnemingen voor betrouwbare resultaten.
- Niet-normale gegevens kunnen met subgroepen van geschikte grootte toch goede resultaten geven.
- Vermijd gecorreleerde waarnemingen binnen subgroepen om nauwkeurige regelgrenzen te verkrijgen.
Alternatieven: wanneer u geen Xbar-S-kaart gebruikt
- Als uw subgroepen 2-8 waarnemingen bevatten, kunt u het best de Xbar-R-kaartgebruiken.
- Als er binnen de subgroepen een constante bron van variatie is, is de I-MR-R/S-kaart geschikter.
- Als er geen subgroepen zijn, gebruik dan de I-MR-kaart.
- Als u met gegevens over defecte eenheden of defecten werkt, wordt een regelkaart voor attributen aanbevolen, zoals de P-kaart of de U-kaart.
Voorbeeld van een Xbar-S-kaart
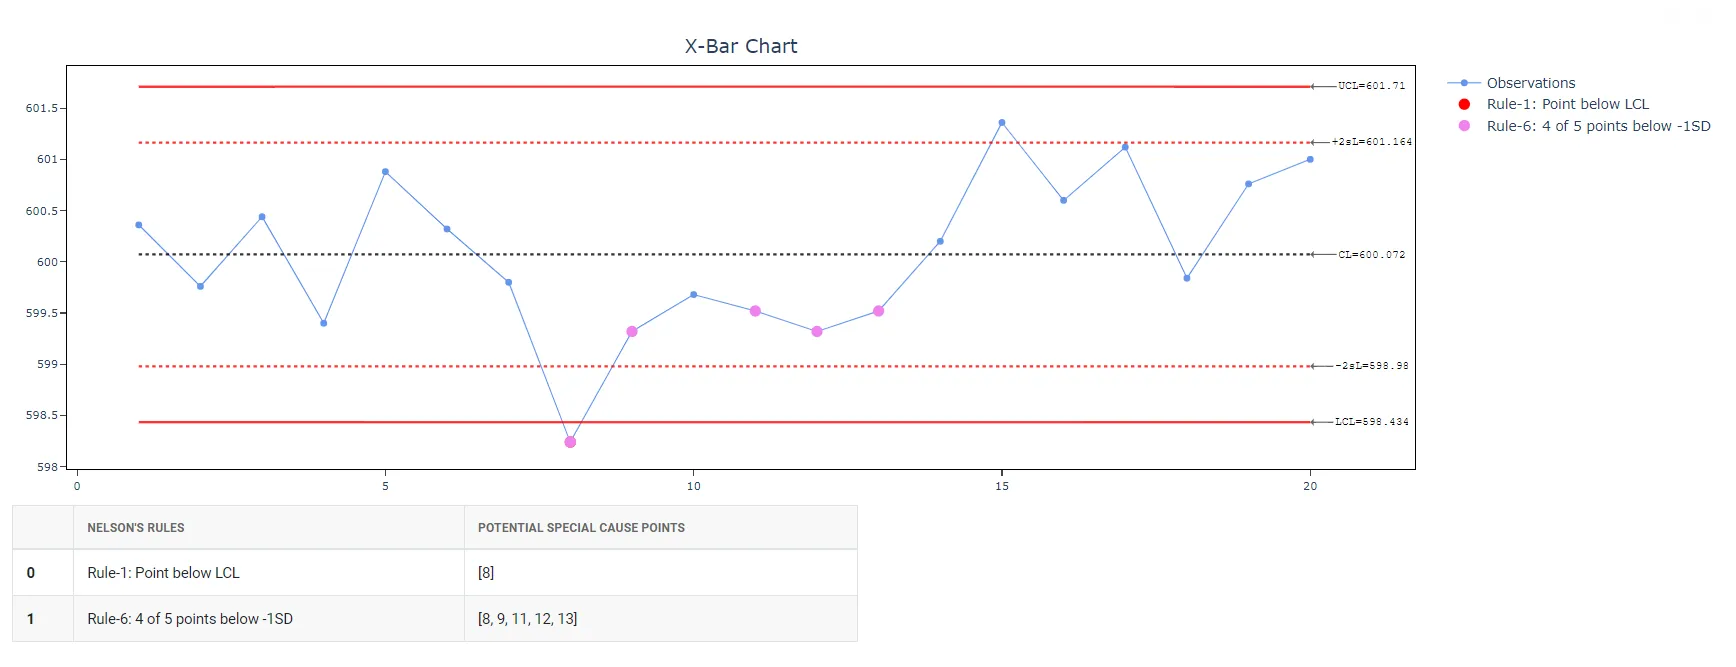
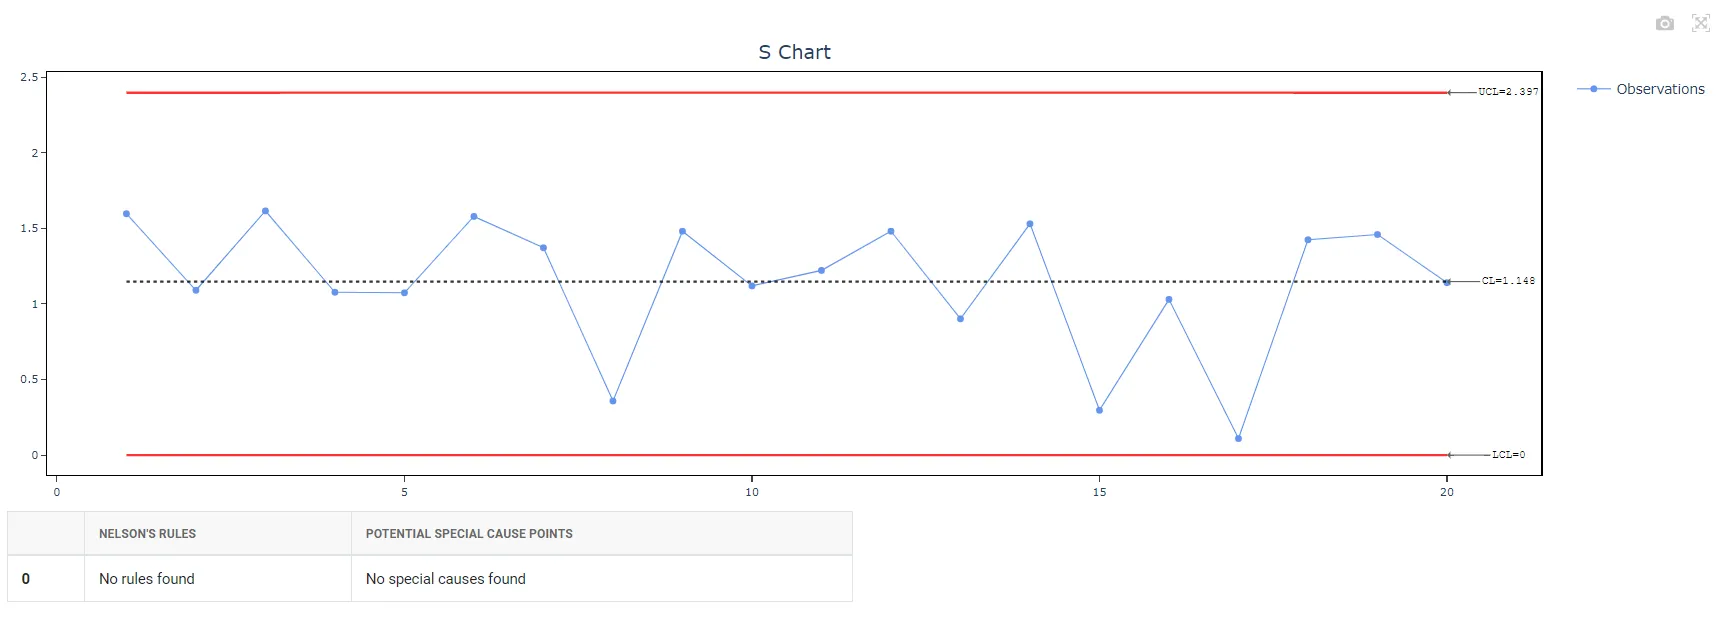
Een kwaliteitsingenieur bewaakt het gewicht van blikken in het vulproces van een conservenbedrijf om te bepalen of het proces onder controle is. De ingenieur neemt elk uur een subgroep van 10 blikken en zorgt dat de blikken binnen een korte tijdspanne worden genomen om de variatie binnen subgroepen te beperken. Om het gewicht te volgen, maakt de kwaliteitsingenieur een Xbar-S-kaart. Zij heeft dit in de volgende stappen gedaan:
- Een hele dag gewerkt en de gewichten van de 10 blikken in elke subgroep per uur vastgelegd.
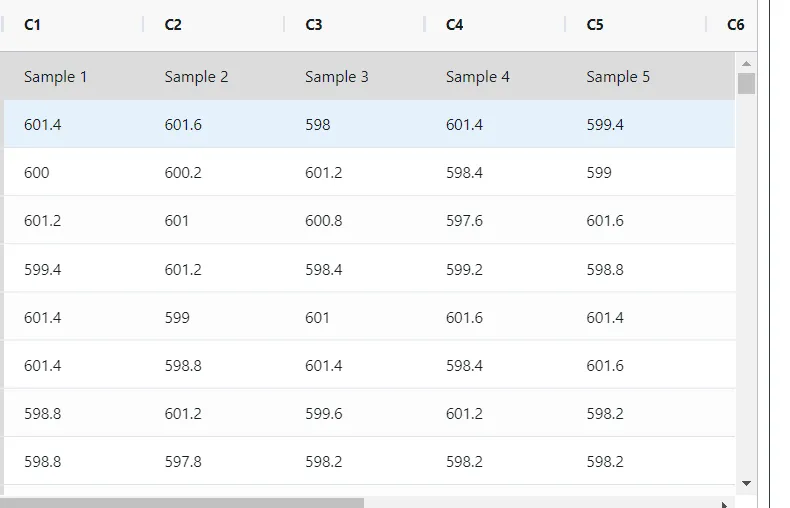
- Nu analyseert zij de gegevens met behulp van https://statsai.zometric.com/
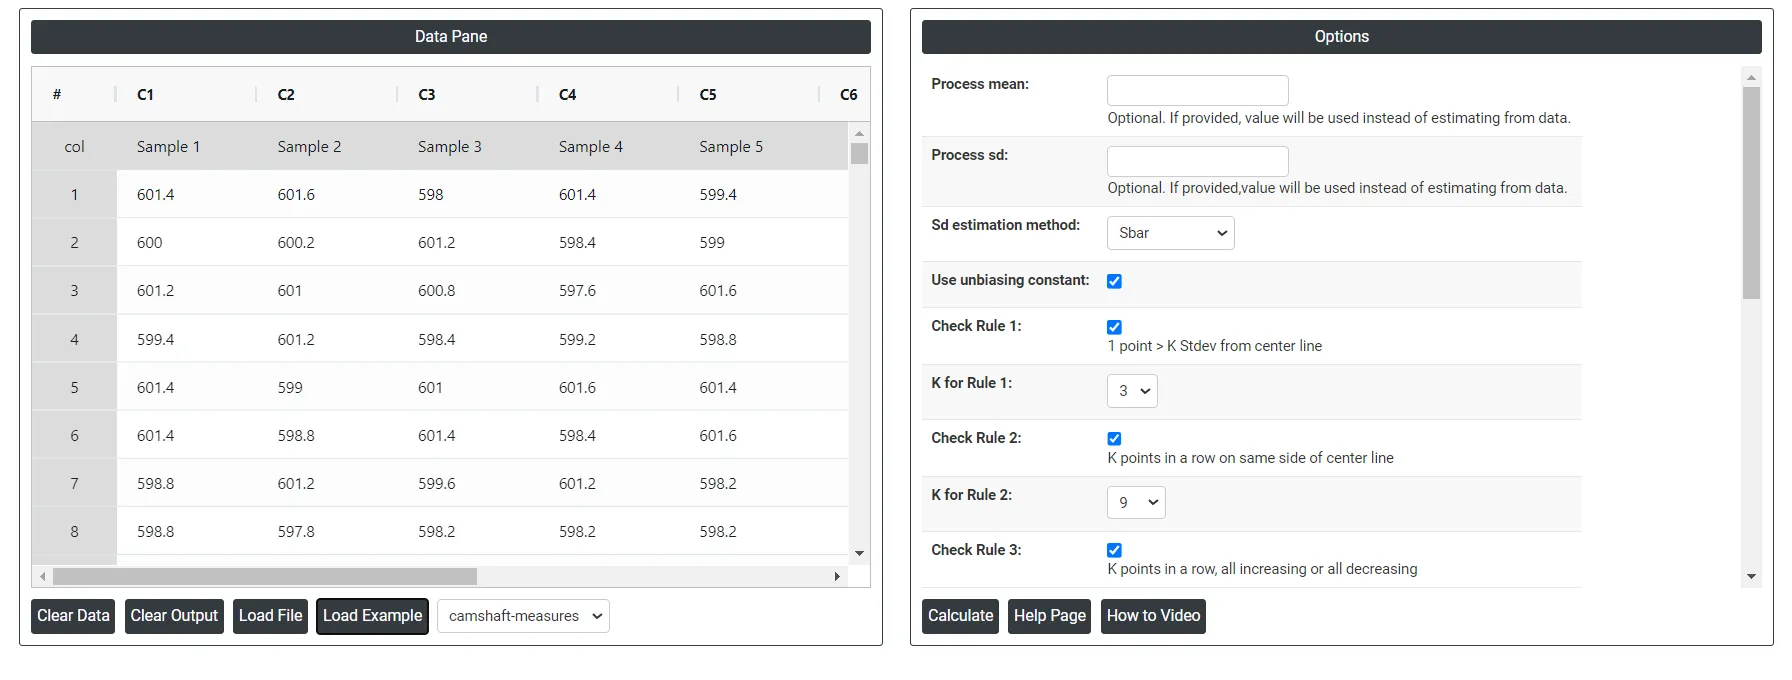
- In de tool voert zij de gegevens in. Daarnaast kiest zij Sbar als Sd estimation method.
- Na gebruik van de bovengenoemde tool worden de bruikbare grafieken als volgt weergegeven:
Zo maakt u een Xbar-S-kaart
De handleiding is als volgt:
- Meld u aan bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Control Charts > Xbar-S Chart.
- Klik op Xbar-S Chart om naar het dashboard te gaan.
- Werk vervolgens de gegevens handmatig bij, of kopieer (Ctrl+C) de gegevens volledig uit een Excel-blad en plak (Ctrl+V) ze, of gebruik de optie Load Example, waarmee de voorbeeldgegevens worden geladen.
- Koppel vervolgens de kolommen aan de parameters.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
Op het dashboard van de Xbar-S-kaart is het venster in twee delen verdeeld.
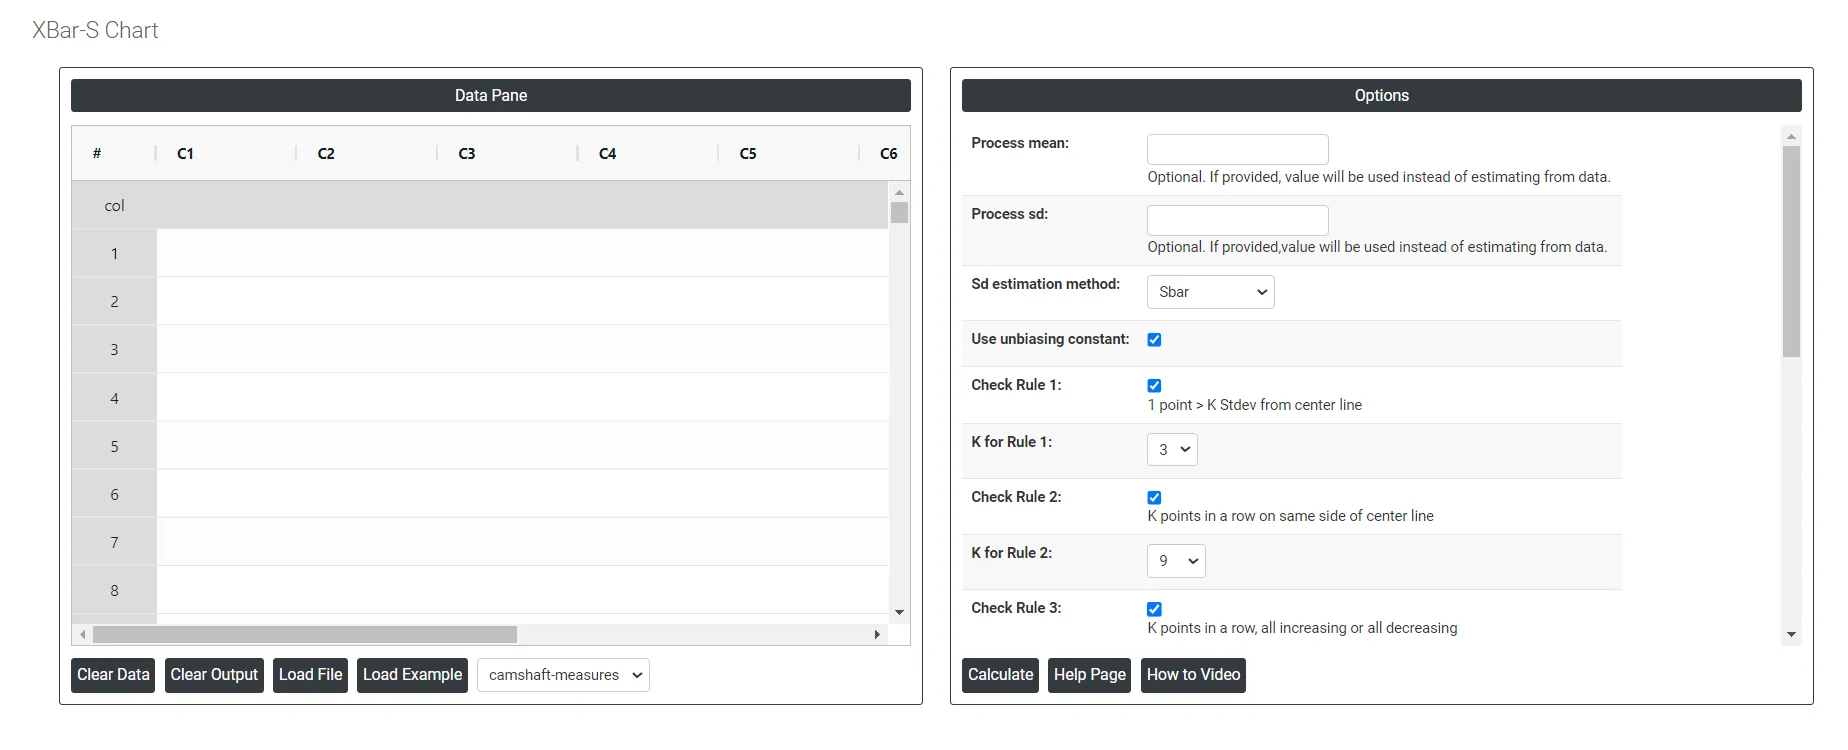
Links bevindt zich het Data Pane. In het Data Pane vormt elke rij één subgroep. Gegevens kunnen handmatig worden ingevoerd, of u kunt de gegevens volledig kopiëren (Ctrl+C) uit een Excel-blad en hier plakken (Ctrl+V).
Load example: De voorbeeldgegevens worden geladen.
Load File: Hiermee laadt u Excel-gegevens rechtstreeks.
Rechts hoeft u alleen het volgende op te geven:
- Process mean: Dit is de gemiddelde waarde van een reeks metingen of waarnemingen uit een proces. Het geeft de centrale tendens van de procesgegevens in de tijd weer en is een belangrijke indicator van de procesprestatie. Zo niet, dan berekent Zometric Statistical Software de middenlijn uit de opgegeven gegevens.
- Process sd: Dit is een maat voor de variatie of spreiding van de procesgegevens rond het gemiddelde. Het geeft aan hoeveel afzonderlijke datapunten in het proces van het procesgemiddelde verschillen. Als u dit veld leeg laat, berekent Zometric Statistical Software de waarde uit de opgegeven gegevens.
- Sd estimation method: Hier heeft de gebruiker twee keuzes voor de berekening. Of u Sbar of de methode van de gepoolde standaardafwijking als schattingsmethode kiest, verandert het resultaat.
- Sbar Sd estimation method: Deze methode berekent de gemiddelde standaardafwijking (Sbar) van de subgroepen om de procesvariatie te bewaken. Sbar is essentieel voor het vaststellen van de regelgrenzen van de S-kaart en geeft veranderingen in de spreiding van de gegevens in de tijd aan. Deze methode zorgt voor een consistente en nauwkeurige beoordeling van de procesvariatie in de kwaliteitsbeheersing.
- Pooled Sd estimation method: De gepoolde standaardafwijking is het gewogen gemiddelde van de subgroepvarianties, waarbij grotere subgroepen meer invloed hebben op de totale schatting. Deze methode geeft een nauwkeurigere schatting van de standaardafwijking wanneer het proces stabiel is.
- Use unbiasing constants for pooled sd: Deze optie is alleen van toepassing wanneer de standaardafwijking wordt geschat met de methode van de gepoolde standaardafwijking (Pooled Stdev).
- Check Rule 1: 1 point > K Stdev from center line: Als een datapunt K standaardafwijkingen van de middenlijn ligt, betekent dit dat het K keer de standaardafwijking van het gemiddelde verwijderd is. Dit is belangrijk in statistische procesbeheersing, omdat het aangeeft of een datapunt binnen aanvaardbare grenzen ligt of dat er mogelijk een probleem met het proces is dat moet worden aangepakt. Doorgaans worden datapunten die meer dan drie standaardafwijkingen van de middenlijn liggen als uitschieters beschouwd en kunnen ze nader onderzoek vereisen.
- Check Rule 2: K points in a row on same side of center line: Als in een dataset K punten op een rij aan dezelfde kant van de middenlijn liggen, wijst dit erop dat het procesgemiddelde mogelijk is verschoven. Dit kan diverse oorzaken hebben, zoals meetfouten, een vertekende steekproeftrekking of een werkelijk onderliggend patroon in de gegevens.
- Check Rule 3: K points in a row, all increasing or all decreasing: Deze toets signaleert een trend of drift in het proces wanneer K punten op een rij aan een van de volgende voorwaarden voldoen:
- De punten stijgen allemaal (d.w.z. elk punt heeft een grotere y-coördinaat dan het voorgaande punt)
- De punten dalen allemaal (d.w.z. elk punt heeft een kleinere y-coördinaat dan het voorgaande punt)
- Check Rule 4: K points in a row, alternating up and down: Als K punten op een rij afwisselend stijgen en dalen in een zaagtandpatroon, is de variatie systematisch en niet willekeurig. Dit kan worden veroorzaakt door bijvoorbeeld overcorrectie van het proces, of door afwisseling tussen twee machines, operators of grondstofbronnen.
- Check Rule 5: K out of K + 1 points > 2 standard deviation from center line (same side): Als K van de K+1 datapunten aan dezelfde kant van de middenlijn liggen en meer dan twee standaardafwijkingen ervan verwijderd zijn, wijst dit erop dat het proces mogelijk buiten controle is en dat speciale oorzaken moeten worden onderzocht om het probleem te vinden en op te lossen.
- Check Rule 6: K out of K + 1 points > 1 standard deviation from center line (same side): Als K van de K+1 opeenvolgende punten aan dezelfde kant meer dan één standaardafwijking van de middenlijn liggen, wijst dit op een mogelijke kleine verschuiving in het procesgemiddelde.
- Check Rule 7: K points in a row within 1 standard deviation of center line (either side): Als K punten op een rij binnen 1 standaardafwijking van de middenlijn liggen, is de variatie kleiner dan de regelgrenzen voorspellen. Dit is geen bewijs van goede beheersing: het wijst vaak op gestratificeerde gegevens of op regelgrenzen die te ruim zijn.
- Check Rule 8: K points in a row > 1 standard deviation from center line (either side): Als K punten op een rij meer dan 1 standaardafwijking van de middenlijn liggen, wijst dit op een mengpatroon, waarbij de punten de middenlijn mijden en dicht bij de regelgrenzen vallen, bijvoorbeeld wanneer gegevens van twee verschillende processtromen zijn gemengd.
Download as Excel: Hiermee wordt het resultaat in Excel-formaat weergegeven, dat u eenvoudig kunt bewerken en met de optie Load File opnieuw kunt laden voor berekeningen.
Formule van de Xbar-S-kaart
In dit deel beschrijven we hoe de regelgrenzen van de Xbar-kaart en de S-kaart worden berekend. Zie eerst de beschrijving van de termen die in de volgende berekeningen worden gebruikt.
TermBeschrijving
x_{ij}
jde waarneming in de ide subgroep
n_i
aantal waarnemingen in subgroep i
\sum x
som van alle afzonderlijke waarnemingen
\sum n
totaal aantal waarnemingen
μ
procesgemiddelde
k
parameter voor toets 1 (standaard is 3)
σ
standaardafwijking van het proces
S_i
standaardafwijking van subgroep i
m
aantal subgroepen
\overline x_i
gemiddelde van subgroep i
µ_ν
gemiddelde van de subgroepvarianties
c_4 ()
waarde van de correctieconstante c4 die hoort bij de waarde die tussen haakjes is opgegeven
c_5 ()
waarde van de correctieconstante c5 die hoort bij de waarde die tussen haakjes is opgegeven
Γ()
gammafunctie
Formule voor de Xbar-kaart
- Uitgezette punten: Elk uitgezet punt, \overline x_i , is het gemiddelde van de waarnemingen van subgroep i .
\overline x_i = \frac{\sum\limits_{j=1}^{n_i} x_{ij}}{n_i}
- Middenlijn: De middenlijn geeft het procesgemiddelde (µ) weer.
\overline{\overline{X}} = \frac{∑x}{∑n}
- Regelgrenzen:
- Onderste regelgrens: De waarde van de onderste regelgrens voor elke subgroep i wordt als volgt berekend:
LCL_i= µ- \frac{kσ}{√(n_i )}
- Bovenste regelgrens: De waarde van de bovenste regelgrens voor elke subgroep i wordt als volgt berekend:
- Bovenste regelgrens: De waarde van de bovenste regelgrens voor elke subgroep i wordt als volgt berekend:
UCL_i= µ+ \frac{kσ}{√(n_i )}
Formule voor de S-kaart
- Uitgezette punten: Elk uitgezet punt, s_i , is de standaardafwijking van subgroep i .
- Middenlijn: De middenlijn geeft de gemiddelde standaardafwijking van een subgroep weer. Als u geen correctieconstante gebruikt, gebruikt Zometric de standaardafwijking van het proces, σ:
\overline S = σ
...........................Als u een correctieconstante gebruikt (standaard), berekent Zometric de waarde van de middenlijn voor elke subgroep ials volgt:
\overline S_i = c_4 (n_i) σ
- Regelgrenzen:
- Onderste regelgrens:
Als de correctieconstante wordt gebruikt:
LCL_i = [c_4 (n_i)×σ]-[kσ× c_5 (n_i)]
Als de correctieconstante niet wordt gebruikt:
LCL_i = σ-k[\frac{c_5 (n_i)}{c_4 (n_i)}]σ
Bovenste regelgrens:
Als de correctieconstante wordt gebruikt
UCL_i = [c_4 (n_i)×σ]+[kσ× c_5 (n_i)]
Als de correctieconstante niet wordt gebruikt:
UCL_i = σ+k[\frac{c_5 (n_i)}{c_4 (n_i)}]σ
Formule voor de schatting van sigma (standaardafwijking binnen subgroepen)
Met de Sbar-methode:
............................Als u geen correctieconstante gebruikt, is \overline S het gemiddelde van de standaardafwijkingen van de subgroepen:
\overline S = \frac{\sum S_i}{m}
............................Als u de correctieconstante c4(ni) gebruikt, wordt \overline S als volgt berekend:
h_i = \frac {c_4 (n_i)^2}{1-c_4 (n_i)^2}
............................Bij een constante subgroepgrootte is \overline S:
\overline S = \frac {\sum S_i}{m×c_4(n_i)}
Met de methode van de gepoolde standaardafwijking:
De gepoolde standaardafwijking (Sp) wordt gegeven door de volgende formule:
S_p = \sqrt\frac{\sum\limits_{i}^{} \sum\limits_{j}^{} (x_{ij}-\overline x_i)^2 }{\sum\limits_{i}^{} (n_{i}-1)}
Bij een constante subgroepgrootte kan Sp ook als volgt worden berekend:
S_p = \sqrt µ_ν
Formules voor de correctieconstanten
- c_4 () en c_5 () :
c_4 (N) = {\sqrt \frac {2}{N-1}}\frac{Γ\frac{N}{2}}{Γ\frac{N-1}{2}}
c_5 (N) = \sqrt {1 - c_4(N)^2}
Veelgestelde vragen
Wat is een Xbar-S-kaart?
Een Xbar-S-kaart is een paar regelkaarten voor continue gegevens in subgroepen. De Xbar-kaart volgt de subgroepgemiddelden in de tijd om verschuivingen in het procesgemiddelde op te sporen, en de S-kaart zet de standaardafwijkingen van de subgroepen uit om veranderingen in de procesvariatie op te sporen. De kaart is geschikt voor grotere subgroepen en geeft een nauwkeuriger beeld van de spreiding dan kaarten op basis van de spreidingsbreedte.
Wanneer gebruikt u een Xbar-S-kaart in plaats van een Xbar-R-kaart?
Gebruik een Xbar-S-kaart voor subgroepen met 9 of meer waarnemingen, omdat de spreidingsbreedte bij grotere subgroepen een minder efficiënte schatter van de processigma wordt en de standaardafwijking van de subgroep beter is. Gebruik een Xbar-R-kaart voor subgroepen van 2 tot 8 en een I-MR-kaart als er geen subgroepen zijn.
Hoeveel gegevens hebt u nodig voor een Xbar-S-kaart?
Verzamel in totaal ten minste 60 waarnemingen voor betrouwbare resultaten. Voer de gegevens in tijdsvolgorde in, verzamel ze met gelijke tussenpozen, gebruik rationele subgroepen die de procesoutput representeren en vermijd gecorreleerde waarnemingen binnen subgroepen, zodat de regelgrenzen nauwkeurig zijn.
Hoe worden de regelgrenzen van de S-kaart berekend?
Met de correctieconstante, de standaardinstelling, is de middenlijn van de S-kaart voor subgroep i gelijk aan c4(ni) maal sigma, en zijn de regelgrenzen c4(ni) maal sigma plus of min k maal sigma maal c5(ni), waarbij standaard k = 3. Sigma kan worden geschat met de Sbar-methode of met de gepoolde standaardafwijking.