
Teste z de uma amostra
O teste z de uma amostra compara uma média amostral com uma média hipotética quando o desvio padrão populacional é conhecido de estudos anteriores ou de dados históricos. Os dados devem ser contínuos, aleatórios e independentes, e ter distribuição normal ou tamanho amostral maior que 20 sem forte assimetria. Se o desvio padrão for desconhecido, use o teste t de uma amostra. A saída inclui a estatística z, o valor-p e o intervalo de confiança.
Última revisão
Conclusão principal
Um teste z de uma amostra determina se a média amostral difere significativamente de uma média populacional hipotética quando o desvio padrão populacional é conhecido, usando a distribuição normal padrão.
Nesta página
- O que é o teste z de uma amostra?
- Quando usar o teste z de uma amostra?
- Diretrizes para o uso correto do teste z de uma amostra
- Alternativas: quando não usar o teste z de uma amostra
- Exemplo de teste z de uma amostra
- Como fazer o teste z de uma amostra
- Como fazer o teste z de uma amostra para dados resumidos
O que é o teste z de uma amostra?
O teste z de uma amostra é um procedimento fundamental da estatística inferencial, usado para determinar se a média de uma amostra é significativamente diferente de uma média populacional conhecida. Esse teste paramétrico é aplicável quando o desvio padrão populacional é conhecido, os pontos de dados são independentes e os dados seguem uma distribuição normal ou o tamanho amostral é grande o suficiente (maior que 20, com dados sem forte assimetria) para que a média amostral seja aproximadamente normal. Ele é versátil, podendo ser aplicado a uma amostra, a duas amostras ou a proporções em testes de hipóteses. O teste z pode ser classificado em unicaudal à esquerda, unicaudal à direita e bicaudal, conforme a natureza dos dados e a hipótese testada. O teste consiste em comparar a média amostral com a média populacional usando a distribuição normal padrão para calcular os valores críticos.
O teste z de uma amostra avalia se a média amostral é significativamente maior que, menor que ou diferente da média populacional. A hipótese nula afirma que não há diferença significativa entre a média amostral e a média populacional. A estatística de teste é calculada e comparada com os valores críticos; se cair na região crítica, a hipótese nula é rejeitada.
Quando usar o teste z de uma amostra?
Em geral, ele é usado quando você tem uma única amostra e deseja compará-la com um valor populacional conhecido.
Condições para usar o teste z de uma amostra:
- Desvio padrão populacional conhecido: O desvio padrão populacional (σ\sigmaσ) deve ser conhecido.
- Tamanho amostral: se os dados não têm distribuição normal, o tamanho amostral deve ser maior que 20 e os dados não devem ter forte assimetria.
- Distribuição normal: a população subjacente da qual a amostra é extraída deve seguir uma distribuição normal, especialmente para tamanhos amostrais pequenos (20 ou menos). No entanto, com tamanhos amostrais maiores, o teste z é robusto à não normalidade.
- Pontos de dados independentes: Os pontos de dados da amostra devem ser independentes uns dos outros. Isso significa que o valor de um ponto de dados não influencia o valor de outro.
Estes são alguns cenários em que você pode querer usar um teste z de uma amostra:
- Controle de qualidade: Uma fábrica produz peças e você quer saber se o peso delas é consistente com a especificação do cliente. Nesse caso, você pode coletar uma amostra de peças, medir seu peso e compará-lo com a especificação do cliente.
- Pesquisa médica: Foi desenvolvido um novo medicamento para reduzir a pressão arterial e você quer saber se ele é eficaz. Você pode coletar uma amostra de pacientes com pressão alta, administrar o medicamento e medir a pressão arterial deles após certo período. Em seguida, pode comparar a pressão arterial média da amostra com a média populacional.
- Satisfação do cliente: Uma empresa quer saber se seus clientes estão satisfeitos com seus produtos. Nesse caso, a empresa pode coletar uma amostra aleatória de clientes e pedir que avaliem sua satisfação em uma escala de 1 a 10. Em seguida, a empresa pode comparar a nota média de satisfação da amostra com a média populacional.
Diretrizes para o uso correto do teste z de uma amostra
- Use o teste z de uma amostra se o desvio padrão populacional for conhecido
- Use dados contínuos na análise, como o peso de embalagens
- Use One sample Poisson Rate para dados de contagem e One Proportion para dados do tipo aprovado/reprovado
- O tamanho amostral deve ser maior que 20 e os dados não devem ter forte assimetria
- Selecione os dados da amostra de forma aleatória e garanta que cada observação seja independente
- Determine um tamanho amostral apropriado para garantir estimativas precisas, intervalos de confiança estreitos e proteção contra erros.
Alternativas: quando não usar o teste z de uma amostra
Se você não conhece o desvio padrão da população, use o teste t de uma amostra.
Exemplo de teste z de uma amostra
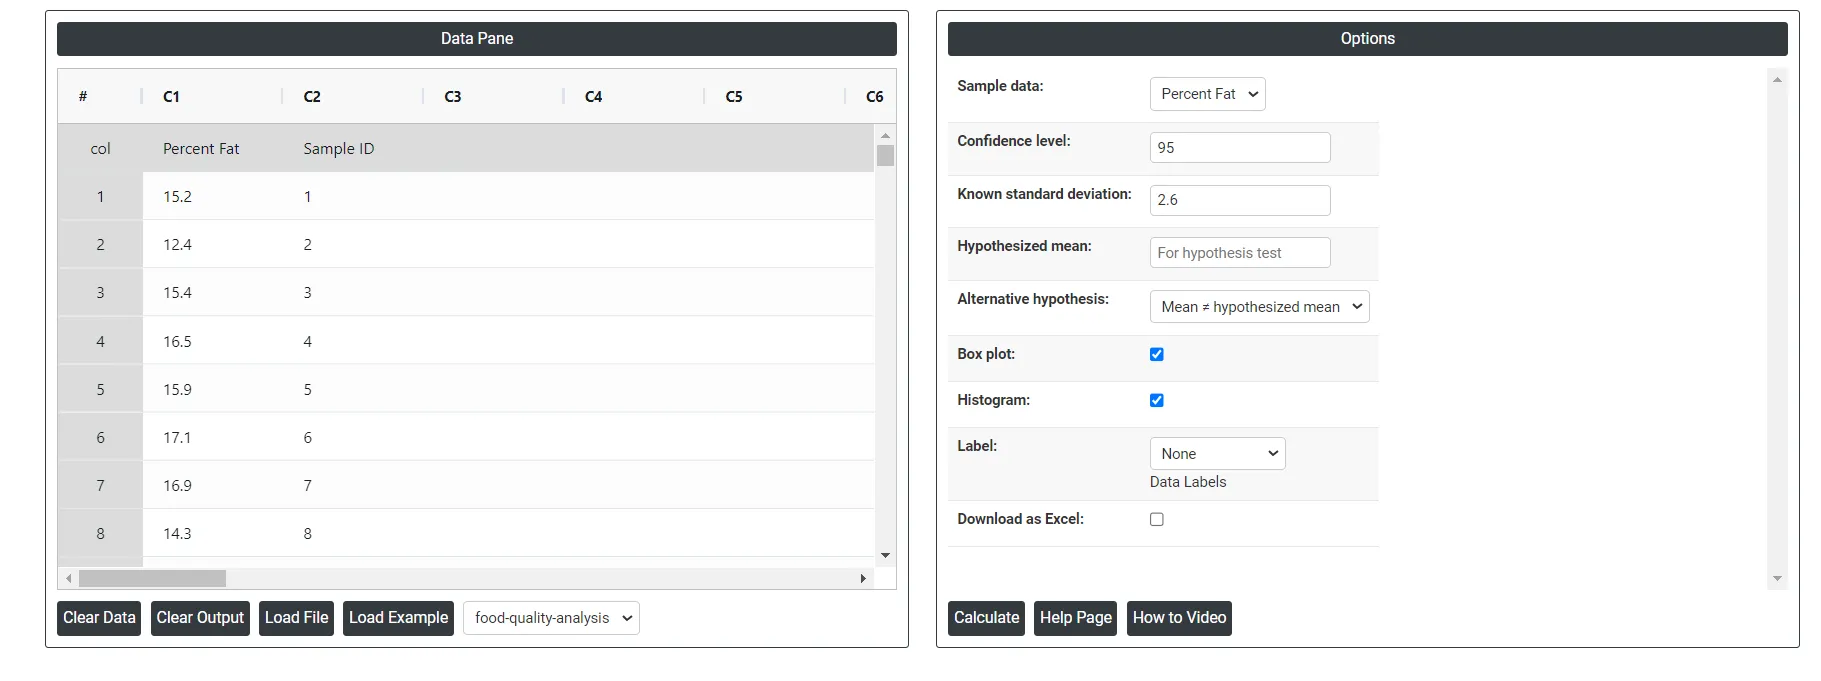
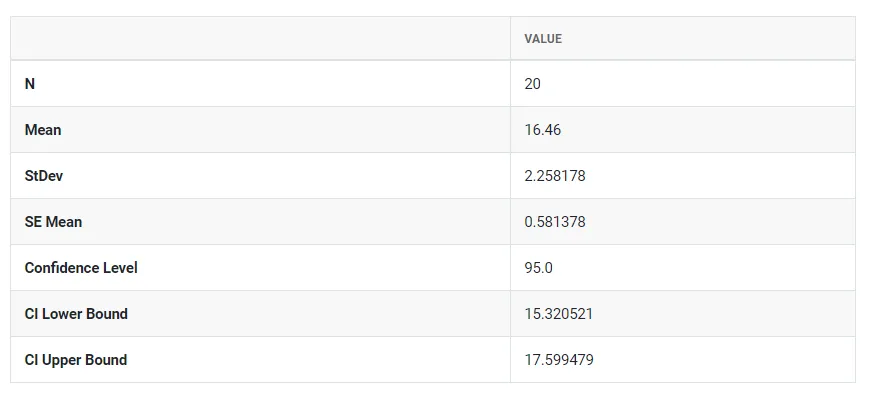
Um cientista de uma empresa que fabrica alimentos processados quer avaliar o percentual de gordura no molho engarrafado da empresa. O percentual anunciado é de 15%. O cientista mede o percentual de gordura em 20 amostras aleatórias. Medições anteriores indicaram que o desvio padrão populacional é de 2.6%. O cientista realiza um teste z de uma amostra para determinar se o percentual de gordura difere de 15%. As etapas são as seguintes:
- Coletou os dados necessários.
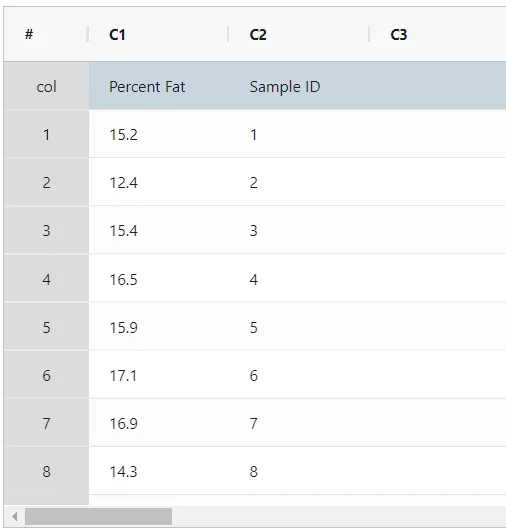
- Em seguida, analise os dados no Zometric Statistical Software em https://statsai.zometric.com/.
- Para encontrar o teste z de uma amostra, escolha Statistical module> Graphical analysis> One sample z-test.
- Na ferramenta, insira os dados e as demais entradas da seguinte forma:
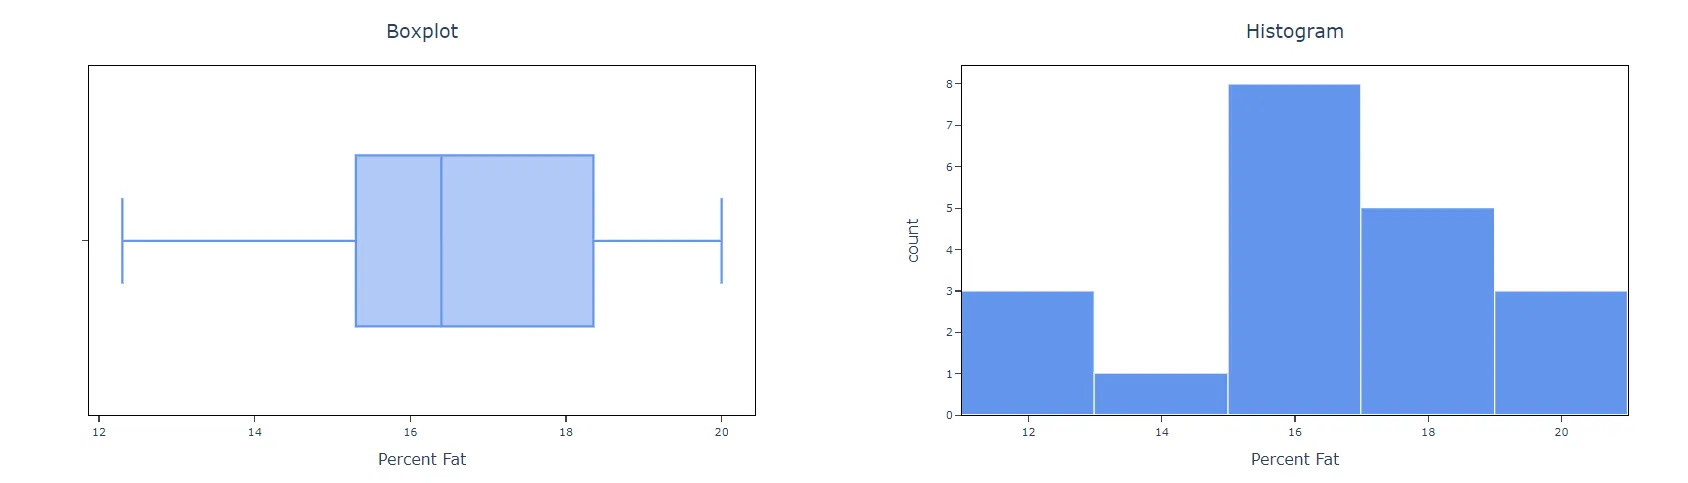
- Depois de usar a ferramenta mencionada acima, obtém-se a saída a seguir:
Como fazer o teste z de uma amostra
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> Graphical analysis >One sample z-test.
- Clique em One sample z-test para acessar o painel (dashboard).
- Em seguida, atualize os dados manualmente ou copie todos os dados (Ctrl+C) de uma planilha do Excel e cole-os (Ctrl+V) aqui.
- Em seguida, você precisa inserir os valores do nível de confiança, do desvio padrão conhecido e da média hipotética.
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) do teste z de uma amostra, a janela é dividida em duas partes.
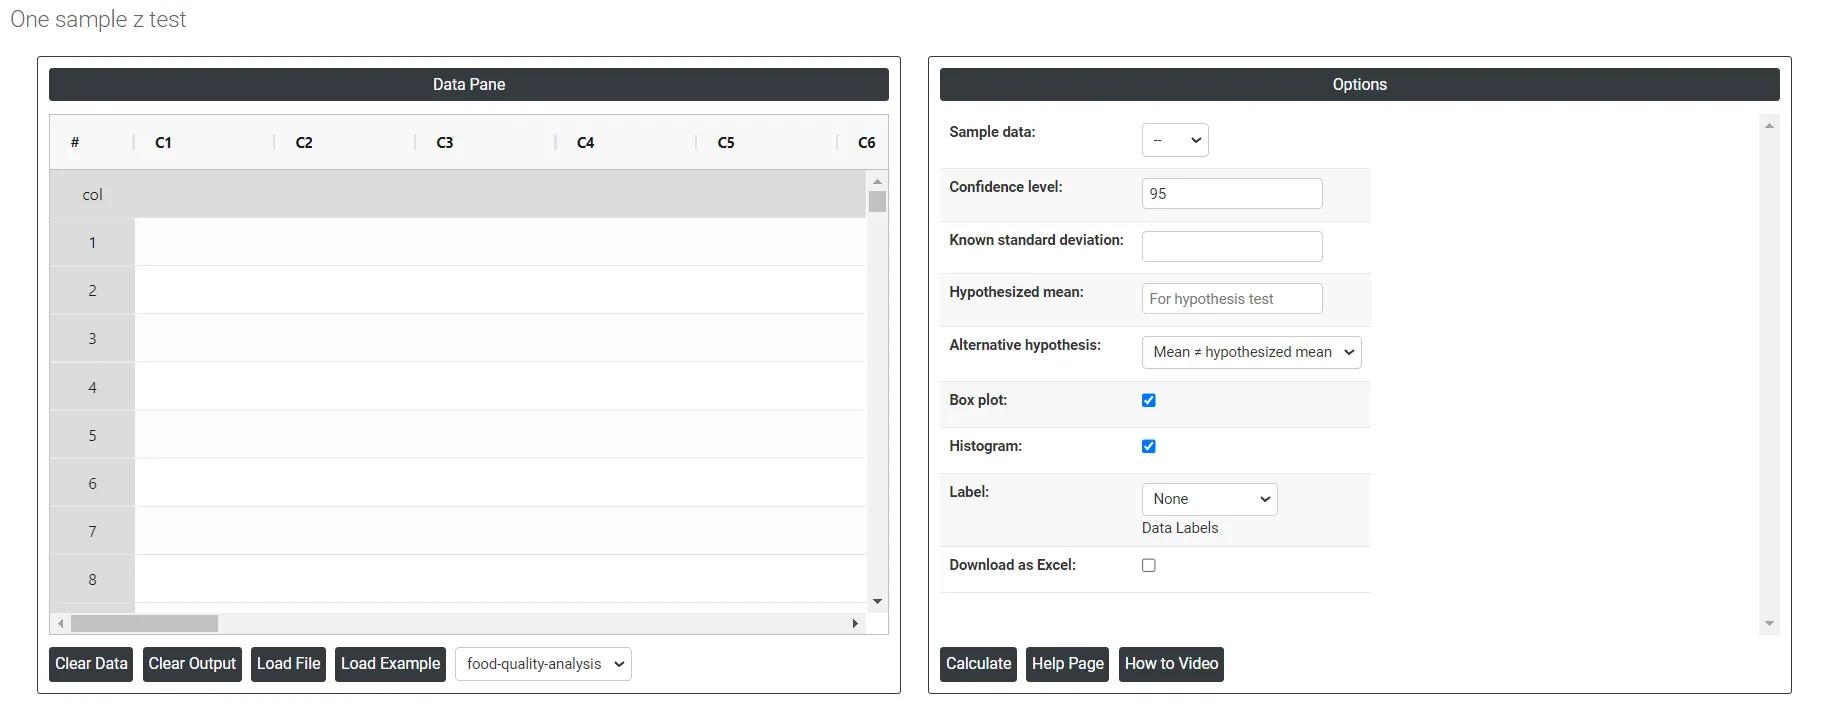
Na parte esquerda fica o painel de dados (Data Pane). No Data Pane, cada linha forma um subgrupo. Os dados podem ser inseridos manualmente, ou você pode copiar todos os dados (Ctrl+C) de uma planilha do Excel e colá-los (Ctrl+V) aqui.
Load example: Os dados de exemplo serão carregados.
Load File: É usado para carregar diretamente os dados do Excel.
Na parte direita, há várias opções, descritas a seguir:
- Confidence level: Em um teste de hipóteses, o nível de confiança representa o grau de certeza ou de confiança que temos em nossa análise estatística. É um valor de probabilidade que indica a probabilidade de o verdadeiro parâmetro populacional estar dentro da faixa de valores especificada. Normalmente, o nível de confiança é expresso como porcentagem e denotado por (1 - α), em que α é o nível de significância, ou a probabilidade de rejeitar uma hipótese nula verdadeira. Por exemplo, se temos um nível de confiança de 95%, estamos dizendo que temos 95% de confiança de que o verdadeiro parâmetro populacional está dentro da nossa estimativa por intervalo, e que há 5% de chance de cometer um erro do tipo I (rejeitar uma hipótese nula verdadeira). Na prática, um nível de confiança mais alto significa que temos mais confiança em nossa análise e em nossos resultados estatísticos. No entanto, aumentar o nível de confiança também aumenta a largura do intervalo de confiança, o que torna mais difícil detectar efeitos pequenos. Portanto, a escolha do nível de confiança depende do contexto do estudo e dos objetivos do pesquisador.
- Known standard deviation: O desvio padrão populacional (σ), conhecido de estudos anteriores ou de dados históricos, e não estimado a partir da amostra. A estatística de teste z é calculada como a diferença entre a média amostral e a média hipotética, dividida pelo erro padrão da média (σ dividido pela raiz quadrada do tamanho amostral), e é comparada com a distribuição normal padrão.
- Hypothesized mean: A média hipotética, também chamada de média esperada ou média populacional, é um valor especificado na hipótese nula que representa o valor médio da variável testada. É um valor teórico usado para comparar com a média amostral real, a fim de determinar se a diferença é estatisticamente significativa ou devida ao acaso.
- Alternative hypothesis: Em um teste de hipóteses, a hipótese alternativa (também chamada de hipótese de pesquisa) é uma afirmação que representa uma conclusão diferente da hipótese nula. A hipótese nula normalmente representa o status quo ou a suposição de que não há diferença ou relação significativa entre dois ou mais grupos ou variáveis. A hipótese alternativa é a afirmação que está sendo testada e propõe que existe uma diferença ou relação significativa entre os grupos ou variáveis estudados.
- Box Plot: Se marcada, fornece o boxplot; caso contrário, não.
- Histogram: Se marcada, fornece o histograma; caso contrário, não.
- Label: Define os rótulos de dados e contém três opções:
- Outlier: Valores de dados muito distantes dos demais, que podem afetar fortemente os seus resultados.
- All quartiles: Os quartis são valores que dividem uma amostra de dados em quatro partes iguais. Permitem avaliar rapidamente a dispersão e a tendência central de um conjunto de dados.
- Mean: A média no boxplot fornece informações adicionais sobre a tendência central dos dados.
- Individual Data: Um ponto de dados individual é uma única observação ou valor em um conjunto de dados.
- Download as Excel: Exibe o resultado em formato Excel, que pode ser facilmente editado e recarregado para os cálculos por meio da opção load file.
Como fazer o teste z de uma amostra para dados resumidos
O guia é o seguinte:
- Faça login no Zometric Statistical Software em https://statsai.zometric.com/
- Na página inicial, escolha Statistical Tool> Graphical analysis >One sample z-test for summarized data
- Clique em One sample z-test for summarized data para acessar o painel (dashboard).
- Em seguida, atualize os dados manualmente ou copie todos os dados (Ctrl+C) de uma planilha do Excel e cole-os (Ctrl+V) aqui.
- Em seguida, você precisa inserir os valores do tamanho amostral, da média amostral, do desvio padrão conhecido, da média hipotética e do nível de confiança.
- Por fim, clique em calculate na parte inferior da página para obter os resultados desejados.
No painel (dashboard) do teste z de uma amostra para dados resumidos, a janela tem apenas a parte esquerda.
Load File: É usado para carregar diretamente os dados do Excel.
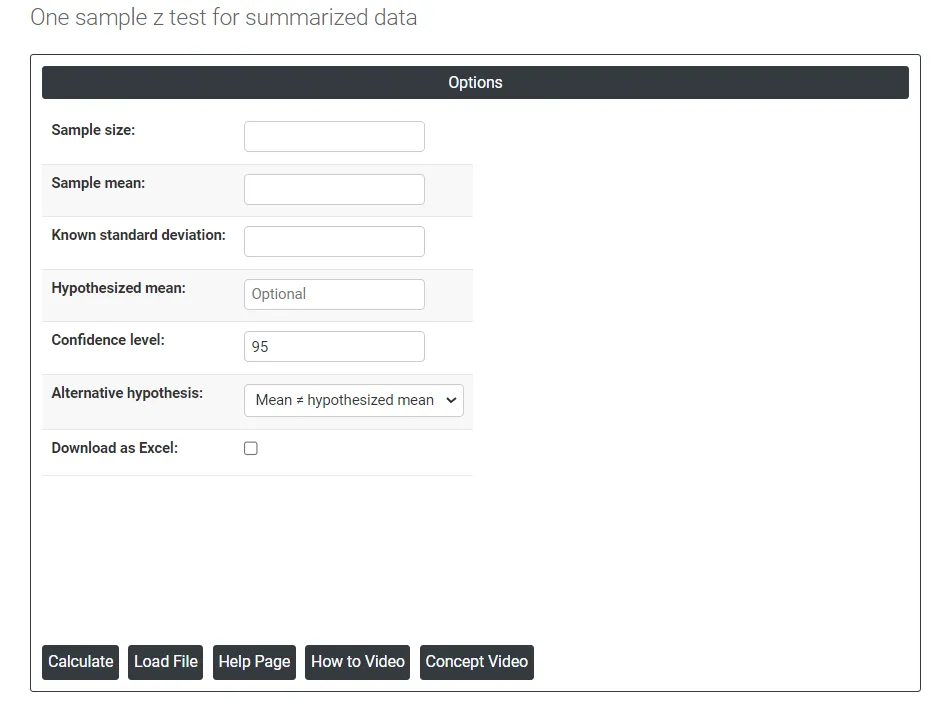
Nesta parte, há várias opções, descritas a seguir:
- Sample size: O tamanho amostral refere-se ao número de indivíduos, objetos ou eventos selecionados de uma população para serem estudados, a fim de tirar conclusões sobre toda a população. Em outras palavras, é o número de observações ou participantes incluídos em um estudo. O tamanho amostral pode ter um impacto significativo na exatidão e na confiabilidade dos resultados do estudo. Um tamanho amostral maior normalmente fornece um retrato mais representativo da população e ajuda a reduzir os efeitos do erro de amostragem aleatória. Portanto, é importante determinar um tamanho amostral apropriado antes de realizar a pesquisa, para garantir que os resultados sejam estatisticamente válidos e confiáveis.
- Sample mean: A média amostral é o valor médio de um conjunto de observações ou pontos de dados selecionados de uma população maior. É calculada somando todos os valores da amostra e dividindo pelo número de observações. A média amostral costuma ser usada como estimador da média populacional, que é o valor médio de toda a população.
- Confidence level: Em um teste de hipóteses, o nível de confiança representa o grau de certeza ou de confiança que temos em nossa análise estatística. É um valor de probabilidade que indica a probabilidade de o verdadeiro parâmetro populacional estar dentro da faixa de valores especificada. Normalmente, o nível de confiança é expresso como porcentagem e denotado por (1 - α), em que α é o nível de significância, ou a probabilidade de rejeitar uma hipótese nula verdadeira. Por exemplo, se temos um nível de confiança de 95%, estamos dizendo que temos 95% de confiança de que o verdadeiro parâmetro populacional está dentro da nossa estimativa por intervalo, e que há 5% de chance de cometer um erro do tipo I (rejeitar uma hipótese nula verdadeira). Na prática, um nível de confiança mais alto significa que temos mais confiança em nossa análise e em nossos resultados estatísticos. No entanto, aumentar o nível de confiança também aumenta a largura do intervalo de confiança, o que torna mais difícil detectar efeitos pequenos. Portanto, a escolha do nível de confiança depende do contexto do estudo e dos objetivos do pesquisador.
- Known standard deviation: O desvio padrão populacional (σ), conhecido de estudos anteriores ou de dados históricos, e não estimado a partir da amostra. A estatística de teste z é calculada como a diferença entre a média amostral e a média hipotética, dividida pelo erro padrão da média (σ dividido pela raiz quadrada do tamanho amostral), e é comparada com a distribuição normal padrão.
- Hypothesized mean: A média hipotética, também chamada de média esperada ou média populacional, é um valor especificado na hipótese nula que representa o valor médio da variável testada. É um valor teórico usado para comparar com a média amostral real, a fim de determinar se a diferença é estatisticamente significativa ou devida ao acaso.
- Alternative hypothesis: Em um teste de hipóteses, a hipótese alternativa (também chamada de hipótese de pesquisa) é uma afirmação que representa uma conclusão diferente da hipótese nula. A hipótese nula normalmente representa o status quo ou a suposição de que não há diferença ou relação significativa entre dois ou mais grupos ou variáveis. A hipótese alternativa é a afirmação que está sendo testada e propõe que existe uma diferença ou relação significativa entre os grupos ou variáveis estudados.
- Download as Excel: Exibe o resultado em formato Excel, que pode ser facilmente editado e recarregado para os cálculos por meio da opção load file. option.
Perguntas frequentes
O que é um teste z de uma amostra?
Um teste z de uma amostra determina se a média de uma amostra é significativamente diferente de uma média populacional conhecida quando o desvio padrão populacional é conhecido. A estatística z é a diferença entre a média amostral e a média hipotética dividida pelo erro padrão, ou seja, sigma dividido pela raiz quadrada do tamanho amostral. Pode ser executado como teste unicaudal à esquerda, unicaudal à direita ou bicaudal.
Quais são as condições para um teste z de uma amostra?
O desvio padrão populacional deve ser conhecido, e os pontos de dados devem ser independentes, contínuos e amostrados de forma aleatória. Os dados devem seguir uma distribuição normal, especialmente para tamanhos amostrais de 20 ou menos; se os dados não forem normais, o tamanho amostral deve ser maior que 20 e os dados não devem ter forte assimetria, para que a média amostral seja aproximadamente normal.
Qual é a diferença entre o teste z de uma amostra e o teste t?
O teste z é usado quando o desvio padrão populacional é conhecido. Se o desvio padrão populacional é desconhecido e precisa ser estimado a partir da amostra, use o teste t de uma amostra. Para dados de contagem, use o teste One sample Poisson Rate e, para dados do tipo aprovado/reprovado, use One Proportion.
Como executar um teste z de uma amostra no Zometric Statistical Software?
Abra a ferramenta One sample z-test, insira ou cole os dados, defina o nível de confiança, o desvio padrão conhecido, a média hipotética e a hipótese alternativa, e clique em Calculate. Uma versão para dados resumidos aceita o tamanho amostral, a média amostral, o desvio padrão conhecido, a média hipotética e o nível de confiança no lugar dos dados brutos.