
Gráfica XBarra-R (X̄-R)
Las gráficas XBarra-R son herramientas esenciales para monitorear la estabilidad de procesos con datos variables en diversas industrias. Son especialmente útiles para examinar datos continuos y evaluar el desempeño del proceso.
Última revisión:
Idea clave
Las gráficas XBarra-R son herramientas esenciales para monitorear la estabilidad de procesos con datos variables en diversas industrias.
En esta página
¿Qué es una gráfica XBarra-R?
Las gráficas XBarra-R son herramientas esenciales para monitorear la estabilidad de procesos con datos variables en diversas industrias. Estas gráficas son especialmente útiles para examinar datos continuos y evaluar el desempeño del proceso. Al recopilar datos de subgrupos a intervalos establecidos, las gráficas XBarra-R proporcionan dos gráficas: una para monitorear la media del proceso (gráfica XBarra) y otra para monitorear la variación del proceso (gráfica R) a lo largo del tiempo.
Las gráficas XBarra-R son fundamentales para identificar la variabilidad tanto de la media como del rango del proceso. Resultan clave para evaluar los efectos de las iniciativas de mejora de procesos. La gráfica XBarra detecta desplazamientos de la media del proceso, mientras que la gráfica R pone de relieve los cambios en la variabilidad del proceso. En conjunto, permiten un control y una evaluación integrales de la consistencia del proceso a lo largo del tiempo. Ayudan a identificar tendencias y patrones que pueden indicar problemas subyacentes en el proceso. Al ofrecer una representación visual clara del comportamiento del proceso, estas gráficas respaldan la toma de decisiones basada en datos y los esfuerzos de mejora continua. Son especialmente valiosos en entornos donde mantener un control estricto de los parámetros del proceso es fundamental para garantizar la calidad del producto y la eficiencia operativa.
¿Cuándo usar una gráfica XBarra-R?
La gráfica XBarra-R se utiliza cuando el tamaño del subgrupo es mayor que uno y el tamaño de muestra es pequeño o mediano (menos de 10). Se utiliza para monitorear la tendencia central (media) y la variabilidad (rango) de un proceso a lo largo del tiempo cuando puede suponerse normalidad. La gráfica XBarra-R es útil para detectar cambios en la media y en la variabilidad del proceso, que pueden indicar la necesidad de mejorar el proceso. Se usa habitualmente en la manufactura y en otras industrias donde el control de calidad es importante.
Pautas para el uso correcto de la gráfica XBarra-R
- Use datos continuos para las gráficas de control por variables y datos de atributos para la gráfica P o la gráfica U.
- Introduzca los datos en orden cronológico, con los datos más antiguos arriba.
- Recopile los datos a intervalos de tiempo igualmente espaciados.
- Use subgrupos racionales, que son muestras pequeñas de unidades similares producidas en las mismas condiciones.
- El tamaño del subgrupo debe ser de 8 o menos; para más, use la gráfica XBarra-S, y la gráfica I-MR si no hay subgrupos.
- Recopile una cantidad adecuada de datos según el tamaño del subgrupo.
- Las gráficas de control pueden funcionar con datos no normales si se recopilan en subgrupos.
- Evite los puntos de datos correlacionados dentro de los subgrupos para que los límites de control no resulten demasiado estrechos.
Alternativas: cuándo no usar la gráfica XBarra-R
- Para subgrupos con 9 o más observaciones, opte por la gráfica XBarra-S, a menos que haya una fuente de variación constante dentro de los subgrupos; en ese caso, use la gráfica I-MR-R/S.
- Si no hay subgrupos, use la gráfica I-MR.
- Si sus datos corresponden a recuentos de unidades defectuosas o de defectos, emplee una gráfica de control por atributos como la gráfica P o la gráfica U.
Ejemplo de gráfica XBarra-R
Veamos cómo crear una gráfica XBarra y una gráfica R con la ayuda de un ejemplo. Supongamos que un ingeniero quiere monitorear un proceso de manufactura que produce árboles de levas para su cliente OEM del sector automotriz. Se recopilaron 5 muestras en cada subgrupo. Un subgrupo consta de muestras recopiladas en un período corto, normalmente piezas consecutivas producidas por una misma máquina de producción. Los datos de los subgrupos se recopilaron aproximadamente cada 30 minutos. Se recopilaron los siguientes datos:
- Se reunieron los datos necesarios.
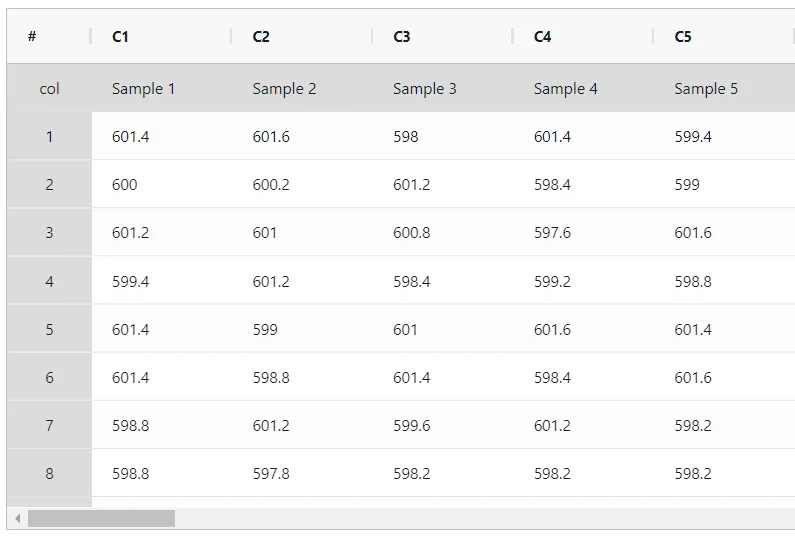
2. Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
3. Para encontrar X Bar R Chart, elija Statistical module> Control Charts> X Bar R Chart.
4. Dentro de la herramienta, introduzca los datos junto con las demás entradas de la siguiente manera:
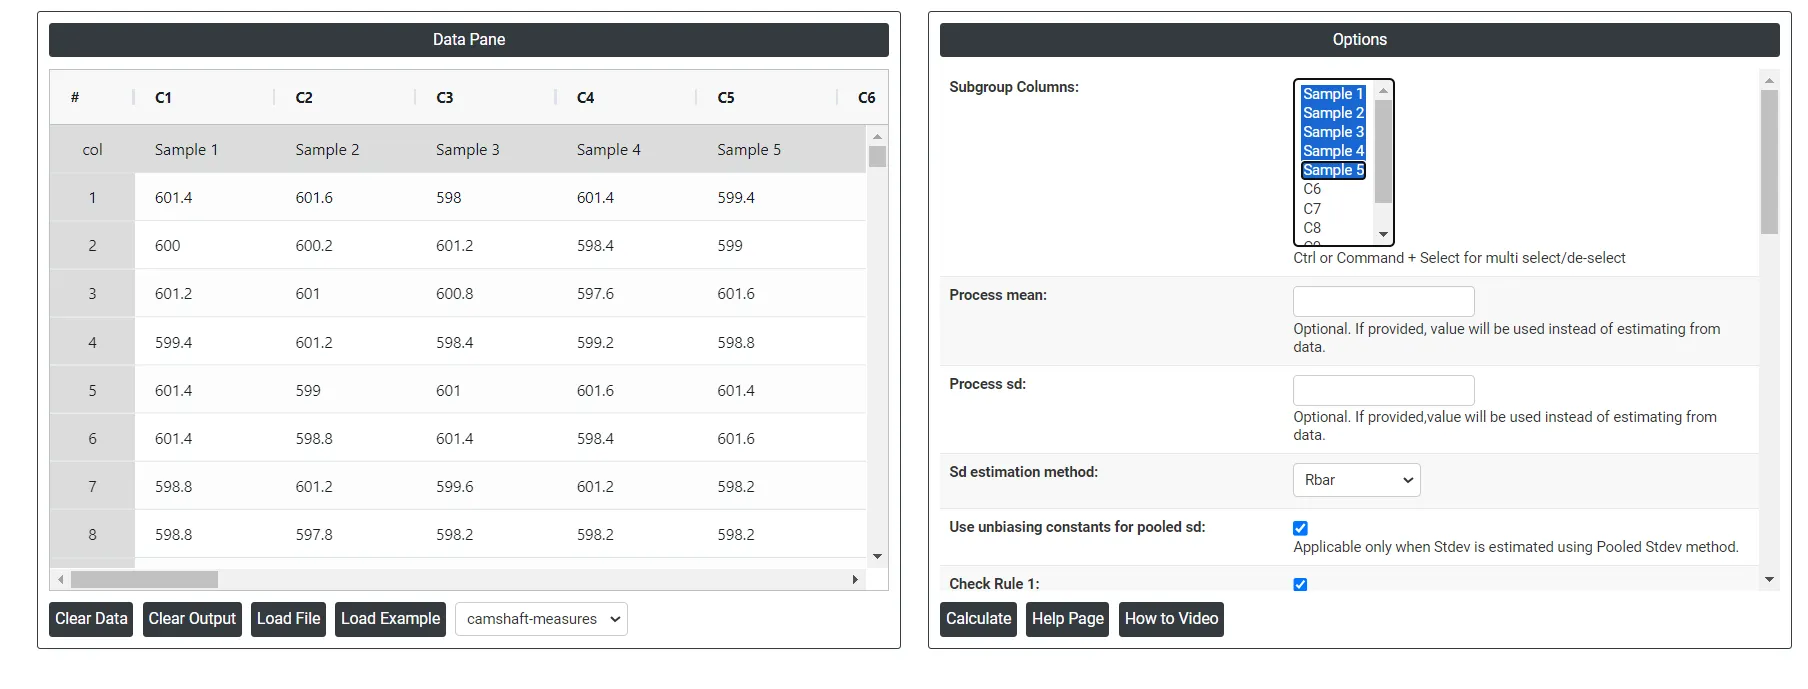
5. Después de usar la herramienta mencionada, se obtiene la siguiente salida:
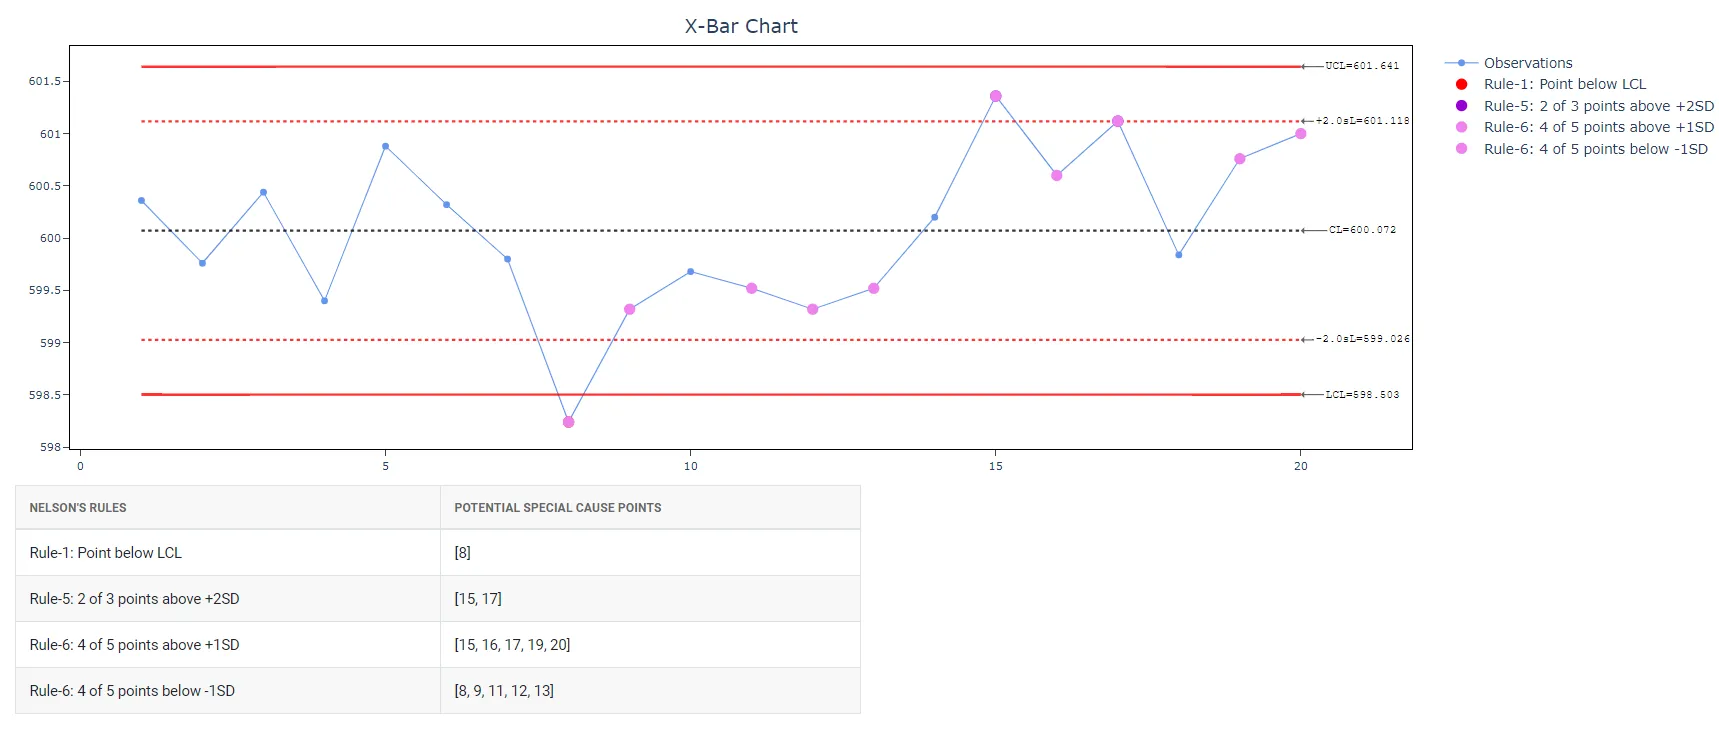
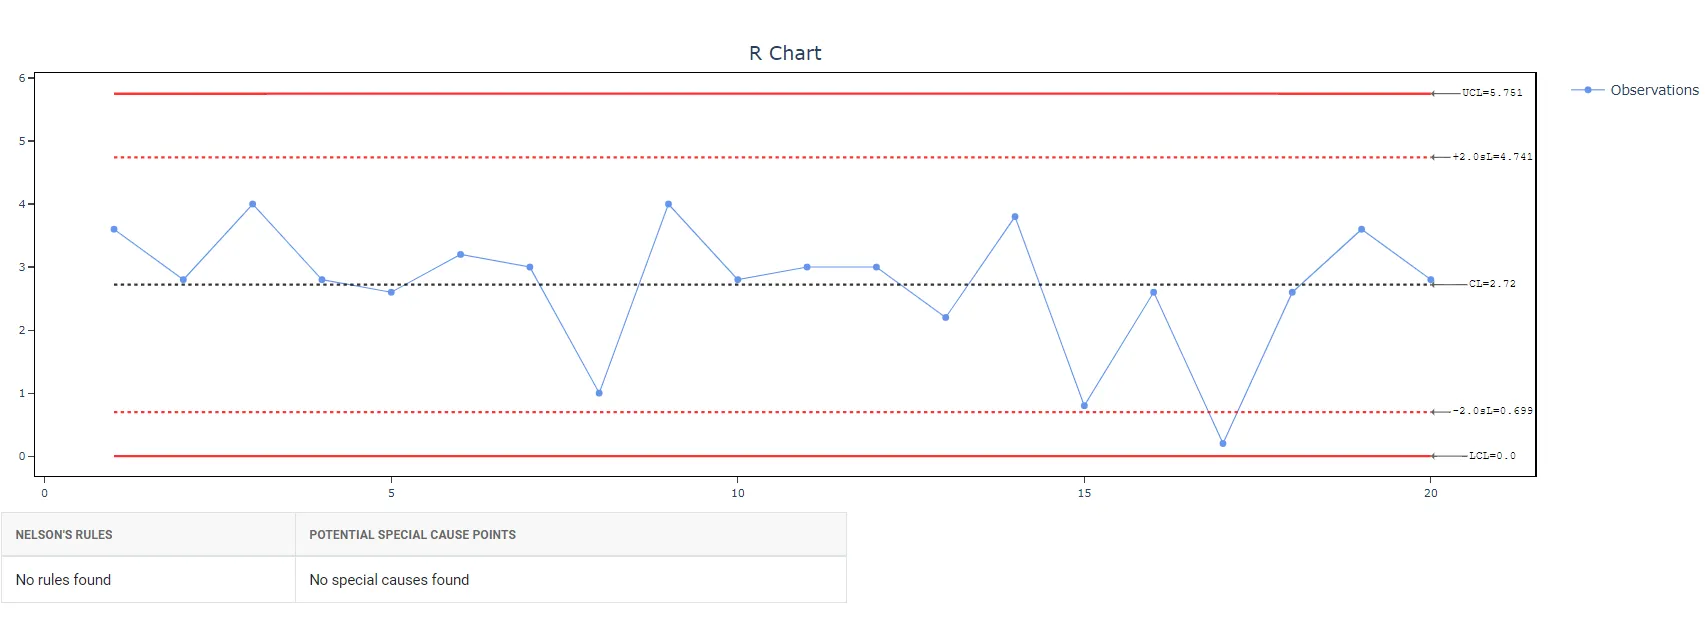
¿Cómo generar una gráfica XBarra-R?
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Control Charts >Xbar R Chart.
- Haga clic en Xbar-R Chart para acceder al tablero.
- A continuación, introduzca los datos manualmente o copie todos los datos (Ctrl+C) de una hoja de Excel y péguelos (Ctrl+V).
- A continuación, debe elegir el Sd estimation method junto con los Check Rules deseados.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de la gráfica XBarra-R, la ventana está dividida en dos partes.
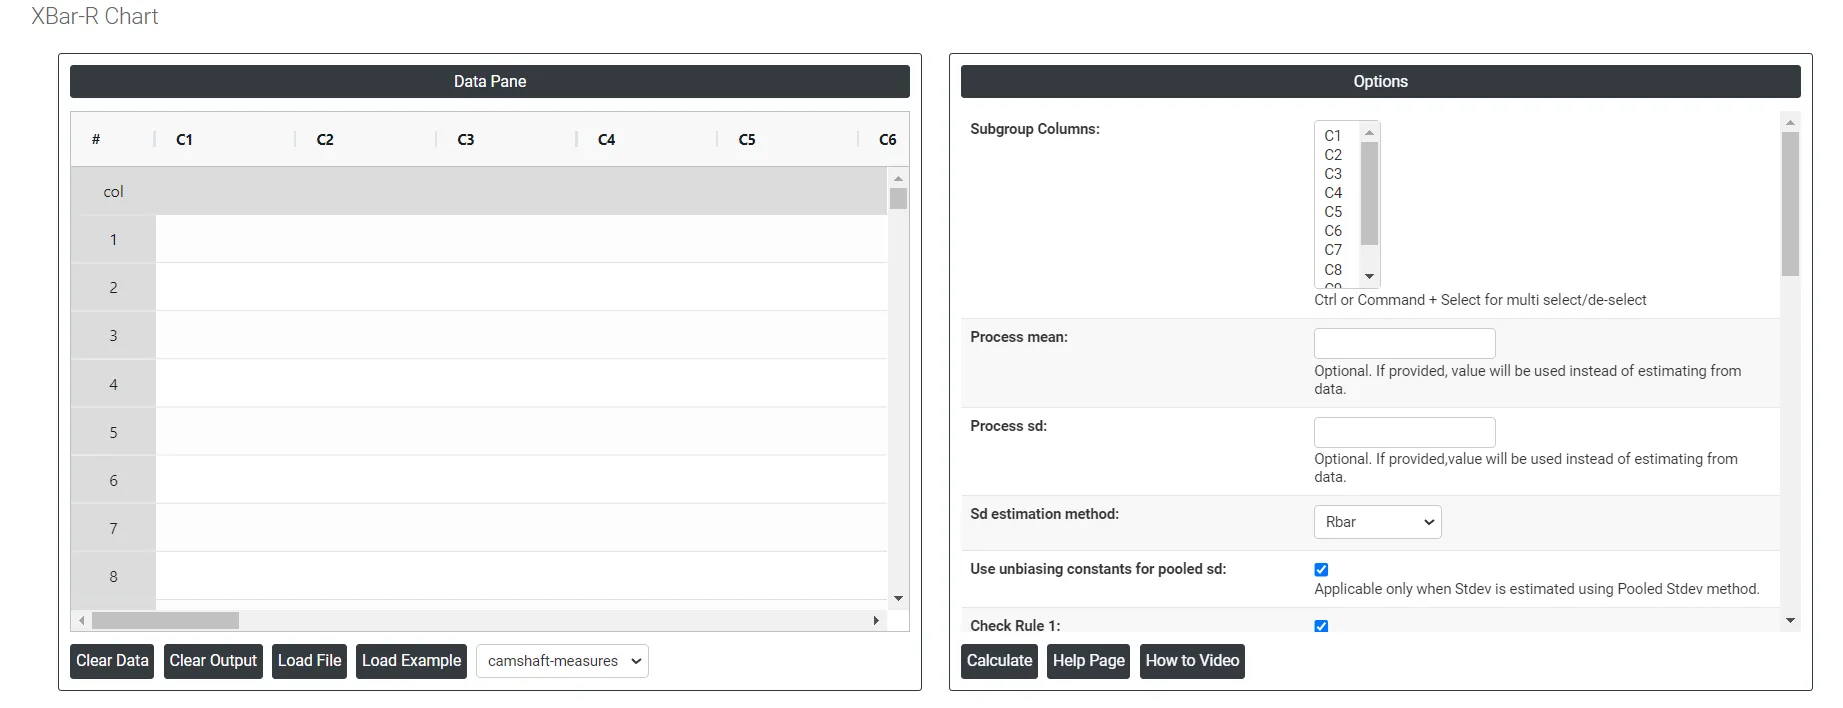
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila forma un subgrupo. Los datos pueden introducirse manualmente o copiarse por completo (Ctrl+C) de una hoja de Excel y pegarse (Ctrl+V) aquí.
Load example: Se cargarán los datos de ejemplo.
Load File: Se usa para cargar directamente los datos de Excel.
En la parte derecha hay varias opciones, como las siguientes:
- Process mean: Es el valor promedio de un conjunto de mediciones u observaciones de un proceso. Representa la tendencia central de los datos del proceso a lo largo del tiempo y es un indicador clave del desempeño del proceso. Si no se indica, Zometric Statistical Software calcula la línea central a partir de los datos proporcionados.
- Process sd: Es una medida de la variabilidad o dispersión de los datos del proceso alrededor de la media. Indica cuánto difieren los puntos de datos individuales del proceso respecto al promedio del proceso. Si lo deja en blanco, Zometric Statistical Software lo calcula a partir de los datos proporcionados.
- Sd estimation method: Deja al usuario dos opciones para el cálculo. Elegir Rbar como método de estimación o el método de la desviación estándar combinada (pooled) cambia el resultado.
- Rbar Sd estimation method: Rbar representa el promedio de los rangos dentro de los subgrupos. El método Rbar es una estimación de la desviación estándar muy utilizada, especialmente eficaz para tamaños de subgrupo de 2 a 8.
- Pooled Sd estimation method: La desviación estándar combinada (pooled) es el promedio ponderado de las varianzas de los subgrupos, en el que los subgrupos mayores tienen más influencia en la estimación global. Este método ofrece una estimación más exacta de la desviación estándar cuando el proceso es estable.
- Use unbiasing constants for pooled sd: Esta opción solo se aplica cuando Stdev se estima con el método Pooled Stdev.
- Check Rule 1: 1 point > K Stdev from center line: La prueba 1 es esencial para identificar subgrupos que se desvían significativamente de los demás, por lo que es una herramienta de reconocimiento universal para detectar situaciones fuera de control. Para aumentar la sensibilidad y detectar desplazamientos más pequeños del proceso, la prueba 2 puede usarse junto con la prueba 1, lo que mejora la eficacia de las gráficas de control.
- Check Rule 2: K points in a row on same side of center line: La prueba 2 detecta cambios en el centrado o en la variación del proceso. Al monitorear desplazamientos pequeños del proceso, la prueba 2 puede usarse junto con la prueba 1 para aumentar la sensibilidad de las gráficas de control.
- Check Rule 3: K points in a row, all increasing or all decreasing: La prueba 3 está diseñada para identificar tendencias dentro de un proceso. Busca específicamente una secuencia prolongada de puntos de datos consecutivos que aumentan o disminuyen de forma constante, lo que señala una posible tendencia subyacente en el comportamiento del proceso.
- Check Rule 4: K points in a row, alternating up and down: La prueba 4 está diseñada para identificar variaciones sistemáticas dentro de un proceso. Idealmente, el patrón de variación de un proceso debería ser aleatorio. Sin embargo, si un punto no supera la prueba 4, puede indicar que la variación no es aleatoria, sino que sigue un patrón predecible.
- Check Rule 5: K out of K + 1 points > 2 standard deviation from center line (same side): La prueba 5 detecta desplazamientos pequeños del proceso.
- Check Rule 6: K out of K + 1 points > 1 standard deviation from center line (same side):La prueba 6 detecta desplazamientos pequeños del proceso.
- Check Rule 7: K points in a row within 1 standard deviation of center line (either side):La prueba 7 identifica patrones de variación que pueden interpretarse erróneamente como evidencia de buen control. Esta prueba detecta límites de control excesivamente amplios, que a menudo son resultado de datos estratificados. Los datos estratificados se producen cuando hay una fuente sistemática de variación dentro de cada subgrupo, lo que hace que los límites de control parezcan más amplios de lo que deberían ser.
- Check Rule 8: K points in a row > 1 standard deviation from center line (either side):La prueba 8 detecta un patrón de mezcla. En un patrón de mezcla, los puntos tienden a alejarse de la línea central y a caer cerca de los límites de control.
- Download as Excel: Muestra el resultado en formato Excel, que puede editarse fácilmente y volver a cargarse para los cálculos mediante la opción load file.
Fórmula de la gráfica XBarra-R
En esta sección se describe cómo se calculan los límites de control de las gráficas XBarra y R. Para empezar, tenga en cuenta la descripción de los términos utilizados en los cálculos que siguen.
TérminoDescripción
x_{ij}
j.ª observación del i.º subgrupo
n_i
número de observaciones del subgrupo i
\sum x
suma de todas las observaciones individuales
\sum n
número total de observaciones
μ
media del proceso
k
parámetro de la prueba 1 (el valor predeterminado es 3)
σ
desviación estándar del proceso
d_2 (.)
valor de la constante de insesgadez d2 correspondiente al valor indicado entre paréntesis
d_3 (.)
valor de la constante de insesgadez d3 correspondiente al valor indicado entre paréntesis
r_i
rango del subgrupo i
m
número de subgrupos
\overline x_i
media del subgrupo i
µ_ν
media de las varianzas de los subgrupos
c_4 (.)
valor de la constante de insesgadez c4 correspondiente al valor indicado entre paréntesis
c_5 (.)
valor de la constante de insesgadez c5 correspondiente al valor indicado entre paréntesis
Γ()
función gamma
Fórmula de la gráfica XBarra
- Puntos representados: Cada punto representado, \overline x_i , es la media de las observaciones del subgrupo i .
\overline x_i = \frac{\sum\limits_{j=1}^{n_i} x_{ij}}{n_i}
- Línea central: La línea central representa la media del proceso (µ).
\overline{\overline{X}} = \frac{∑x}{∑n}
- Límites de control:
- Límite inferior de control: El valor del límite inferior de control de cada subgrupo, i , se calcula de la siguiente manera:
LCL_i= µ- \frac{kσ}{√(n_i )}
- Límite superior de control: El valor del límite superior de control de cada subgrupo, i , se calcula de la siguiente manera:
- Límite superior de control: El valor del límite superior de control de cada subgrupo, i , se calcula de la siguiente manera:
UCL_i= µ+ \frac{kσ}{√(n_i )}
Fórmula de la gráfica R
- Puntos representados: Cada punto representado, r_i , es el rango del subgrupo i .
- Línea central: El valor de la línea central de cada subgrupo, \overline R_i , se calcula de la siguiente manera:
\overline R_i= d_2(n_i) × σ
- Límite de control:
- Límite inferior de control: El valor del límite inferior de control de cada subgrupo i es igual al mayor de los siguientes:
LCL_i= [d_2(n_i) × σ] - [kσ×d_3(n_i)]
o
LCL_i= 0
- Límite superior de control: El valor del límite superior de control de cada subgrupo i se calcula de la siguiente manera:
UCL_i= [d_2(n_i) × σ] + [kσ×d_3(n_i)]
Fórmula para la estimación de sigma (desviación estándar dentro de los subgrupos)
- Con frecuencia se supone por error que el σ utilizado en los cálculos anteriores es la desviación estándar muestral o poblacional habitual, que puede obtenerse con los cálculos estándar de una hoja de cálculo. Sin embargo, debe tenerse en cuenta que es una desviación estándar estimada, basada en el principio de que debe usarse únicamente la desviación estándar inherente al proceso, y debe excluirse la variación entre subgrupos. Hay dos métodos habituales para estimar la variación dentro de los subgrupos.
- Con el método Rbar: Se usa el rango de cada subgrupo, r_i , para calcular S_r , que es un estimador insesgado de σ:
S_r = \frac{\sum\limits_{i}^{} (\frac{f_i r_i}{d_2 (n_i)})}{\sum\limits_{i}^{} {f_i}}
donde
f_i = \frac{[d_2 (n_i)]^2}{[d_3 (n_i)]^2}
Cuando el tamaño del subgrupo es constante, la fórmula se simplifica a la siguiente:
S_r = \frac{\overline R}{d_2 (n_i)}
donde
\overline R = \frac{\sum r_i}{m}
- Con el método de la desviación estándar combinada (pooled): La desviación estándar combinada (Sp) viene dada por la siguiente fórmula.
S_p = \sqrt\frac{\sum\limits_{i}^{} \sum\limits_{j}^{} (x_{ij}-\overline x_i)^2 }{\sum\limits_{i}^{} (n_{i}-1)}
Cuando el tamaño del subgrupo es constante, Sp también puede calcularse de la siguiente manera:
S_p = \sqrt µ_ν
Fórmulas de las constantes de insesgadez
- Las constantes de insesgadez utilizadas en las fórmulas anteriores suelen obtenerse de tablas estadísticas estándar. Sin embargo, también puede usarse la siguiente fórmula para calcular los valores de las constantes de insesgadez.
- d_2 () : Para valores de N de 51 a 100, use la siguiente aproximación para d2(N):
d_2 (N) = 3.4873 + 0.0250141 × N - 0.00009823 × N^2
- d_3 () y d_4 () : Para valores de N de 26 a 100, use las siguientes aproximaciones para d3(N) y d4(N):
d_3 (N) = 0.80818 - 0.0051871 × N + 0.00005098×N^2 - 0.00000019 × N^3
d_4 (N) = 2.88606 + 0.051313 × N - 0.00049243×N^2 + 0.00000188 × N^3
- c_4 () y c_5 () :
c_4 (N) = {\sqrt \frac {2}{N-1}}\frac{Γ\frac{N}{2}}{Γ\frac{N-1}{2}}
c_5 (N) = \sqrt {1 - c_4(N)^2}
Preguntas frecuentes
¿Qué es una gráfica XBarra-R?
Una gráfica XBarra-R es un par de gráficas de control para datos continuos recopilados en subgrupos a intervalos establecidos. La gráfica XBarra monitorea la media del proceso y detecta desplazamientos en ella, mientras que la gráfica R monitorea la variación del proceso mediante el rango de cada subgrupo. Juntos muestran si el proceso es estable a lo largo del tiempo.
¿Cuándo debe usar una gráfica XBarra-R en lugar de una gráfica XBarra-S?
Use una gráfica XBarra-R cuando el tamaño del subgrupo sea mayor que uno y de 8 o menos. Para subgrupos de 9 o más observaciones, use una gráfica XBarra-S. Si no hay subgrupos, use una gráfica I-MR, y para recuentos de unidades defectuosas o de defectos use una gráfica por atributos, como una gráfica P o una gráfica U.
¿Cómo se calculan los límites de control de una gráfica XBarra-R?
En la gráfica XBarra, los límites de cada subgrupo son la media del proceso más o menos k veces sigma dividido entre la raíz cuadrada del tamaño del subgrupo, con k = 3 por defecto. En la gráfica R, la línea central es d2 por sigma, y los límites son d2 por sigma más o menos k por sigma por d3, con el límite inferior no menor que cero.
¿Cómo se estima sigma en una gráfica XBarra-R?
Sigma es la desviación estándar dentro de los subgrupos, no la desviación estándar muestral ordinaria, por lo que se excluye la variación entre subgrupos. Con el método Rbar y un tamaño de subgrupo constante, sigma es el rango promedio dividido entre d2. El método de la desviación estándar combinada usa, en cambio, el promedio ponderado de las varianzas de los subgrupos.