
Test t à un échantillon
Le test t à un échantillon vérifie si la moyenne d'une population diffère d'une cible, en estimant l'écart-type à partir de l'échantillon. Utilisez-le pour des données continues, échantillonnées au hasard et approximativement normales, ou avec un effectif d'échantillon supérieur à 20 sans forte asymétrie. Si l'écart-type de la population est connu, utilisez un test z à un échantillon. Les résultats incluent une valeur p et un intervalle de confiance ; une version pour données résumées existe.
Dernière révision
Point clé
Un test t à un échantillon compare la moyenne d'un échantillon à une valeur cible ou hypothétique lorsque l'écart-type de la population est inconnu, et fournit un intervalle de confiance de la moyenne de la population.
Sur cette page
- Qu'est-ce que le test t à un échantillon ?
- Quand utiliser le test t à un échantillon ?
- Recommandations pour bien utiliser le test t à un échantillon
- Alternatives : quand ne pas utiliser le test t à un échantillon
- Exemple de test t à un échantillon
- Comment réaliser un test t à un échantillon
- Comment réaliser un test t à un échantillon pour données résumées
Qu'est-ce que le test t à un échantillon ?
Un test t à un échantillon est un test statistique servant à estimer la moyenne d'une population et à la comparer à une valeur cible ou de référence lorsque l'écart-type de la population est inconnu. Ce test paramétrique détermine s'il existe une différence significative entre la moyenne de l'échantillon et une moyenne hypothétique de la population. Il calcule aussi un intervalle de confiance de la moyenne de la population, c'est-à-dire une plage de valeurs susceptible de contenir la vraie moyenne. Cette analyse est particulièrement utile pour de petits effectifs d'échantillon ou lorsque la variance de la population n'est pas connue.
Quand utiliser le test t à un échantillon ?
Le test t à un échantillon est approprié lorsque les conditions suivantes sont réunies :
- L'échantillon est sélectionné au hasard dans la population étudiée.
- Les données suivent approximativement une distribution normale (voir la condition d'effectif d'échantillon ci-dessous pour les données non normales).
- L'écart-type de la population est inconnu, mais peut être estimé à partir de l'échantillon.
- Les données suivent une distribution normale, ou l'effectif de l'échantillon est assez grand (supérieur à 20, avec des données sans forte asymétrie) pour que la distribution d'échantillonnage de la moyenne soit approximativement normale.
Voici des exemples de situations où utiliser un test t à un échantillon :
- Un chercheur veut tester si la taille moyenne d'un échantillon d'étudiants est la même que la taille moyenne des étudiants dans la population générale.
- Une entreprise veut tester si le temps moyen d'exécution d'une tâche est le même que la norme du secteur.
- Un médecin veut tester si un nouveau médicament a un effet significatif sur la baisse de la tension artérielle des patients.
Dans l'ensemble, le test t à un échantillon est un outil statistique puissant qui peut aider les chercheurs à tirer des conclusions sur des populations à partir d'un seul échantillon.
Recommandations pour bien utiliser le test t à un échantillon
- Utilisez le test z à un échantillon si vous connaissez l'écart-type de la population.
- Utilisez des données continues pour l'analyse, comme le poids de colis.
- Utilisez le test du taux de Poisson à un échantillon si les données sont des comptages, et le test de proportion à un échantillon si les données se classent en deux catégories.
- L'effectif de l'échantillon doit être supérieur à 20 et sans forte asymétrie pour un test d'hypothèse approprié.
- Prélevez des échantillons aléatoires pour faire des inférences sur la population.
- Test t apparié : à utiliser pour des données dépendantes ou appariées.
- L'effectif de l'échantillon doit être assez grand pour obtenir des estimations précises, des intervalles de confiance étroits et une protection contre les erreurs. Utilisez Puissance et effectif d'échantillon pour le test t à 1 échantillon afin de déterminer l'effectif de l'échantillon approprié.
Alternatives : quand ne pas utiliser le test t à un échantillon
- Si l'écart-type de la population est connu, il est recommandé d'utiliser le test z à un échantillon plutôt que le test t, car le premier a une puissance supérieure à celle du second.
Exemple de test t à un échantillon
Un économiste recueille les coûts énergétiques mensuels de 25 familles pour l'année en cours afin de déterminer s'il y a eu un changement par rapport à l'année précédente, où le coût moyen était de $200. Il réalise un test t à un échantillon pour vérifier si le coût énergétique de l'année en cours diffère significativement de $200. Le test se déroule selon les étapes suivantes :
- Rassemblez les données nécessaires.
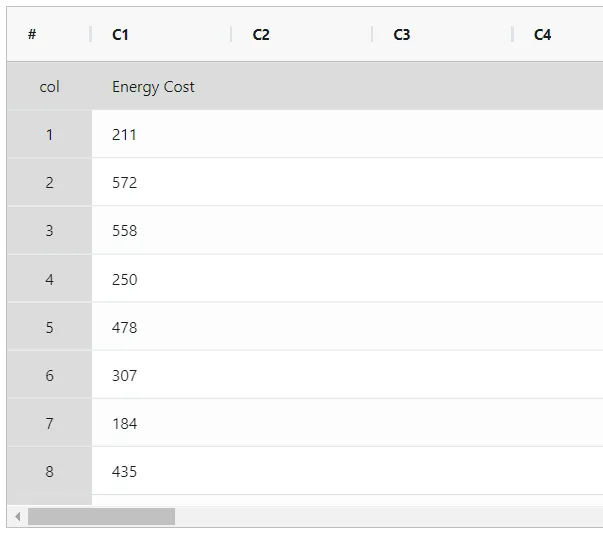
- Analysez ensuite les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
- Pour accéder au test t à un échantillon, choisissez Statistical module> Graphical analysis> One sample t-test.
- Dans l'outil, saisissez les données ainsi que les autres paramètres comme suit :
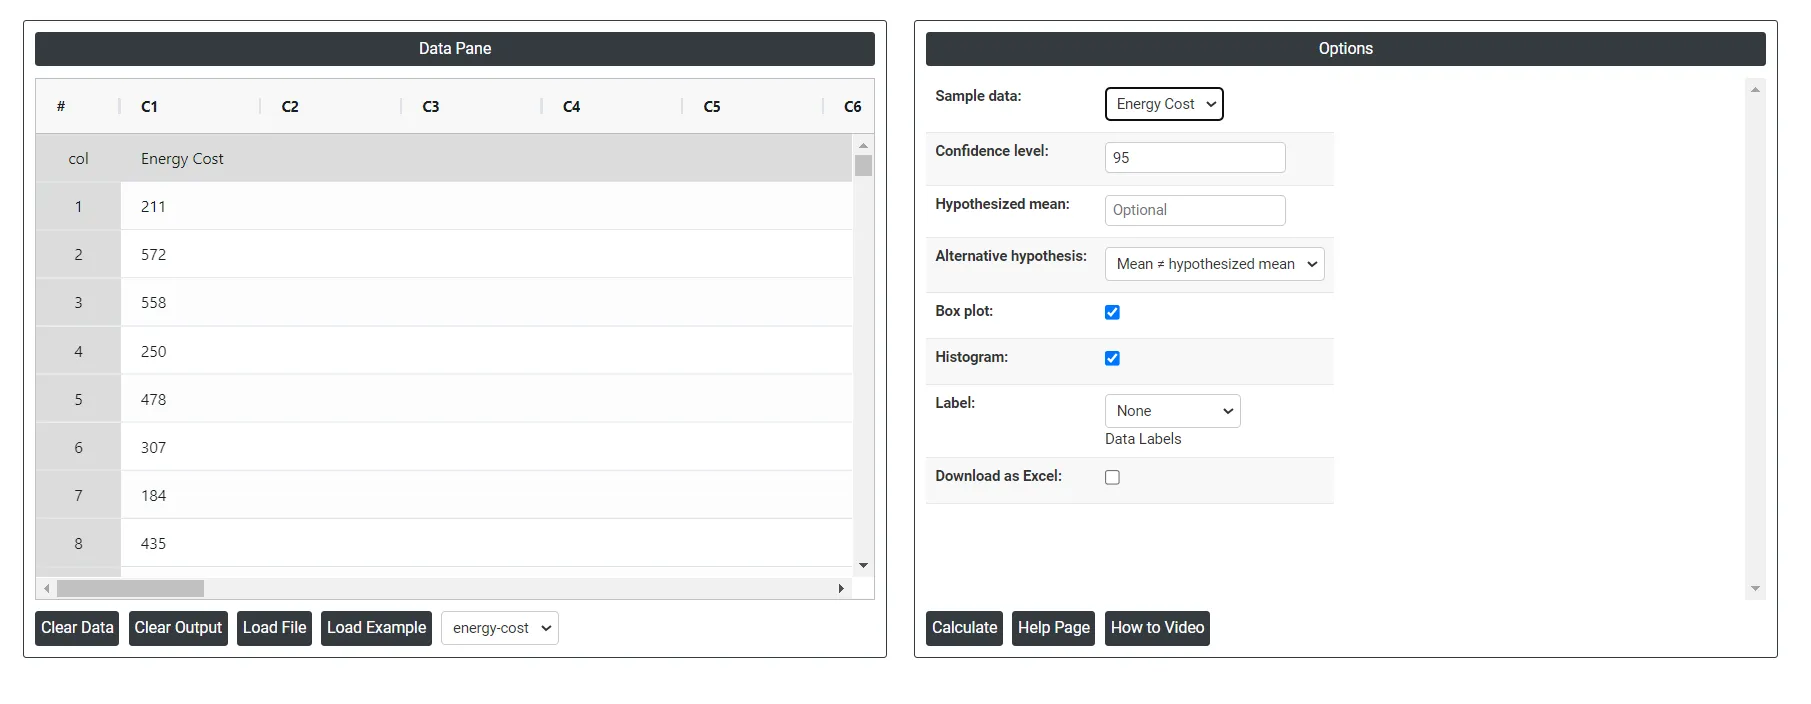
5. Une fois l'outil utilisé, vous obtenez les résultats suivants :
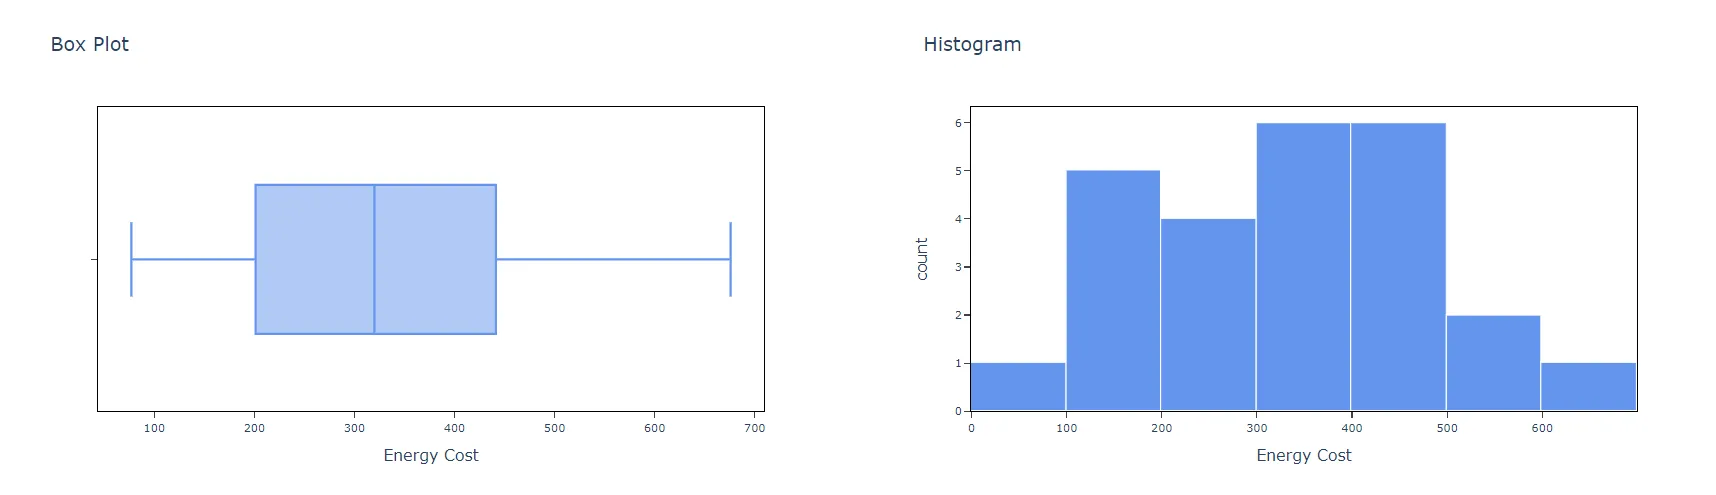
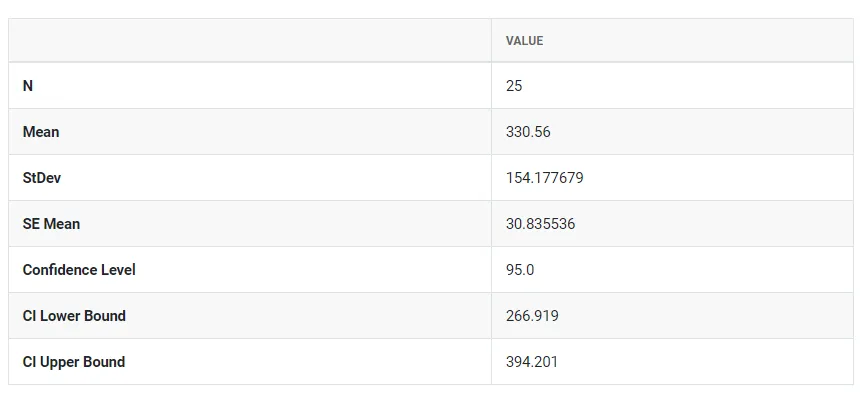
Comment réaliser un test t à un échantillon
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Graphical analysis >One sample t test.
- Cliquez sur One sample t test pour accéder au tableau de bord.
- Ensuite, saisissez les données manuellement ou copiez-les (Ctrl+C) depuis une feuille Excel et collez-les (Ctrl+V) ici.
- Ensuite, vous devez saisir les valeurs du niveau de confiance et de la moyenne hypothétique.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Le tableau de bord du test t à un échantillonest divisé en deux parties.
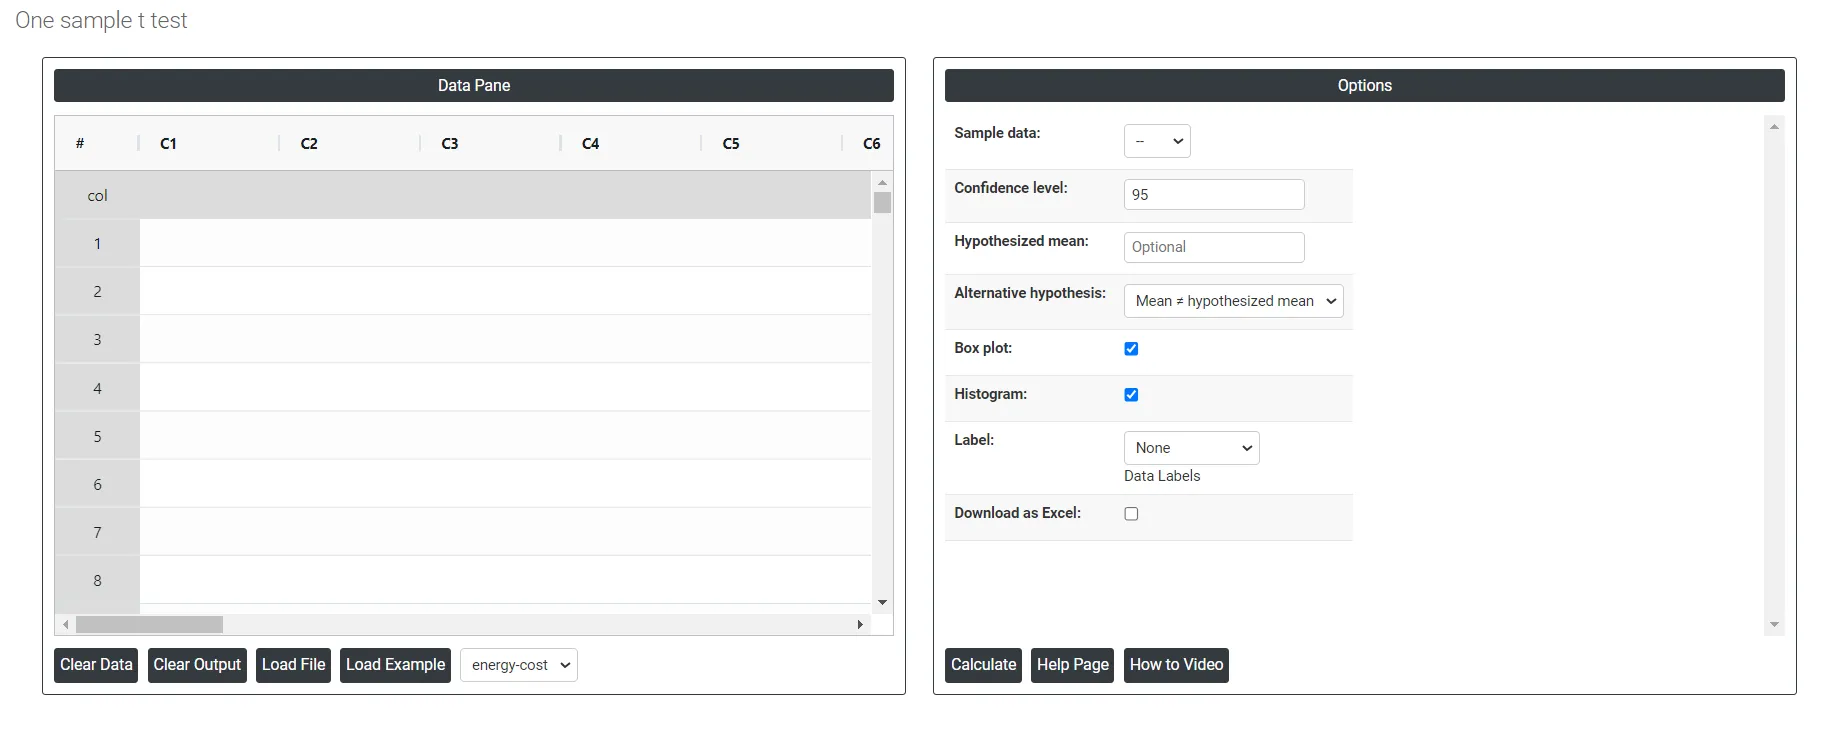
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement ou copiées (Ctrl+C) depuis une feuille Excel puis collées (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File : permet de charger directement des données Excel.
Dans la partie droite, vous trouvez de nombreuses options, présentées ci-dessous :
- Confidence level : dans un test d'hypothèse, le niveau de confiance représente le degré de certitude que nous accordons à notre analyse statistique. C'est une valeur de probabilité qui indique la vraisemblance que le vrai paramètre de la population se situe dans la plage de valeurs spécifiée. Le niveau de confiance est généralement exprimé en pourcentage et noté (1 - α), où α est le seuil de signification, c'est-à-dire la probabilité de rejeter une hypothèse nulle vraie. Par exemple, avec un niveau de confiance de 95%, nous disons que nous sommes sûrs à 95% que le vrai paramètre de la population se situe dans notre intervalle d'estimation, et qu'il y a 5% de risque de commettre une erreur de type I (rejeter une hypothèse nulle vraie). En pratique, un niveau de confiance plus élevé signifie que nous avons davantage confiance dans notre analyse statistique et dans les résultats. Toutefois, augmenter le niveau de confiance augmente aussi la largeur de l'intervalle de confiance, ce qui rend plus difficile la détection de petits effets. Le choix du niveau de confiance dépend donc du contexte de l'étude et des objectifs du chercheur.
- Hypothesized mean : la moyenne hypothétique, aussi appelée moyenne attendue ou moyenne de la population, est une valeur spécifiée dans l'hypothèse nulle qui représente la valeur moyenne de la variable testée. C'est une valeur théorique utilisée pour la comparer à la moyenne réelle de l'échantillon afin de déterminer si la différence est statistiquement significative ou due au hasard.
- Alternative hypothesis : dans un test d'hypothèse, l'hypothèse alternative (aussi appelée hypothèse de recherche) est un énoncé qui représente une conclusion différente de celle de l'hypothèse nulle. L'hypothèse nulle représente généralement le statu quo, c'est-à-dire l'hypothèse qu'il n'y a pas de différence ou de relation significative entre deux groupes ou variables, ou plus. L'hypothèse alternative est l'énoncé que l'on teste ; elle propose qu'il existe une différence ou une relation significative entre les groupes ou variables étudiés.
- Box Plot : si la case est cochée, la boîte à moustaches (box plot) est affichée ; sinon, elle ne l'est pas.
- Histogram : si la case est cochée, l'histogramme est affiché ; sinon, il ne l'est pas.
- Label : ajoute des étiquettes de données, avec trois options :
- Outlier: des valeurs de données éloignées des autres valeurs, qui peuvent influencer fortement vos résultats.
- All quartiles: les quartiles sont des valeurs qui divisent un échantillon de données en quatre parties égales. Ils permettent d'évaluer rapidement la dispersion et la tendance centrale d'un jeu de données.
- Mean: la moyenne dans une boîte à moustaches, pour fournir une information supplémentaire sur la tendance centrale des données.
- Individual Data : un point de données individuel est une observation ou une valeur unique dans un jeu de données.
- Download as Excel: affiche le résultat au format Excel ; il peut être facilement modifié puis rechargé pour de nouveaux calculs avec l'option Load File.
Comment réaliser un test t à un échantillon pour données résumées
La marche à suivre est la suivante :
- Connectez-vous à Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Graphical analysis >One sample t test for summarized data
- Cliquez sur One sample t test for summarized data pour accéder au tableau de bord.
- Ensuite, saisissez les données manuellement ou copiez-les (Ctrl+C) depuis une feuille Excel et collez-les (Ctrl+V) ici.
- Ensuite, vous devez saisir les valeurs de l'effectif de l'échantillon, de la moyenne de l'échantillon, de l'écart-type, de la moyenne hypothétique et du niveau de confiance.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Le tableau de bord du test t à un échantillon pour données résuméesne comporte que la partie gauche.
Load File : permet de charger directement des données Excel.
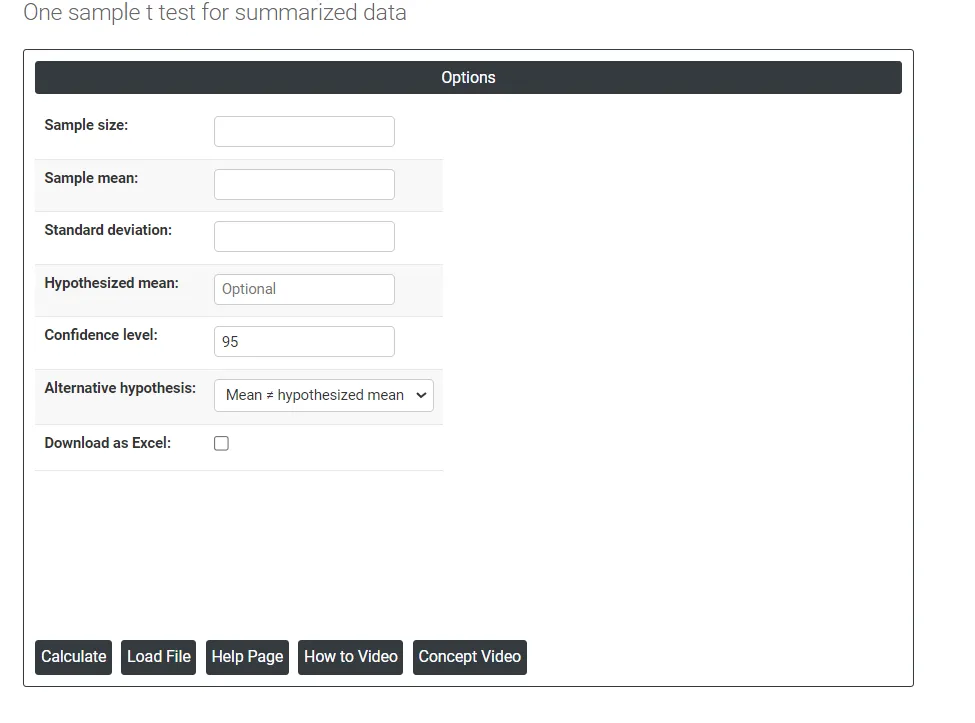
Dans la partie gauche, vous trouvez de nombreuses options, présentées ci-dessous :
- Sample size : l'effectif de l'échantillon désigne le nombre d'individus, d'objets ou d'événements sélectionnés dans une population pour être étudiés afin de tirer des conclusions sur l'ensemble de la population. Autrement dit, c'est le nombre d'observations ou de participants inclus dans une étude. L'effectif de l'échantillon peut avoir un impact important sur l'exactitude et la fiabilité des résultats de l'étude. Un échantillon plus grand donne généralement une image plus représentative de la population et aide à réduire les effets de l'erreur d'échantillonnage aléatoire. Il est donc important de déterminer un effectif d'échantillon approprié avant de mener la recherche, afin que les résultats soient statistiquement valides et fiables.
- Sample mean : la moyenne de l'échantillon est la valeur moyenne d'un ensemble d'observations ou de points de données sélectionnés dans une population plus grande. Elle se calcule en additionnant toutes les valeurs de l'échantillon et en divisant par le nombre d'observations. La moyenne de l'échantillon sert souvent d'estimateur de la moyenne de la population, qui est la valeur moyenne de l'ensemble de la population.
- Standard deviation : dans un test d'hypothèse, l'écart-type est une mesure de la variabilité des données. Il est souvent utilisé avec la moyenne pour évaluer si la différence observée entre deux groupes est statistiquement significative.
- Hypothesized mean : la moyenne hypothétique, aussi appelée moyenne attendue ou moyenne de la population, est une valeur spécifiée dans l'hypothèse nulle qui représente la valeur moyenne de la variable testée. C'est une valeur théorique utilisée pour la comparer à la moyenne réelle de l'échantillon afin de déterminer si la différence est statistiquement significative ou due au hasard.
- Confidence level : dans un test d'hypothèse, le niveau de confiance représente le degré de certitude que nous accordons à notre analyse statistique. C'est une valeur de probabilité qui indique la vraisemblance que le vrai paramètre de la population se situe dans la plage de valeurs spécifiée. Le niveau de confiance est généralement exprimé en pourcentage et noté (1 - α), où α est le seuil de signification, c'est-à-dire la probabilité de rejeter une hypothèse nulle vraie. Par exemple, avec un niveau de confiance de 95%, nous disons que nous sommes sûrs à 95% que le vrai paramètre de la population se situe dans notre intervalle d'estimation, et qu'il y a 5% de risque de commettre une erreur de type I (rejeter une hypothèse nulle vraie). En pratique, un niveau de confiance plus élevé signifie que nous avons davantage confiance dans notre analyse statistique et dans les résultats. Toutefois, augmenter le niveau de confiance augmente aussi la largeur de l'intervalle de confiance, ce qui rend plus difficile la détection de petits effets. Le choix du niveau de confiance dépend donc du contexte de l'étude et des objectifs du chercheur.
- Download as Excel: affiche le résultat au format Excel ; il peut être facilement modifié puis rechargé pour de nouveaux calculs avec l'option Load File.
Questions fréquentes
Qu'est-ce qu'un test t à un échantillon ?
Un test t à un échantillon est un test paramétrique qui estime la moyenne d'une population et la compare à une valeur cible ou de référence lorsque l'écart-type de la population est inconnu. Il détermine si la moyenne de l'échantillon diffère significativement de la moyenne hypothétique et calcule un intervalle de confiance de la moyenne de la population.
Quelles sont les hypothèses d'un test t à un échantillon ?
L'échantillon doit être sélectionné au hasard dans la population, les données doivent être continues, et l'écart-type de la population est inconnu mais estimé à partir de l'échantillon. Les données doivent être approximativement normales, ou l'effectif de l'échantillon assez grand, supérieure à 20 avec des données sans forte asymétrie, pour que la distribution d'échantillonnage de la moyenne soit approximativement normale. Pour des données appariées, utilisez un test t apparié.
Quand utiliser un test z à un échantillon plutôt qu'un test t ?
Si l'écart-type de la population est connu, utilisez le test z à un échantillon, qui a une puissance supérieure à celle du test t. Pour des données de comptage, utilisez le test 1-Sample Poisson Rate, et pour des données classées en deux catégories, le test One Proportion.
Comment réaliser un test t à un échantillon dans Zometric Statistical Software ?
Ouvrez l'outil One sample t test, saisissez ou collez les données, puis réglez le niveau de confiance, la moyenne hypothétique et l'hypothèse alternative, avec la boîte à moustaches et l'histogramme en option. Cliquez sur Calculate pour obtenir les résultats. Une version pour données résumées accepte à la place des données brutes l'effectif de l'échantillon, la moyenne de l'échantillon, l'écart-type, la moyenne hypothétique et le niveau de confiance.