
Zusätzliche Funktionen für den Bioassay mit 4-Parameter-Logistik-Modell
Diese Erweiterung der Four-Parameter Logistic Method fügt eine Einstellung für den Fehlerterm von ANOVA / CI hinzu. Sequential (Standard) gibt jedem F-Test sein eigenes Residuum aus dem geschachtelten Modell; Pure Error verwendet das Residuum des saturierten Modells für alle drei F-Tests zur Gültigkeit (Regression, Nichtparallelität, Lack of Fit) und das Konfidenzintervall der Wirksamkeit, wie es EP-5.3-Software tut. Pure Error erfordert Wiederholungen. Kurvenparameter und Wirksamkeitsschätzung bleiben unverändert.
Zuletzt geprüft
Kernaussage
Die Fehlerterm-Option des 4PL-Bioassays legt fest, ob die F-Tests zur Gültigkeit und das Konfidenzintervall der Wirksamkeit sequenzielle geschachtelte Residuen oder einen einzigen reinen Fehlerterm nutzen, wie in EP 5.3.
Auf dieser Seite
- Bioassay – Four-Parameter Logistic Method
- Was hinzugefügt wurde
- Regulatorischer und statistischer Hintergrund
- Die Mathematik
- Begründung: Warum zwei Konventionen, und wann welche verwenden?
- Was sich in der Ausgabe ändert und was nicht
- Wo Sie diese Funktion finden
- Verifizierung anhand veröffentlichter Referenzdaten
- Literatur
Bioassay – Four-Parameter Logistic Method
Hinzugefügte Funktion: optionaler Fehlerterm für ANOVA / Konfidenzintervall ("Sequential" vs. "Pure Error")
Was hinzugefügt wurde
Die Four-Parameter Logistic Method erhält dieselbe Art optionaler Fehlerterm-Konvention, die bereits für die Parallel-Line- und die Slope-Ratio-Methode hinzugefügt wurde, angepasst an die eigene Modellstruktur dieser Methode. Sie steuert, welcher Varianzschätzer gemeinsam in alle drei F-Tests zur Gültigkeit und in das Konfidenzintervall der Wirksamkeit eingeht (statt nur in das Konfidenzintervall wie bei den beiden linearen Methoden) – entsprechend dem Aufbau der ANOVA dieser Methode. Die angepassten Kurvenparameter und der Punktschätzer der Wirksamkeit bleiben in beiden Fällen unberührt.
Regulatorischer und statistischer Hintergrund
Ein Assay mit 4-Parameter-Logistik-Modell (4PL) passt an die Zielgröße jeder Zubereitung gegen die logarithmierte Dosis eine sigmoide Kurve an, die durch eine obere Asymptote, eine untere Asymptote, einen Steigungsfaktor und einen Wendepunkt bestimmt ist. Für die Gültigkeitstests werden drei geschachtelte Modelle verglichen: ein Nullmodell (waagerechte Linie), ein Modell, in dem alle Zubereitungen eine gemeinsame Kurvenform teilen (nur der Wendepunkt darf sich unterscheiden, woraus sich die Wirksamkeitsschätzung ergibt), und eine vollständig getrennte Kurve, die für jede Zubereitung unabhängig angepasst wird.
Wie bei den anderen Bioassay-Methoden bildet kommerzielle Software, die dem Europäischen Arzneibuch (Ph. Eur.), Kapitel 5.3 – "Statistical Analysis of Results of Biological Assays and Tests" – entspricht, üblicherweise alle drei F-Tests zur Gültigkeit und das Konfidenzintervall der Wirksamkeit aus einem einzigen gemeinsamen Fehlervarianzterm – ihre Konvention der "Pure-error ANOVA". Der bisherige Standard dieses Werkzeugs gibt dagegen jedem F-Test seinen eigenen, lokal passenderen Fehlerterm.
Die Mathematik
Konvention A – "Sequential" (der bisherige Standard dieses Werkzeugs). Jeder der drei F-Tests wird aus dem konkreten Paar geschachtelter Modelle gebildet, zwischen denen er testet, wobei die eigene Residualvarianz dieses Vergleichs als Nenner dient:
F(Regression) = MS(durch gemeinsame Kurve vs. waagerechte Linie erklärt) / MS(Residuum der Anpassung mit gemeinsamer Kurve)
F(Nichtparallelität) = MS(durch getrennte Kurven vs. gemeinsame Kurve erklärt) / MS(Residuum der Anpassung mit getrennten Kurven)
F(Lack of Fit) = MS(durch saturierte Anpassung vs. getrennte Kurven erklärt) / MS(Residuum der saturierten Anpassung, d. h. reiner Fehler)
und das Konfidenzintervall der Wirksamkeit verwendet ebenso das eigene Residuum des Modells mit gemeinsamer Kurve – wobei ein geringer, nicht signifikanter Anteil an Nichtparallelität mit einfließt.
Konvention B – "Pure Error" (die neue Option; die "Pure-error ANOVA" nach EP 5.3). Alle drei F-Tests und das Konfidenzintervall der Wirksamkeit teilen sich stattdessen durchgehend einen einzigen Nenner – das Residuum der vollständig saturierten Anpassung mit einer Kurve je Zubereitung/Dosisgruppe:
F(jeder Test) = MS(durch den Vergleich dieses Tests erklärt) / MS(reiner Fehler, aus der saturierten Anpassung) – jedes Mal derselbe Nenner
Begründung: Warum zwei Konventionen, und wann welche verwenden?
Die beiden Konventionen beantworten leicht unterschiedliche Fragen, genau wie bei den beiden linearen Methoden: Bei der sequenziellen Konvention wird die Signifikanz jedes Tests an der Streuung beurteilt, die für den jeweiligen Vergleich maßgeblich ist, während die Konvention des reinen Fehlers jedem Test dieselbe Grundfrage stellt – "Wie verhält sich diese Abweichung zum reinen Wiederholrauschen, ohne dass etwas anderes eingerechnet wird?" – und zusätzlich das Konfidenzintervall der Wirksamkeit an genau diese, kleinstmögliche Fehlerschätzung bindet.
Bei einem gut angepassten, gültigen Assay ist der Unterschied zwischen beiden meist gering. Deutlicher wird er bei einem mäßigen, nicht signifikanten Anteil an Nichtparallelität oder Lack of Fit, da die sequenzielle Konvention diese zusätzliche Streuung in den Fehlerterm des betreffenden Tests (und des Wirksamkeitsintervalls) einbezieht, während die Konvention des reinen Fehlers sie überall bewusst ausschließt.
Wie bei den anderen Methoden dient die Auswahl von "Pure Error" vor allem dazu, Ergebnisse mit EP-5.3-konformer kommerzieller Software oder einer validierten Altmethode abzugleichen, die auf deren Konvention der Pure-error ANOVA beruht. Der bisherige sequenzielle Standard des Werkzeugs bleibt eine voll gültige Wahl, wenn kein solcher externer Vergleich erforderlich ist.
Was sich in der Ausgabe ändert und was nicht
Betroffen:
- F-Wert und p-Wert für alle drei Gültigkeitstests (Regression, Nichtparallelität, Lack of Fit)
- Eine neue Spalte "Error Term" in der ANOVA-Tabelle, die angibt, welche Konvention und welche Freiheitsgrade verwendet wurden
- Lower CL und Upper CL des Konfidenzintervalls der Wirksamkeit sowie eine neue Spalte "CI Error Term"
Nicht betroffen:
- Die angepassten Kurvenparameter (obere/untere Asymptote, Steigungsfaktor, Wendepunkt) für jede Zubereitung
- Das geschätzte Verhältnis der relativen Wirksamkeit
- Die für jede Zubereitung angezeigte angepasste Modellgleichung
Wo Sie diese Funktion finden
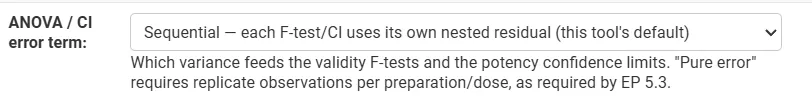
Im Eingabeformular des Werkzeugs Four-Parameter Logistic Method bietet ein Feld mit der Bezeichnung "ANOVA / CI error term" die Wahl zwischen "Sequential — each F-test/CI uses its own nested residual (this tool's default)" und "Pure error — single saturated-model residual for all F-tests and the CI (EP 5.3 default)". Die Option des reinen Fehlers setzt voraus, dass das saturierte Modell (eine Anpassung je Zubereitung/Dosisgruppe) mindestens einen Residual-Freiheitsgrad hat, d. h. dass die Daten Wiederholungen enthalten.
Verifizierung anhand veröffentlichter Referenzdaten
Diese Option wurde anhand eines veröffentlichten serologischen Assays von Tetanus-Antitoxin geprüft, in dem ein Standard und eine Testserum-Zubereitung über zehn zweifache Verdünnungsstufen mit zwei Wiederholungen je Dosis verglichen werden.
Quelle: Europäisches Arzneibuch, 5. Ausgabe (2005), Kapitel 5.3, Beispiel 5.4.1.a – wiedergegeben im veröffentlichten Beispielbericht PLA 3.0 von Stegmann Systems (Document-3567, "PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf")
Kennzahl | Veröffentlicht (PLA/EP 5.3) | Berechnet (Option Pure Error) |
F Regression (df=3) | 9785.4821 | 9788.5262 |
F Nichtparallelität (df=3) | 0.48912 | 0.4884 |
F Lack of Fit (df=12) | 0.62266 | 0.6216 |
Wirksamkeitsverhältnis | 1.45886 | 1.45880 (gerundet: 1.4588) |
Geschätzte Wirksamkeit der Probe (IU/ml) | 0.58354 | 0.5835 |
95% KI (Wirksamkeit der Probe, IU/ml) | 0.55511 – 0.61343 | 0.5544 – 0.6127 |
Die Kurvenformparameter (obere/untere Asymptote, Steigungsfaktor, Wendepunkte) und der Punktschätzer der Wirksamkeit stimmten unter beiden Konventionen nahezu exakt mit dem veröffentlichten Bericht überein, was bestätigt, dass die Anpassung selbst – wie beabsichtigt – von dieser Option unberührt bleibt. Die mit der Option des reinen Fehlers berechneten F-Werte und das Konfidenzintervall liegen nahe an den veröffentlichten Werten; eine kleine Restdifferenz (vor allem im Konfidenzintervall sichtbar) ist darauf zurückzuführen, dass der veröffentlichte Bericht seine Zwischenwerte vor der Endberechnung auf drei Dezimalstellen rundet. Der bisherige sequenzielle Standard des Werkzeugs sollte erwartungsgemäß nicht mit diesem Bericht zur "Pure-error ANOVA" übereinstimmen und wurde separat auf innere Konsistenz geprüft.
Literatur
- Europäisches Arzneibuch (Ph. Eur.), Kapitel 5.3 – "Statistical Analysis of Results of Biological Assays and Tests" (5. Ausgabe, 2005, und Folgeausgaben).
- United States Pharmacopeia, General Chapter <111> – "Design and Analysis of Biological Assays".
- Stegmann Systems GmbH, veröffentlichtes Beispiel zu PLA 3.0: "PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf" – https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel_logistic_potency_assays__3PL__4PL__5PL_/PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf
Häufig gestellte Fragen
Was ist ein Bioassay mit 4-Parameter-Logistik-Modell (4PL)?
Ein 4PL-Assay passt an die Zielgröße jeder Zubereitung gegen die logarithmierte Dosis eine sigmoide Kurve an, die durch obere Asymptote, untere Asymptote, Steigungsfaktor und Wendepunkt definiert ist. Die Gültigkeitstests vergleichen ein Modell mit waagerechter Linie, ein Modell mit gemeinsamer Kurvenform, in dem sich nur der Wendepunkt unterscheidet und das die Wirksamkeitsschätzung liefert, sowie vollständig getrennte Kurven für jede Zubereitung.
Was ist der Unterschied zwischen sequenzieller ANOVA und Pure-Error-ANOVA in einem 4PL-Assay?
Bei der sequenziellen Konvention verwendet jeder F-Test das Residuum der konkreten geschachtelten Modelle, die er vergleicht, und das Wirksamkeitsintervall verwendet das Residuum der gemeinsamen Kurve. Bei der Konvention des reinen Fehlers teilen sich alle drei F-Tests und das Wirksamkeitsintervall einen Nenner: das Residuum der vollständig saturierten Anpassung. Angepasste Kurve und Wirksamkeitsschätzung sind in beiden Fällen gleich.
Wann sollten Sie bei einem 4PL-Assay die Option des reinen Fehlers verwenden?
Verwenden Sie den reinen Fehler vor allem, um Ergebnisse mit EP-5.3-konformer Software oder einer validierten Altmethode abzugleichen, die auf deren Konvention der Pure-Error-ANOVA beruht. Bei einem gut angepassten, gültigen Assay unterscheiden sich die beiden Konventionen meist kaum. Der Unterschied wächst bei einem mäßigen, nicht signifikanten Anteil an Nichtparallelität oder Lack of Fit. Ansonsten bleibt der sequenzielle Standard gültig.
Wie wählen Sie den Fehlerterm in Zometric Statistical Software aus?
Wählen Sie im Eingabeformular der Four-Parameter Logistic Method im Feld ANOVA / CI error term entweder Sequential (Standard) oder Pure error. Die Option des reinen Fehlers setzt voraus, dass das saturierte Modell mindestens einen Residual-Freiheitsgrad hat, d. h. die Daten müssen Wiederholungen enthalten.