
ARIMA (Box-Jenkins-Prognose)
ARIMA modelliert eine in gleichen Abständen gemessene Reihe mit autoregressiven (p), Differenzen- (d) und Moving-Average-Termen (q), optional mit saisonalen Termen (P, D, Q, s) und einer Konstanten. Einsatz, wenn Werte von früheren Werten abhängen oder die Reihe Trend oder Saison aufweist. ACF- und PACF-Diagramme leiten die Wahl der Ordnungen. Die Ausgabe umfasst Parameterschätzungen, Ljung-Box-Tests, Residuen-ACF/PACF, MAPE, MAD, MSD und Prognosen mit Prognosegrenzen.
Zuletzt geprüft
Kernaussage
ARIMA passt ein autoregressives integriertes Moving-Average-Modell nach Box-Jenkins an eine äquidistante Zeitreihe an und prognostiziert künftige Werte mit Prognoseintervallen; erfasst werden Übertrag, Trend und Saisonalität.
Auf dieser Seite
Zweck
ARIMA passt ein autoregressives integriertes Moving-Average-Modell nach Box-Jenkins an eine Reihe an, die in gleichen Zeitabständen gemessen wird (täglich, wöchentlich, monatlich), und prognostiziert die nächsten Werte mit Prognoseintervallen. Setzen Sie es ein, wenn jeder Wert von den vorhergehenden Werten abhängt oder die Reihe einen Trend oder eine wiederkehrende Saison aufweist, die einfachere Verfahren wie gleitende Durchschnitte oder exponentielle Glättung nicht gut erfassen. Die Diagramme der Autokorrelation (ACF) und der partiellen Autokorrelation (PACF) der Reihe helfen, die Modellordnungen vor der Berechnung festzulegen.
Wichtige Funktionen
- Nicht saisonale autoregressive Terme (p), Differenzenterme (d) und Moving-Average-Terme (q) sowie saisonale Terme (P, D, Q) für jede beliebige Saisonperiode, z. B. 12 für Monatsdaten mit Jahresmuster oder 7 für Tagesdaten mit Wochenmuster.
- Optionaler konstanter Term: das mittlere Niveau einer nicht differenzierten Reihe oder die mittlere Drift (der Trend) einer differenzierten Reihe.
- Parameterschätzungen mit Standardfehlern, T-Werten und p-Werten, sodass Sie nicht benötigte Terme entfernen können.
- Residuenprüfung: Residuenquadratsumme und mittleres Residuenquadrat, modifizierte Box-Pierce-Chi-Quadrat-Tests (Ljung-Box) bei den Lags 12, 24, 36 und 48 sowie ACF- und PACF-Diagramme der Residuen.
- Prognosen mit unterer und oberer Prognosegrenze zum gewählten Konfidenzniveau; mit einem Prognoseursprung können Sie ab einer früheren Zeile prognostizieren und die Prognosen mit den tatsächlichen Werten vergleichen.
- Maße der Anpassungsgüte MAPE, MAD und MSD, vergleichbar mit den anderen Zeitreihenwerkzeugen.
- Optionale zusätzliche Ausgabe: Schätzungen in jeder Iteration, die Korrelationsmatrix der geschätzten Parameter, die Rückwärtsprognosen und ein Vier-in-eins-Residuendiagramm.
Statistische Methoden
Das Modell lautet φ(B)Φ(Bˢ)(1−B)ᵈ(1−Bˢ)ᴰ yₜ = C + θ(B)Θ(Bˢ) aₜ. Dabei ist B der Rückwärtsverschiebungsoperator, φ und θ sind die nicht saisonalen AR- und MA-Polynome der Ordnungen p und q, Φ und Θ die saisonalen AR- und MA-Polynome der Ordnungen P und Q in Bˢ, s ist die Saisonperiode, C die Konstante und aₜ sind die Residuen (zufällige Störungen). Die Differenzenbildung (1−B)ᵈ(1−Bˢ)ᴰ entfernt Trend und Saison, bevor die AR- und MA-Terme angepasst werden; dadurch gehen am Anfang der Reihe d + D·s Beobachtungen verloren.
Die Parameter werden mit dem Kleinste-Quadrate-Verfahren nach Box-Jenkins mit Rückwärtsprognosen geschätzt: Startwerte werden iterativ verfeinert, um die Summe der quadrierten Residuen zu minimieren, wobei die Reihe rückwärts prognostiziert wird, um ihre Werte vor dem Stichprobenbeginn zu liefern. Das mittlere Residuenquadrat ist MS = SS / DF mit DF = Anzahl der differenzierten Beobachtungen − Anzahl der geschätzten Parameter. Der T-Wert jedes Koeffizienten ist der Koeffizient geteilt durch seinen Standardfehler; der p-Wert stammt aus der t-Verteilung mit den Residuen-DF. Bei einem nicht differenzierten Modell mit Konstante wird zusätzlich der Prozessmittelwert C / (φ(1)Φ(1)) ausgegeben.
Die Ljung-Box-Statistik Q = n(n+2) Σ rₖ² / (n−k) wird aus den Residuen-Autokorrelationen rₖ bis zum jeweiligen Lag berechnet und mit einer Chi-Quadrat-Verteilung verglichen, deren DF gleich dem Lag minus der Anzahl der geschätzten Parameter sind; ein p-Wert über 0.05 bedeutet, dass es keinen Hinweis auf verbleibende Autokorrelation in den Residuen gibt. Prognosen werden rekursiv aus der angepassten Gleichung berechnet; das Prognoseintervall für h Perioden im Voraus ist die Prognose ± z·√(MS·Σψⱼ²), summiert über die ersten h ψ-Gewichte des Modells, sodass die Intervalle mit dem Prognosehorizont breiter werden.
Eingabefelder und Optionen
Feld | Beschreibung |
Variable (Y) | Pflichtfeld. Die Spalte mit der Reihe, in zeitlicher Reihenfolge und in gleichen Abständen. |
Autoregressive order (p) | Anzahl der nicht saisonalen AR-Terme (0 bis 10, Standard 1): wie viele vorherige Werte in den aktuellen Wert übertragen werden. |
Difference order (d) | Anzahl der nicht saisonalen Differenzen (0 bis 3, Standard 0). Verwenden Sie 1 für eine Reihe mit einem Trend, der wandert oder wächst. |
Moving average order (q) | Anzahl der nicht saisonalen MA-Terme (0 bis 10, Standard 0): wie viele vorherige zufällige Störungen übertragen werden. |
Include seasonal terms | Aktivieren, um die unten stehenden saisonalen Ordnungen hinzuzufügen. Das Modell benötigt insgesamt mindestens einen AR- oder MA-Term. |
Seasonal AR order (P) / Seasonal difference order (D) / Seasonal MA order (Q) | Saisonale Ordnungen (P und Q 0 bis 5, D 0 bis 2). D = 1 modelliert die Veränderung gegenüber dem Vorjahr bei Monatsdaten mit s = 12. |
Seasonal period (s) | Bei saisonalen Termen erforderlich: die Anzahl der Beobachtungen in einer Saison (12 für Monatsdaten mit Jahreszyklus, 4 für Quartalsdaten, 7 für Tagesdaten mit Wochenzyklus). |
Include constant term | Standardmäßig aktiviert. Deaktivieren Sie die Option bei einer differenzierten Reihe ohne Drift. |
Number of forecasts | Wie viele Perioden nach dem Prognoseursprung prognostiziert werden (0 bis 1000; 0 = keine Prognosen). |
Confidence level (%) for forecast interval | Standard 95. |
Forecast origin (row) | Optional. Die Prognosen beginnen nach dieser Zeile und verwenden die Daten bis zu ihr; leer = Ende der Reihe. Damit können Sie das Modell an bereits vorhandenen Daten testen. |
Results to display | Endgültige Schätzungen, Angaben zur Differenzenbildung, Residuenquadratsummen, Anzahl der Beobachtungen; oder zusätzlich die Schätzungen in jeder Iteration, die Korrelationsmatrix der geschätzten Parameter oder die Rückwärtsprognosen. |
Residual plots (four in one) | Fügt ein Normalverteilungs-Wahrscheinlichkeitsnetz, Residuen gegen angepasste Werte, ein Histogramm und Residuen gegen Reihenfolge hinzu. |
Title | Titel, der in der Ausgabe angezeigt wird. |
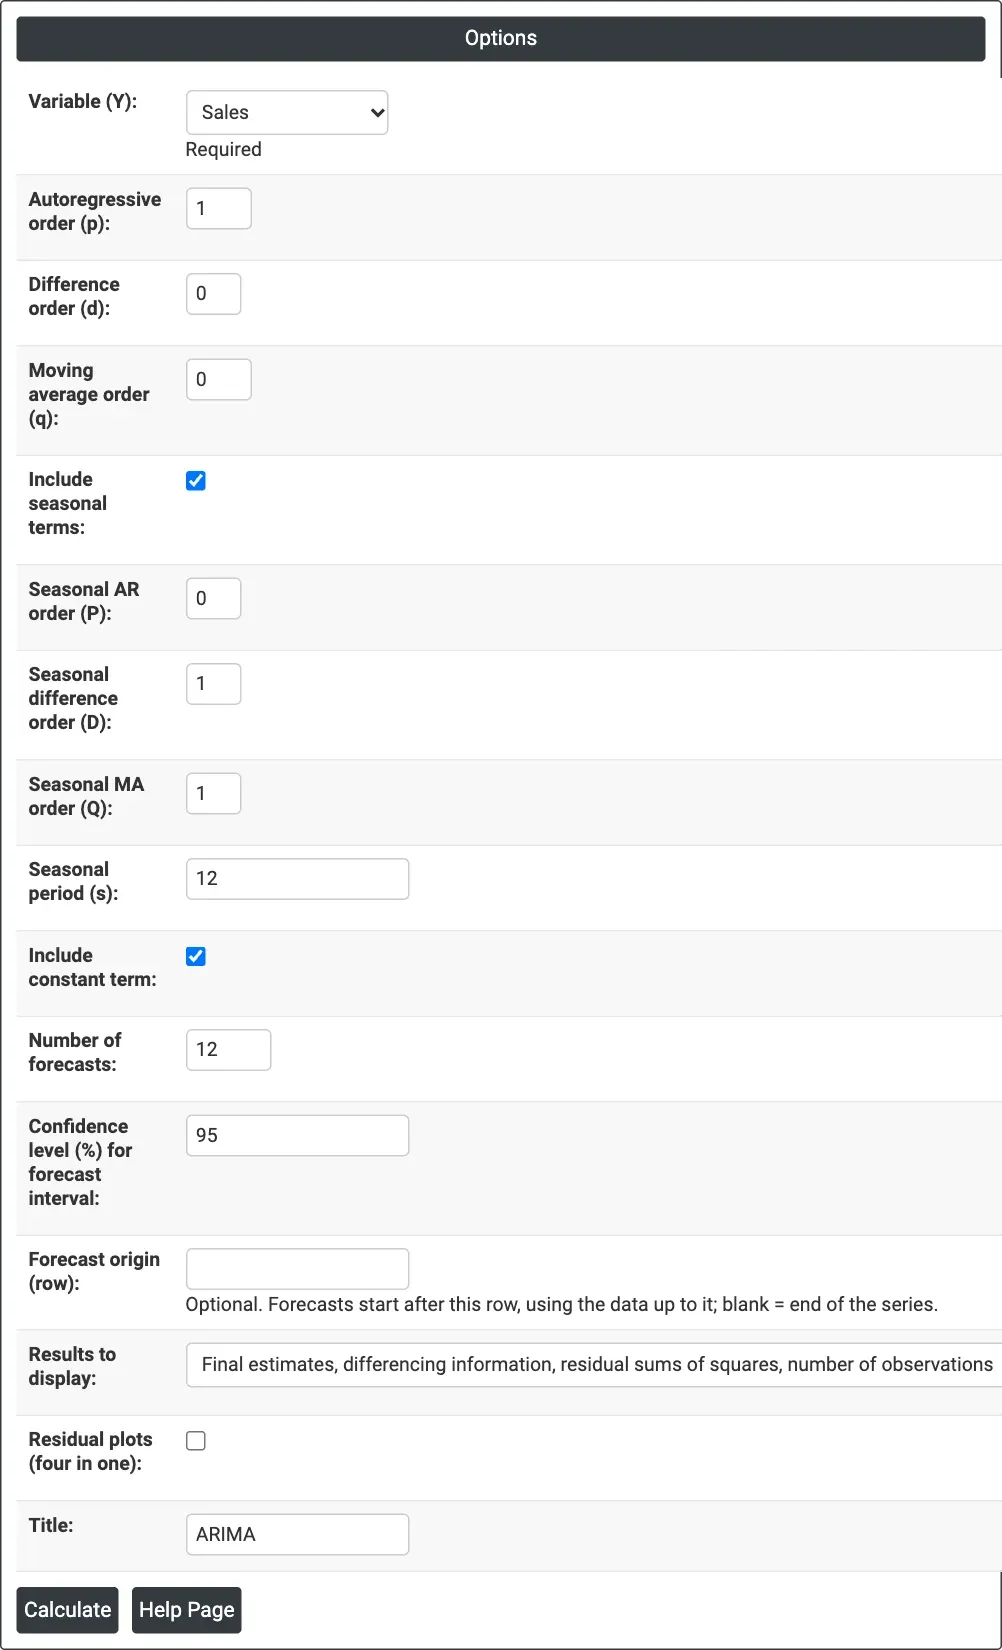
Abbildung 1 – Das Beispiel der Monatsumsätze: Variable (Y) = Sales, ein saisonales ARIMA(1, 0, 0)(0, 1, 1)12-Modell mit Konstante und 12 Prognosen.
Beschreibung der Ausgabe
- ARIMA-Diagramm – die Reihe mit den angepassten Werten, den Prognosen und dem Band ihres Prognoseintervalls; MAPE, MAD und MSD werden unter dem Titel angezeigt.
- Final Estimates of Parameters – jeder AR-, SAR-, MA- und SMA-Term sowie die Konstante, mit Coefficient, SE Coef, T-Value und P-Value (und dem Mean bei einem nicht differenzierten Modell mit Konstante).
- Residual Sums of Squares – DF, SS und MS der Residuen.
- Modified Box-Pierce (Ljung-Box) Chi-Square statistic – Chi-Square, DF und P-Value bei den Lags 12, 24, 36 und 48 (Lags, die länger als die Reihe sind, entfallen).
- Forecasts – Periode, Prognose sowie untere und obere Prognosegrenze.
- ACF and PACF of Residuals – Balken innerhalb der gestrichelten Grenzen bedeuten, dass keine Autokorrelation verbleibt.
- Optionale Tabellen und Diagramme, die unter Results to display und Residual plots ausgewählt wurden, sowie PDF-Export über Download.
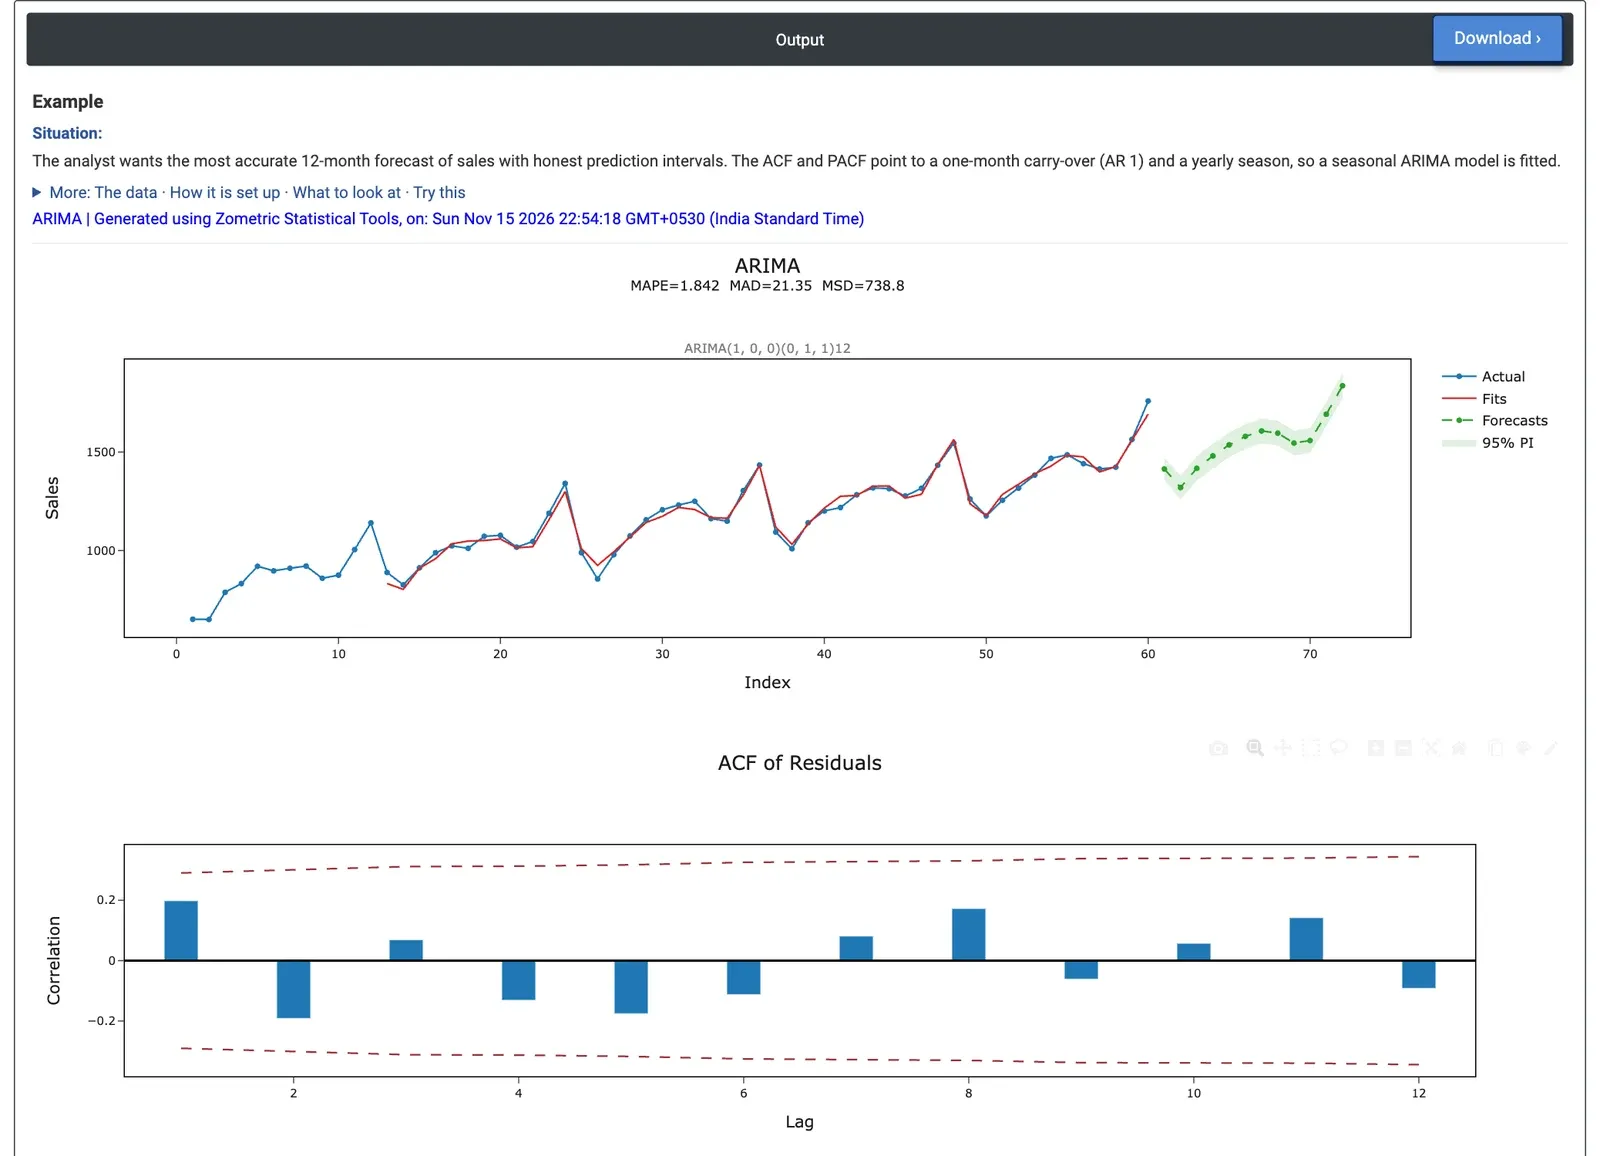
Abbildung 2 – ARIMA-Ausgabe für das Beispiel der Monatsumsätze: die Anpassung und die 12-Monats-Prognose mit ihrem 95-%-Prognoseband sowie die ACF der Residuen.
Beispiel
Ein Analyst verfügt über 60 Monate Umsatzdaten (Januar 2020 bis Dezember 2024) und möchte eine 12-Monats-Prognose mit belastbaren Prognoseintervallen. ACF und PACF deuten auf einen Übertrag von einem Monat und eine jährliche Saison hin, daher lautet das Modell ARIMA(1, 0, 0)(0, 1, 1)12 mit Konstante: Autoregressive order (p) = 1, Seasonal difference order (D) = 1, Seasonal MA order (Q) = 1, Seasonal period (s) = 12 und Number of forecasts = 12.
Beide Terme werden eindeutig benötigt: AR 1 = 0.481 (SE 0.104, T = 4.63, p < 0.001) und SMA 12 = 0.805 (SE 0.144, T = 5.59, p < 0.001), mit einer Konstanten von 69.34 (dem mittleren Wachstum gegenüber dem Vorjahr). Das mittlere Residuenquadrat MS beträgt 788.1 bei 45 DF (60 Monate − 12 durch die saisonale Differenz verlorene − 3 Parameter). Die Ljung-Box-p-Werte betragen 0.214, 0.319 und 0.254 bei den Lags 12, 24 und 36 und liegen alle über 0.05; die Residuen verhalten sich also wie zufälliges Rauschen, und das Modell hat das Muster erfasst. Die Anpassung ist gut: MAPE 1.84%, MAD 21.35, MSD 738.8.
Die Prognose für Januar 2025 (Periode 61) beträgt 1,414 Einheiten mit einem 95-%-Prognoseintervall von 1,359 bis 1,469 und steigt bis Dezember 2025 (Periode 72) auf 1,837, Intervall 1,774 bis 1,899. Um das Modell zu testen, bevor Sie ihm vertrauen, setzen Sie Forecast origin (row) = 48, um 2024 aus den Daten bis Dezember 2023 zu prognostizieren, und vergleichen Sie die Prognosen mit den tatsächlichen Umsätzen 2024.
Häufig gestellte Fragen
Was ist ein ARIMA-Modell?
ARIMA ist ein autoregressives integriertes Moving-Average-Modell nach Box-Jenkins für eine Reihe, die in gleichen Zeitabständen gemessen wird. Autoregressive Terme übertragen vorherige Werte, die Differenzenbildung entfernt den Trend, und Moving-Average-Terme übertragen vorherige zufällige Störungen. Für eine wiederkehrende Saison können saisonale Terme hinzugefügt werden, z. B. Periode 12 für Monatsdaten mit Jahresmuster.
Wann sollte man ARIMA statt exponentieller Glättung verwenden?
Verwenden Sie ARIMA, wenn jeder Wert von den vorhergehenden Werten abhängt oder die Reihe einen Trend oder eine wiederkehrende Saison aufweist, die einfachere Verfahren wie gleitende Durchschnitte oder exponentielle Glättung nicht gut erfassen. Die Diagramme der Autokorrelation (ACF) und der partiellen Autokorrelation (PACF) der Reihe helfen, die Modellordnungen vor der Anpassung festzulegen.
Wie prüft man, ob ein ARIMA-Modell gut passt?
Prüfen Sie, ob der p-Wert jedes Terms zeigt, dass dieser benötigt wird, und betrachten Sie die Ljung-Box-Chi-Quadrat-Tests bei den Lags 12, 24, 36 und 48: Ein p-Wert über 0.05 bedeutet, dass es keinen Hinweis auf verbleibende Autokorrelation in den Residuen gibt. Die Balken der Residuen-ACF und -PACF sollten innerhalb der gestrichelten Grenzen bleiben. MAPE, MAD und MSD fassen die Anpassungsgüte zusammen.
Wie testet man eine ARIMA-Prognose, bevor man ihr vertraut?
Setzen Sie den Prognoseursprung auf eine frühere Zeile, sodass das Modell aus den Daten bis zu diesem Punkt prognostiziert, und vergleichen Sie diese Prognosen dann mit den tatsächlichen Werten. Im Beispiel wird mit dem Ursprung in Zeile 48 das Jahr 2024 aus den Daten bis Dezember 2023 prognostiziert und mit den tatsächlichen Umsätzen 2024 verglichen. Prognoseintervalle werden mit dem Prognosehorizont breiter.