
Automatisierte Prozessfähigkeit (Automated Process Capability)
Automated Process Capability ersetzt die manuelle Normalitätsprüfung. Es führt einen Anderson-Darling-Test durch: Liegt der p-Wert auf oder über dem Schwellenwert (Standard 0.1), berechnet es Pp, Ppl, Ppu und Ppk für die Normalverteilung; liegt er darunter, passt es nicht normale Kandidatenverteilungen per Maximum-Likelihood an, wählt die beste Anpassung und verwendet die z-Wert-Methode. Die Ausgabe zeigt den gewählten Weg, ein Histogramm mit angepasster Verteilung, die Indizes sowie erwartete und beobachtete PPM.
Zuletzt geprüft
Kernaussage
Automated Process Capability prüft die Normalität mit dem Anderson-Darling-Test und berechnet Pp und Ppk automatisch aus dem Normalverteilungsmodell oder der am besten passenden nicht normalen Verteilung; der gewählte Weg wird dokumentiert.
Auf dieser Seite
Zweck
Automated Process Capability ersetzt den manuellen Schritt, zuerst die Normalität zu prüfen und dann gesondert zwischen einem normalen und einem nicht normalen Fähigkeitsmodell zu wählen. Das Werkzeug führt den Anderson-Darling-Test auf Normalverteilung selbst durch und leitet die Berechnung automatisch zu den üblichen Fähigkeitsindizes für die Normalverteilung, wenn die Daten den Test bestehen, oder andernfalls zu einer am besten passenden nicht normalen Verteilung (ausgewählt aus der Bibliothek der Kandidatenverteilungen der Anwendung) — mit einem einzigen Bericht, in dem die Weichenentscheidung oben dokumentiert ist.
Wichtige Funktionen
- Führt den Anderson-Darling-Test auf Normalverteilung automatisch durch — kein separater Schritt zur Normalitätsprüfung erforderlich.
- Wählt automatisch die am besten passende nicht normale Kandidatenverteilung, wenn die Normalverteilungsannahme verworfen wird, mit derselben Bibliothek zur Verteilungsanpassung wie die übrigen Werkzeuge der Anwendung für nicht normale Prozessfähigkeit.
- Konfigurierbarer p-Wert-Schwellenwert für die Normalität, mit dem Sie einstellen können, wie konservativ das Werkzeug den Weg über die Normalverteilung wählt.
- Gibt den gewählten Weg (normal oder nicht normal und welche Verteilung) direkt in der Ausgabe an, sodass die Weichenentscheidung transparent und auditierbar ist.
- Unterstützt eine optionale Factor-Spalte und einen Modus „Compare selected columns as separate groups“, wie die übrigen Fähigkeitswerkzeuge der Anwendung.
Statistische Methoden
Die Normalität wird mit dem Anderson-Darling-Test beurteilt (anderson() aus scipy gegen eine Normalverteilung als Referenz), mit der üblichen Korrektur für kleine Stichproben AD = A²·(1 + 0.75/n + 2.25/n²); der p-Wert wird aus den stückweisen empirischen Näherungen nach D'Agostino–Stephens für die korrigierte AD-Statistik abgeleitet.
Weichenregel: Ist der Anderson-Darling-p-Wert größer oder gleich dem Normality p-value threshold (Standard 0.1), behandelt das Werkzeug die Daten als normalverteilt — es schätzt σ_overall über die Methode der gleitenden Spannweite (MRbar/d2 oder eine Variante mit dem Median der gleitenden Spannweiten) und berechnet daraus die üblichen z-basierten Leistungsindizes Pp, Ppl, Ppu, Ppk. Liegt der p-Wert unter dem Schwellenwert, passt das Werkzeug stattdessen jede von der Anwendung unterstützte nicht normale Kandidatenverteilung (Weibull, 3-Parameter-Weibull, Exponential, 2-Parameter-Exponential, Gamma, logistisch, loglogistisch, lognormal sowie die Extremwertverteilungen für kleinste/größte Werte) per Maximum-Likelihood an, ordnet sie nach Anpassungsgüte und wählt automatisch die am besten passende.
Auf dem nicht normalen Weg wird die Verteilungsfunktion (CDF) der gewählten Verteilung bei LSL und USL ausgewertet, um die Randwahrscheinlichkeiten p_lsl und p_usl zu erhalten, die dann über die inverse Verteilungsfunktion der Normalverteilung (norm.ppf) in äquivalente z-Werte der Standardnormalverteilung umgerechnet werden — die „z-Wert-Methode“. Die Prozessfähigkeit wird dann mit diesen z-Werten auf der vertrauten Cpk-Skala angegeben: Pp = (z_usl − z_lsl) / 6, PPL = −norm.ppf(p_lsl) / 3, PPU = norm.ppf(p_usl) / 3, Ppk = min(PPL, PPU) — so wird das tatsächliche Randrisiko einer schiefen Verteilung erfasst und anschließend in denselben Cpk-ähnlichen Einheiten ausgedrückt, die in der gesamten Anwendung verwendet werden, statt einen rohen z-Wert der Normalverteilung fälschlich auf nicht normalverteilte Daten anzuwenden.
PPM-Werte (parts per million) werden auf zwei Arten angegeben: „erwartete“ PPM aus den Randwahrscheinlichkeiten der angepassten Verteilung jenseits jeder Spezifikationsgrenze und „beobachtete“ PPM durch einfaches Auszählen des Anteils der Rohstichprobe, der tatsächlich außerhalb der Spezifikationsgrenzen liegt.
Eingabefelder und Optionen
Feld | Beschreibung |
Choose columns | Die zu analysierende(n) Spalte(n) der Zielgröße. |
Factor | Optional. Vergleicht die Prozessfähigkeit zwischen Gruppen, wenn die Daten aus einer einzelnen Response-Spalte und einer Factor-Spalte bestehen. |
Compare selected columns as separate groups | Wenn 2 oder mehr Spalten ausgewählt sind, wird die Prozessfähigkeit für jede getrennt berechnet und nebeneinander verglichen. |
LSL / USL | Untere und obere Spezifikationsgrenze, angewendet auf jede ausgewählte Spalte. |
Normality p-value threshold | Standard 0.1. Liegt der Anderson-Darling-p-Wert auf oder über diesem Wert, wird die Prozessfähigkeit unter Annahme der Normalverteilung berechnet; liegt er darunter, wird automatisch die am besten passende nicht normale Verteilung ausgewählt und stattdessen verwendet. |
Download as Excel | Optional. Exportiert den Bericht in eine Excel-Arbeitsmappe. |
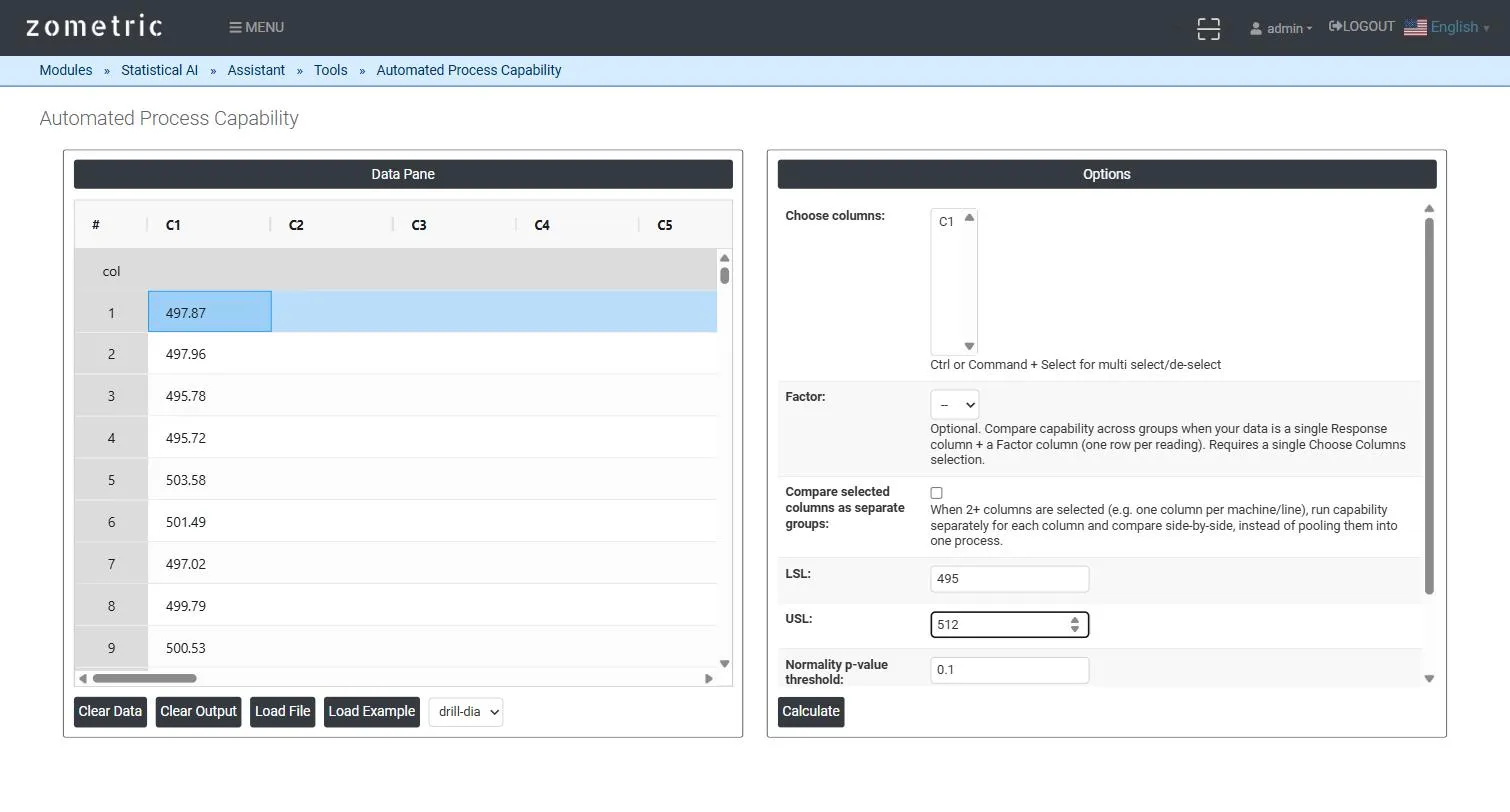
Abbildung 1 — Datenbereich (Data Pane) mit 60 Füllgewichtswerten in C1, LSL/USL und Normality p-value threshold im Options-Bereich ausgefüllt.
Beschreibung der Ausgabe
- Ergebnis des Tests auf Normalverteilung — die Anderson-Darling-Statistik und der p-Wert sowie der gewählte Weg (normal oder die automatisch gewählte nicht normale Verteilung).
- Histogramm der angepassten Verteilung — Histogramm der Stichprobe mit überlagerter angepasster Dichtekurve und LSL/USL-Referenzlinien.
- Tabelle der Verteilungsparameter — LSL, USL, Stichprobenmittelwert, Stichprobenumfang und die Form-/Skalenparameter (oder entsprechende Parameter) der angepassten Verteilung.
- Fähigkeitsindizes — Pp, Ppl, Ppu, Ppk, berechnet aus der jeweils gewählten Verteilung.
- PPM-Tabellen — erwartete PPM (aus den Rändern der angepassten Verteilung) und beobachtete PPM (aus der Rohstichprobe), jeweils aufgeteilt in PPM < LSL, PPM > USL und PPM Total.
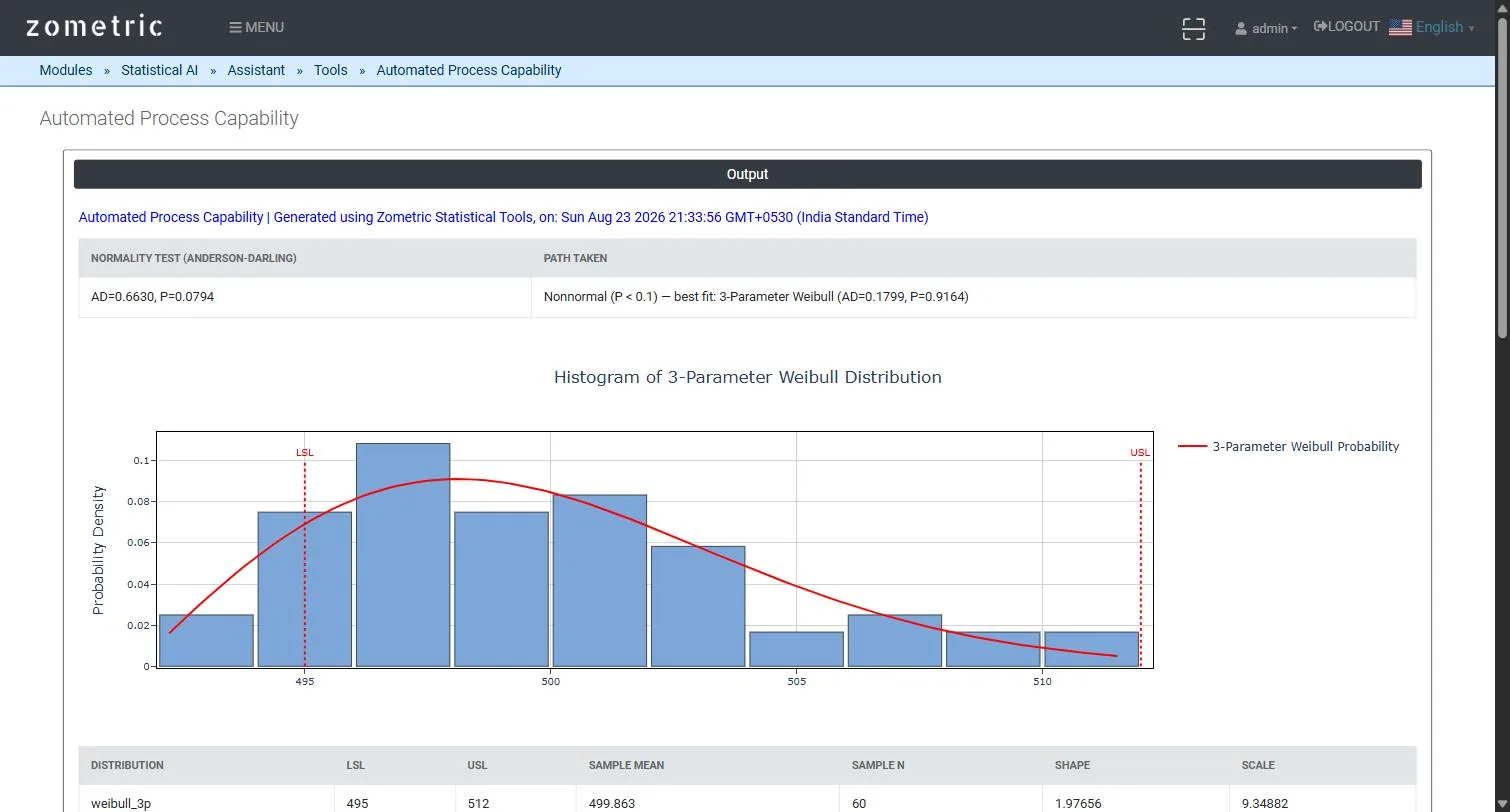
Abbildung 2 — Verteilungsparameter und die resultierenden Indizes Pp/Ppl/Ppu/Ppk mit Tabellen der erwarteten und beobachteten PPM.
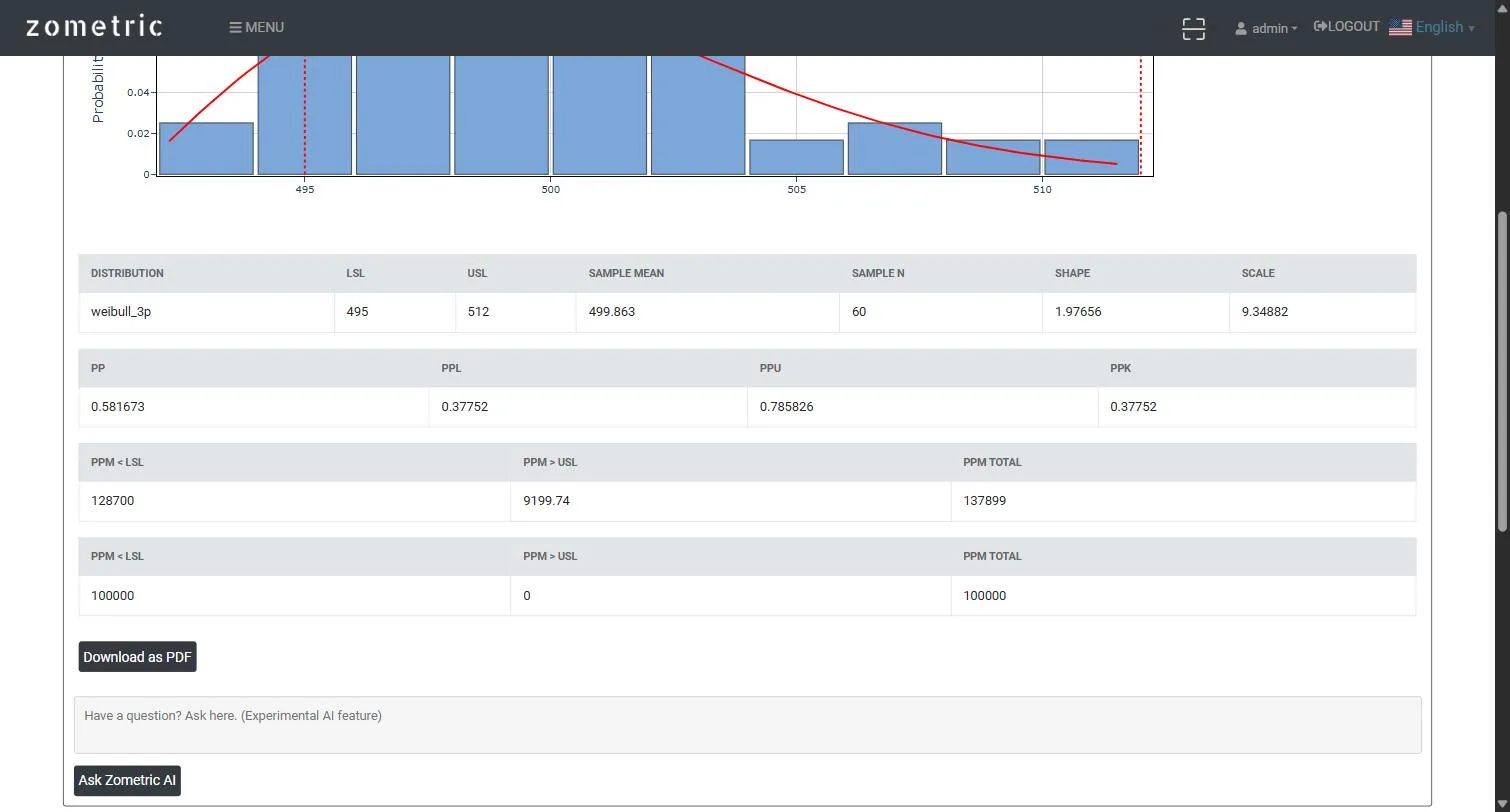
Abbildung 3 — Automatische Weichenentscheidung (Anderson-Darling-Ergebnis und gewählter Weg) mit dem Histogramm der angepassten Verteilung.
Beispiel
Eine Abfülllinie füllt Flaschen mit einer zähflüssigen Reinigungsflüssigkeit; das Füllgewicht (g) wird an 60 über eine Schicht entnommenen Flaschen gemessen (Spalte C1), mit LSL = 495 g und USL = 512 g. Mit dem Standardschwellenwert 0.1 liefert der Anderson-Darling-Test AD = 0.6630, P = 0.0794 — unter dem Schwellenwert —, daher leitet das Werkzeug automatisch auf den nicht normalen Weg und wählt eine 3-Parameter-Weibull-Anpassung (AD = 0.1799, P = 0.9164) als am besten passende Verteilung. Es gibt Ppk = 0.378 aus den Randwahrscheinlichkeiten der angepassten Weibull-Verteilung an statt aus einer (irreführenden) Normalverteilungsannahme.
Häufig gestellte Fragen
Was leistet die automatisierte Prozessfähigkeit?
Sie führt den Anderson-Darling-Test auf Normalverteilung für die Daten durch und leitet die Fähigkeitsberechnung dann automatisch weiter: zu den üblichen Fähigkeitsindizes für die Normalverteilung, wenn die Daten den Test bestehen, oder andernfalls zur am besten passenden nicht normalen Verteilung. Ein einziger Bericht zeigt das Normalitätsergebnis, den gewählten Weg und die verwendete Verteilung, sodass die Weichenentscheidung transparent und auditierbar ist.
Wie entscheidet das Werkzeug zwischen normaler und nicht normaler Prozessfähigkeit?
Ist der Anderson-Darling-p-Wert größer oder gleich dem Normality p-value threshold, standardmäßig 0.1, werden die Daten als normalverteilt behandelt. Liegt er darunter, passt das Werkzeug Kandidatenverteilungen wie Weibull, 3-Parameter-Weibull, Gamma, lognormal und weitere per Maximum-Likelihood an, ordnet sie nach Anpassungsgüte und wählt die beste aus.
Wie wird Ppk für nicht normalverteilte Daten berechnet?
Die Verteilungsfunktion der gewählten Verteilung liefert die Randwahrscheinlichkeiten jenseits von LSL und USL, die in äquivalente z-Werte der Standardnormalverteilung umgerechnet werden. Dann gilt PPL = -z(p_lsl)/3, PPU = z(p_usl)/3 und Ppk = min(PPL, PPU). So wird das tatsächliche Randrisiko einer schiefen Verteilung erfasst, während die Ergebnisse auf der vertrauten Cpk-ähnlichen Skala bleiben.
Wie führen Sie die automatisierte Prozessfähigkeit in Zometric Statistical Software aus?
Fügen Sie die Daten ein, wählen Sie die Spalte oder Spalten der Zielgröße, optional einen Factor oder die Option, Spalten als getrennte Gruppen zu vergleichen, und geben Sie LSL und USL ein. Legen Sie den Normality p-value threshold fest (Standard 0.1). Der Bericht zeigt die Weichenentscheidung, das Histogramm mit angepasster Verteilung, die Verteilungsparameter, die Fähigkeitsindizes und die PPM-Tabellen und kann nach Excel exportiert werden.