
Best-Subsets-Regression
Die Best Subsets Regression passt Modelle nach der Methode der kleinsten Quadrate für jede Teilmenge der freien Prädiktoren an, auf Wunsch mit Prädiktoren, die in allen Modellen enthalten sind, und zeigt die besten ein bis fünf Modelle jeder Größe. Jede Zeile enthält R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp und S, optional PRESS, AICc, BIC und VIF. Nutzen Sie sie früh zur Vorauswahl der Prädiktoren und passen Sie das gewählte Modell dann mit Fit Regression Model an.
Zuletzt geprüft
Kernaussage
Die Best-Subsets-Regression passt für jede Kombination der Kandidaten-Prädiktoren eine lineare Regression an und listet die besten Modelle jeder Größe, um die kleinste Menge zu finden, die den Großteil der Streuung erklärt.
Auf dieser Seite
Zweck
Die Best Subsets Regression passt für jede Kombination der Kandidaten-Prädiktoren eine lineare Regression an und stellt die besten Modelle jeder Größe nebeneinander dar. Verwenden Sie sie früh in einer Untersuchung, wenn Sie mehrere mögliche Prozesseinstellungen haben und die kleinste Menge suchen, die den Großteil der Streuung der Zielgröße erklärt, bevor Sie das gewählte Modell mit Fit Regression Model im Detail anpassen.
Wichtige Funktionen
- Passt jede Teilmenge der freien Prädiktoren an, von der festgelegten minimalen bis zur maximalen Anzahl.
- Zeigt die besten ein bis fünf Modelle jeder Größe, geordnet nach R-Sq.
- Gibt für jedes Modell R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp und S aus, auf Wunsch zusätzlich PRESS, AICc und BIC.
- Predictors in all models: Nehmen Sie Variablen, von denen Sie wissen, dass sie relevant sind, in jede Teilmenge auf.
- Enhanced tables ergänzen den Varianzinflationsfaktor (VIF) jedes Prädiktors in jedem Modell, um korrelierte Prädiktoren zu erkennen.
- Modell mit oder ohne Achsenabschnitt.
Statistische Methoden
Zeilen mit fehlendem oder nicht numerischem Wert in der Zielgröße oder einem ausgewählten Prädiktor werden entfernt. Für jede Teilmengengröße vom Minimum bis zum Maximum passt das Werkzeug für jede Kombination aus entsprechend vielen freien Prädiktoren (plus eventuell erzwungene Prädiktoren) ein Modell nach der Methode der kleinsten Quadrate an, sortiert sie nach R-Sq und behält die besten Modelle jeder Größe. Bei p freien Prädiktoren gibt es 2ᵖ − 1 Teilmengen, sodass jeder zusätzliche Kandidat die Anzahl der Anpassungen verdoppelt.
Für ein Modell mit k Koeffizienten (einschließlich Konstante), angepasst an n Zeilen, gilt: S = √MSE; R-Sq(adj) korrigiert R-Sq um die Anzahl der Terme; PRESS = Σ (eᵢ / (1 − hᵢ))², die Summe der quadrierten Leave-One-out-Vorhersagefehler mit den Hebelwerten hᵢ; R-Sq(pred) = 1 − PRESS / SS Total. Mallows' Cp = SSE / MSE(full) − (n − 2k), wobei MSE(full) das mittlere Fehlerquadrat des Modells mit allen Prädiktoren ist; ein Modell mit geringem Bias hat ein Cp nahe k, und das vollständige Modell hat stets Cp = k. AICc = −2 log L + 2(k+1) + 2(k+1)(k+2)/(n − k − 2) und BIC = −2 log L + (k+1) ln n, wobei σ als Parameter gezählt wird; für PRESS, AICc und BIC gilt: kleiner ist besser.
Suchen Sie das Modell, bei dem R-Sq(adj) und R-Sq(pred) nicht mehr steigen, Cp nahe der Anzahl der Koeffizienten liegt und S klein ist. Eine große Lücke zwischen R-Sq und R-Sq(pred) warnt vor Überanpassung. Best Subsets vergleicht nur Anpassungen: Prüfen Sie Residuen und Koeffizienten des gewählten Modells in Fit Regression Model.
Eingabefelder und Optionen
Feld | Beschreibung |
Response (Y) | Numerische Spalte, die erklärt werden soll. Pflichtfeld. |
Free predictors | Numerische Kandidaten-Prädiktoren; jede Kombination wird geprüft. Pflichtfeld. Strg bzw. Befehlstaste + Klick, um mehrere auszuwählen. |
Predictors in all models (optional) | Numerische Prädiktoren, die in jedem Modell enthalten sind. Sie dürfen nicht zugleich freie Prädiktoren sein. |
Models of each size to display | Wie viele der besten Modelle jeder Größe aufgeführt werden, 1 bis 5. Standard 2. |
Display PRESS / Display AICc / Display BIC | Fügt diese Spalten der Tabelle hinzu. Standardmäßig deaktiviert. |
Free Predictors: Minimum / Maximum | Kleinste und größte Anzahl freier Prädiktoren in einem Modell. Standard: 1 bis alle. |
Fit intercept | Standardmäßig aktiviert. Deaktivieren Sie die Option, um Modelle durch den Ursprung anzupassen (R-Sq ist dann nicht zentriert). |
Display of results | Simple tables (Standard) oder Enhanced tables, die für jeden Prädiktor eine VIF-Spalte ergänzen. |
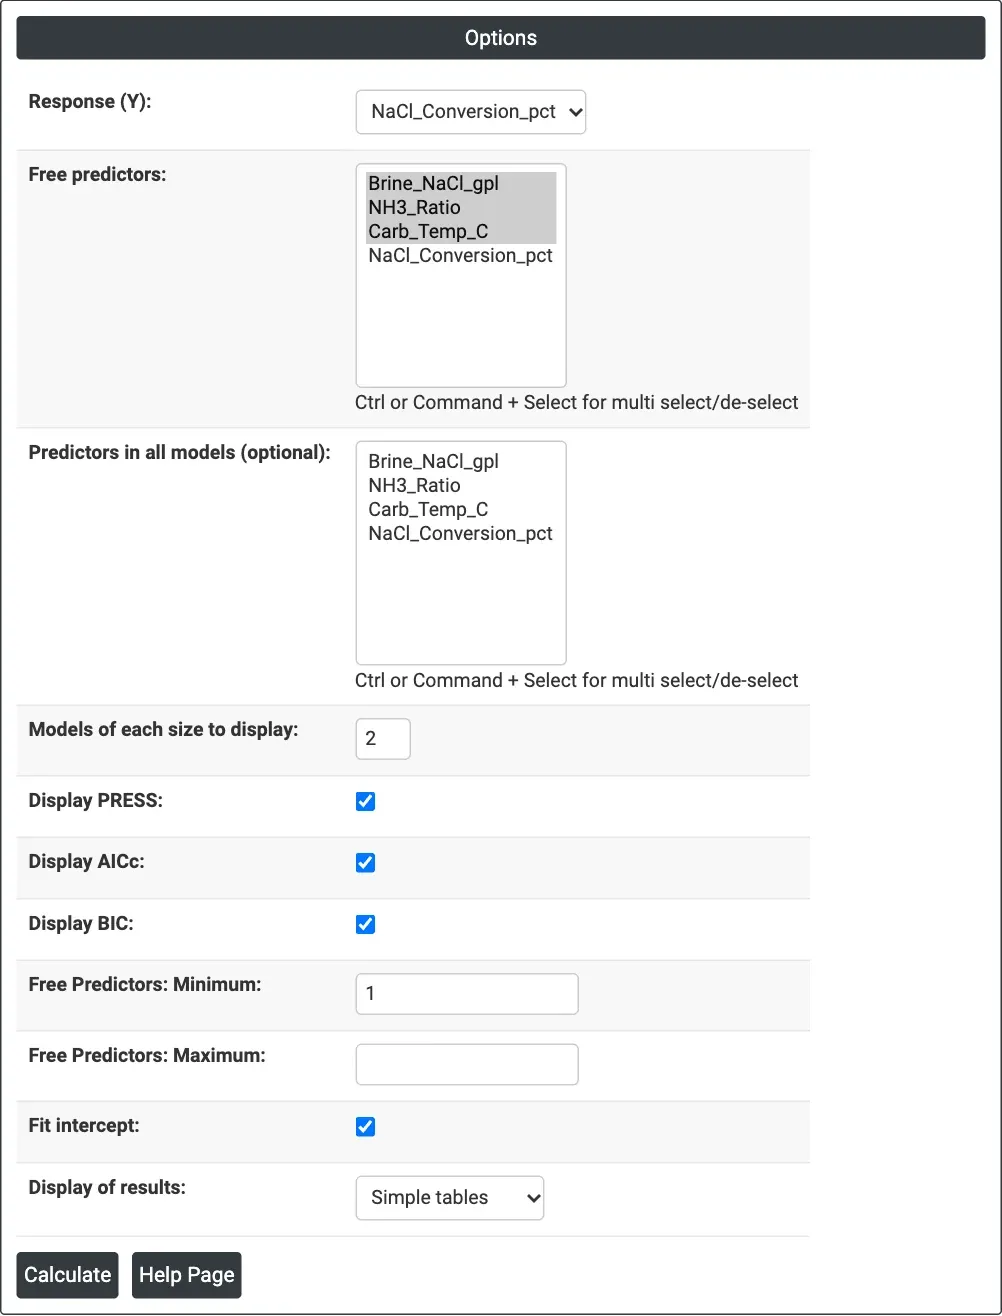
Abbildung 1 – Optionen für das Sodaasche-Beispiel: NaCl_Conversion_pct als Zielgröße, die drei Prozesseinstellungen als freie Prädiktoren, mit Anzeige von PRESS, AICc und BIC.
Beschreibung der Ausgabe
- Zeile zur Zielgröße – nennt die Zielgröße und alle in sämtliche Modelle aufgenommenen Prädiktoren.
- Tabelle Best Subsets Results – eine Zeile je Modell: Vars (Anzahl der freien Prädiktoren), R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp, S, optional PRESS, AICc und BIC sowie ein X unter jedem im Modell enthaltenen Prädiktor; bei Enhanced tables zusätzlich der VIF jedes Prädiktors im Modell.
- PDF-Export über Download.
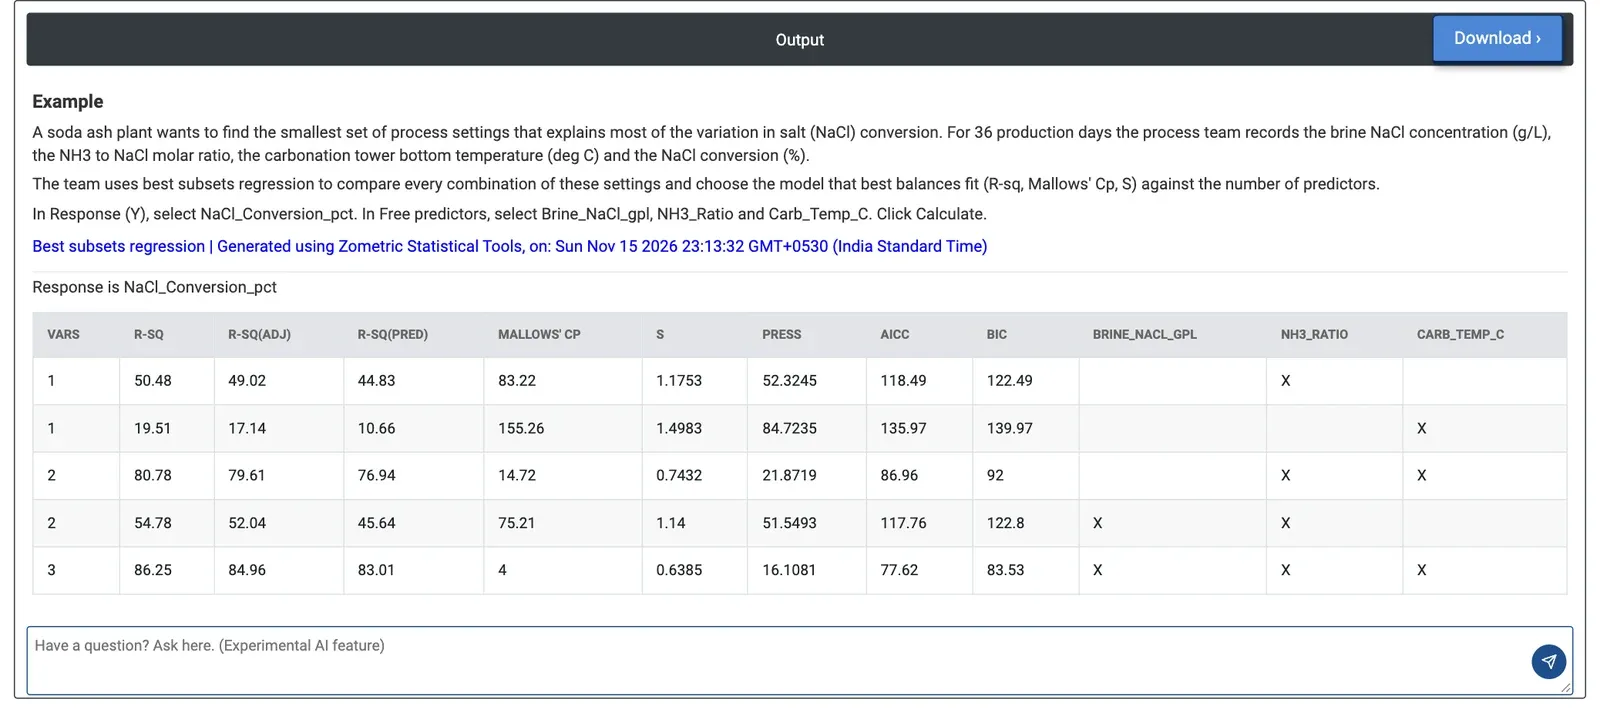
Abbildung 2 – Best-Subsets-Ergebnisse für den NaCl-Umsatz: Das Modell mit drei Prädiktoren hat R-Sq 86.25%, R-Sq(pred) 83.01%, Cp 4 und S 0.6385.
Beispiel
Ein Sodaasche-Werk möchte wissen, welche Prozesseinstellungen den täglichen NaCl-Umsatz (%) erklären. An 36 Produktionstagen erfasst das Team die NaCl-Konzentration der Sole (Brine_NaCl_gpl), das Molverhältnis NH3 zu NaCl (NH3_Ratio) und die Temperatur am Fuß des Carbonisierungsturms (Carb_Temp_C). Es wählt NaCl_Conversion_pct als Zielgröße und die drei Einstellungen als freie Prädiktoren, behält zwei Modelle jeder Größe und aktiviert Display PRESS, AICc und BIC.
Für sich allein ist das NH3-Verhältnis der beste einzelne Prädiktor, erklärt aber nur 50.48% der Streuung (Cp 83.22). Mit der Carbonisierungstemperatur steigt R-Sq auf 80.78% und S sinkt von 1.1753 auf 0.7432 Prozentpunkte, doch Cp liegt mit 14.72 noch deutlich über den 3 Koeffizienten dieses Modells – es fehlt also etwas. Mit allen drei Einstellungen beträgt R-Sq 86.25%, R-Sq(pred) 83.01% und S 0.6385, und PRESS, AICc und BIC sind die niedrigsten Werte der Tabelle (16.1081, 77.62 und 83.53). Die kleine Lücke zwischen R-Sq und R-Sq(pred) zeigt, dass das Modell nicht überangepasst ist.
Das Team behält alle drei Einstellungen und passt sie mit Fit Regression Model an. Mit Enhanced tables ergeben sich VIF-Werte von 1.01 bis 1.03; die drei Einstellungen wurden also nicht gemeinsam verändert, und jeder Effekt lässt sich für sich interpretieren.
Häufig gestellte Fragen
Was ist eine Best-Subsets-Regression?
Die Best-Subsets-Regression passt für jede Kombination der Kandidaten-Prädiktoren eine lineare Regression an und stellt die besten Modelle jeder Größe, geordnet nach R-Sq, nebeneinander dar. Sie wird früh in einer Untersuchung eingesetzt, um die kleinste Menge an Prädiktoren, etwa Prozesseinstellungen, zu finden, die den Großteil der Streuung der Zielgröße erklärt.
Wie wählen Sie aus der Best-Subsets-Ausgabe das beste Modell aus?
Suchen Sie das Modell, bei dem R-Sq(adj) und R-Sq(pred) nicht mehr steigen, Mallows' Cp nahe der Anzahl der Koeffizienten liegt und S klein ist. Kleinere Werte für PRESS, AICc und BIC sind besser. Eine große Lücke zwischen R-Sq und R-Sq(pred) warnt vor Überanpassung. Prüfen Sie anschließend Residuen und Koeffizienten des gewählten Modells in Fit Regression Model.
Was bedeutet Mallows' Cp in der Best-Subsets-Regression?
Mallows' Cp vergleicht den Fehler eines Modells mit dem des vollständigen Modells mit allen Prädiktoren. Ein Modell mit geringem Bias hat ein Cp nahe k, der Anzahl seiner Koeffizienten einschließlich Konstante, und das vollständige Modell hat stets Cp gleich k. Ein Cp deutlich über k, etwa 14.72 für ein Modell mit 3 Koeffizienten im Beispiel, deutet darauf hin, dass ein wichtiger Prädiktor fehlt.
Wie viele Modelle passt die Best-Subsets-Regression an?
Bei p freien Prädiktoren gibt es 2 hoch p minus 1 Teilmengen, sodass jeder zusätzliche Kandidaten-Prädiktor die Anzahl der Anpassungen verdoppelt. Sie können die minimale und maximale Anzahl freier Prädiktoren je Modell begrenzen, bekannte Prädiktoren in jedes Modell aufnehmen und festlegen, wie viele der besten Modelle jeder Größe angezeigt werden, von 1 bis 5.