
Prozessfähigkeit Between/Within (zwischen/innerhalb der Teilgruppen)
Die Between/Within-Fähigkeit ist für Daten in Teilgruppen gedacht, deren Mittelwerte driften können, etwa von Stunde zu Stunde. Sie schätzt die Standardabweichungen innerhalb der Teilgruppen, zwischen den Teilgruppen sowie die kombinierte Between/Within-Standardabweichung. Cp, Cpk und CCpk verwenden das Between/Within-Sigma; Pp und Ppk verwenden die Gesamtstandardabweichung der Stichprobe; Cpm kommt hinzu, wenn ein Zielwert angegeben ist. Die Ausgabe umfasst diese Indizes, Z-Werte, PPM sowie ein Histogramm mit angepasster Normalverteilungskurve.
Zuletzt geprüft
Kernaussage
Die Between/Within-Prozessfähigkeit trennt die Streuung zwischen und innerhalb der Teilgruppen und gibt Cp/Cpk auf Basis der kombinierten Between/Within-Standardabweichung sowie die Gesamtindizes Pp/Ppk aus.
Auf dieser Seite
Zweck
Die Between/Within-Prozessfähigkeit erzeugt einen einzigen Fähigkeitsbericht, der die beiden Streuungsquellen jedes in Teilgruppen erfassten Prozesses trennt – die Streuung ZWISCHEN den Teilgruppen (Drift von Schicht zu Schicht oder von Stunde zu Stunde) und die Streuung INNERHALB einer Teilgruppe (kurzfristiges Maschinen- bzw. Messrauschen) – und sowohl eine Between/Within-Fähigkeit (Cp/Cpk-Familie, auf Basis der kombinierten Standardabweichung zwischen und innerhalb der Teilgruppen) als auch eine Gesamtfähigkeit (Pp/Ppk-Familie) nebeneinander ausgibt. Sie ist das eigenständige Gegenstück zum Feld „Between/Within“ in einem vollständigen Capability Sixpack, für Anwender, die nur die Indizes und das Histogramm ohne die zugehörigen Regelkarten benötigen.
Wichtigste Funktionen
- Akzeptiert entweder mehrere Wiederholungsspalten (eine Spalte je Wiederholungsmessung innerhalb einer Teilgruppe) oder eine einzelne Spalte der Zielgröße mit ausdrücklich angegebener Teilgruppengröße.
- Optionale Factor-Spalte, um die Fähigkeit über benannte Gruppen (z. B. Maschine, Linie) aus einem einzigen Response-+-Factor-Layout zu vergleichen.
- Optionaler Modus „Compare selected columns as separate groups“, um mehrere Spalten als unabhängige Prozesse auszuwerten, statt sie zusammenzufassen.
- Berechnet aus demselben Datensatz sowohl die Between/Within-Fähigkeit (Cp/Cpk) als auch die Gesamtfähigkeit (Pp/Ppk) und zusätzlich Cpm, wenn ein Zielwert angegeben ist.
- Konfigurierbarer K-Sigma-Toleranzfaktor und Sigma-Schätzung über die gleitende Spannweite, einheitlich mit den übrigen Fähigkeitswerkzeugen der Anwendung.
Statistische Methoden
Das Werkzeug schätzt aus den Daten in Teilgruppen drei Standardabweichungen. σ_within ist eine gepoolte Kurzzeitschätzung über alle Teilgruppen (bei Teilgruppengröße 1 die Schätzung über die mittlere gleitende Spannweite MRbar/1.128; bei größeren Teilgruppen eine Schätzung über die gepoolte Standardabweichung der Teilgruppen). σ_xbar wird aus der gleitenden Spannweite der Teilgruppenmittelwerte geschätzt (MRbar/d2 oder eine Variante mit dem Median der gleitenden Spannweiten), und σ_between wird daraus abgeleitet als σ_between = √(max(0, σ_xbar² − σ_within²/n)), wobei n die Teilgruppengröße ist. Die Kombination ergibt σ_between_within = √(σ_between² + σ_within²) – das Sigma der „Potential“-Fähigkeit (innerhalb + zwischen). Davon getrennt ist σ_overall die gewöhnliche Standardabweichung der Stichprobe, direkt über alle Einzelbeobachtungen um den Gesamtmittelwert berechnet – das „Performance“-Sigma.
Die „Potential“-Indizes werden mit σ_between_within berechnet: Cp = (USL − LSL) / (K·σ_between_within), Cpu = (USL − x̄) / ((K/2)·σ_between_within), Cpl = (x̄ − LSL) / ((K/2)·σ_between_within) und Cpk = min(Cpu, Cpl), mit der Standardkonvention K = 6 (6 Sigma) für die Toleranz.
Die „Performance“-Indizes (Pp, Ppu, Ppl, Ppk) verwenden dieselben Formeln mit σ_overall anstelle von σ_between_within – entsprechend der üblichen SQC-Terminologie (Montgomery, Introduction to Statistical Quality Control), während die eigene Between/Within-Zerlegung dieses Werkzeugs in beide einfließt.
CCpk verwendet dasselbe Between/Within-Sigma, misst jedoch vom Zielwert (bzw., wenn kein Zielwert angegeben ist, von der Mitte der Spezifikationsgrenzen) statt vom Prozessmittelwert aus: CCpk = min[(USL−Target)/((K/2)·σ_between_within), (Target−LSL)/((K/2)·σ_between_within)] – die Fähigkeit, die der Prozess hätte, wenn er auf den Zielwert zentriert wäre. Das hilft, den Einfluss der Zentrierung vom Einfluss der Streuung zu trennen.
Ist ein Zielwert angegeben, wird zusätzlich Cpm ausgegeben: Cpm = min(USL − Target, Target − LSL) / ((K/2)·√(mean((x−Target)²))). Dabei wird die mittlere quadratische Abweichung vom Zielwert über alle Einzelbeobachtungen verwendet, sodass der Index einen vom Zielwert abweichenden Prozessmittelwert bestraft, auch wenn der Prozess ansonsten deutlich innerhalb der Spezifikation liegt.
Z.LSL und Z.USL (jeweils Within und Overall) geben den standardisierten Abstand zwischen dem Prozessmittelwert und der jeweiligen Spezifikationsgrenze an, und die PPM-Werte kombinieren die erwartete Randwahrscheinlichkeit der angepassten Normalverteilung jenseits jeder Spezifikationsgrenze mit der tatsächlich beobachteten Anzahl von Werten außerhalb der Spezifikation in den Rohdaten.
Eingabefelder und Optionen
Feld | Beschreibung |
|---|---|
Subgroup Columns | Wählen Sie 2 oder mehr Wiederholungsspalten (jede enthält eine Wiederholungsmessung innerhalb derselben Teilgruppe) ODER eine einzelne Spalte in Verbindung mit einer ausdrücklich angegebenen Subgroup size (siehe unten). |
LSL / USL | Untere und obere Spezifikationsgrenze der Zielgröße. |
Target | Optional. Wenn angegeben, wird der Bericht um den Index Cpm ergänzt. |
Subgroup size | Nur erforderlich, wenn eine einzelne Subgroup Column ausgewählt ist oder „Compare selected columns as separate groups“ aktiviert ist. Leer lassen, wenn mehrere Wiederholungsspalten ausgewählt sind. |
Factor | Optional. Vergleicht die Fähigkeit über benannte Gruppen, wenn die Daten aus einer einzelnen Response-Spalte und einer Factor-Spalte bestehen (eine Zeile je Messwert). Erfordert eine einzelne Subgroup Column. |
Compare selected columns as separate groups | Wenn 2 oder mehr Subgroup Columns ausgewählt sind, wird die Fähigkeit für jede Spalte getrennt berechnet und nebeneinander verglichen, statt die Spalten zu einem Prozess zusammenzufassen. |
SD estimation method | Legt fest, wie das Sigma zwischen den Teilgruppen aus der gleitenden Spannweite der Teilgruppenmittelwerte geschätzt wird: „Average moving range“ (Standard) oder „Median moving range.“ |
Length of moving range | Spanne der gleitenden Spannweite für die Schätzung der Standardabweichung; Standardwert 2. |
Tolerance (K) | Faktor, mit dem Sigma bei der Bildung des Toleranzbands für die Fähigkeit multipliziert wird; Standardwert 6 (übliche 6-Sigma-Fähigkeit). |
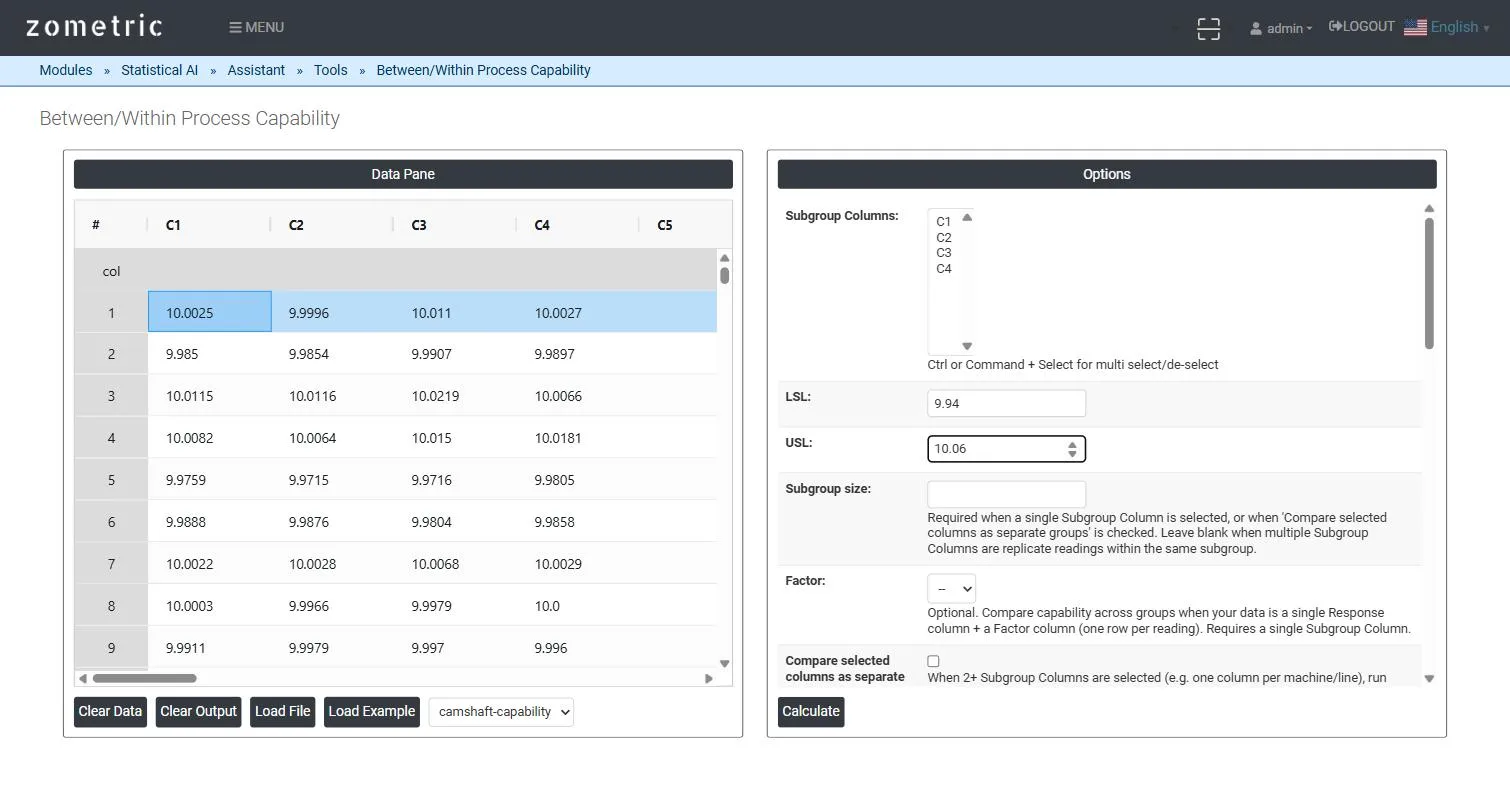
Abbildung 1 – Datenbereich (Data Pane) mit 20 Teilgruppen zu je 4 Wiederholungsmessungen des Durchmessers sowie das Options-Panel mit ausgewählten Subgroup Columns C1–C4 und ausgefüllten Feldern LSL/USL/Target.
Beschreibung der Ausgabe
- Übersichtstabelle der Felder – die für den Lauf verwendeten Werte für LSL, Target und USL.
- Potential-Indizes (Between/Within) – StDev Within, StDev Between, Cp, Cpl, Cpu, Cpk, CCpk, Z.LSL Within, Z.USL Within. Cp, Cpl, Cpu, Cpk, CCpk und die Z-Werte in dieser Spalte werden mit StDev B/W berechnet.
- Performance-Indizes (Overall) – StDev Overall, StDev B/W (die kombinierte Between/Within-Standardabweichung, die für die Cp/Cpk-Familie verwendet wird), Pp, Ppl, Ppu, Ppk, Cpm, Z.LSL Overall, Z.USL Overall.
- Histogramm – die zusammengefasste Verteilung der Zielgröße mit den Bezugslinien LSL/Target/USL und einer überlagerten angepassten Normalverteilungsdichte.
- PDF-Export des vollständigen Berichts über die Schaltfläche Download as PDF.
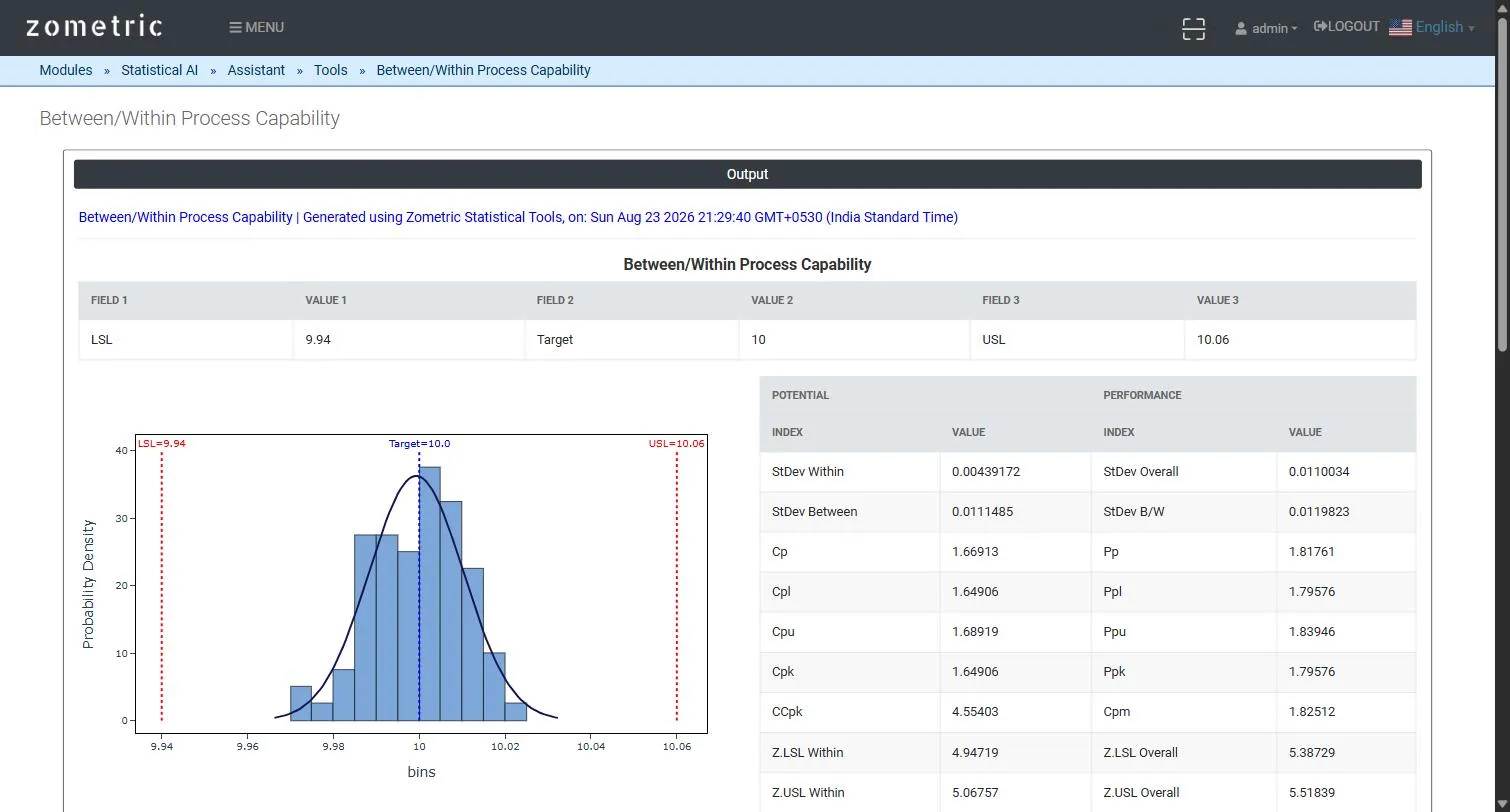
Abbildung 2 – Ausgabebericht: Fähigkeitshistogramm mit den Bezugslinien LSL/Target/USL und angepasster Normalverteilungskurve, daneben die Tabellen der Fähigkeitsindizes Within („Potential“) und Overall („Performance“).
Beispiel
Auf einer CNC-Linie wird der Außendurchmesser (mm) einer Welle bearbeitet. Jede Stunde entnimmt ein Bediener 4 aufeinanderfolgende Teile (eine Teilgruppe) und misst den Durchmesser; so entstehen über 20 Stunden 20 Teilgruppen mit je 4 Wiederholungen (Spalten C1–C4). Mit LSL = 9.94, USL = 10.06 und Target = 10.00 gibt das Werkzeug StDev Within ≈ 0.0044 und StDev Overall ≈ 0.0110 aus – die Gesamtstreuung ist sichtbar größer als die Streuung innerhalb einer Stunde. Das zeigt, dass der Großteil der Prozessstreuung aus der Drift von Stunde zu Stunde stammt und nicht aus kurzfristigem Maschinenrauschen – genau die Unterscheidung, die dieses Werkzeug sichtbar machen soll. Cp und Cpk werden aus StDev B/W berechnet, Pp und Ppk aus StDev Overall, wie in Abbildung 2 dargestellt.
Häufig gestellte Fragen
Was ist die Between/Within-Prozessfähigkeit?
Es handelt sich um eine Fähigkeitsanalyse für Daten in Teilgruppen, die zwei Streuungsquellen trennt: die Streuung zwischen den Teilgruppen, etwa Drift von Schicht zu Schicht oder von Stunde zu Stunde, und die Streuung innerhalb einer Teilgruppe, etwa kurzfristiges Maschinen- oder Messrauschen. Sie gibt die Between/Within-Fähigkeit (Cp/Cpk-Familie, auf Basis der kombinierten Standardabweichung zwischen und innerhalb der Teilgruppen) und die Gesamtfähigkeit (Pp/Ppk-Familie) nebeneinander aus, dazu ein Histogramm.
Wie wird die Standardabweichung zwischen den Teilgruppen berechnet?
Sigma within ist eine gepoolte Kurzzeitschätzung über alle Teilgruppen. Das Sigma der Teilgruppenmittelwerte ergibt sich aus deren gleitender Spannweite, und Sigma between ist die Quadratwurzel aus max(0, sigma_xbar zum Quadrat minus sigma_within zum Quadrat / n), wobei n die Teilgruppengröße ist. Das Between/Within-Sigma ist die Quadratwurzel aus sigma_between zum Quadrat plus sigma_within zum Quadrat.
Wann sollte man die Between/Within-Fähigkeit statt der normalen Fähigkeitsanalyse verwenden?
Verwenden Sie sie, wenn der Prozess in Teilgruppen erfasst wird und es echte Streuung zwischen den Teilgruppen geben kann, etwa eine Drift von Stunde zu Stunde, sodass ein Sigma allein aus der Streuung innerhalb der Teilgruppen die Prozessstreuung unterschätzen würde. Sie ist die eigenständige Version des Between/Within-Felds in einem Capability Sixpack, wenn Sie die Indizes und das Histogramm ohne die Regelkarten benötigen.
Worin unterscheiden sich Cpk, CCpk und Cpm in diesem Bericht?
Cpk verwendet das Between/Within-Sigma und misst vom Prozessmittelwert aus. CCpk verwendet dasselbe Sigma, misst jedoch vom Zielwert aus bzw. von der Mitte der Spezifikationsgrenzen, wenn kein Zielwert angegeben ist, und zeigt so die Fähigkeit eines zentrierten Prozesses. Cpm wird ausgegeben, wenn ein Zielwert eingegeben ist, und verwendet die mittlere quadratische Abweichung vom Zielwert; der Index fällt daher niedriger aus, wenn der Mittelwert vom Zielwert abweicht.