
Binary Fitted Line Plot (binäre logistische Anpassungslinie)
Binary Fitted Line Plot modelliert die Wahrscheinlichkeit eines Gut/Schlecht- bzw. Ja/Nein-Ergebnisses in Abhängigkeit von einer stetigen Einflussgröße, anhand binärer Rohdatenzeilen oder Ereignis-/Versuchsanzahlen und mit Logit-, Probit- oder komplementärer Log-Log-Linkfunktion. Die Ausgabe umfasst Regressionsgleichung, Devianz-ANOVA, Deviance R-Sq, AIC, Fläche unter der ROC-Kurve, Koeffizienten, Odds Ratios (Logit), die angepasste Kurve und ungewöhnliche Beobachtungen.
Zuletzt geprüft
Kernaussage
Ein Binary Fitted Line Plot passt eine logistische (oder Probit-)Regression eines Ja/Nein-Ergebnisses auf eine stetige Einflussgröße an und zeigt die S-Kurve: wie weit eine Einstellung sich ändern muss, bis das Ereignis wahrscheinlich wird.
Auf dieser Seite
Zweck
Binary Fitted Line Plot modelliert, wie sich die Wahrscheinlichkeit eines Ja/Nein-Ergebnisses mit einer stetigen Einflussgröße ändert, und zeichnet die angepasste S-förmige Kurve über die Daten. Verwenden Sie es, wenn das Ergebnis gut/schlecht, fehlerhaft/in Ordnung oder verbacken/nicht verbacken lautet und Sie wissen möchten, wie weit sich eine Einstellung wie Temperatur, Luftfeuchte oder Dosis verändern muss, bevor das Ereignis wahrscheinlich wird.
Wichtige Funktionen
- Akzeptiert Rohdaten (eine Zeile je Einheit mit einer Ja/Nein-Spalte) oder zusammengefasste Daten (Anzahl der Ereignisse und Anzahl der Versuche je Zeile).
- Logit-, Probit- oder komplementäre Log-Log-Linkfunktion.
- Regressionsgleichung, Devianz-ANOVA-Tabelle, Modellzusammenfassung, Koeffizienten mit Konfidenzintervallen und bei Logit-Link das Odds Ratio für ein beliebiges Inkrement der Einflussgröße.
- Diagramm der angepassten Wahrscheinlichkeitskurve mit optionalen beobachteten Anteilen und Konfidenzband.
- Tabelle ungewöhnlicher Beobachtungen (große Residuen oder ungewöhnliche Werte der Einflussgröße) und optionale Residuendiagramme.
- Optionale Häufigkeitsspalte für Daten mit wiederholten Zeilen.
Statistische Methoden
Das Werkzeug passt eine binäre logistische Regression mit einer Einflussgröße als verallgemeinertes lineares Modell mit Binomialverteilung nach der Maximum-Likelihood-Methode (iterativ neu gewichtete kleinste Quadrate) an. Mit Logit-Link gilt P(Ereignis) = exp(b₀ + b₁x) / (1 + exp(b₀ + b₁x)); mit Probit P = Φ(b₀ + b₁x); mit komplementärem Log-Log P = 1 − exp(−exp(b₀ + b₁x)). Im Rohdatenformat zählen Zeilen, deren Antwort dem Event value entspricht, als Ereignisse, alle anderen als Nicht-Ereignisse.
Die ANOVA-Tabelle testet die Einflussgröße über die Abnahme der Devianz: χ² = Null-Devianz − Residualdevianz, mit 1 Freiheitsgrad. Deviance R-Sq ist der erklärte Anteil der Null-Devianz. Die Koeffiziententabelle gibt Wald-z-Werte und Konfidenzintervalle b ± z·SE an; das Odds Ratio für ein Inkrement Δ ist exp(b₁·Δ), mit dem Intervall exp(Δ × die Grenzen von b₁). Area Under ROC Curve ist die Wahrscheinlichkeit, dass ein zufällig gewähltes Ereignis eine höhere angepasste Wahrscheinlichkeit hat als ein zufällig gewähltes Nicht-Ereignis (0.5 = keine Trennung, 1 = perfekt).
Das Konfidenzband um die Kurve verwendet den Standardfehler des linearen Prädiktors, zurücktransformiert auf die Wahrscheinlichkeitsskala. In der Tabelle der ungewöhnlichen Beobachtungen wird ein standardisiertes Residuum jenseits von ±2 mit R und ein Hebelwert über 3p/n mit X gekennzeichnet. Bei Rohdaten sind die beobachteten Anteile im Diagramm die Ereignisraten innerhalb von bis zu 10 gleich großen Gruppen entlang der Einflussgröße.
Eingabefelder & Optionen
Feld | Beschreibung |
Data format | Binary response (eine Zeile je Beobachtung, Standard) oder Event/Trial (eine Zeile je Einstellung mit der Anzahl der Ereignisse und der Anzahl der Versuche). |
Response / Event value | Format Binary response: die Spalte mit dem Ergebnis und der darin enthaltene Wert, der als Ereignis zählt (z. B. Yes, Fail, 1). |
Number of events / Number of trials | Format Event/Trial: die Spalten mit der Anzahl der Ereignisse und der Anzahl der geprüften Einheiten in jeder Zeile. |
Event name | Optionale Bezeichnung des Ereignisses, verwendet in der Gleichung und an der Diagrammachse, z. B. Caked. Leer: der Event value (Format Binary response) bzw. der Name der Ereignisspalte (Format Event/Trial). |
Predictor (continuous) | Numerische Einflussgröße. Pflichtfeld. |
Link function | Logit (Standard), Probit oder Complementary log-log. |
Confidence level | Standard 95. |
Type of confidence interval | Two-sided (Standard), Lower bound oder Upper bound; gilt für Koeffizienten, Odds Ratios und das Kurvenband. |
Frequency (optional) | Spalte mit der Anzahl, wie oft jede Zeile vorkommt. |
Increment for odds ratio | Änderung der Einflussgröße, für die das Odds Ratio ausgegeben wird. Standard 1. Nur bei Logit-Link. |
Display observed proportions / Display confidence interval | Fügen dem Diagramm die beobachteten Ereignisanteile und das Konfidenzband hinzu. Standardmäßig aus. |
Residuals for plots | Regular- oder Deviance-Residuen für die Residuendiagramme. |
Histogram of residuals / Normal probability plot of residuals / Residuals versus order / Three in one | Residuendiagramme; Three in one zeichnet alle drei zusammen. |
Residuals versus the variables | Stellt die Residuen gegen eine gewählte Spalte dar. |
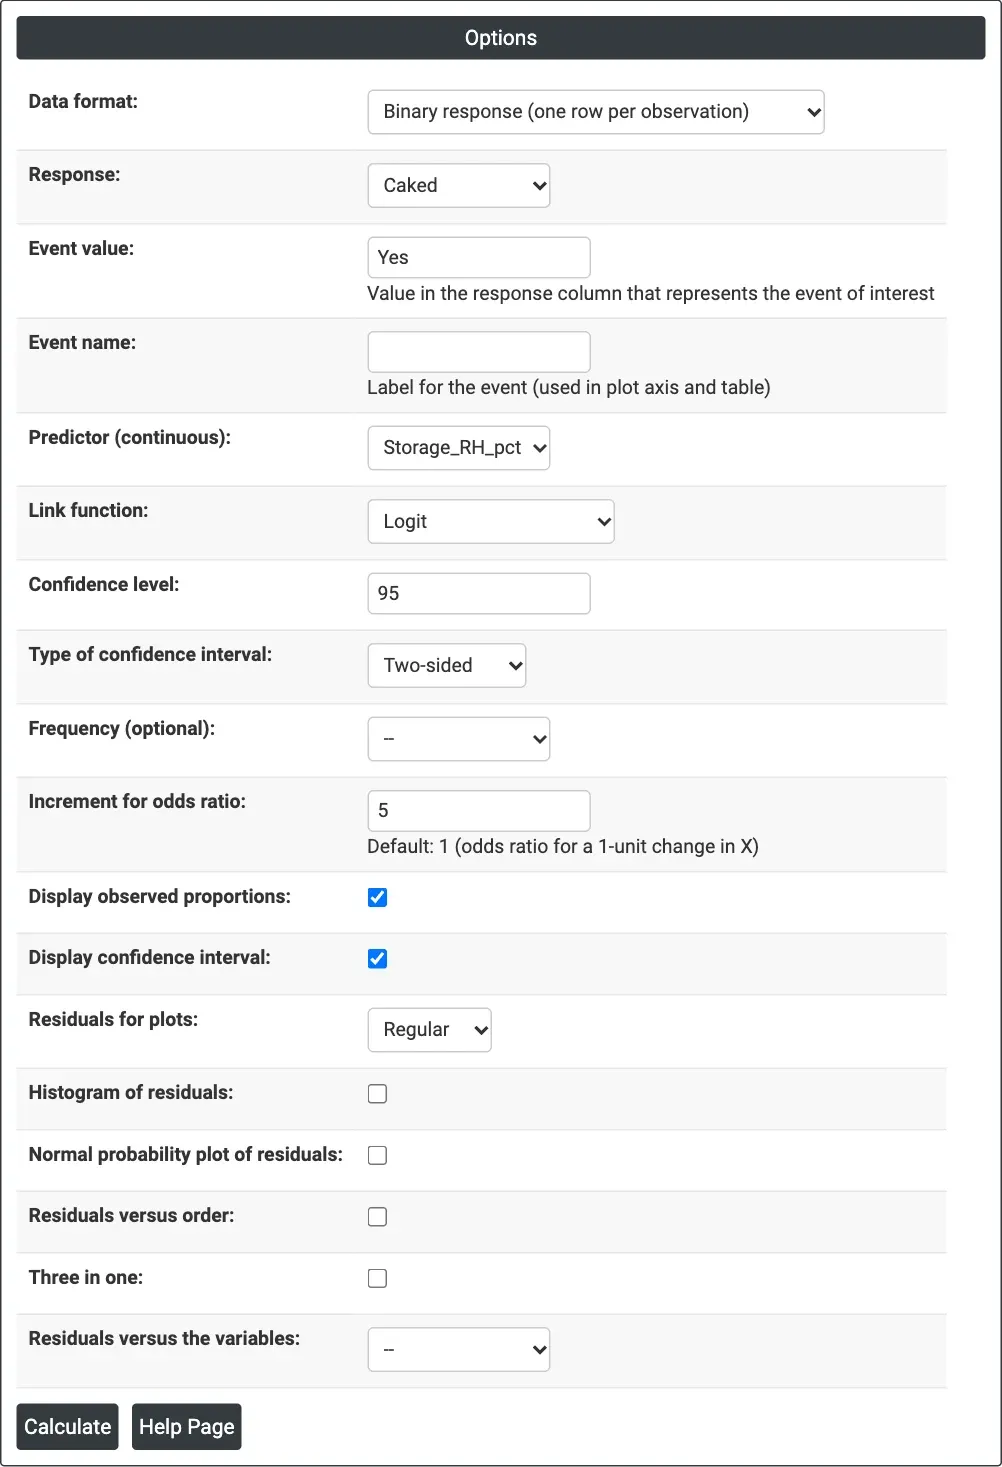
Abbildung 1 – Optionen für das Beispiel zum Verbacken von Säcken: Caked als Zielgröße mit dem Ereignis Yes, Storage_RH_pct als Einflussgröße, Logit-Link, Odds Ratio für einen Anstieg der Luftfeuchte um 5 Punkte.
Beschreibung der Ausgabe
- Regression Equation – die angepasste Wahrscheinlichkeit des Ereignisses als Funktion der Einflussgröße.
- Analysis of Variance – Devianztest der Einflussgröße (Adj Dev, Chi-Square, P-Value) mit Fehler- und Gesamtdevianz.
- Model Summary – Deviance R-Sq, Deviance R-Sq(adj), AIC, AICc, BIC und Area Under ROC Curve.
- Coefficients – Coef, SE Coef, Z-Value, P-Value und Konfidenzgrenzen für die Konstante und die Einflussgröße.
- Odds Ratios for Continuous Predictors (bzw. Odds Ratios (Increment=Δ)) – nur bei Logit-Link.
- Binary Fitted Line Plot – angepasste Wahrscheinlichkeitskurve, mit beobachteten Anteilen und Konfidenzband, falls aktiviert.
- Fits and Diagnostics for Unusual Observations – mit R (großes Residuum) oder X (ungewöhnlicher X-Wert) gekennzeichnete Zeilen.
- Residuendiagramme, falls ausgewählt.
- PDF-Export über Download.
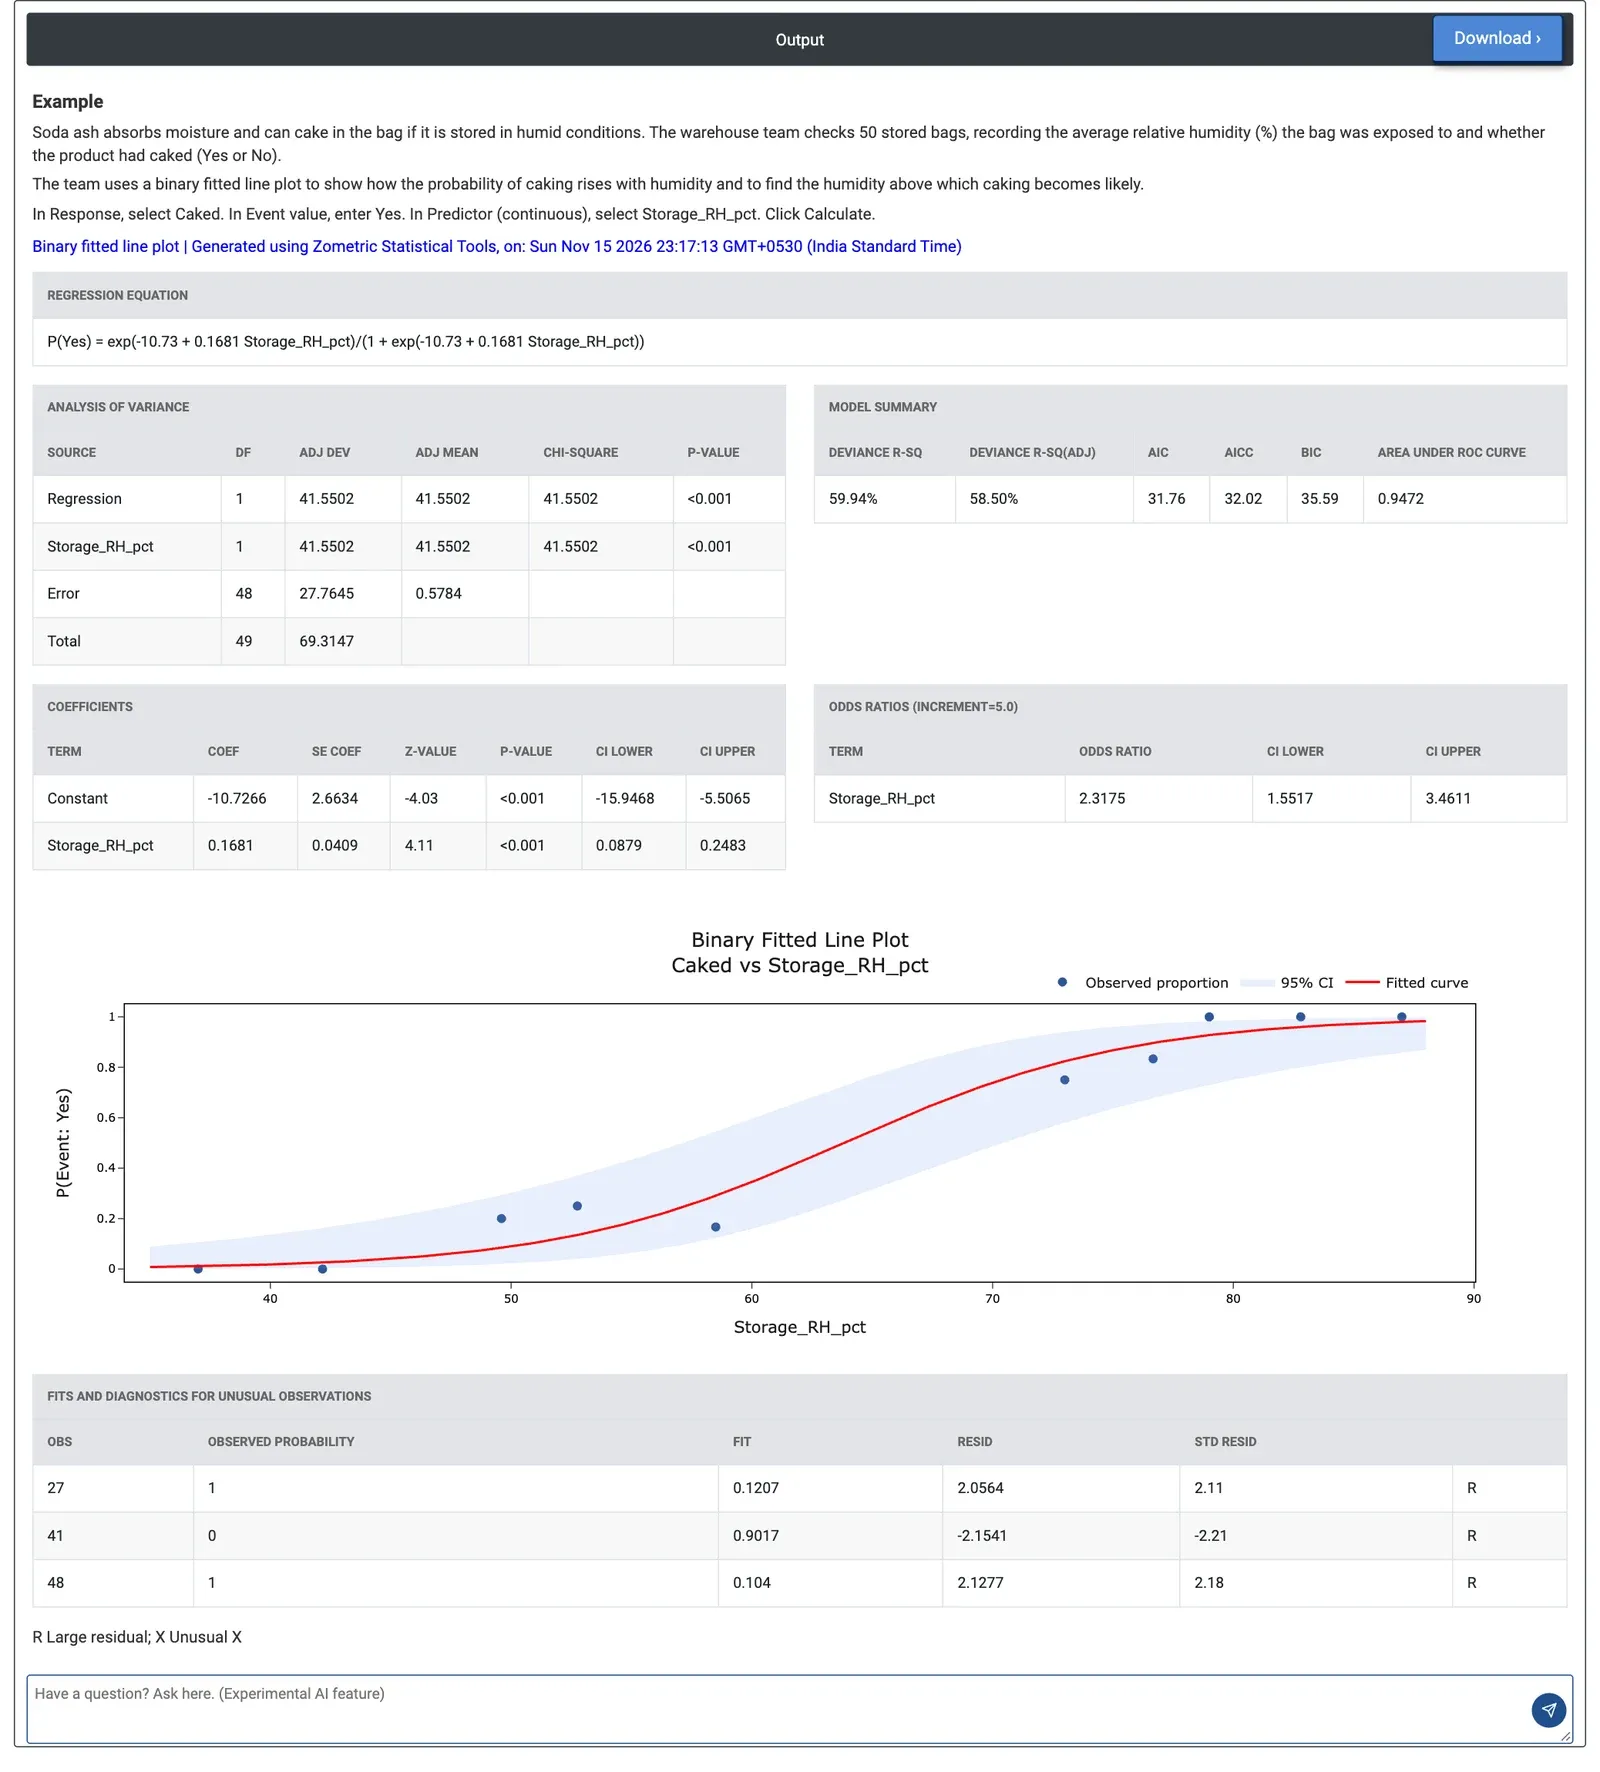
Abbildung 2 – Binary Fitted Line Plot der Verbackungswahrscheinlichkeit in Abhängigkeit von der Lagerluftfeuchte: Die Kurve überschreitet 50 % bei etwa 64 % r. F.
Beispiel
Soda (Natriumcarbonat) kann im Sack verbacken, wenn es feucht gelagert wird. Ein Lagerteam prüft 50 gelagerte Säcke und notiert die mittlere relative Luftfeuchte, der jeder Sack ausgesetzt war (Storage_RH_pct, 35 bis 88 %), und ob das Produkt verbacken war (Caked: 25 Yes, 25 No). Es wählt Caked als Zielgröße mit dem Event value Yes, Storage_RH_pct als Einflussgröße, behält den Logit-Link bei, setzt das Inkrement für das Odds Ratio auf 5 und aktiviert beide Anzeigeoptionen.
Die Luftfeuchte hat einen deutlichen Effekt: Das Devianz-Chi-Quadrat beträgt 41.55 mit p < 0.001, Deviance R-Sq beträgt 59.94 % und die Fläche unter der ROC-Kurve 0.9472; die Luftfeuchte trennt verbackene von einwandfreien Säcken also gut. Die Gleichung lautet P(Yes) = exp(−10.73 + 0.1681 RH) / (1 + exp(−10.73 + 0.1681 RH)). Jeder Anstieg der Luftfeuchte um 5 Punkte multipliziert die Odds des Verbackens mit 2.32 (95-%-KI 1.55 bis 3.46). Laut Gleichung beträgt die Verbackungswahrscheinlichkeit etwa 19 % bei 55 % r. F., 50 % bei 63.8 % r. F. und 74 % bei 70 % r. F.
Drei Säcke werden als ungewöhnlich gekennzeichnet: Zwei verbackten bei niedrigen angepassten Wahrscheinlichkeiten (0.12 und 0.10), und einer blieb bei 0.90 einwandfrei; hier lohnt sich die Prüfung auf andere Ursachen wie beschädigte Innensäcke. Um das Verbackungsrisiko unter etwa 10 % zu halten, legt die Kurve eine Lagerung unter rund 51 % r. F. nahe. Ein Wechsel zum Probit-Link liefert eine nahezu gleiche Anpassung (Deviance R-Sq 60.50 %).
Häufig gestellte Fragen
Was ist ein Binary Fitted Line Plot?
Ein Binary Fitted Line Plot modelliert, wie sich die Wahrscheinlichkeit eines Ja/Nein-Ergebnisses, etwa gut/schlecht oder verbacken/nicht verbacken, mit einer stetigen Einflussgröße ändert, und zeichnet die angepasste S-förmige Kurve über die Daten. Es handelt sich um eine binäre logistische Regression mit einer Einflussgröße, angepasst nach der Maximum-Likelihood-Methode, mit Logit-, Probit- oder komplementärer Log-Log-Linkfunktion.
Wie interpretiert man das Odds Ratio im Binary Fitted Line Plot?
Mit Logit-Link ist das Odds Ratio für ein Inkrement der Einflussgröße exp(b1 x Inkrement). Es ist der Faktor, mit dem die Odds des Ereignisses bei dieser Änderung multipliziert werden. Im Beispiel multiplizierte jeder Anstieg der Lagerluftfeuchte um 5 Punkte die Odds des Verbackens mit 2.32, mit einem 95-%-Konfidenzintervall von 1.55 bis 3.46.
Woran erkennt man, ob die Einflussgröße einen signifikanten Effekt hat?
Die ANOVA-Tabelle testet die Einflussgröße über die Abnahme der Devianz, ein Chi-Quadrat mit 1 Freiheitsgrad; ein kleiner p-Wert bedeutet einen deutlichen Effekt. Deviance R-Sq zeigt den erklärten Anteil der Null-Devianz, und die Fläche unter der ROC-Kurve zeigt die Trennschärfe, wobei 0.5 keine und 1 perfekte Trennung bedeutet.
Wie erstellt man einen Binary Fitted Line Plot in Zometric Statistical Software?
Wählen Sie das Datenformat: eine binäre Ergebnisspalte mit einem Event value oder Spalten für die Anzahl der Ereignisse und Versuche. Wählen Sie die stetige Einflussgröße und eine Linkfunktion (standardmäßig Logit), legen Sie Konfidenzniveau und Inkrement für das Odds Ratio fest und lassen Sie optional beobachtete Anteile und Konfidenzband anzeigen. Die Ausgabe liefert Gleichung, Tabellen und Diagramm.