
Binäre logistische Regression
Die binäre logistische Regression sagt die Wahrscheinlichkeit einer von zwei Ausprägungen (z. B. gut/schlecht, ja/nein) aus stetigen Prädiktoren, kategorialen Prädiktoren oder beiden voraus. Verwenden Sie sie, wenn die Zielgröße genau zwei Kategorien hat; stetige Zielgrößen erfordern Fit Regression Model. Erheben Sie genügend Daten in beiden Kategorien, vermeiden Sie vollständige Separation und validieren Sie mit Anpassungsgüte-Statistiken und Residuendiagnostik. Ergebnisse enthalten Konfidenzintervalle, standardmäßig 95 %.
Zuletzt geprüft
Kernaussage
Die binäre logistische Regression modelliert den Zusammenhang zwischen einem oder mehreren Prädiktoren und einer Zielgröße mit genau zwei Ausprägungen (z. B. gut/schlecht, fehlerhaft/fehlerfrei) und sagt deren Wahrscheinlichkeiten voraus.
Auf dieser Seite
Was ist die binäre logistische Regression?
Die binäre logistische Regression ist ein statistisches Werkzeug, mit dem der Zusammenhang zwischen einer oder mehreren Prädiktorvariablen und einer kategorialen Zielgröße mit genau zwei Ausprägungen untersucht wird, etwa gut/schlecht, ja/nein oder fehlerhaft/fehlerfrei. Sie sagt anhand der Prädiktorwerte die Wahrscheinlichkeit voraus, mit der die eine Ausprägung statt der anderen eintritt.
Wann wird die binäre logistische Regression eingesetzt?
Prädiktorvariablen
- Prädiktoren können stetig, kategorial oder eine Mischung aus beidem sein
- Diskrete Variablen können je nach Anzahl der Stufen und Ziel der Analyse als stetig oder kategorial behandelt werden
- Nur ein stetiger Prädiktor bei stetiger Zielgröße → verwenden Sie Fit Line Model
- Mehrere Prädiktoren bei stetiger Zielgröße → verwenden Sie Fit Regression Model
Zielgröße
- Die Zielgröße muss genau zwei Kategorien haben (z. B. gut/schlecht, ja/nein, in Ordnung/nicht in Ordnung)
- Ist die Zielgröße stetig → verwenden Sie Fit Regression Model
- Hat die Zielgröße drei oder mehr ungeordnete Kategorien → verwenden Sie die nominale logistische Regression
- Hat die Zielgröße drei oder mehr geordnete Kategorien → verwenden Sie die ordinale logistische Regression
Hinweise zur richtigen Anwendung der binären logistischen Regression
- Die Zielgröße muss genau zwei Kategorienhaben; hat sie mehr, verwenden Sie stattdessen die ordinale oder nominale logistische Regression.
- Prädiktoren können stetig oder kategorialsein; stellen Sie vor der Analyse sicher, dass jede Variable richtig eingeordnet ist.
- Stellen Sie sicher, dass die Daten die Zielgrundgesamtheit zutreffend abbilden; verzerrte oder unvollständige Daten führen zu unzuverlässigen Vorhersagen.
- Erheben Sie ausreichend Datenpunkte für beide Kategorien . Sehr wenige Beobachtungen in einer Kategorie machen das Modell instabil und die Vorhersagen unzuverlässig.
- Messen Sie alle Variablen so genau wie möglich; Fehler in den Eingangsdaten verringern unmittelbar die Genauigkeit der vorhergesagten Wahrscheinlichkeiten.
- Erfassen Sie die Daten in der Reihenfolge ihrer Erhebung , damit sich zeitabhängige Muster erkennen lassen, die die Ergebnisse beeinflussen könnten.
- Validieren Sie das Modell nach der Anpassung mit Anpassungsgüte-Statistiken und Residuendiagnostik; ein schlecht angepasstes Modell liefert irreführende Vorhersagen.
- Vermeiden Sie vollständige Separation , bei der ein Prädiktor die beiden Kategorien vollständig trennt, denn sie verursacht Schätzprobleme im Modell.
Alternativen: Wann Sie keine binäre logistische Regression verwenden sollten
- Ist die Zielgröße stetig, verwenden Sie stattdessen Fit Regression Model .
- Haben Sie nur einen stetigen Prädiktor bei stetiger Zielgröße, verwenden Sie stattdessen Fit Line Model .
- Hat die Zielgröße drei oder mehr ungeordnete Kategorien, verwenden Sie stattdessen die nominale logistische Regression .
- Hat die Zielgröße drei oder mehr geordnete Kategorien, verwenden Sie stattdessen die ordinale logistische Regression .
- Haben Sie einen kategorialen Prädiktor bei stetiger Zielgröße, verwenden Sie stattdessen die einfache ANOVA .
Anleitung: Binäre logistische Regression durchführen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool>Regression >Binary Logistic Regression .
- Klicken Sie auf Binary Logistic Regression, um zum Dashboard zu gelangen.
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie hier ein (Strg+V).
- Füllen Sie die erforderlichen Optionen auf der linken Seite aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard der binären logistischen Regression ist in zwei Bereiche unterteilt.
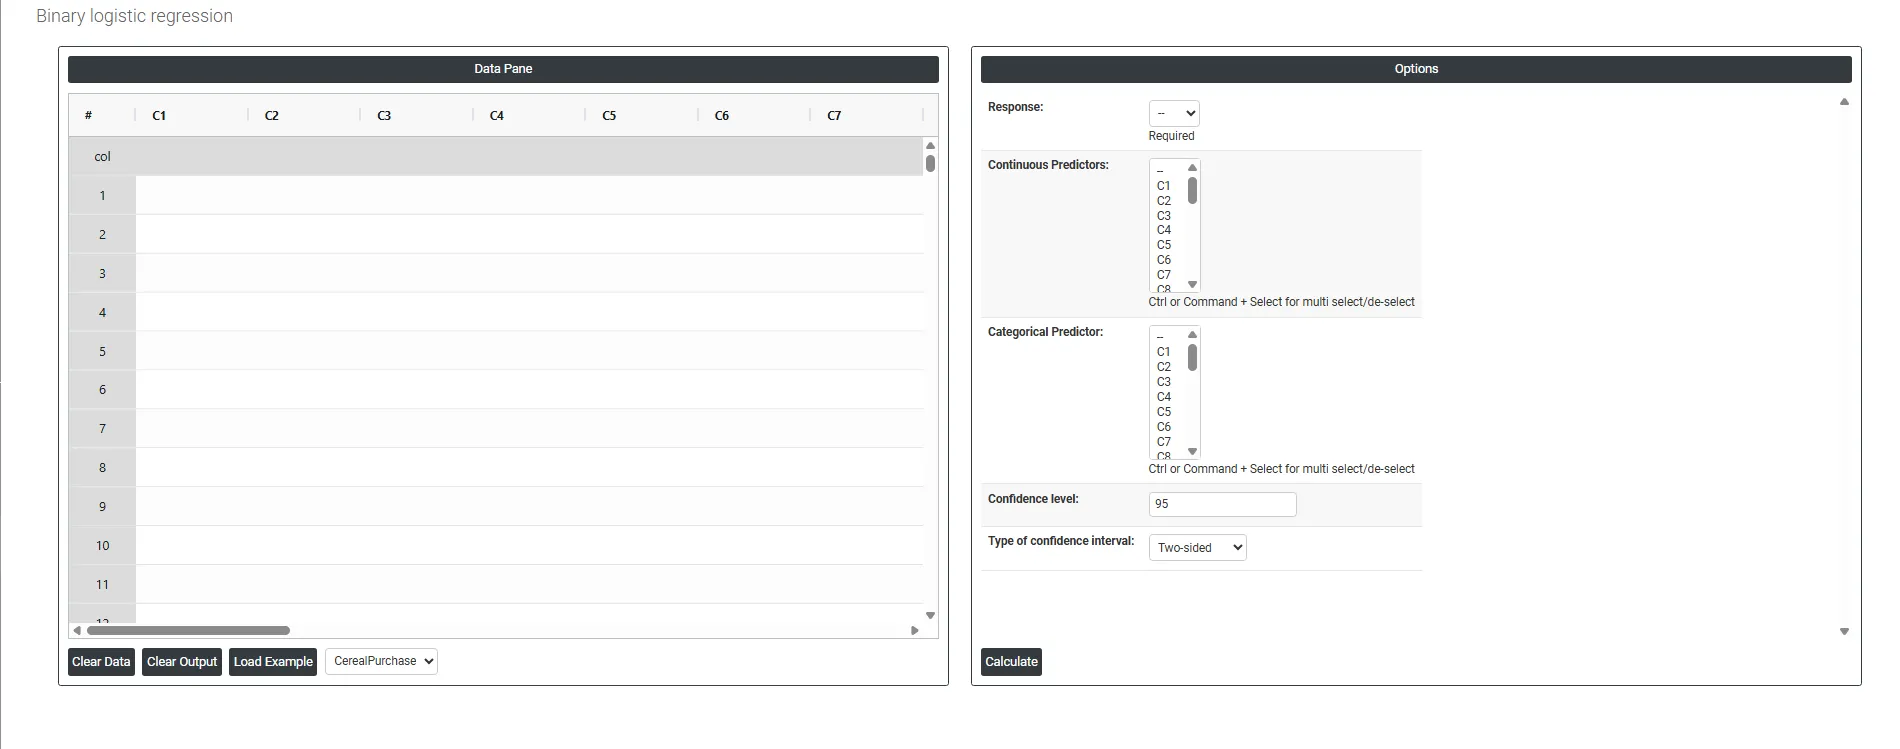
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example: Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich stehen zahlreiche Optionen zur Verfügung:
- Response Die Ergebnisvariable, die Sie vorhersagen möchten; sie muss genau zwei Kategorienenthalten, etwa gut/schlecht, ja/nein oder fehlerhaft/fehlerfrei. Das Modell berechnet anhand der eingegebenen Prädiktorwerte die Wahrscheinlichkeit, mit der die eine Kategorie statt der anderen eintritt.
- Categorical Predictor Eine Prädiktorvariable mit einer festen Menge eindeutiger Gruppen oder Bezeichnungen, etwa Schicht, Maschinentyp oder Lieferant. Das Modell schätzt, wie die Zugehörigkeit zu jeder Gruppe die Wahrscheinlichkeit verändert, dass die Zielgröße in die eine statt in die andere Kategorie fällt.
- Continuous Predictor Eine Prädiktorvariable mit messbaren numerischen Werten, etwa Temperatur, Geschwindigkeit oder Gewicht. Das Modell schätzt, wie eine Zunahme dieser Variablen um eine Einheit die Wahrscheinlichkeit des Ergebnisses der Zielgröße erhöht oder verringert.
- Confidence Interval Ein Wertebereich, in dem das wahre Ergebnis mit hoher Wahrscheinlichkeit liegt. Der Standardwert ist 95%, das heißt, Sie können zu 95 % sicher sein, dass die wahre Wahrscheinlichkeit bzw. der wahre Koeffizient in diesem Bereich liegt. Standardmäßig sind 95 % eingestellt, weil dies der allgemein anerkannte Standard ist, der statistische Zuverlässigkeit und praktische Brauchbarkeit ausbalanciert: schmal genug, um nützlich zu sein, und breit genug, um die Unsicherheit zu berücksichtigen.
- Type of Confidence Interval
- Two-Sided : Liefert eine untere und eine obere Grenze und zeigt so den Bereich, in dem der wahre Wert auf beiden Seiten mit hoher Wahrscheinlichkeit liegt. Verwenden Sie diese Option, wenn Sie jede Abweichung nach oben oder unten erkennen möchten. Dies ist die Standardeinstellung und die am häufigsten verwendete Option.
- Upper Bound : Liefert nur die obere Grenze, also den höchsten Wert, den das wahre Ergebnis mit hoher Wahrscheinlichkeit erreicht. Verwenden Sie diese Option, wenn es Ihnen nur darum geht, ob der Wert einen bestimmten Schwellenwert überschreitet.
- Lower Bound : Liefert nur die untere Grenze, also den niedrigsten Wert, den das wahre Ergebnis mit hoher Wahrscheinlichkeit annimmt. Verwenden Sie diese Option, wenn es Ihnen nur darum geht, ob der Wert einen bestimmten Schwellenwert unterschreitet.
Häufig gestellte Fragen
Was ist die binäre logistische Regression?
Die binäre logistische Regression untersucht den Zusammenhang zwischen einer oder mehreren Prädiktorvariablen und einer kategorialen Zielgröße mit genau zwei Ausprägungen, etwa gut/schlecht, ja/nein oder fehlerhaft/fehlerfrei. Sie sagt aus den Prädiktorwerten die Wahrscheinlichkeit voraus, mit der die eine Ausprägung statt der anderen eintritt. Prädiktoren können stetig, kategorial oder eine Mischung aus beidem sein.
Wann sollte man die binäre logistische Regression statt anderer Regressionsverfahren verwenden?
Verwenden Sie sie, wenn die Zielgröße genau zwei Kategorien hat. Ist die Zielgröße stetig, verwenden Sie Fit Regression Model bzw. bei einem einzigen stetigen Prädiktor Fit Line Model. Hat die Zielgröße drei oder mehr ungeordnete Kategorien, verwenden Sie die nominale logistische Regression; bei drei oder mehr geordneten Kategorien die ordinale logistische Regression.
Welche Voraussetzungen gelten für eine zuverlässige binäre logistische Regression?
Erheben Sie genügend Datenpunkte in beiden Kategorien der Zielgröße, da sehr wenige Beobachtungen in einer Kategorie das Modell instabil machen. Ordnen Sie jeden Prädiktor richtig als stetig oder kategorial ein, verwenden Sie repräsentative und genau gemessene Daten und vermeiden Sie vollständige Separation, bei der ein Prädiktor die beiden Kategorien vollständig trennt, denn sie verursacht Schätzprobleme. Validieren Sie das Modell mit Anpassungsgüte-Statistiken und Residuendiagnostik.
Wie führt man eine binäre logistische Regression in Zometric Statistical Software durch?
Wählen Sie Statistical Tool > Regression > Binary Logistic Regression und geben Sie die Daten ein, fügen Sie sie ein oder laden Sie sie. Wählen Sie die Spalte Response mit zwei Kategorien sowie gegebenenfalls Spalten für Categorical Predictor und Continuous Predictor, legen Sie das Konfidenzniveau des Konfidenzintervalls (standardmäßig 95 %) und die Art des Konfidenzintervalls (zweiseitig, obere Grenze oder untere Grenze) fest und klicken Sie auf Calculate.