
Chi-Quadrat-Anpassungstest (Chi Square Goodness Of Fit)
Ein Chi-Quadrat-Anpassungstest prüft, ob die beobachtete Häufigkeitsverteilung einer kategorialen Variablen einer bestimmten erwarteten Verteilung entspricht. Er vergleicht, wie oft jede Kategorie in Ihren Daten tatsächlich vorkommt, mit der Häufigkeit, die Sie aufgrund eines theoretischen Modells oder einer vorherigen Annahme für jede Kategorie erwarten würden.
Zuletzt geprüft
Kernaussage
Ein Chi-Quadrat-Anpassungstest prüft, ob die beobachtete Häufigkeitsverteilung einer kategorialen Variablen einer bestimmten erwarteten Verteilung entspricht.
Auf dieser Seite
- Was ist der Chi-Quadrat-Anpassungstest?
- Wann wird der Chi-Quadrat-Anpassungstest eingesetzt?
- Hinweise zur richtigen Anwendung des Chi-Quadrat-Anpassungstests
- Alternativen: Wann Sie den Chi-Quadrat-Anpassungstest nicht verwenden sollten
- Beispiel für einen Chi-Quadrat-Anpassungstest
- Anleitung: Chi-Quadrat-Anpassungstest durchführen
Was ist der Chi-Quadrat-Anpassungstest?
Ein Chi-Quadrat-Anpassungstest prüft, ob die beobachtete Häufigkeitsverteilung einer kategorialen Variablen einer bestimmten erwarteten Verteilung entspricht. Er vergleicht, wie oft jede Kategorie in Ihren Daten tatsächlich vorkommt, mit der Häufigkeit, die Sie aufgrund eines theoretischen Modells oder einer vorherigen Annahme für jede Kategorie erwarten würden.
Sie könnten beispielsweise prüfen, ob eine Fertigungslinie Fehler gleichmäßig über alle Schichten verteilt produziert oder ob sich Kundenreklamationen in den von Ihrem Modell vorhergesagten Anteilen auf die Kategorien verteilen.
Einfache Definition: Ein Test, der prüft, ob die tatsächlich beobachteten Häufigkeiten in den Kategorien den erwarteten Häufigkeiten entsprechen. Er zeigt Ihnen, ob Ihre Daten zum vorhergesagten Muster passen.
Wann wird der Chi-Quadrat-Anpassungstest eingesetzt?
- Verwenden Sie ihn, wenn Ihre Zielgröße kategorial ist und Sie prüfen möchten, ob ihre beobachtete Verteilung einer erwarteten oder theoretischen Verteilung entspricht.
- Verwenden Sie ihn, um zu prüfen, ob ein Prozess Fehler oder Ergebnisse in den erwarteten Anteilen über Kategorien wie Schicht, Maschine oder Produkttyp hervorbringt.
- Verwenden Sie ihn, wenn Sie ein theoretisches Modell oder eine vorherige Verteilung haben und prüfen möchten, wie gut Ihre tatsächlichen Daten damit übereinstimmen.
- Verwenden Sie ihn bei Stichprobenaudits, Konformitätsprüfungen und Qualitätsbewertungen , bei denen die erwarteten Häufigkeiten aus Spezifikationen oder historischen Daten bekannt sind.
Hinweise zur richtigen Anwendung des Chi-Quadrat-Anpassungstests
- Jede Kategorie muss eine erwartete Häufigkeit von mindestens 5 haben; Kategorien mit sehr kleinen erwarteten Häufigkeiten machen den Test unzuverlässig. Fassen Sie Kategorien bei Bedarf zusammen.
- Die Beobachtungen müssen unabhängig sein: Die Häufigkeit in einer Kategorie darf die Häufigkeit in einer anderen nicht beeinflussen.
- Die erwarteten Anteile oder Häufigkeiten müssen festgelegt werden, bevor Sie die Daten betrachten ; sie aus demselben zu prüfenden Datensatz abzuleiten, ist ein Zirkelschluss und ungültig.
- Ein p-Wert unter 0.05 zeigt an, dass sich die beobachtete Verteilung signifikant von der erwarteten unterscheidet; untersuchen Sie, welche Kategorien die größten Abweichungen zeigen.
- Erheben Sie eine ausreichend große Gesamtstichprobe , damit alle erwarteten Zellhäufigkeiten den Mindestwert von 5 erreichen.
Alternativen: Wann Sie den Chi-Quadrat-Anpassungstest nicht verwenden sollten
- Wenn Sie den Zusammenhang zwischen zwei kategorialen Variablenprüfen, verwenden Sie den Chi-Quadrat-Unabhängigkeitstest
- Wenn die Zielgröße stetigist, verwenden Sie den Test auf Normalverteilung oder die Identifikation der Verteilung (Individual Distribution Identification)
- Wenn Zähldaten einem Poisson-Prozess folgen (seltene Ereignisse über Zeit oder Fläche), verwenden Sie den Poisson-Anpassungstest
Beispiel für einen Chi-Quadrat-Anpassungstest
Ein Einkaufsleiter möchte den Anteil der verkauften T-Shirts jeder Größe mit dem Anteil der bestellten vergleichen. Der Manager zählt, wie viele T-Shirts jeder Größe in einer Woche verkauft werden. Der Einkäufer führt einen Chi-Quadrat-Anpassungstest durch, um festzustellen, ob die Anteile der verkauften T-Shirt-Größen mit den Anteilen der bestellten T-Shirt-Größen übereinstimmen. Die Schritte:
- Die erforderlichen Daten wurden erhoben.
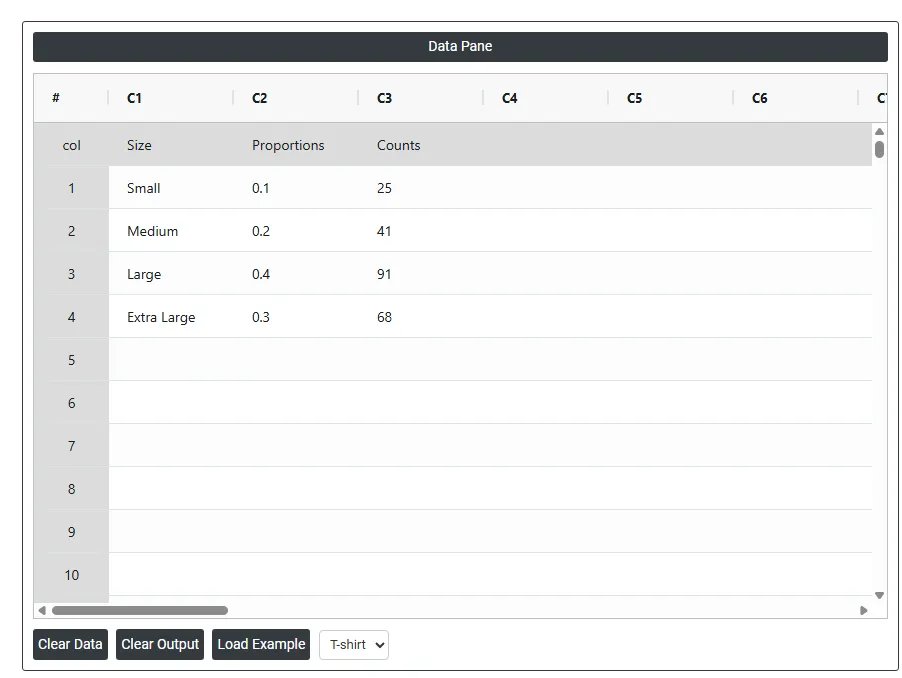
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Den Chi-Quadrat-Anpassungstest finden Sie unter Statistical module> Hypothesis Test> Chi Square Goodness Of Fit.
- Geben Sie im Werkzeug die Daten zusammen mit den weiteren Eingaben wie folgt ein:
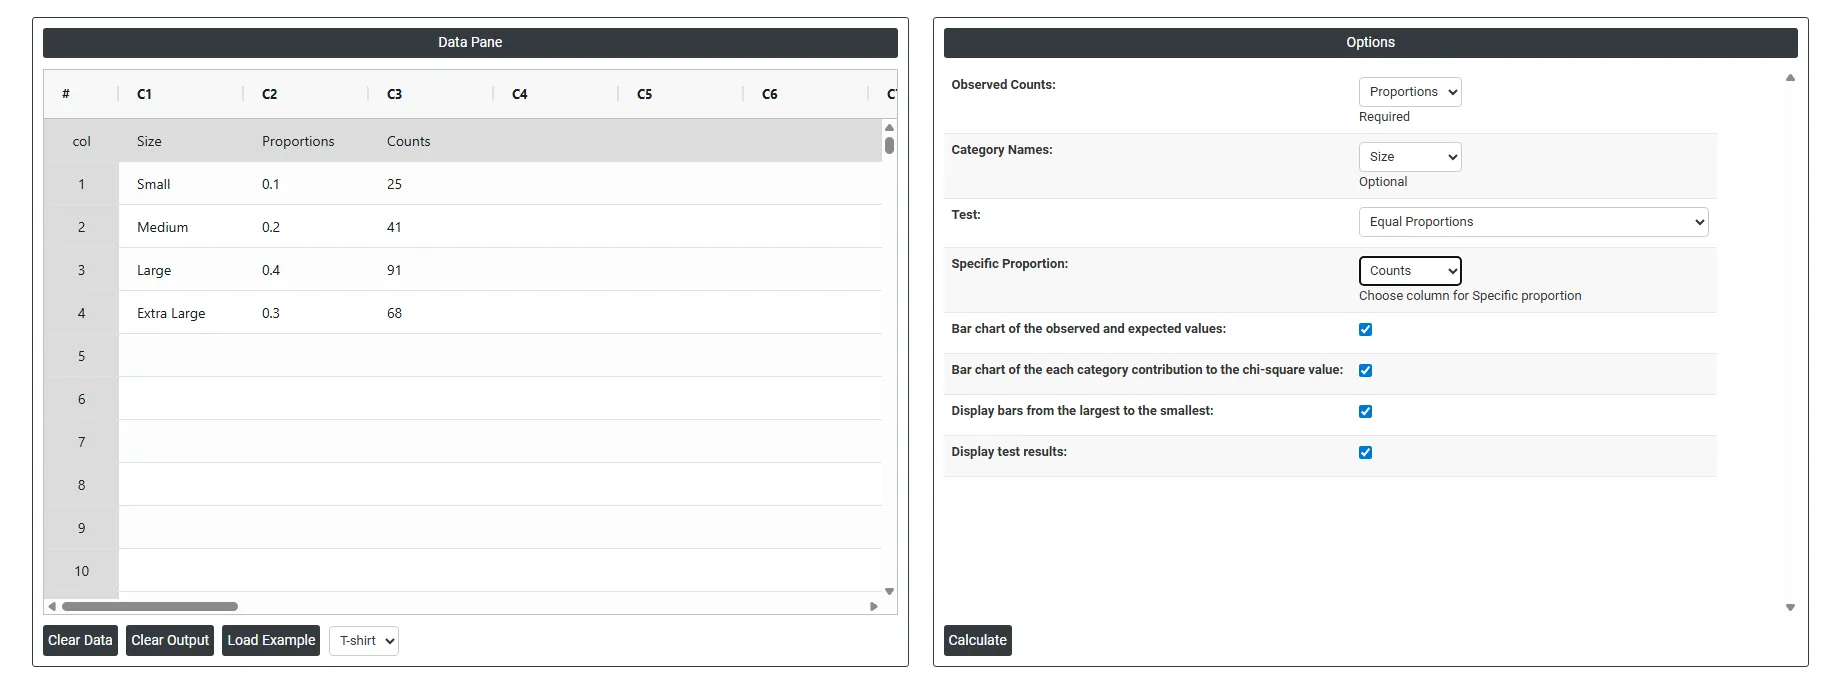
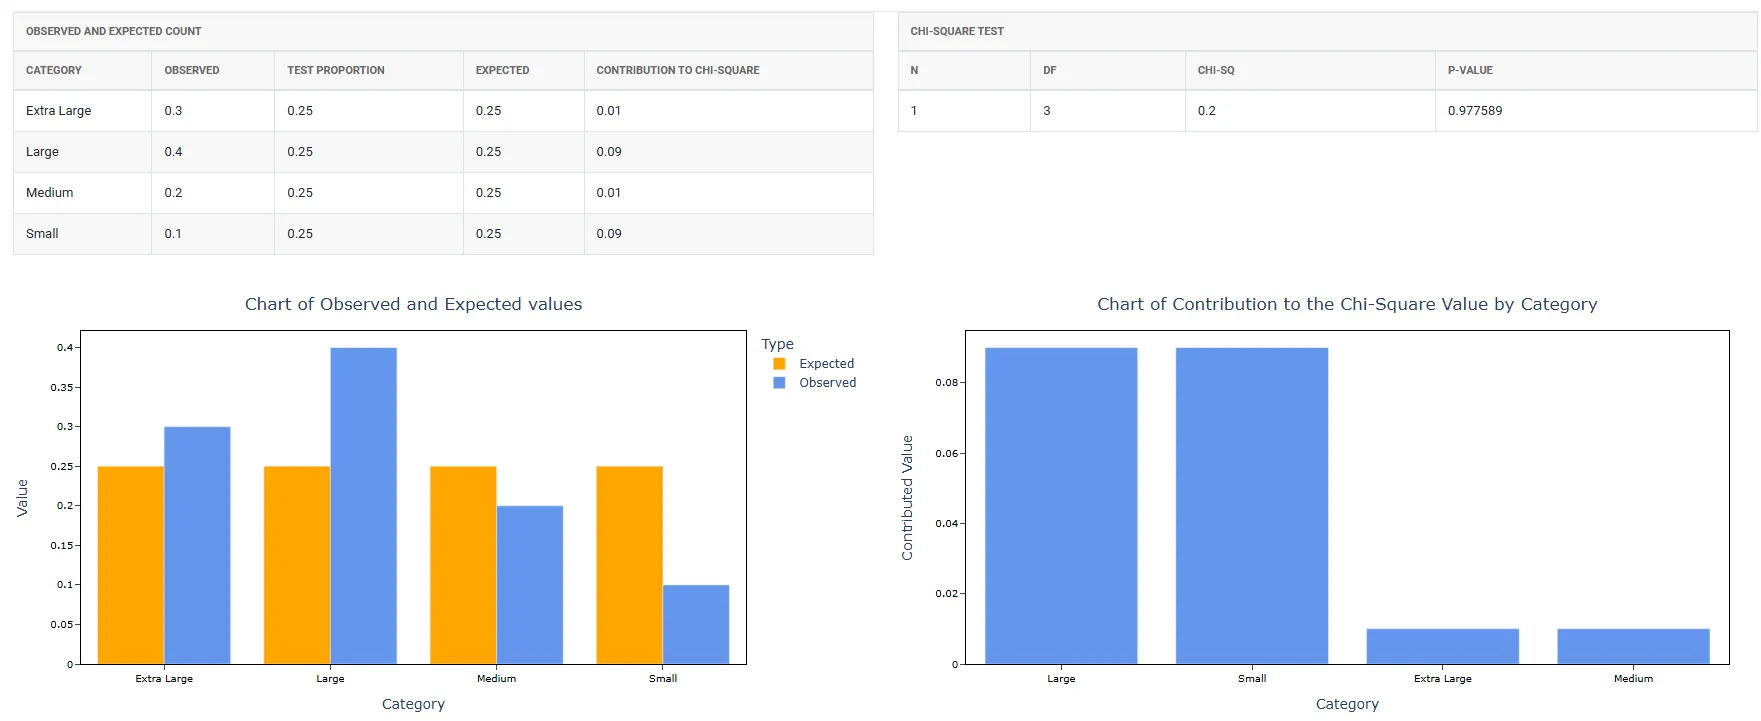
5. Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
Anleitung: Chi-Quadrat-Anpassungstest durchführen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Hypothesis Test >Chi Square Goodness Of Fit .
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie hier ein (Strg+V).
- Füllen Sie die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard des Chi-Quadrat-Anpassungstests ist in zwei Bereiche unterteilt.
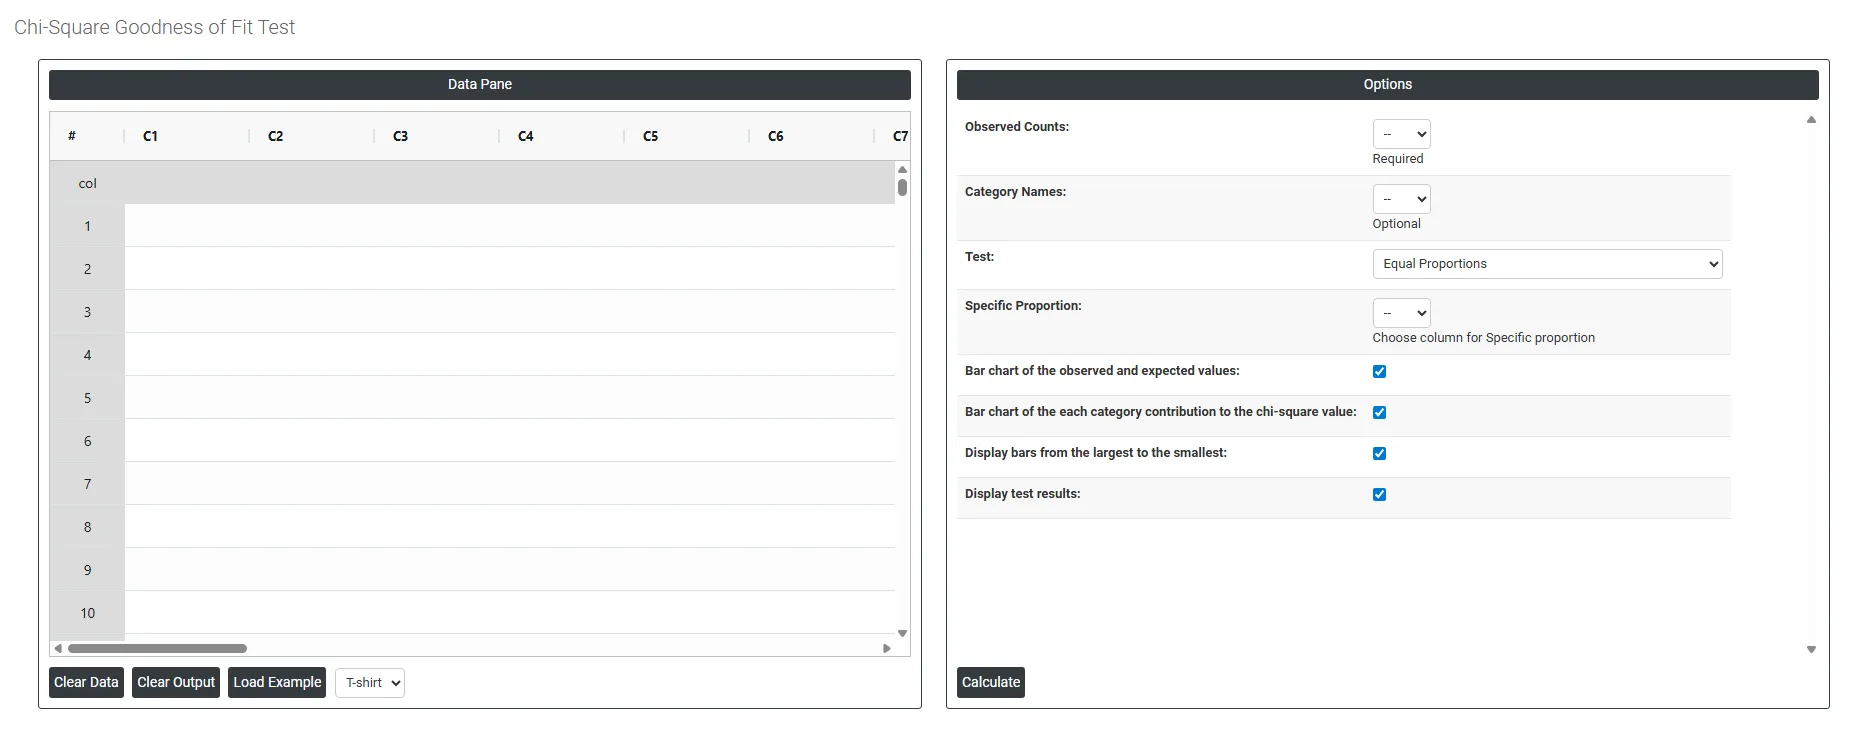
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example: Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Observed Counts Wählen Sie die Spalte mit den tatsächlichen Häufigkeiten , die für jede Kategorie in Ihren Daten erfasst wurden, zum Beispiel die Anzahl der in jeder Schicht beobachteten Fehler, die Anzahl der Kundenreklamationen je Kategorie oder die Anzahl der Vorkommen in jeder Gruppe. Dies ist die zentrale Eingabe, mit der der Test das tatsächlich Eingetretene mit dem Erwarteten vergleicht. Dieses Feld ist erforderlich.
- Category Names; Wählen Sie die Spalte mit den Bezeichnungen oder Namen jeder Kategorie, zum Beispiel Shift 1, Shift 2, Shift 3 oder Scratch, Dent, Tear. Diese Angabe ist optional, wird aber empfohlen, da Ausgabediagramme und Ergebnistabelle dadurch eindeutig beschriftet und leichter zu interpretieren und in Berichten darzustellen sind.
- Test: Legt fest, mit welcher erwarteten Verteilung die beobachteten Häufigkeiten verglichen werden. Drei Optionen stehen zur Verfügung:
- Equal Proportions : prüft, ob alle Kategorien gleich häufig auftreten. Verwenden Sie diese Option, wenn Ihre Nullhypothese lautet, dass jede Kategorie gleich oft vorkommen sollte, zum Beispiel bei der Prüfung, ob Fehler gleichmäßig über alle Wochentage verteilt sind.
- Specific Proportions : prüft, ob Kategorien mit bestimmten, vorab festgelegten Anteilen auftreten, die Sie manuell eingeben. Verwenden Sie diese Option, wenn Sie eine erwartete Verteilung aus Theorie, historischen Daten oder Spezifikationen haben, zum Beispiel bei der Prüfung, ob 60% der Ergebnisse in Kategorie A, 30% in Kategorie B und 10% in Kategorie C fallen.
- Properties Specified by Historical Counts (Input Column) : prüft gegen erwartete Anteile, die aus einer Referenzspalte mit historischen Häufigkeiten abgeleitet werden, statt aus manuell eingegebenen Werten. Verwenden Sie diese Option, wenn Sie einen früheren Datensatz oder Basiszeitraum haben, mit dessen Verteilung Sie Ihre aktuellen Daten vergleichen möchten.
- Specific Proportion: Wählen Sie die Spalte mit den erwarteten Anteilen oder Referenzhäufigkeiten jeder Kategorie, wenn Sie die Testoption Specific Proportions oder Historical Counts verwenden. Die Werte in dieser Spalte legen fest, wie die Verteilung unter der Nullhypothese aussehen sollte; der erwartete Anteil jeder Kategorie muss in der Reihenfolge den Kategorien in der Spalte Observed Counts entsprechen.
- Bar Chart of Observed and Expected Values: Wenn aktiviert, wird ein Balkendiagramm angezeigt, das beobachtete und erwartete Häufigkeiten für jede Kategorie nebeneinander vergleicht. Dies ist eine der nützlichsten grafischen Ausgaben: Sie zeigt sofort, bei welchen Kategorien die größten Lücken zwischen Beobachtetem und Erwartetem bestehen, und hilft Ihnen, die Stellen mit der stärksten Abweichung der Verteilung zu finden.
- Bar Chart of Each Category Contribution to the Chi-Square Value: Wenn aktiviert, wird ein Balkendiagramm angezeigt, das zeigt, wie viel jede einzelne Kategorie zur gesamten Chi-Quadrat-Statistik beiträgt. Die Kategorien mit den höchsten Balken bestimmen das signifikante Ergebnis. So erkennen Sie genau, welche Kategorien am stärksten für die Abweichung von der erwarteten Verteilung verantwortlich sind, statt nur zu wissen, dass insgesamt ein Unterschied besteht.
- Display Bars from Largest to Smallest: Wenn aktiviert, werden die Balken in den Diagrammen in absteigender Reihenfolge vom größten Beitrag bzw. der größten Häufigkeit zum kleinsten sortiert. So können Sie leichter priorisieren, welche Kategorien am wichtigsten sind, und sich zuerst auf die größten Abweichungen konzentrieren; das ist besonders nützlich, wenn es viele Kategorien gibt und Sie die bedeutendsten schnell erkennen möchten.
- Display Test Results: Wenn aktiviert, wird die vollständige statistische Testausgabe direkt im oder neben dem Diagramm angezeigt, einschließlich Chi-Quadrat-Statistik, Freiheitsgraden und p-Wert. So sehen Sie die grafischen und statistischen Ergebnisse gemeinsam an einer Stelle, ohne eine separate Ausgabetabelle heranziehen zu müssen.
Häufig gestellte Fragen
Was sagt Ihnen ein Chi-Quadrat-Anpassungstest?
Er zeigt, ob die beobachtete Häufigkeitsverteilung einer kategorialen Variablen einer bestimmten erwarteten Verteilung entspricht, indem er vergleicht, wie oft jede Kategorie tatsächlich vorkommt und wie oft sie nach einem theoretischen Modell oder einer vorherigen Annahme vorkommen sollte. Ein p-Wert unter 0.05 zeigt einen signifikanten Unterschied an; untersuchen Sie dann, welche Kategorien die größten Abweichungen zeigen.
Welche Voraussetzungen hat der Chi-Quadrat-Anpassungstest?
Jede Kategorie sollte eine erwartete Häufigkeit von mindestens 5 haben; fassen Sie Kategorien bei Bedarf zusammen und erheben Sie eine ausreichend große Gesamtstichprobe. Die Beobachtungen müssen unabhängig sein, damit die Häufigkeit in einer Kategorie keine andere beeinflusst. Die erwarteten Anteile müssen festgelegt werden, bevor Sie die Daten betrachten, denn sie aus demselben Datensatz abzuleiten, ist ein Zirkelschluss und ungültig.
Gegen welche erwarteten Verteilungen können Sie prüfen?
In Zometric Statistical Software bietet die Option Test drei Möglichkeiten: Equal Proportions, bei der jede Kategorie gleich oft vorkommen sollte; Specific Proportions, manuell eingegeben aus Theorie, historischen Daten oder Spezifikationen; und Anteile, die durch historische Häufigkeiten in einer Referenzspalte festgelegt sind, um aktuelle Daten mit einem früheren Datensatz oder Basiszeitraum zu vergleichen.
Wann sollten Sie stattdessen den Chi-Quadrat-Unabhängigkeitstest verwenden?
Verwenden Sie den Anpassungstest für eine kategoriale Variable, die mit einer erwarteten Verteilung verglichen wird. Um den Zusammenhang zwischen zwei kategorialen Variablen zu prüfen, verwenden Sie den Chi-Quadrat-Unabhängigkeitstest. Ist die Zielgröße stetig, verwenden Sie einen Test auf Normalverteilung oder die Identifikation der Verteilung, und folgen die Häufigkeiten einem Poisson-Prozess, verwenden Sie den Poisson-Anpassungstest.