
Chi-Quadrat-Unabhängigkeitstest (Kreuztabelle)
Der Chi-Quadrat-Unabhängigkeitstest prüft anhand einer zusammengefassten Kreuztabelle mit Häufigkeiten oder anhand von Rohdaten, ob zwei kategoriale Variablen zusammenhängen. Er vergleicht beobachtete mit den bei Unabhängigkeit erwarteten Häufigkeiten mit dem Pearson- und dem Likelihood-Quotienten-Chi-Quadrat bei (r − 1)(c − 1) Freiheitsgraden. Beiträge und adjustierte Residuen zeigen, welche Zellen das Ergebnis bestimmen. Die erwarteten Häufigkeiten dürfen nicht zu klein sein.
Zuletzt geprüft
Kernaussage
Der Chi-Quadrat-Unabhängigkeitstest prüft, ob zwei kategoriale Variablen zusammenhängen, etwa ob die Verteilung der Fehlerarten von Schicht, Lieferant oder Linie abhängt, und zeigt, welche Zellen den Zusammenhang bestimmen.
Auf dieser Seite
Zweck
Der Chi-Quadrat-Unabhängigkeitstest (Chi-Square Test of Independence) prüft, ob zwei kategoriale Variablen zusammenhängen, zum Beispiel ob die Verteilung der Fehlerarten von der Schicht, dem Lieferanten oder der Linie abhängt. Geben Sie eine bereits zusammengefasste Häufigkeitstabelle oder die Rohdaten mit einer Zeile pro Einheit ein; das Werkzeug prüft den Zusammenhang und zeigt, welche Zellen ihn bestimmen.
Wichtige Funktionen
- Zusammengefasste Kreuztabelle (eine Spalte pro Spaltenkategorie, eine Zeile pro Zeilenkategorie) oder kategoriale Rohdaten mit optionalen Häufigkeiten.
- Pearson- und Likelihood-Quotienten-Chi-Quadrat-Test.
- Optionale Tabellen mit erwarteten Häufigkeiten, Beiträgen zum Chi-Quadrat-Wert, rohen, standardisierten und adjustierten Residuen sowie Zeilen-, Spalten- und Gesamtprozenten.
- Optionale geführte Interpretation: zusammenfassender Bericht mit Prozentprofilen und Diagrammen der %-Differenzen, Diagnosebericht und Berichtskarte.
- Data Options: Teilmenge der Zeilen vor der Analyse bilden.
Statistische Methoden
Für eine r × c-Tabelle beobachteter Häufigkeiten O mit Zeilensummen Rᵢ, Spaltensummen Cⱼ und Gesamtsumme N ist die erwartete Häufigkeit bei Unabhängigkeit Eᵢⱼ = Rᵢ·Cⱼ / N. Die Pearson-Statistik ist χ² = Σ (O − E)² / E, die Likelihood-Quotienten-Statistik G² = 2 Σ O·ln(O / E). Beide werden mit einer Chi-Quadrat-Verteilung mit (r − 1)(c − 1) Freiheitsgraden verglichen. Ein kleiner p-Wert bedeutet, dass Zeilen- und Spaltenvariable zusammenhängen: Die Verteilung über die Spalten ist nicht in jeder Zeile gleich.
Der Beitrag (O − E)² / E jeder Zelle zeigt, woher der Zusammenhang kommt. Das rohe Residuum ist O − E, das standardisierte Residuum (O − E) / √E und das adjustierte Residuum (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)), das annähernd standardnormalverteilt ist: Werte jenseits von etwa ±2 kennzeichnen Zellen, die deutlich von der Unabhängigkeit abweichen. Bei Rohdaten bildet das Werkzeug zuerst eine Kreuztabelle der beiden Spalten und summiert dabei die Häufigkeitsspalte, falls eine angegeben ist; leere Zellen werden ausgelassen. Eine Zeile oder Spalte mit der Summe null muss entfernt werden. Der p-Wert ist zuverlässig, wenn die erwarteten Häufigkeiten nicht zu klein sind; die geführte Interpretation prüft dies.
Eingabefelder und Optionen
Feld | Beschreibung |
Data | Summarized data in a two-way table (Standard) oder Raw data (categorical variables). |
Columns (one per column-category) | Tabellenlayout: zwei oder mehr numerische Spalten, die jeweils die Häufigkeiten einer Kategorie der Spaltenvariablen enthalten, eine Zeile pro Zeilenkategorie. Erforderlich. |
Row labels | Tabellenlayout, optional: eine Spalte, die jede Zeilenkategorie benennt; leer ergibt Row 1, Row 2, … |
Rows / Columns / Frequencies (optional) | Rohdatenlayout: die beiden kategorialen Spalten und eine optionale Spalte mit der Häufigkeit jedes Datensatzes. |
Statistics | Expected cell counts und Each cell's contribution to chi-square (standardmäßig aktiviert); Raw residuals, Standardized residuals, Adjusted residuals, Row percents, Column percents, Total percents. |
Data Options: Subset (optional) | Exclude matching rows (Standard) oder Include only matching rows, nach Zeilennummern und/oder einer Bedingung. |
Show guided interpretation | Fügt eine leicht verständliche Summary, Diagnostic und Report Card hinzu; Difference between the % defectives with practical value ist dafür eine optionale Eingabe. |
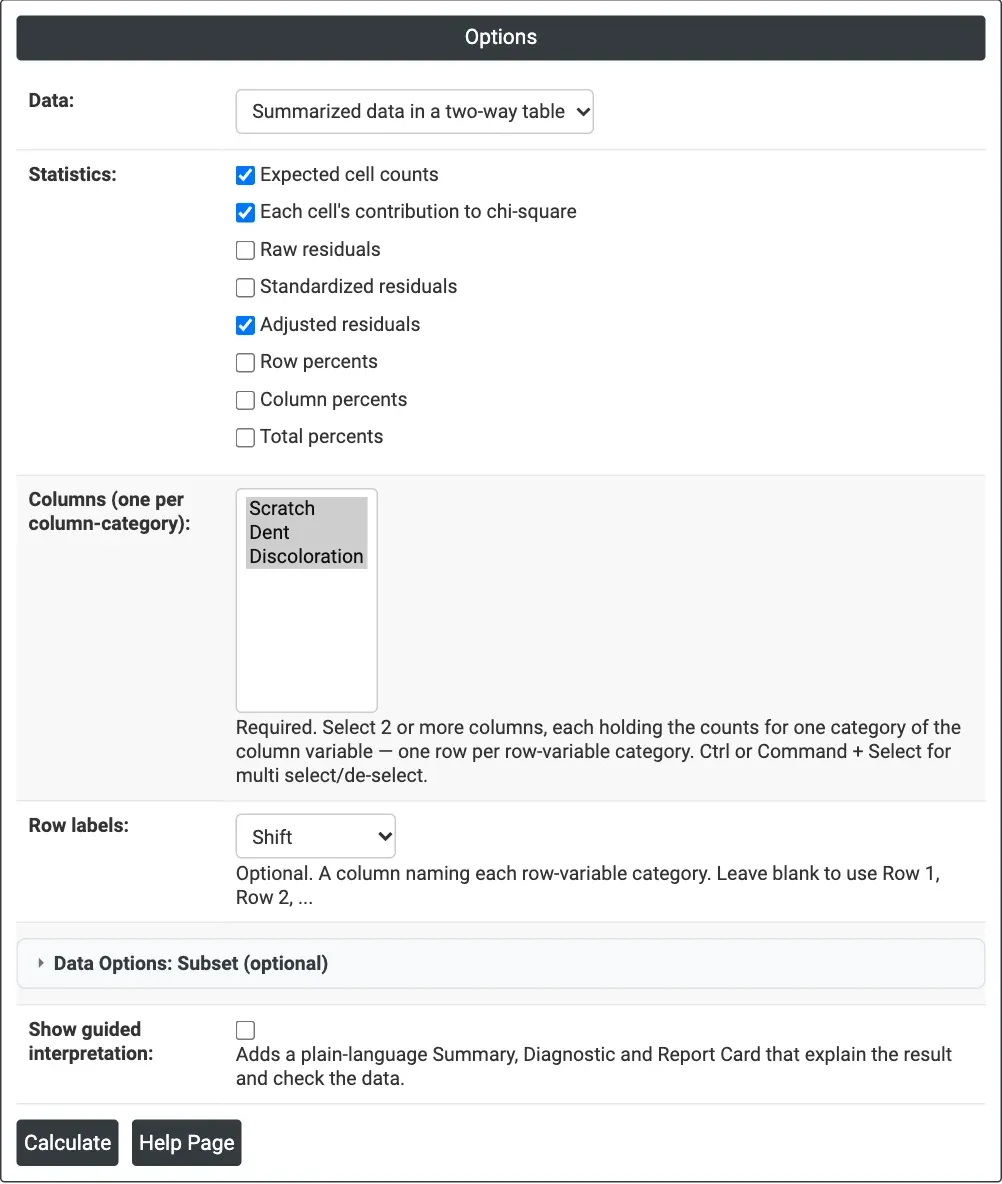
Abbildung 1 — Optionen für das Fehlerarten-Beispiel: eine zusammengefasste Tabelle mit den Häufigkeiten für Scratch, Dent und Discoloration als Spalten und Shift als Zeilenbeschriftungen, Adjusted residuals aktiviert.
Beschreibung der Ausgabe
- Observed Counts — die Tabelle mit Zeilen- und Spaltensummen (All).
- Expected Counts und Contribution to Chi-Square — wenn aktiviert.
- Chi-Square Tests — Chi-Sq, DF und P-Value des Pearson- und des Likelihood-Quotienten-Tests.
- Raw Residuals, Standardized Residuals, Adjusted Residuals, Row Percents, Column Percents und Total Percents — wenn aktiviert.
- Summary Report, Diagnostic Report und Report Card — mit geführter Interpretation.
- PDF-Export über Download.
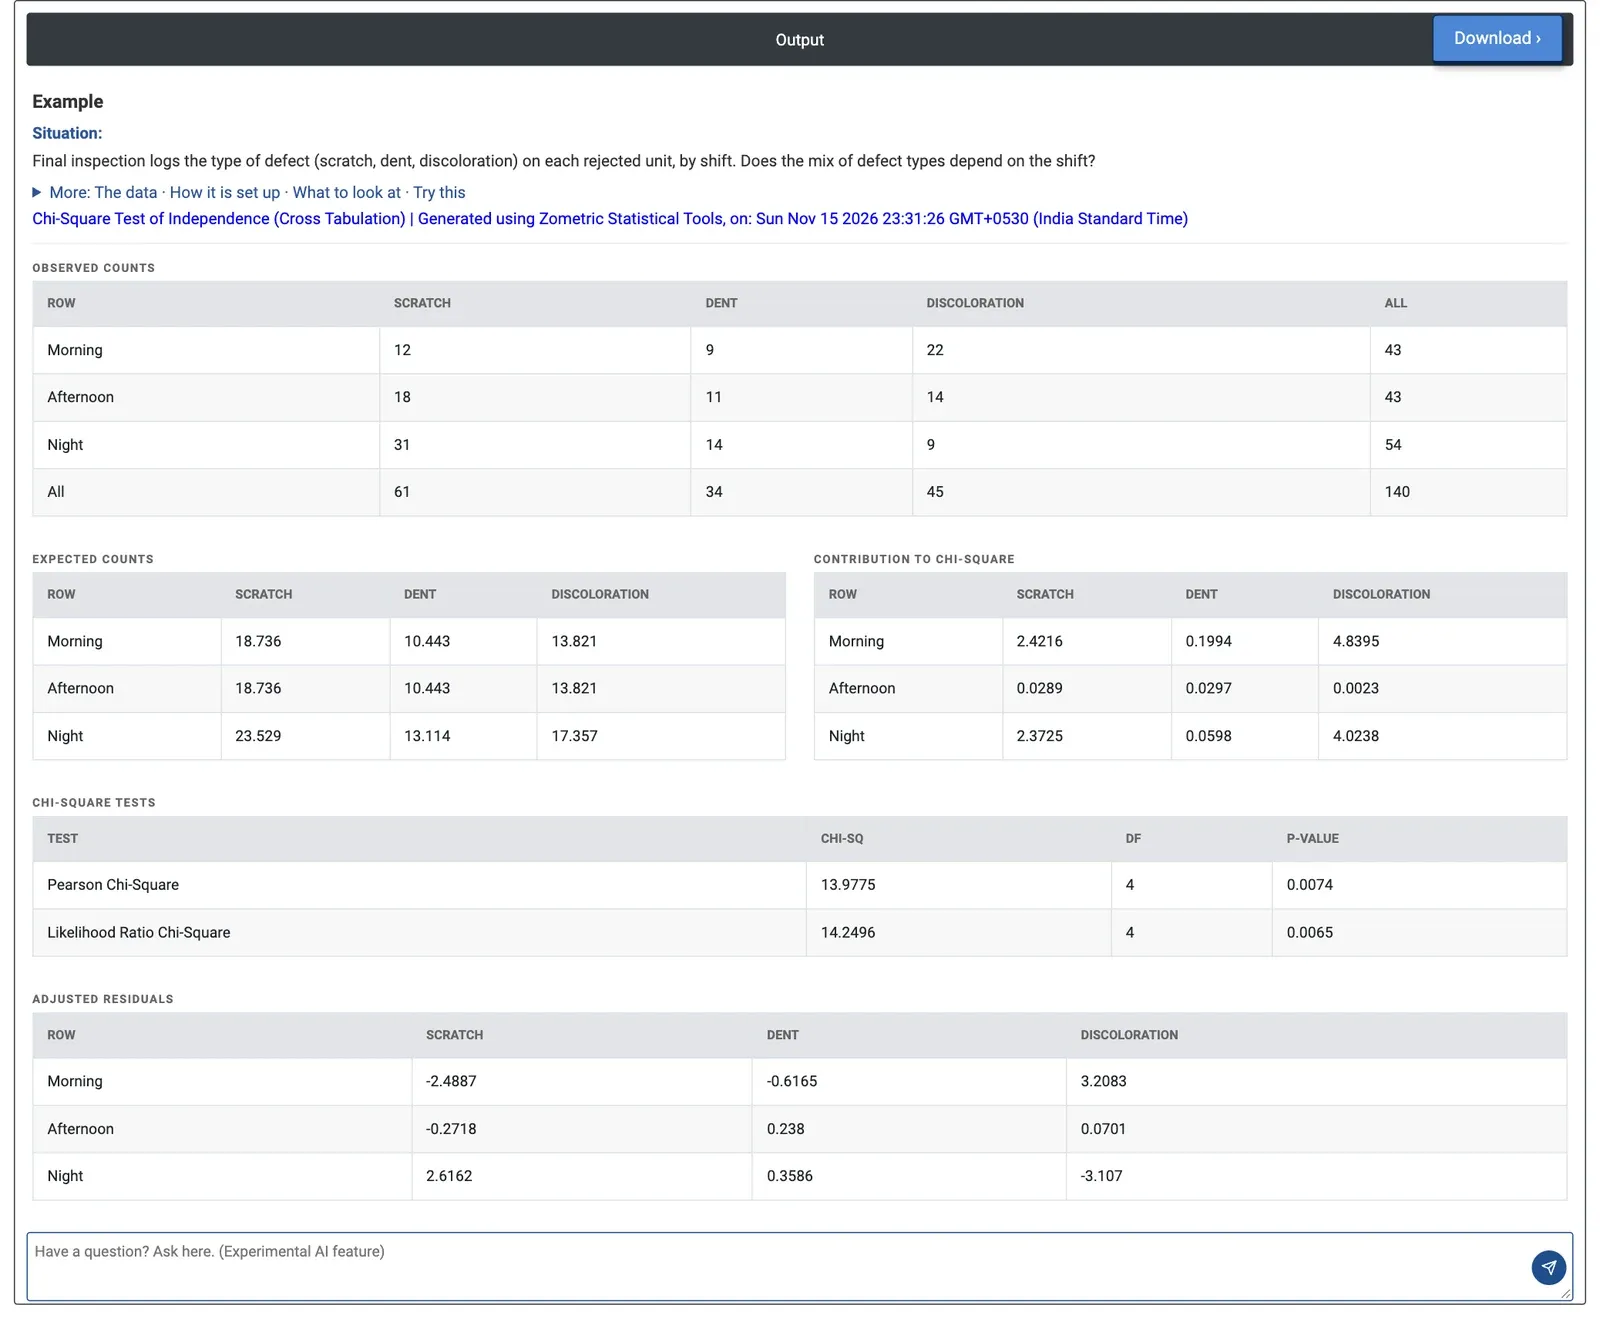
Abbildung 2 — Fehlerart nach Schicht: Pearson-Chi-Quadrat 13.98 mit 4 DF, p = 0.0074; die adjustierten Residuen weisen auf Verfärbungen in der Frühschicht und Kratzer in der Nachtschicht hin.
Beispiel
Bei der Endprüfung wird für jede zurückgewiesene Einheit die Fehlerart nach Schicht erfasst: insgesamt 140 Ausschussteile. Das Qualitätsteam möchte wissen, ob die Verteilung der Fehlerarten von der Schicht abhängt. Es gibt die Häufigkeiten als Tabelle mit einer Spalte pro Fehlerart (Scratch, Dent, Discoloration) und Shift als Zeilenbeschriftungen ein und aktiviert zusätzlich zu den Standardstatistiken Adjusted residuals.
Die Verteilung der Fehlerarten hängt tatsächlich von der Schicht ab: Pearson-Chi-Quadrat 13.98 bei 4 DF, p = 0.0074 (Likelihood-Quotient 14.25, p = 0.0065). Die Beiträge zeigen, wo: Verfärbungen in der Frühschicht (4.84; 22 beobachtet gegenüber 13.8 erwartet) und in der Nachtschicht (4.02; 9 gegenüber 17.4), dann Kratzer in der Frühschicht (2.42; 12 gegenüber 18.7) und in der Nachtschicht (2.37; 31 gegenüber 23.5). Die Spätschicht entspricht der Gesamtverteilung, und Dellen sind gleichmäßig verteilt.
Die adjustierten Residuen bestätigen dies: 3.21 für Verfärbungen in der Frühschicht und 2.62 für Kratzer in der Nachtschicht liegen deutlich über 2. Das Team untersucht bei den Verfärbungen, was sich zu Beginn des Tages ändert (z. B. Aufwärmphase oder eine andere Lackcharge), und bei den Kratzern Handhabung und Beleuchtung in der Nachtschicht. Alle erwarteten Häufigkeiten liegen über 10, sodass dem p-Wert vertraut werden kann.
Häufig gestellte Fragen
Wie wird die erwartete Häufigkeit beim Chi-Quadrat-Unabhängigkeitstest berechnet?
Bei Unabhängigkeit ist die erwartete Häufigkeit einer Zelle ihre Zeilensumme mal ihre Spaltensumme geteilt durch die Gesamtsumme, E = R x C / N. Die Pearson-Statistik summiert (O − E)² / E über alle Zellen und wird mit einer Chi-Quadrat-Verteilung mit (r − 1)(c − 1) Freiheitsgraden verglichen, wobei r und c die Anzahl der Zeilen und Spalten sind.
Wie interpretieren Sie einen Chi-Quadrat-Unabhängigkeitstest?
Ein kleiner p-Wert bedeutet, dass Zeilen- und Spaltenvariable zusammenhängen: Die Verteilung über die Spalten ist nicht in jeder Zeile gleich. Um zu sehen, woher der Zusammenhang kommt, betrachten Sie den Beitrag (O − E)² / E jeder Zelle und die adjustierten Residuen, die annähernd standardnormalverteilt sind; Werte jenseits von etwa ±2 kennzeichnen Zellen, die deutlich von der Unabhängigkeit abweichen.
Welches Datenformat benötigt der Test?
In Zometric Statistical Software können Sie eine zusammengefasste Kreuztabelle mit einer numerischen Spalte pro Spaltenkategorie und einer Zeile pro Zeilenkategorie eingeben oder Rohdaten mit zwei kategorialen Spalten und einer optionalen Häufigkeitsspalte. Bei Rohdaten bildet das Werkzeug zuerst eine Kreuztabelle der beiden Spalten. Eine Zeile oder Spalte mit der Summe null muss entfernt werden.
Wann ist der p-Wert des Chi-Quadrat-Tests zuverlässig?
Der p-Wert ist zuverlässig, wenn die erwarteten Häufigkeiten nicht zu klein sind; die optionale geführte Interpretation prüft dies. Im Beispiel zur Fehlerart nach Schicht lagen alle erwarteten Häufigkeiten über 10, sodass dem Pearson-p-Wert von 0.0074 bei 4 Freiheitsgraden vertraut werden konnte.