
K-Means-Clusteranalyse (Cluster K-Means)
Cluster K-Means gruppiert Beobachtungen anhand von zwei oder mehr numerischen Variablen in K von Ihnen festgelegte Cluster, mit dem Lloyd-Verfahren, k-means++-Startzentren und mehreren Zufallsstarts. Standardisieren Sie Variablen mit unterschiedlichen Einheiten. Nutzen Sie es, wenn Sie eine bekannte Anzahl von Gruppen erwarten. Ausgabe: endgültige Partition, Clusterzentroide, Cluster und Abstand jeder Beobachtung sowie der erklärte Anteil der Streuung in Prozent.
Zuletzt geprüft
Kernaussage
Cluster K-Means teilt Beobachtungen in eine feste Anzahl von Gruppen (K) auf, sodass sich die Beobachtungen jeder Gruppe in den gewählten Variablen möglichst ähneln, etwa um Chargen, Teile oder Lieferanten in Typen einzuteilen.
Auf dieser Seite
Zweck
Cluster K-Means teilt Beobachtungen in eine feste Anzahl von Gruppen (K) auf, sodass sich die Beobachtungen jeder Gruppe in den von Ihnen gewählten Variablen möglichst ähneln. Verwenden Sie das Verfahren, wenn Sie eine bekannte Anzahl von Gruppen erwarten, zum Beispiel um Materialchargen, Teile oder Lieferanten anhand mehrerer gemessener Eigenschaften in Typen einzuteilen, oder um zu prüfen, ob sich eine bereits verwendete Kennzeichnung (Güteklasse, Linie, Schicht) überhaupt in den Messwerten zeigt.
Wichtige Funktionen
- Gruppiert Beobachtungen anhand von zwei oder mehr numerischen Variablen in K von Ihnen festgelegte Cluster.
- Optionale Standardisierung, damit eine in großen Einheiten gemessene Variable die Gruppierung nicht dominiert.
- Mehrere zufällige Startpunkte; die beste Lösung (kleinste Streuung innerhalb der Cluster) wird beibehalten, und dieselben Daten liefern immer dasselbe Ergebnis.
- Gibt die endgültige Partition aus (Größe, Quadratsumme innerhalb der Cluster, mittlerer und maximaler Abstand vom Zentroid), den Zentroid jedes Clusters in den ursprünglichen Einheiten, den Cluster jeder Beobachtung und den Prozentsatz der Gesamtstreuung, der durch die Cluster erklärt wird.
- Streudiagramm der ersten beiden ausgewählten Variablen, nach Cluster eingefärbt.
Statistische Methoden
Zeilen mit einem fehlenden oder nicht numerischen Wert in einer der ausgewählten Variablen werden verworfen. Ist Standardize variables aktiviert, wird jede Variable mit der Stichprobenstandardabweichung s in z = (x − mean) / s umgerechnet, sodass jede Variable vor der Clusterbildung den Mittelwert 0 und die Standardabweichung 1 hat.
Der K-Means-Algorithmus (Lloyd-Verfahren) ordnet jede Beobachtung nach euklidischem Abstand dem nächstgelegenen Clusterzentrum zu, berechnet jedes Zentrum als Mittelwert seiner Mitglieder neu und wiederholt dies, bis sich die Zuordnungen nicht mehr ändern. Die Startzentren werden nach der k-means++-Regel gewählt. Da das Ergebnis vom Start abhängen kann, wird der Algorithmus so oft ausgeführt, wie unter Number of random starts angegeben, und der Lauf mit der kleinsten Quadratsumme innerhalb der Cluster wird beibehalten. Es wird ein fester Zufallsstartwert (Seed) verwendet, sodass sich die Ergebnisse exakt wiederholen.
Der Prozentsatz der durch die Cluster erklärten Streuung ist (total SS − within-cluster SS) / total SS × 100. Dabei ist total SS die Summe der quadrierten Abstände aller Beobachtungen vom Gesamtmittelwert und within-cluster SS die Summe der quadrierten Abstände jeder Beobachtung vom Zentrum ihres eigenen Clusters. Beide werden an den Daten in der Form gemessen, in der sie geclustert wurden (standardisiert, wenn diese Option aktiviert ist). Ein höherer Wert bedeutet deutlicher getrennte, kompaktere Gruppen; er steigt jedoch mit wachsendem K immer an, vergleichen Sie ihn daher über verschiedene K mit Vorsicht. Die Zentroide werden für die Ausgabe in die ursprünglichen Einheiten zurückgerechnet. Die endgültige Partition gibt für jeden Cluster die Anzahl der Beobachtungen, die Quadratsumme innerhalb des Clusters sowie den mittleren und maximalen Abstand seiner Mitglieder vom Zentroid an; diese Abstände und der Abstand jeder Beobachtung in der Zugehörigkeitstabelle sind euklidische Abstände in den geclusterten Einheiten (standardisiert, wenn diese Option aktiviert ist), wie in Minitab.
Eingabefelder und Optionen
Feld | Beschreibung |
Variables | Zwei oder mehr numerische Spalten, nach denen geclustert wird. Mit Strg- bzw. Befehlstaste + Klick wählen Sie mehrere aus. |
Number of clusters (K) | Wie viele Gruppen gebildet werden. Standard 3; Minimum 2. Sie benötigen mindestens K vollständige Beobachtungen. |
Standardize variables | Standardmäßig aktiviert. Bringt vor der Clusterbildung alle Variablen auf dieselbe Skala (Mittelwert 0, Standardabweichung 1). Deaktivieren Sie die Option nur, wenn alle Variablen dieselben Einheiten haben und Variablen mit größerer Streuung stärker gewichtet werden sollen. |
Number of random starts | Wie viele Startpunkte ausprobiert werden; das beste Ergebnis wird beibehalten. Standard 10, 1 bis 100. |
Title | Titel, der im Diagramm und in der Ausgabe angezeigt wird. Standard Cluster K-Means. |
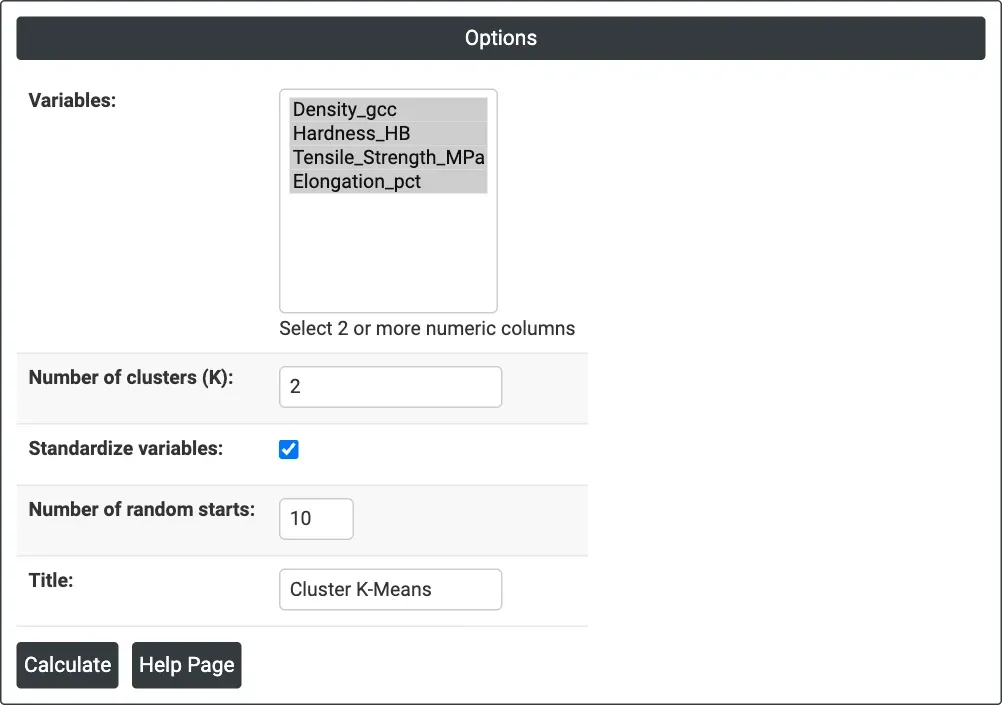
Abbildung 1 — Optionen für das Beispiel: die vier Eigenschaftsspalten, K = 2, standardisiert, 10 Zufallsstarts.
Beschreibung der Ausgaben
- Cluster K-Means plot — Streudiagramm der ersten ausgewählten Variablen (x) gegen die zweite (y), jeder Punkt nach seinem Cluster eingefärbt.
- % variation explained by clusters — der Anteil der Gesamtstreuung, der zwischen den Clustern statt innerhalb der Cluster liegt.
- Final Partition — für jeden Cluster: Number of observations, Within cluster sum of squares, Average distance from centroid und Maximum distance from centroid.
- Cluster Centroids — für jeden Cluster die Anzahl N seiner Beobachtungen und der Mittelwert jeder Variablen in den ursprünglichen Einheiten.
- Cluster Membership — jede Beobachtung (nach Zeile im Arbeitsblatt), ihr Cluster und ihr Abstand vom Zentroid dieses Clusters.
- PDF-Export über Download.
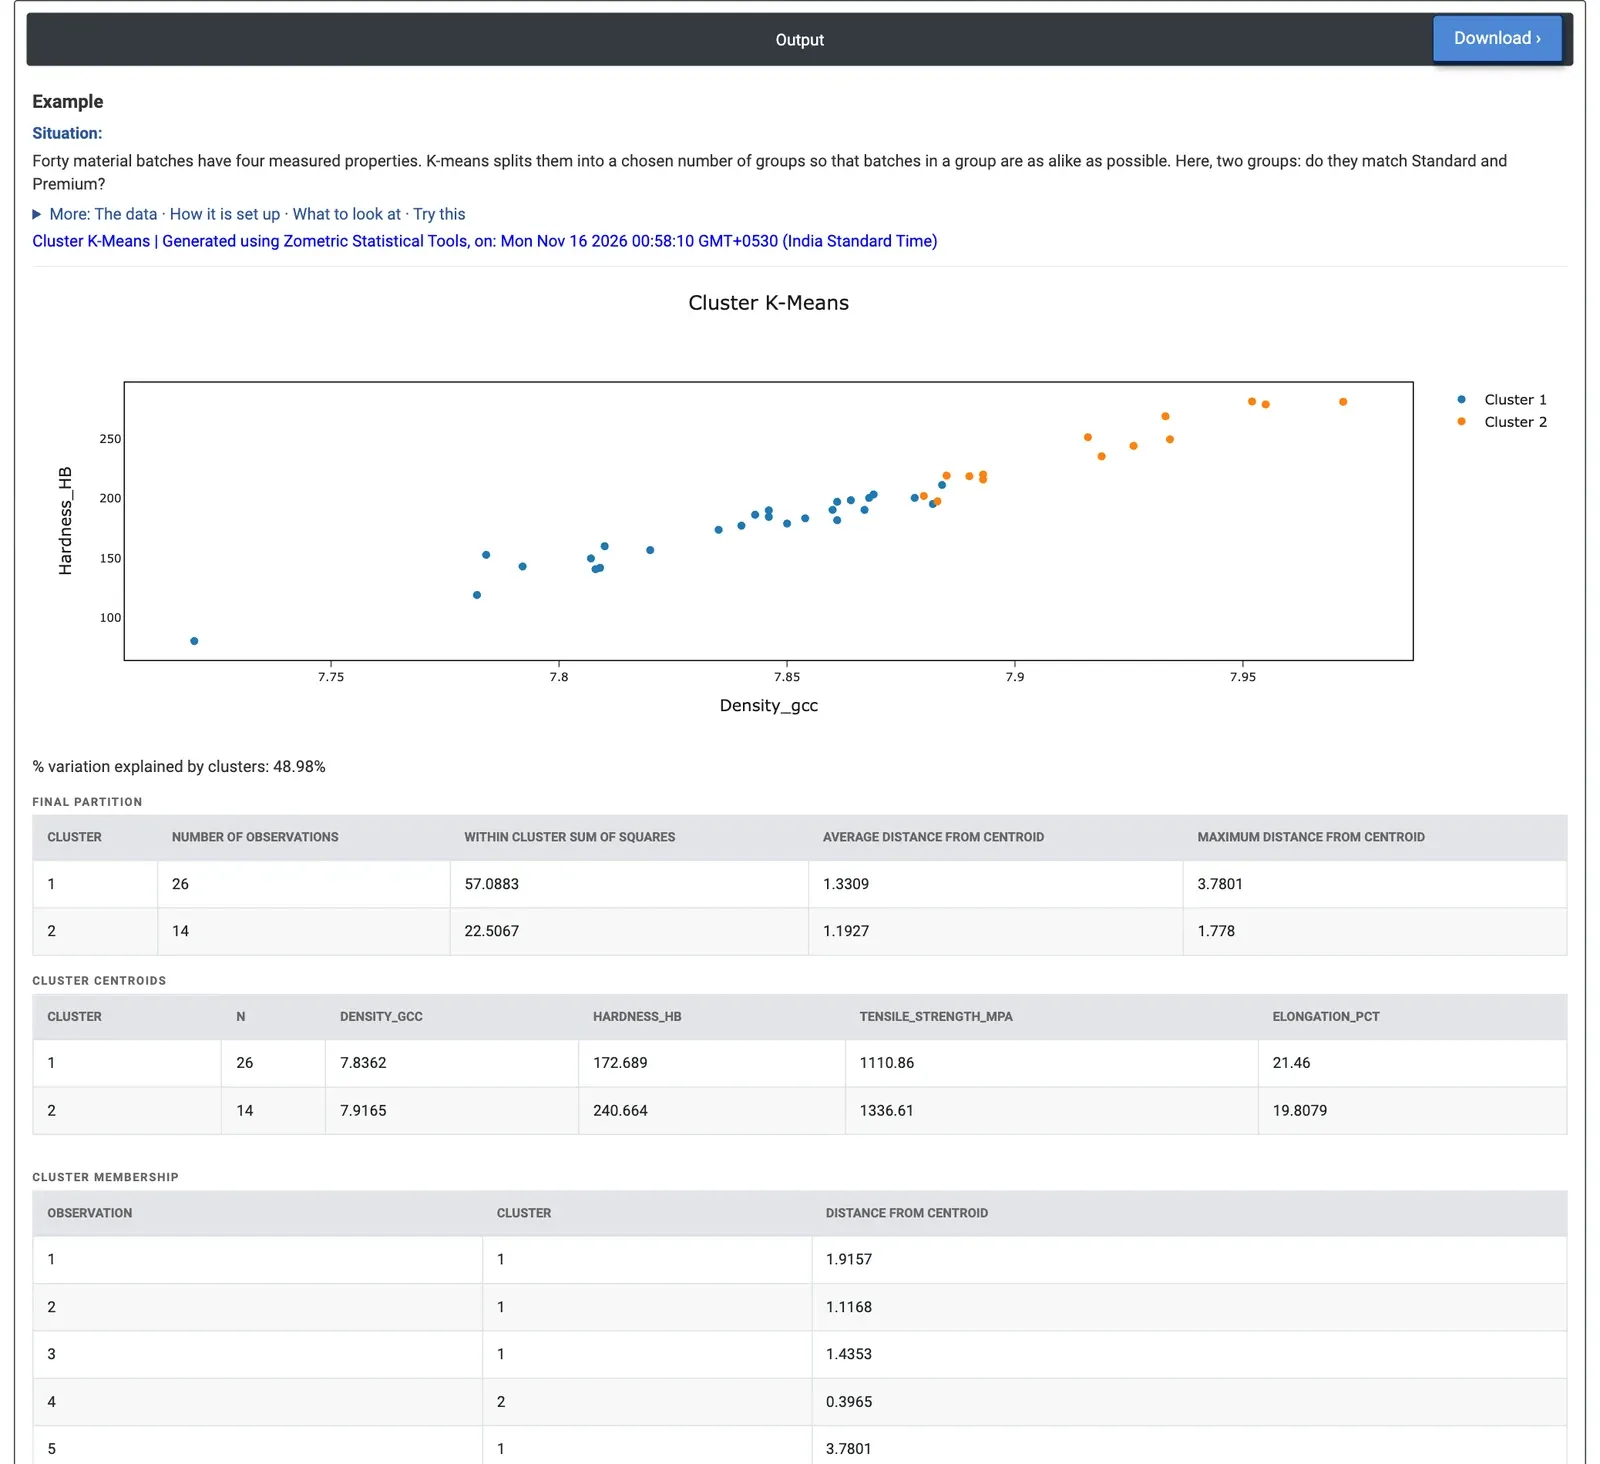
Abbildung 2 — Zwei Cluster aus 40 Materialchargen: Cluster 2 (14 Chargen) ist härter und fester; die Cluster erklären 48.98 % der Streuung. Auf das Diagramm folgen die endgültige Partition, die Zentroide und der Anfang der Zugehörigkeitstabelle.
Beispiel
Ein Werkstofflabor hat 40 Chargen, an denen jeweils Dichte (g/cc), Härte (HB), Zugfestigkeit (MPa) und Bruchdehnung (%) gemessen wurden. Die Chargen werden als Standard oder Premium verkauft, je 20. Das Labor möchte wissen, ob die Messwerte allein in zwei natürliche Gruppen zerfallen und ob diese Gruppen dem Chargentyp entsprechen. Es wählt die vier Eigenschaftsspalten aus, setzt Number of clusters (K) = 2, lässt Standardize variables aktiviert (die Zugfestigkeit im Hunderterbereich würde sonst dominieren) und behält 10 Zufallsstarts bei.
Die Cluster erklären 48.98 % der Streuung. Cluster 2 umfasst 14 Chargen, die härter und fester (Mittelwerte 240.7 HB und 1,336.6 MPa) und etwas weniger duktil (19.8 % Bruchdehnung) sind; Cluster 1 umfasst 26 Chargen mit Mittelwerten von 172.7 HB, 1,110.9 MPa und 21.5 % Bruchdehnung. Die Dichte-Zentroide unterscheiden sich nur wenig (7.92 gegenüber 7.84 g/cc). In der endgültigen Partition ist Cluster 2 die kompaktere Gruppe (mittlerer Abstand vom Zentroid 1.19 gegenüber 1.33 standardisierten Einheiten); das am weitesten entfernte Mitglied von Cluster 1, Zeile 5, liegt 3.78 Einheiten von seinem Zentroid entfernt, eine ungewöhnliche Charge, die eine Prüfung wert ist. Im Vergleich mit der Spalte für den Chargentyp enthält Cluster 2 11 Premium- und 3 Standard-Chargen und Cluster 1 17 Standard- und 9 Premium-Chargen, sodass 28 von 40 Chargen in dem Cluster liegen, der ihrem Typ entspricht.
Für das Labor bedeutet das: Die festesten Chargen bilden eine klare Gruppe, viele Premium-Chargen sind jedoch nicht härter oder fester als Standard-Chargen; die Kennzeichnung wird durch die Eigenschaften nicht vollständig gestützt. Mit K = 3 steigt die erklärte Streuung auf 69.66 %, und eine weiche, wenig feste Gruppe von 9 Chargen (138.2 HB, 995.9 MPa) trennt sich von einer mittleren Gruppe mit 23 und einer Spitzengruppe mit 8 Chargen. Wird Standardize variables deaktiviert, ändert sich die Aufteilung auf 19 und 21 Chargen, weil dann die Zugfestigkeit das größte Gewicht trägt. Um eine Regel zu erstellen, die die bekannten Typen nutzt, führen Sie mit denselben Daten eine Diskriminanzanalyse (Discriminant Analysis) durch.
Häufig gestellte Fragen
Wann sollte man die K-Means-Clusteranalyse einsetzen?
Setzen Sie sie ein, wenn Sie eine bekannte Anzahl von Gruppen erwarten und Beobachtungen wie Materialchargen, Teile oder Lieferanten anhand mehrerer gemessener Eigenschaften in Typen einteilen möchten. Sie eignet sich auch, um zu prüfen, ob sich eine bereits verwendete Kennzeichnung wie Güteklasse, Linie oder Schicht tatsächlich in den Messwerten zeigt.
Sollte man die Variablen vor K-Means standardisieren?
Die Standardisierung rechnet jede Variable auf Mittelwert 0 und Standardabweichung 1 um, damit eine in großen Einheiten gemessene Variable die Gruppierung nicht dominiert. Sie ist standardmäßig aktiviert. Deaktivieren Sie sie nur, wenn alle Variablen dieselben Einheiten haben und Variablen mit größerer Streuung stärker gewichtet werden sollen; im Beispiel änderte das Deaktivieren die Aufteilung, weil dann die Zugfestigkeit das größte Gewicht trug.
Wie wählt man die Anzahl der Cluster K?
Die Ausgabe gibt den Prozentsatz der Gesamtstreuung an, der durch die Cluster erklärt wird; ein höherer Wert bedeutet deutlicher getrennte, kompaktere Gruppen. Er steigt mit wachsendem K immer an, vergleichen Sie ihn daher über verschiedene K mit Vorsicht. Im Beispiel erklärten zwei Cluster 48.98 % und drei Cluster 69.66 % der Streuung, wobei sich eine weiche, wenig feste Gruppe von 9 Chargen abtrennte.
Was ist der Unterschied zwischen K-Means und Diskriminanzanalyse?
K-Means findet Gruppen allein aus den Messwerten, ohne bekannte Kennzeichnungen zu nutzen. Im Beispiel stimmten die beiden Cluster nur bei 28 von 40 Chargen mit der Kennzeichnung Standard oder Premium überein. Um eine Regel zu erstellen, die die Gruppen anhand der bekannten Typen trennt, führen Sie mit denselben Daten eine Diskriminanzanalyse (Discriminant Analysis) durch.