
Clusteranalyse von Beobachtungen (Cluster Observations)
Cluster Observations fasst die ähnlichsten Beobachtungen anhand von zwei oder mehr numerischen Variablen schrittweise zusammen und stellt das Ergebnis als Dendrogramm dar. Wählen Sie eines von sieben Fusionierungsverfahren und eines von fünf Distanzmaßen und standardisieren Sie Variablen in unterschiedlichen Einheiten. Ward, Centroid und Median erfordern die euklidische oder quadrierte euklidische Distanz. Die Eingabe einer Clusteranzahl schneidet den Baum und kennzeichnet jede Beobachtung.
Zuletzt geprüft
Kernaussage
Cluster Observations ist eine hierarchische Clusteranalyse, die über mehrere numerische Variablen ähnliche Zeilen gruppiert, ohne die Gruppenzahl vorab zu kennen, und ein Dendrogramm natürlicher Gruppen und Ausreißer zeichnet.
Auf dieser Seite
Zweck
Cluster Observations gruppiert Beobachtungen (Zeilen), die sich über mehrere numerische Variablen hinweg ähneln, ohne dass die Anzahl der Gruppen vorab bekannt sein muss. Das Verfahren fasst die ähnlichsten Beobachtungen schrittweise zusammen und stellt das Ergebnis als Dendrogramm (Baum) dar, sodass Sie sehen, wie viele natürliche Gruppen es gibt und welche Beobachtungen zusammengehören. Verwenden Sie es, um natürliche Familien von Chargen, Teilen, Lieferanten oder Produktionsläufen zu finden oder eine Beobachtung zu erkennen, die in keine Gruppe passt.
Wichtige Funktionen
- Hierarchische (agglomerative) Clusteranalyse von Beobachtungen anhand von zwei oder mehr numerischen Variablen.
- Sieben Fusionierungsverfahren: Single, Complete, Average, Centroid, Median, McQuitty und Ward.
- Fünf Distanzmaße: Euclidean, Squared Euclidean, Manhattan (City Block), Cosine und Correlation.
- Optionale Standardisierung, damit Variablen in unterschiedlichen Einheiten gleich gewichtet werden.
- Dendrogramm der gesamten Fusionsfolge und, wenn Sie eine Clusteranzahl angeben, optional eine Clusterzuordnung für jede Beobachtung.
Statistische Methoden
Zeilen mit fehlendem oder nicht numerischem Wert in einer der ausgewählten Variablen werden entfernt; mindestens 3 Beobachtungen sind nötig. Ist Standardize variables aktiviert, wird jede Variable mit der Stichproben-Standardabweichung s in z = (x − mean) / s umgerechnet. Anschließend wird die Distanz zwischen jedem Beobachtungspaar mit dem gewählten Maß berechnet: Euclidean √Σ(xᵢ − yᵢ)², Squared Euclidean Σ(xᵢ − yᵢ)², Manhattan Σ|xᵢ − yᵢ|, Cosine 1 − cos(Winkel zwischen den beiden Zeilen) oder Correlation 1 − r zwischen den beiden Zeilen.
Die Clusteranalyse beginnt mit jeder Beobachtung als eigenem Cluster und fusioniert wiederholt die beiden nächstgelegenen Cluster, bis nur noch einer übrig ist. Das Fusionierungsverfahren legt fest, wie die Distanz zwischen zwei Clustern gemessen wird: Single verwendet das nächstgelegene Paar von Elementen, Complete das am weitesten entfernte Paar, Average den Mittelwert aller paarweisen Distanzen, McQuitty einen gewichteten Mittelwert, Centroid die Distanz zwischen den Clusterzentren, Median die Distanz zwischen den ungewichteten Zentren, und Ward fusioniert das Clusterpaar, das den geringsten Anstieg der Quadratsumme innerhalb der Cluster ergibt. Ward, Centroid und Median erfordern eine euklidische oder quadrierte euklidische Distanz; andere Kombinationen lehnt das Werkzeug ab.
Die Höhe, in der sich zwei Äste im Dendrogramm vereinigen, ist ihre Distanz zum Zeitpunkt der Fusion; lange senkrechte Äste kennzeichnen daher gut getrennte Gruppen. Wird Number of clusters eingegeben, wird der Baum auf der Ebene geschnitten, die diese Anzahl an Clustern ergibt, und jede Beobachtung erhält ihre Clusternummer.
Eingabefelder und Optionen
Feld | Beschreibung |
Variables | Zwei oder mehr numerische Spalten, die jede Beobachtung beschreiben. Strg bzw. Befehlstaste + Klick, um mehrere auszuwählen. |
Linkage method | Wie die Distanz zwischen Clustern gemessen wird: Single, Complete, Average (Standard), Centroid, Median, McQuitty oder Ward. |
Distance measure | Wie die Distanz zwischen zwei Beobachtungen gemessen wird: Euclidean (Standard), Squared Euclidean, Manhattan (City Block), Cosine oder Correlation. |
Standardize variables | Standardmäßig aktiviert. Skaliert zunächst jede Variable auf Mittelwert 0 und Standardabweichung 1, damit eine Variable in großen Einheiten nicht dominiert. |
Number of clusters | Optional, 2 oder mehr. Schneidet den Baum in diese Anzahl an Clustern und fügt die Tabelle Cluster Assignments hinzu. Leer lassen, um nur das Dendrogramm anzuzeigen. |
Title | Titel, der auf dem Dendrogramm angezeigt wird. Standard: Cluster Observations. |
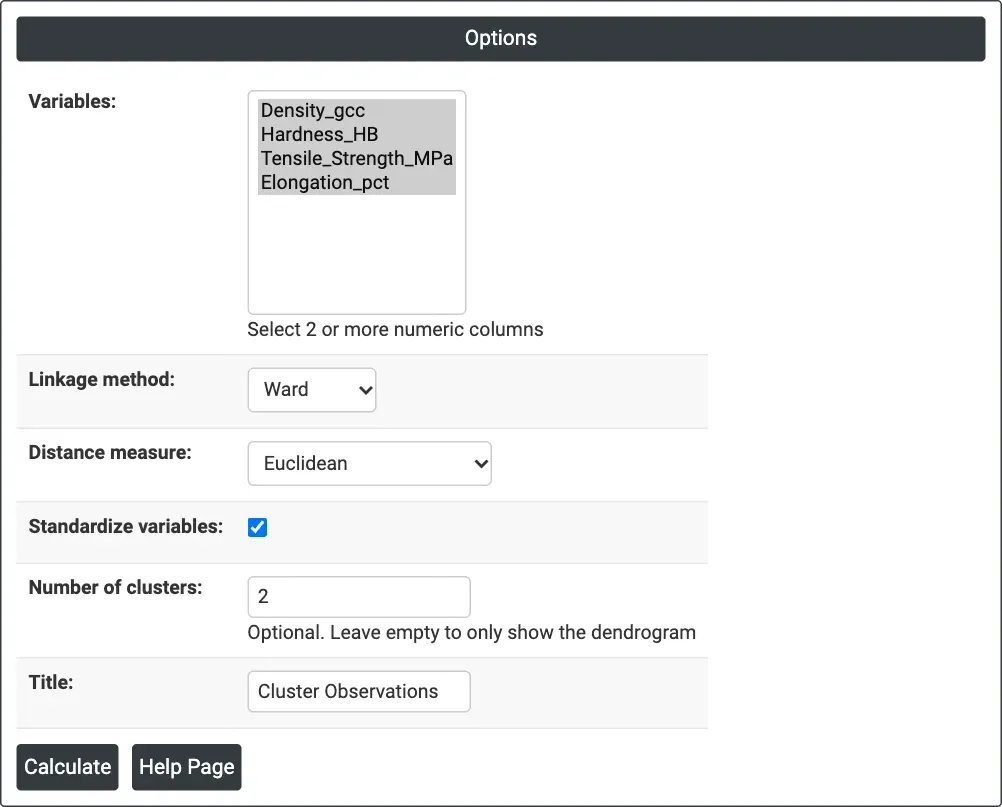
Abbildung 1 – Optionen für das Beispiel: vier Spalten mit Werkstoffeigenschaften, Fusionierung nach Ward, euklidische Distanz, standardisiert, 2 Cluster.
Beschreibung der Ausgabe
- Dendrogram – die Fusionsfolge. Die Beobachtungen (Zeilennummern) liegen in Baumreihenfolge entlang der x-Achse; die y-Achse (Distance) zeigt die Ebene, auf der sich die Äste vereinigen.
- Cluster Assignments – wird angezeigt, wenn Number of clusters eingegeben ist: Zeilennummer und Clusternummer jeder Beobachtung.
- PDF-Export über Download.
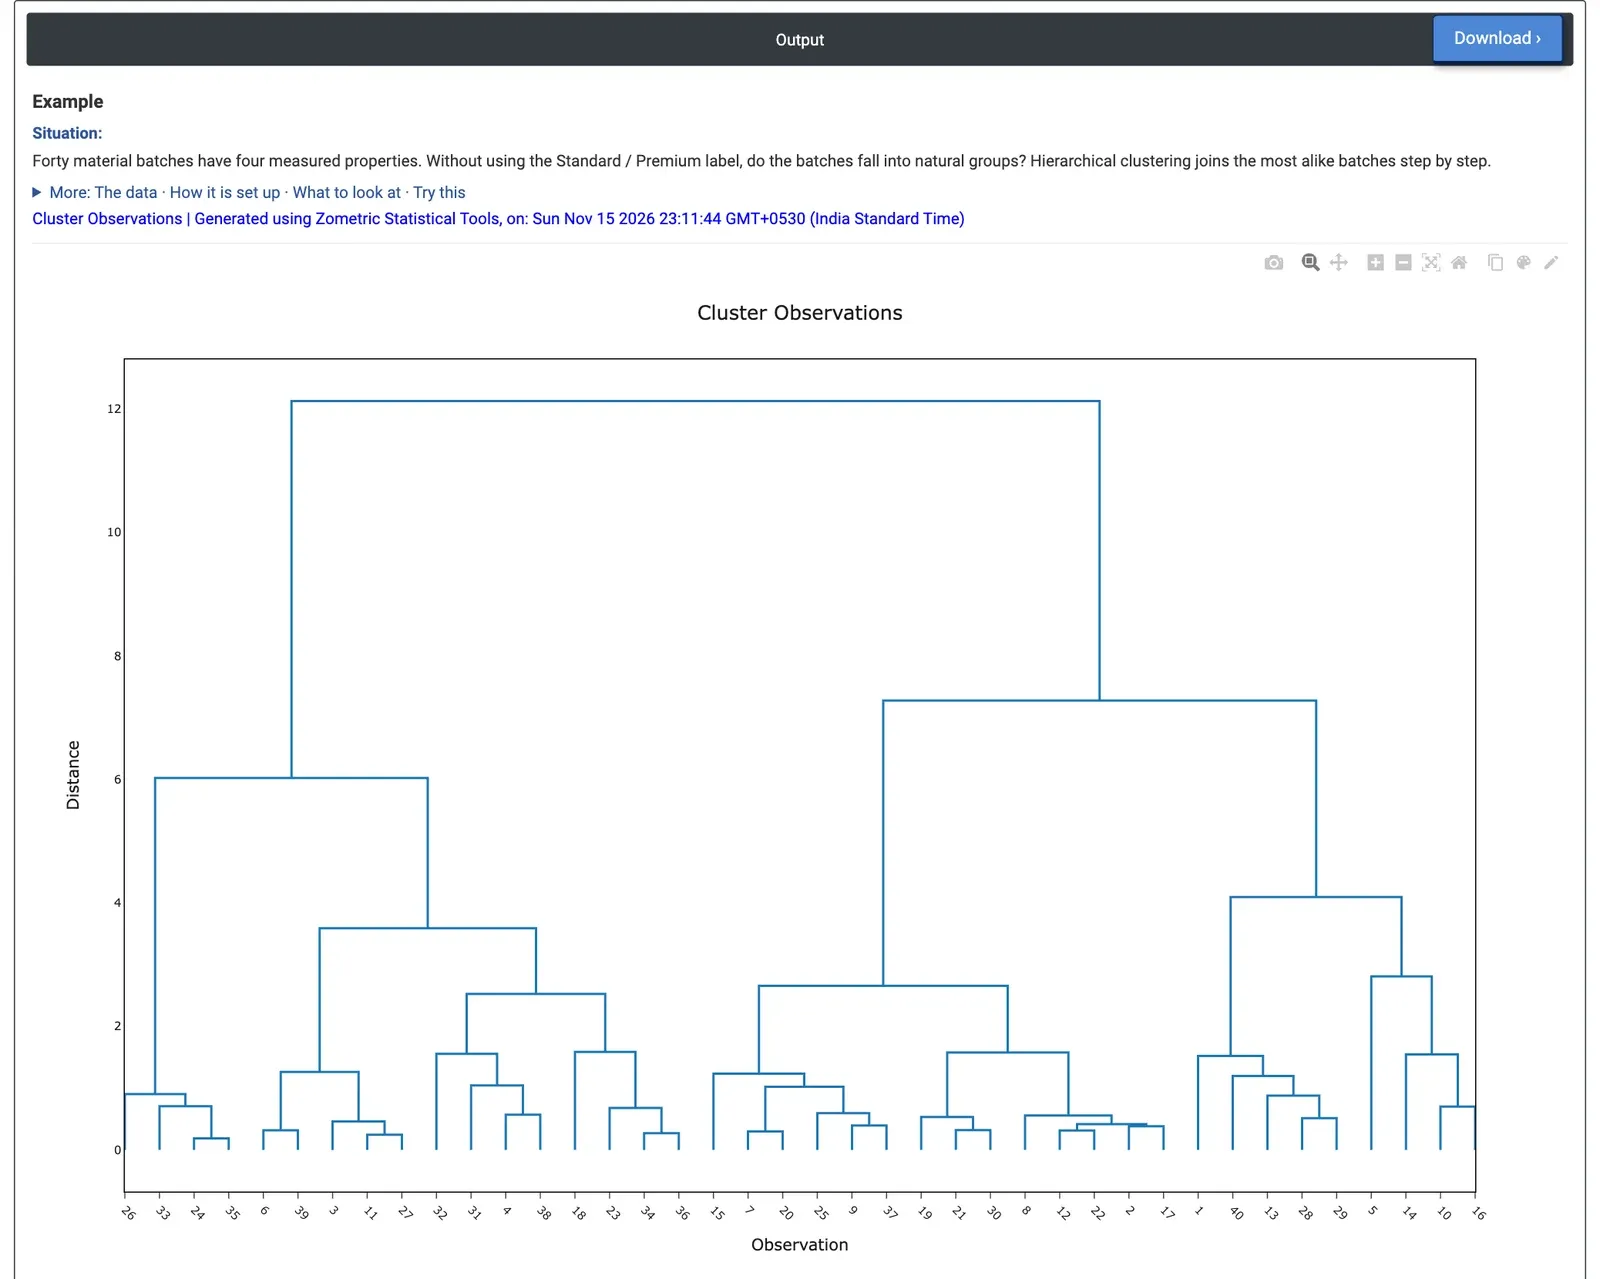
Abbildung 2 – Dendrogramm von 40 Materialchargen mit Fusionierung nach Ward: Zwei Hauptäste vereinigen sich bei einer Distanz von etwa 12.1.
Beispiel
Ein Werkstofflabor hat an 40 Chargen Dichte (g/cc), Härte (HB), Zugfestigkeit (MPa) und Bruchdehnung (%) gemessen. Ohne die Kennzeichnung Standard oder Premium zu verwenden, möchte das Labor wissen, ob die Chargen in natürliche Gruppen zerfallen. Es wählt die vier Eigenschaftsspalten, Linkage method = Ward und Distance measure = Euclidean, lässt Standardize variables aktiviert (Dichte in g/cc und Festigkeit in MPa wären sonst nicht vergleichbar) und gibt Number of clusters = 2 ein.
Das Dendrogramm zeigt zwei Hauptäste, die sich bei einer Distanz von 12.1 vereinigen, deutlich über den nächsten Fusionen (7.3 und 6.0); zwei Gruppen sind also ein natürlicher Schnitt. Cluster 1 umfasst 17 härtere und festere Chargen (Mittelwerte 231.6 HB und 1,308 MPa, 19.8% Bruchdehnung); Cluster 2 umfasst 23 weichere und duktilere Chargen (170.5 HB, 1,103 MPa, 21.7% Bruchdehnung). Im Vergleich mit dem Chargentyp enthält Cluster 1 12 Premium- und 5 Standard-Chargen und Cluster 2 15 Standard- und 8 Premium-Chargen: Die Cluster folgen dem Typ nur bei 27 von 40 Chargen.
Für das Labor bedeutet das: Die Eigenschaften der beiden Typen überschneiden sich stark, und ein beträchtlicher Teil der Standard-Chargen ist so fest wie Premium-Chargen. Die Wahl des Fusionierungsverfahrens ist wichtig: Mit Average-Linkage trennt der Schnitt in zwei Cluster eine einzelne Charge ab (Zeile 5, 80.1 HB und 822.6 MPa, deutlich weicher als die übrigen) und fasst die anderen 39 zusammen – ein nützlicher Weg, einen Ausreißer statt Gruppen zu finden. Ein Schnitt des Ward-Baums bei 3 Clustern trennt eine weiche Gruppe von 9 Chargen ab (138.2 HB, 995.9 MPa).
Häufig gestellte Fragen
Was ist eine hierarchische Clusteranalyse von Beobachtungen?
Sie beginnt mit jeder Beobachtung als eigenem Cluster und fusioniert wiederholt die beiden nächstgelegenen Cluster, bis nur noch einer übrig ist. Das Ergebnis wird als Dendrogramm dargestellt, sodass Sie sehen, wie viele natürliche Gruppen es gibt und welche Beobachtungen zusammengehören, ohne die Anzahl der Gruppen vorab zu kennen. Sie kann auch eine Beobachtung aufdecken, die in keine Gruppe passt.
Wie liest man ein Dendrogramm?
Die Beobachtungen liegen in Baumreihenfolge entlang der x-Achse, und die y-Achse zeigt die Distanz, bei der sich die Äste vereinigen. Lange senkrechte Äste kennzeichnen gut getrennte Gruppen. Im Beispiel vereinigten sich zwei Hauptäste bei einer Distanz von 12.1, deutlich über den nächsten Fusionen bei 7.3 und 6.0, sodass zwei Gruppen ein natürlicher Schnitt waren.
Welches Fusionierungsverfahren sollten Sie verwenden?
Das Werkzeug bietet Single, Complete, Average, Centroid, Median, McQuitty und Ward. Ward fusioniert das Clusterpaar mit dem geringsten Anstieg der Quadratsumme innerhalb der Cluster und erfordert wie Centroid und Median eine euklidische oder quadrierte euklidische Distanz. Die Wahl ist wichtig: Im Beispiel trennte Average-Linkage eine einzelne abweichende Charge ab, während Ward zwei Gruppen fand.
Sollten Sie Variablen vor der Clusteranalyse von Beobachtungen standardisieren?
Standardize variables ist standardmäßig aktiviert und skaliert zunächst jede Variable auf Mittelwert 0 und Standardabweichung 1, damit eine Variable in großen Einheiten nicht dominiert. Im Beispiel wären Dichte in g/cc und Festigkeit in MPa sonst nicht vergleichbar gewesen. Zeilen mit fehlendem oder nicht numerischem Wert werden entfernt, und mindestens 3 Beobachtungen sind nötig.