
Clusteranalyse von Variablen (Cluster Variables)
Cluster Variables wendet hierarchisches Clustern auf drei oder mehr numerische Variablen an, mit Korrelation, absoluter Korrelation oder euklidischer Distanz und einem von sieben Linkage-Verfahren. Variablen, die sich gemeinsam bewegen, werden zuerst verbunden; das Ergebnis zeigt ein Dendrogramm. Einsatz, um eine lange Liste von Messgrößen oder Umfrage-Items zu kürzen. Mindestens 3 vollständige Zeilen sind nötig. Mit einer Clusteranzahl wird jede Variable einem Cluster zugeordnet.
Zuletzt geprüft
Kernaussage
Cluster Variables gruppiert Variablen (Spalten) mit ähnlicher Information, indem gemeinsam steigende und fallende Variablen verbunden werden; so lässt sich eine lange Liste von Messgrößen oder Umfrage-Items auf eine je Cluster kürzen.
Auf dieser Seite
Zweck
Cluster Variables gruppiert Variablen (Spalten) mit ähnlichem Informationsgehalt. Variablen, die über die Beobachtungen hinweg gemeinsam steigen und fallen, werden zuerst verbunden, und das Ergebnis wird als Dendrogramm dargestellt. Setzen Sie das Verfahren ein, um eine lange Liste von Messgrößen oder Umfrage-Items zu kürzen: Wenn mehrere Variablen im selben Cluster liegen, können Sie eine davon oder einen kombinierten Wert verfolgen statt aller.
Wichtige Funktionen
- Hierarchisches Clustern von drei oder mehr numerischen Variablen.
- Distanz auf Basis von Korrelation, absoluter Korrelation oder euklidischer Distanz.
- Sieben Linkage-Verfahren: Single, Complete, Average, Centroid, Median, McQuitty und Ward.
- Dendrogramm, das Reihenfolge und Niveau der Verbindung der Variablen zeigt.
- Optionale Clusterzuordnung für jede Variable, wenn Sie eine Clusteranzahl angeben.
Statistische Methoden
Zeilen mit einem fehlenden oder nicht numerischen Wert in einer der ausgewählten Variablen werden verworfen; mindestens 3 Variablen und 3 vollständige Zeilen sind nötig. Jede Variable wird als Punkt behandelt, dessen Koordinaten ihre Werte über die Zeilen sind, und die Distanz zwischen jedem Variablenpaar wird mit dem gewählten Maß berechnet. Die Korrelationsdistanz ist 1 − r, wobei r die Pearson-Korrelation zwischen den beiden Variablen ist: 0 bei perfekter positiver und 2 bei perfekter negativer Korrelation. Die absolute Korrelationsdistanz ist 1 − |r| und behandelt einen starken negativen Zusammenhang als ebenso nah wie einen starken positiven. Die euklidische Distanz ist √Σ(xᵢ − yᵢ)² auf den Rohwerten und hängt daher von den Einheiten der einzelnen Variablen ab.
Das Clustern beginnt mit jeder Variablen für sich und verschmilzt wiederholt die beiden nächstgelegenen Cluster. Das Linkage-Verfahren legt die Distanz zwischen Clustern fest: Single verwendet das nächstgelegene Paar, Complete das am weitesten entfernte Paar, Average den Mittelwert aller paarweisen Distanzen, McQuitty einen gewichteten Mittelwert, Centroid und Median die Distanz zwischen den Clusterzentren und Ward den kleinsten Anstieg der Quadratsumme innerhalb der Cluster. Ward, Centroid und Median erfordern die euklidische Distanz; andere Kombinationen lehnt das Werkzeug ab.
Bei Korrelationsdistanz bedeutet eine Verbindung auf der Höhe h, dass die Variablen in den beiden Zweigen eine mittlere Korrelation von etwa 1 − h haben. Wenn Number of clusters angegeben ist, wird der Baum so geschnitten, dass sich diese Anzahl von Clustern ergibt, und jede Variable wird mit ihrem Cluster gekennzeichnet.
Eingabefelder und Optionen
Feld | Beschreibung |
Variables | Drei oder mehr numerische Spalten, die gruppiert werden sollen. Mit Strg- oder Befehlstaste + Klick wählen Sie mehrere aus. |
Linkage method | Wie die Distanz zwischen Clustern gemessen wird: Single, Complete, Average (Standard), Centroid, Median, McQuitty oder Ward. |
Distance measure | Correlation (Standard), Absolute Correlation oder Euclidean. |
Number of clusters | Optional, 2 oder mehr. Schneidet den Baum in diese Anzahl von Clustern und fügt die Tabelle Cluster Assignments hinzu. Leer lassen, um nur das Dendrogramm anzuzeigen. |
Title | Titel des Dendrogramms. Standard Cluster Variables. |
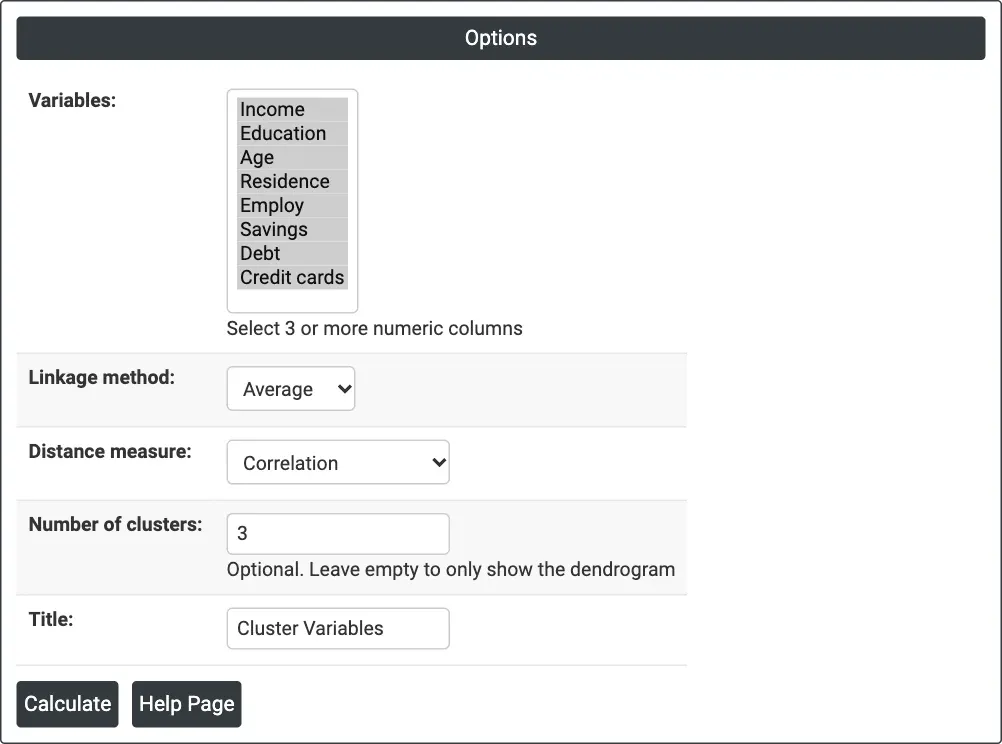
Abbildung 1 – Optionen für das Beispiel: acht Variablen zu Kreditantragstellern, Average-Linkage, Korrelationsdistanz, 3 Cluster.
Beschreibung der Ausgabe
- Dendrogram – die Variablen entlang der x-Achse in Baumreihenfolge; die y-Achse (Distance) zeigt das Niveau, auf dem sich Zweige verbinden. Je tiefer die Verbindung, desto ähnlicher die Variablen.
- Cluster Assignments – angezeigt, wenn Number of clusters angegeben ist: jede Variable und ihre Clusternummer.
- PDF-Export über Download.
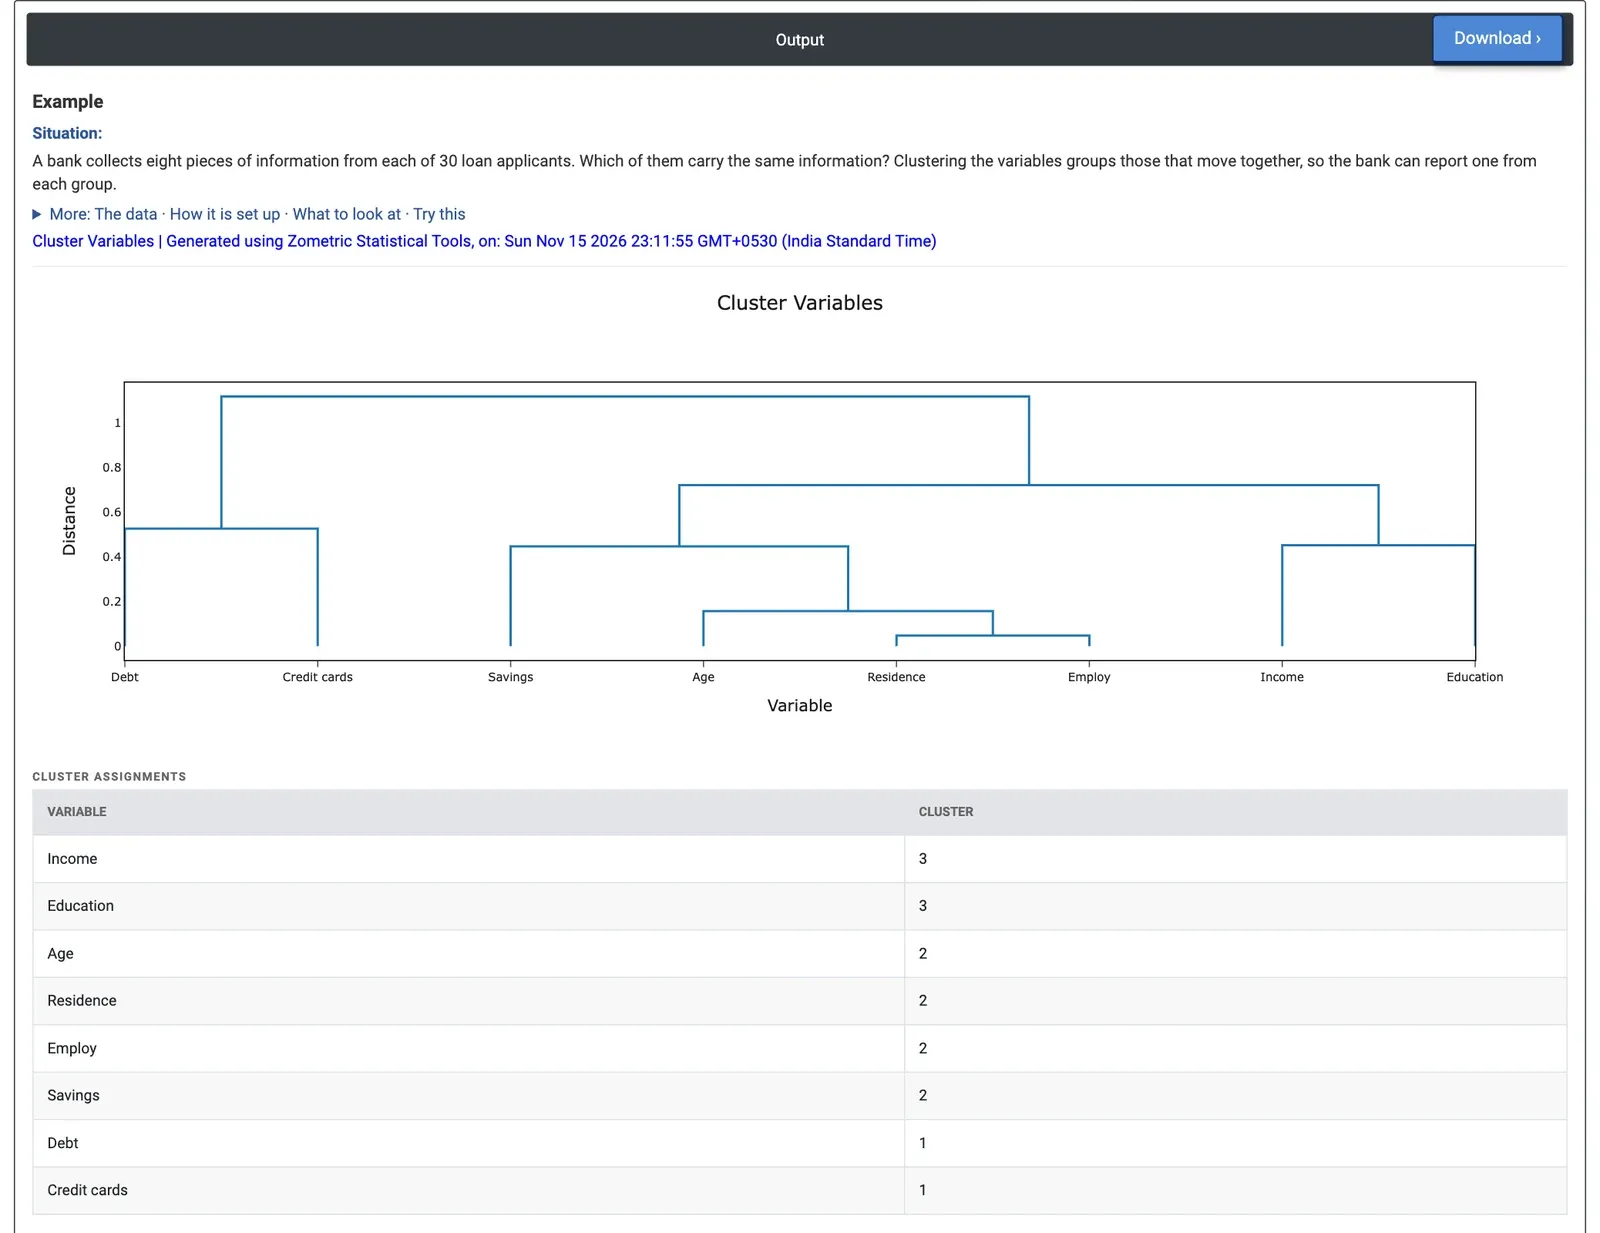
Abbildung 2 – Dendrogramm und Clusterzuordnung für die acht Variablen zu Kreditantragstellern: Cluster für Stabilität, Einkommen und Verschuldung.
Beispiel
Eine Bank erfasst zu jedem Kreditantragsteller acht Angaben: Einkommen, Ausbildungsjahre, Alter, Jahre an der aktuellen Adresse (Residence), Jahre beim aktuellen Arbeitgeber (Employ), Ersparnisse, Schulden und Anzahl der Kreditkarten. Ein Kreditanalyst möchte wissen, welche davon dieselbe Information tragen, damit ein kurzer Bericht je Gruppe nur eine Angabe zeigen kann. Anhand von 30 Antragstellern wählt der Analyst alle acht Spalten aus, behält Linkage method = Average und Distance measure = Correlation bei und gibt Number of clusters = 3 ein.
Residence und Employ verbinden sich zuerst, bei einer Distanz von 0.048 (Korrelation 0.95), und Age kommt bei 0.157 hinzu. Savings schließt sich dieser Gruppe bei 0.446 an. Income und Education verbinden sich bei 0.451, Debt und Credit cards bei 0.526. Bei drei Clustern enthält Cluster 2 Age, Residence, Employ und Savings, die die Stabilität des Antragstellers beschreiben; Cluster 3 enthält Income und Education; und Cluster 1 enthält Debt und Credit cards, die Verschuldung. Die letzten beiden Verbindungen erfolgen bei 0.72 und 1.117, deutlich über den anderen, was für drei Gruppen spricht.
Für den Analysten würde je eine Variable aus jedem Cluster, zum Beispiel Employ, Income und Debt, den Großteil dessen abdecken, was die acht Variablen aussagen. Mit Number of clusters = 2 werden die Cluster für Stabilität und Einkommen zusammengelegt, und Debt und Credit cards bleiben für sich; bei 4 Clustern werden Debt und Credit cards getrennt. Eine Faktorenanalyse derselben acht Spalten ergibt eine ähnliche Gruppierung, mit Ladungen, die zeigen, wie stark jede Variable zu ihrer Gruppe gehört.
Häufig gestellte Fragen
Wofür wird Cluster Variables verwendet?
Es wird verwendet, um eine lange Liste von Messgrößen oder Umfrage-Items zu kürzen. Variablen, die über die Beobachtungen hinweg gemeinsam steigen und fallen, werden zuerst verbunden, und das Ergebnis wird als Dendrogramm dargestellt. Wenn mehrere Variablen im selben Cluster liegen, können Sie eine davon oder einen kombinierten Wert verfolgen statt aller.
Was ist die Korrelationsdistanz?
Die Korrelationsdistanz ist 1 − r, wobei r die Pearson-Korrelation zwischen zwei Variablen ist: 0 bei perfekter positiver und 2 bei perfekter negativer Korrelation. Die absolute Korrelationsdistanz 1 − |r| behandelt einen starken negativen Zusammenhang als ebenso nah wie einen starken positiven. Die euklidische Distanz verwendet die Rohwerte und hängt daher von den Einheiten jeder Variablen ab.
Wie liest man das Dendrogramm für Variablen?
Die Variablen stehen entlang der x-Achse in Baumreihenfolge, und die y-Achse zeigt die Distanz, bei der sich Zweige verbinden; je tiefer die Verbindung, desto ähnlicher die Variablen. Bei Korrelationsdistanz bedeutet eine Verbindung auf der Höhe h, dass die Variablen in den beiden Zweigen eine mittlere Korrelation von etwa 1 − h haben.
Wie wählt man die Anzahl der Variablencluster?
Achten Sie auf Verbindungen, die deutlich über den anderen liegen. Im Beispiel der Kreditantragsteller erfolgten die letzten beiden Verbindungen bei 0.72 und 1.117, deutlich über den übrigen, was drei Cluster stützte: Stabilität, Einkommen und Verschuldung. Je eine Variable aus jedem Cluster, etwa Employ, Income und Debt, würde dann den Großteil dessen abdecken, was die acht Variablen aussagen.