
Einfache Korrespondenzanalyse
Die einfache Korrespondenzanalyse verarbeitet kategoriale Rohdaten oder eine Kontingenztafel und stellt Zeilen- und Spaltenkategorien auf einer Karte dar. Sie liefert einen Chi-Quadrat-Test auf Zusammenhang, eine Trägheitstabelle (Inertia) mit dem Erklärungsanteil jeder Komponente sowie Beitragstabellen für Zeilen und Spalten. Jede Variable benötigt mindestens 2 Kategorien. Nutzen Sie sie, um das Muster in einer großen Kreuztabelle zu erkennen, etwa Fehlerarten nach Maschine.
Zuletzt geprüft
Kernaussage
Die einfache Korrespondenzanalyse macht aus einer Kreuztabelle von Häufigkeiten eine Karte, auf der Zeilen- und Spaltenkategorien, die häufiger als zufällig zu erwarten zusammen auftreten, nahe beieinander liegen.
Auf dieser Seite
Zweck
Die einfache Korrespondenzanalyse macht aus einer Kreuztabelle von Häufigkeiten eine Karte. Zeilen- und Spaltenkategorien werden als Punkte dargestellt, und Kategorien, die häufiger als zufällig zu erwarten zusammen auftreten, liegen nahe beieinander. Nutzen Sie sie, um das Muster in einer großen Kreuztabelle auf einen Blick zu erkennen: welche Fehlerarten zu welchen Maschinen gehören, welche Reklamationskategorien zu welchen Produkten oder welche Eigenschaften Kunden mit welchen Marken verbinden.
Wichtige Funktionen
- Akzeptiert Rohdaten (eine Zeile je Einheit mit zwei kategorialen Spalten) oder eine bereits als Häufigkeiten zusammengefasste Kontingenztafel.
- Chi-Quadrat-Test auf Zusammenhang zwischen Zeilen- und Spaltenvariable.
- Trägheitstabelle (Inertia), die zeigt, welchen Anteil des Zusammenhangs jede Komponente (Achse der Karte) erklärt.
- Beitragstabellen für Zeilen und Spalten: Qualität, Masse, Trägheit, Koordinaten, quadrierte Korrelationen und Beiträge für die von Ihnen gewählte Anzahl von Komponenten.
- Fünf Diagramme: symmetrisches Diagramm von Zeilen und Spalten, nur Zeilen, nur Spalten sowie asymmetrische Zeilen- oder Spaltendiagramme.
Statistische Methoden
Bei der Eingabe Categorical variables bildet das Werkzeug eine Kreuztabelle der Zeilenvariable gegen die Spaltenvariable und ignoriert Zeilen mit fehlendem Wert. Bei der Eingabe Columns of a contingency table enthält jede ausgewählte Spalte die Häufigkeiten einer Spaltenkategorie, und jede Zeile ist eine Zeilenkategorie; Zeilen oder Spalten mit Summe null werden entfernt. Jede Variable benötigt mindestens 2 Kategorien.
Die Häufigkeiten werden durch die Gesamtsumme n geteilt, was die Anteile P ergibt, mit den Zeilenmassen r (Zeilensummen von P) und den Spaltenmassen c (Spaltensummen). Die Matrix der standardisierten Residuen S = Dr^−½ (P − r cᵀ) Dc^−½ wird durch Singulärwertzerlegung zerlegt. Jeder Singulärwert d ergibt eine Komponente mit der Trägheit d², und die Anzahl der Komponenten ist der kleinere Wert von (Zeilen − 1) und (Spalten − 1). Die Gesamtträgheit entspricht der Chi-Quadrat-Statistik geteilt durch n, und das Werkzeug gibt Chi-Quadrat = n × Gesamtträgheit mit (Zeilen − 1)(Spalten − 1) Freiheitsgraden und dem zugehörigen p-Wert aus. Ein kleiner p-Wert bedeutet, dass Zeilen und Spalten zusammenhängen, die Karte also ein echtes Muster zeigt.
Die Hauptkoordinaten der Zeilen sind Dr^−½ U D und die der Spalten Dc^−½ V D. In den Beitragstabellen ist Mass der Anteil der Kategorie an der Gesamthäufigkeit, Inert ihr Anteil an der Gesamtträgheit, Corr der quadrierte Kosinus (wie gut eine Komponente den Punkt darstellt), Qual die Summe von Corr über die ausgegebenen Komponenten und Contr der Anteil der Trägheit einer Komponente, der auf den Punkt entfällt. Symmetrische Diagramme verwenden für beide Punktmengen Hauptkoordinaten; ein asymmetrisches Zeilendiagramm zeigt Zeilen in Haupt- und Spalten in Standardkoordinaten (Hauptkoordinaten geteilt durch d), ein asymmetrisches Spaltendiagramm umgekehrt.
Eingabefelder und Optionen
Feld | Beschreibung |
Input data | Categorical variables (Standard): eine Zeile je Einheit. Columns of a contingency table: bereits zusammengefasste Häufigkeiten. Die folgenden Felder ändern sich je nach Auswahl. |
Row variable / Column variable | Bei der Eingabe Categorical variables: die beiden kategorialen Spalten für die Kreuztabelle. Beide erforderlich und müssen verschieden sein. |
Contingency table columns | Bei Eingabe als Kontingenztafel: zwei oder mehr Spalten, jede mit den Häufigkeiten einer Spaltenkategorie, eine Zeile je Zeilenkategorie. |
Row names | Bei Eingabe als Kontingenztafel, optional: eine Spalte mit dem Namen jeder Tabellenzeile. Leer ergibt Row 1, Row 2 usw. |
Column names | Bei Eingabe als Kontingenztafel, optional: eine Spalte mit je einem Namen pro ausgewählter Tabellenspalte, in derselben Reihenfolge. Leer verwendet die Spaltenüberschriften. |
Number of components | Für wie viele Komponenten Coord, Corr und Contr in den Beitragstabellen ausgegeben werden. Standard 2; 1 bis 20, begrenzt auf die Anzahl verfügbarer Komponenten. |
Symmetric plot showing rows and columns | Standardmäßig aktiviert. Zeilen und Spalten auf einer Karte, beide in Hauptkoordinaten. |
Symmetric plot showing rows only / columns only | Standardmäßig deaktiviert. Dieselbe Karte mit nur einer Punktmenge. |
Asymmetric row plot / Asymmetric column plot | Standardmäßig deaktiviert. Zeilen in Haupt- und Spalten in Standardkoordinaten oder umgekehrt. |
Title | Titel der Diagramme. Standard: Simple Correspondence Analysis. |
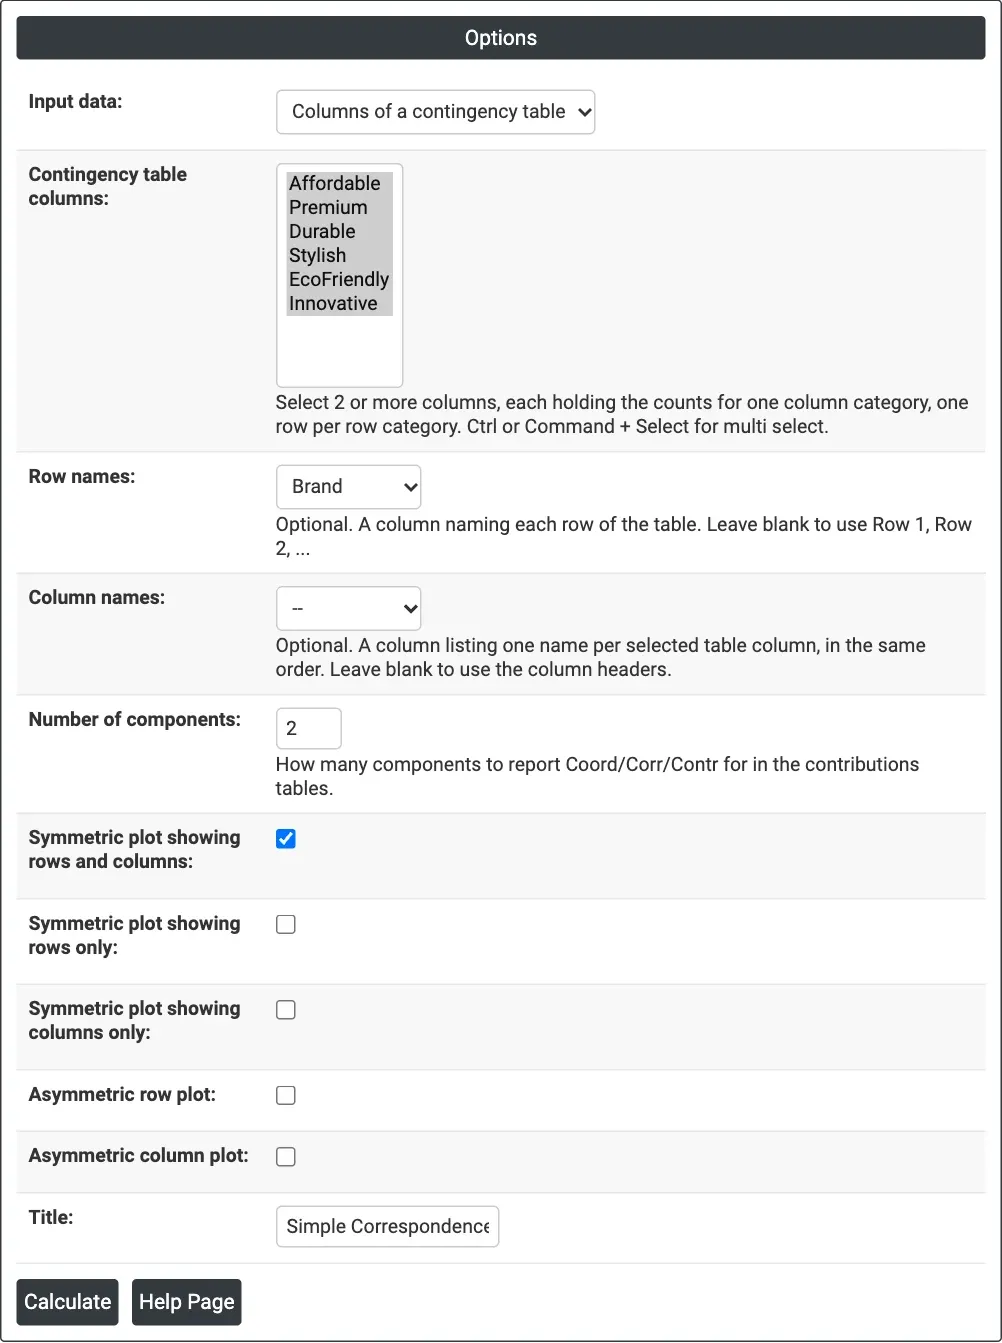
Abbildung 1 — Optionen für das Beispiel zur Markenwahrnehmung: Eingabe als Kontingenztafel mit sechs Eigenschaftsspalten und Brand als Zeilennamen.
Beschreibung der Ausgabe
- Symmetric Plot, Row Plot, Column Plot, Asymmetric Row Plot, Asymmetric Column Plot — die aktivierten Diagramme, mit Component 1 und Component 2 als Achsen und dem jeweils erklärten Trägheitsanteil in Prozent in den Achsentiteln.
- Contingency Table — bei Eingabe als Kontingenztafel: die Tabelle, wie sie analysiert wurde.
- Chi-square, DF und P-value — der Test auf Zusammenhang zwischen Zeilen und Spalten.
- Analysis of Contingency Table — Trägheit, Anteil und kumulierter Anteil jeder Achse, mit einem Text-Histogramm, sowie die Gesamtträgheit.
- Row Contributions und Column Contributions — ID, Name, Qual, Mass, Inert sowie Coord, Corr und Contr für jede ausgegebene Komponente.
- PDF-Export über Download.
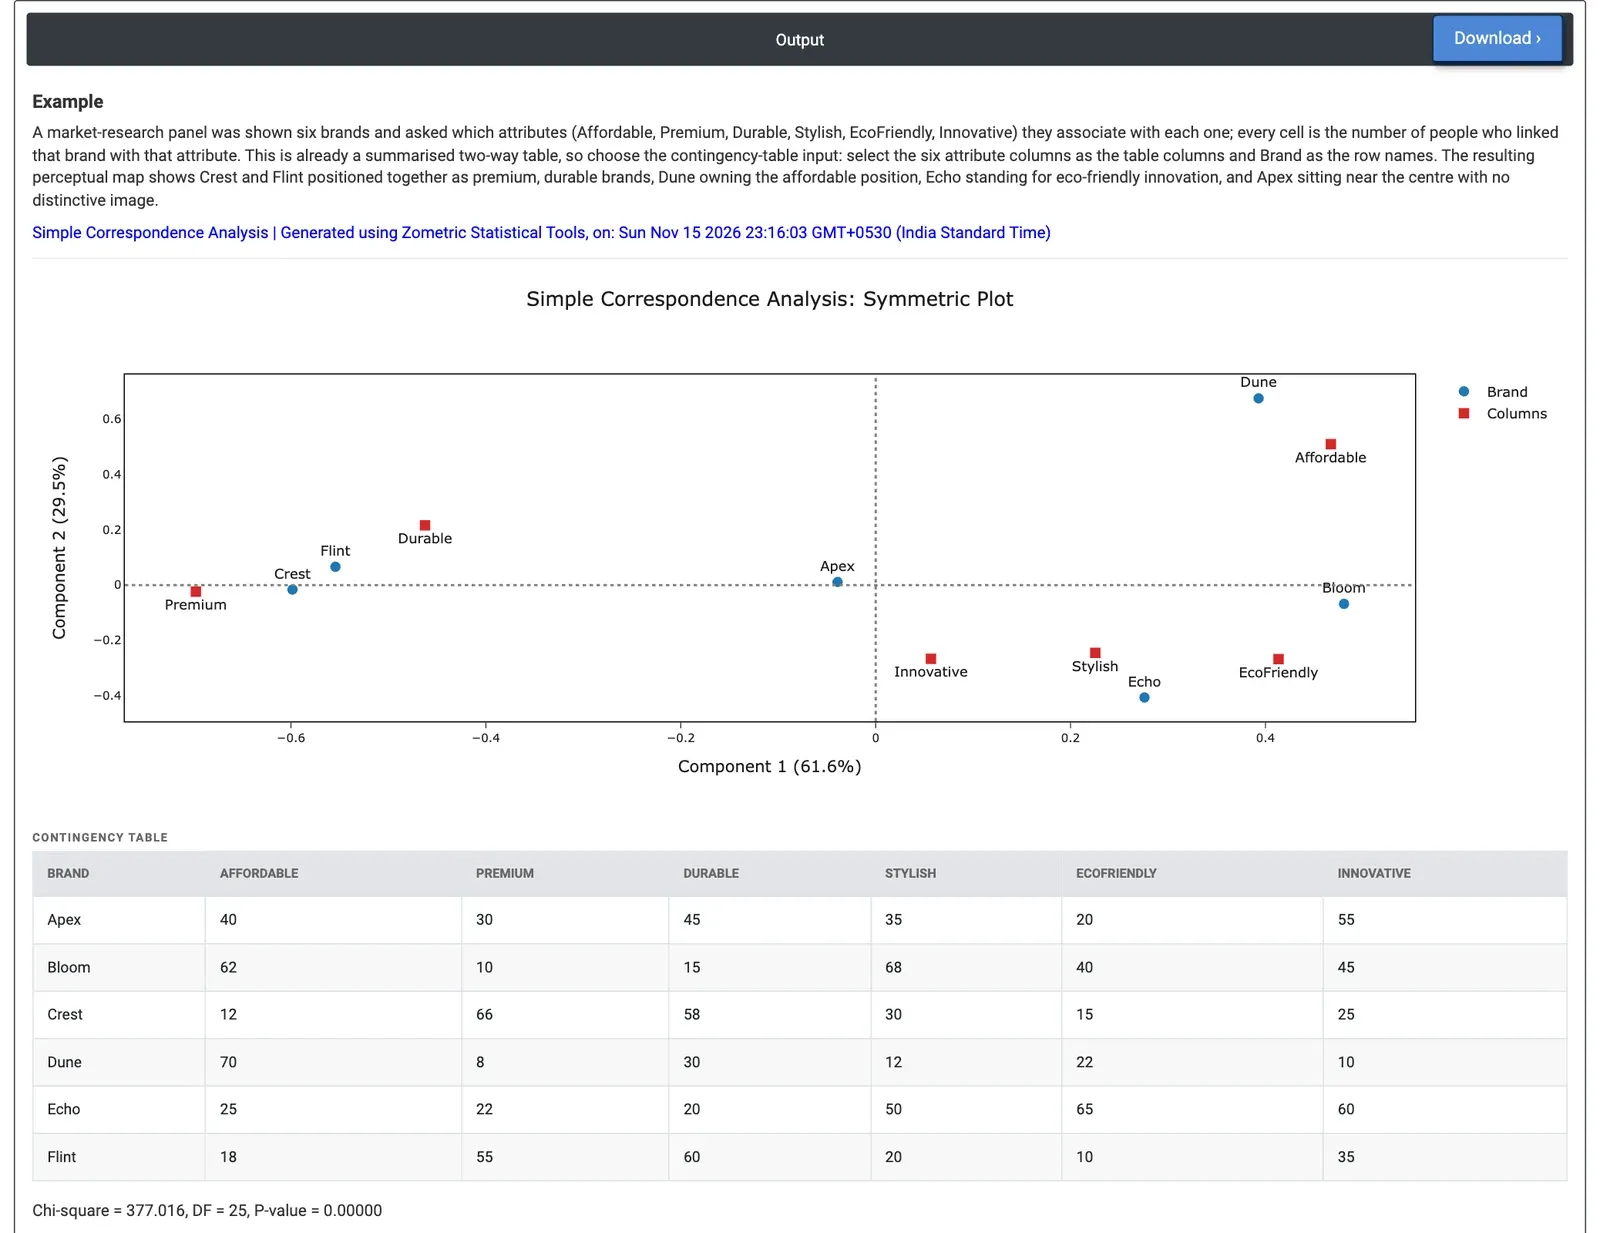
Abbildung 2 — Symmetrisches Diagramm von sechs Marken und sechs Eigenschaften: Crest und Flint liegen bei Premium und Durable, Dune bei Affordable, Echo nahe EcoFriendly; Chi-Quadrat 377.0 bei 25 DF.
Beispiel
Einem Marktforschungspanel wurden sechs Marken (Apex, Bloom, Crest, Dune, Echo und Flint) gezeigt, und die Teilnehmer wurden gefragt, welche von sechs Eigenschaften sie mit jeder Marke verbinden: Affordable, Premium, Durable, Stylish, EcoFriendly und Innovative. Jede Zelle enthält die Anzahl der Personen, die diese Marke mit dieser Eigenschaft verbunden haben. Das Marketingteam möchte die Position jeder Marke sehen. Da die Daten bereits eine Häufigkeitstabelle sind, setzt es Input data = Columns of a contingency table, wählt die sechs Eigenschaftsspalten als Contingency table columns und Brand als Row names und behält das symmetrische Diagramm von Zeilen und Spalten bei.
Chi-Quadrat beträgt 377.016 bei 25 Freiheitsgraden (p < 0.00001), das Markenimage unterscheidet sich also deutlich zwischen den Marken. Component 1 trägt 61.6% der Trägheit und Component 2 29.5%, die zweidimensionale Karte zeigt also 91.1% des Musters. Component 1 verläuft von Premium (−0.698) und Durable (−0.462) links bis Affordable (0.467) und EcoFriendly (0.414) rechts. Crest (−0.599) und Flint (−0.554) liegen auf der Seite von Premium und Durable und werden auf dieser Achse nahezu perfekt dargestellt (Corr 0.94 und 0.98). Dune liegt hoch auf Component 2 (0.674), neben Affordable, und erklärt 62.2% der Trägheit dieser Komponente. Echo (0.276, −0.406) liegt nahe EcoFriendly, Stylish und Innovative, und Bloom (0.481) tendiert zu Stylish und Affordable.
Apex liegt nahe dem Zentrum (−0.039, 0.011) mit einer Qualität von nur 0.038: Sein Profil liegt nahe am Durchschnitt aller Marken, es hat also kein eigenständiges Image. Für das Team bedeutet das: Crest und Flint konkurrieren um dieselbe Position für Premium und Langlebigkeit, Dune besetzt die preisgünstige Position, und Apex ist die Marke, die eine klarere Botschaft braucht.
Häufig gestellte Fragen
Wofür wird die Korrespondenzanalyse verwendet?
Sie dient dazu, das Muster in einer großen Kreuztabelle auf einen Blick zu erkennen, zum Beispiel welche Fehlerarten zu welchen Maschinen gehören, welche Reklamationskategorien zu welchen Produkten oder welche Eigenschaften Kunden mit welchen Marken verbinden. Zeilen- und Spaltenkategorien werden als Punkte dargestellt, und Kategorien, die häufiger als zufällig zusammen auftreten, liegen nahe beieinander.
Was ist die Trägheit (Inertia) in der Korrespondenzanalyse?
Die Trägheit misst den Zusammenhang in der Tabelle. Jede Komponente bzw. Achse der Karte hat eine Trägheit, die ihrem quadrierten Singulärwert entspricht, und die Gesamtträgheit entspricht der Chi-Quadrat-Statistik geteilt durch die Gesamtsumme n. Die Trägheitstabelle zeigt den Anteil, den jede Komponente erklärt; im Markenbeispiel zeigten die ersten beiden Komponenten 91.1% des Musters.
Wie interpretiert man Qualität, Masse und Beitrag?
Mass ist der Anteil einer Kategorie an der Gesamthäufigkeit, Inert ihr Anteil an der Gesamtträgheit, Corr gibt an, wie gut eine Komponente den Punkt darstellt, Qual ist die Summe von Corr über die ausgegebenen Komponenten und Contr der Anteil der Trägheit einer Komponente, der auf den Punkt entfällt. Ein Punkt nahe dem Zentrum mit geringer Qualität, wie Apex im Beispiel, hat ein Profil nahe am Durchschnitt.
Was ist der Unterschied zwischen symmetrischen und asymmetrischen Diagrammen?
Ein symmetrisches Diagramm zeigt Zeilen und Spalten gemeinsam, beide in Hauptkoordinaten, und ist standardmäßig aktiviert. Ein asymmetrisches Zeilendiagramm zeigt Zeilen in Hauptkoordinaten und Spalten in Standardkoordinaten (Hauptkoordinaten geteilt durch den Singulärwert), ein asymmetrisches Spaltendiagramm umgekehrt. Diagramme nur mit Zeilen oder nur mit Spalten sind ebenfalls verfügbar.