
Kreuztabelle und Chi-Quadrat-Test
Erstellt aus einer Zeile je Datensatz eine zweidimensionale Häufigkeitstabelle, optional mit Zeilen-, Spalten- und Gesamtprozenten. Der Zusammenhang wird mit dem Chi-Quadrat-Test nach Pearson und dem Likelihood-Quotienten-Chi-Quadrat-Test geprüft; erwartete Häufigkeiten, Residuen und Zellbeiträge lassen sich einsehen, die Stärke misst Cramérs V-Quadrat. Fishers exakter Test deckt 2x2-Tabellen ab. Ein Hinweis erscheint, wenn erwartete Häufigkeiten unter 5 liegen. Eine Schichtvariable liefert eine Tabelle je Stufe.
Zuletzt geprüft
Kernaussage
Kreuztabelle und Chi-Quadrat zählen, wie oft jede Kombination zweier kategorialer Variablen in Rohdatensätzen vorkommt, und prüfen, ob beide zusammenhängen, optional nach einer dritten Variablen in Schichten aufgeteilt.
Auf dieser Seite
Zweck
Kreuztabelle und Chi-Quadrat zählen, wie oft jede Kombination zweier kategorialer Variablen in Rohdatensätzen vorkommt, etwa Abteilung und Zufriedenheitsgrad, Fehlerart und Linie oder Lieferant und gut/schlecht, und prüfen, ob die beiden Variablen zusammenhängen. Eine dritte Variable kann die Analyse in Schichten aufteilen, zum Beispiel eine Tabelle je Schicht.
Wichtigste Funktionen
- Zweidimensionale Häufigkeitstabelle mit Zeilen- und Spaltensummen, erstellt aus einer Zeile je Datensatz.
- For layers: eine eigene Tabelle und ein eigener Test für jeden Wert einer dritten Variablen.
- Zeilen-, Spalten- und Gesamtprozente.
- Chi-Quadrat-Test nach Pearson (standardmäßig aktiviert) und Likelihood-Quotienten-Chi-Quadrat-Test.
- Erwartete Häufigkeiten, rohe, standardisierte und adjustierte Residuen sowie der Beitrag jeder Zelle zum Chi-Quadrat.
- Cramérs V-Quadrat und Fishers exakter Test für 2×2-Tabellen.
- Warnung, wenn einige erwartete Häufigkeiten unter 5 liegen.
Statistische Methoden
Datensätze mit einem fehlenden Wert in der Zeilen-, Spalten- oder Schichtvariablen werden ausgeschlossen. Für die Tabelle der beobachteten Häufigkeiten O mit Zeilensummen Rᵢ, Spaltensummen Cⱼ und Gesamtumfang N ist die erwartete Häufigkeit unter Unabhängigkeit Eᵢⱼ = Rᵢ·Cⱼ / N. Die Pearson-Statistik χ² = Σ (O − E)² / E (ohne Stetigkeitskorrektur, auch bei 2×2-Tabellen) und die Likelihood-Quotienten-Statistik G² = 2 Σ O·ln(O / E) werden mit einer Chi-Quadrat-Verteilung mit (r − 1)(c − 1) Freiheitsgraden verglichen. Ein kleiner p-Wert bedeutet, dass sich die Verteilung über die Spalten zwischen den Zeilen unterscheidet.
So erkennen Sie, welche Zellen das Ergebnis bestimmen: Der Beitrag einer Zelle ist (O − E)² / E; das rohe Residuum ist O − E; das standardisierte Residuum (O − E) / √E; das adjustierte Residuum (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)) ist annähernd standardnormalverteilt, sodass Werte jenseits von etwa ±2 Zellen kennzeichnen, die deutlich von der Unabhängigkeit abweichen. Cramérs V-Quadrat = χ² / (N·(min(r, c) − 1)) misst die Stärke des Zusammenhangs von 0 (keiner) bis 1 (vollständig); bei großem Stichprobenumfang kann auch ein schwacher Zusammenhang signifikant sein.
Die Chi-Quadrat-Näherung erfordert hinreichend große erwartete Häufigkeiten; die Seite gibt an, wie viele Zellen eine erwartete Häufigkeit unter 5 haben. Für eine 2×2-Tabelle liefert Fishers exakter Test einen exakten p-Wert, der nicht auf dieser Näherung beruht. Die Kategorien erscheinen in sortierter Reihenfolge.
Eingabefelder und Optionen
Feld | Beschreibung |
Rows | Kategoriale Spalte für die Zeilen der Tabelle. Pflichtfeld. |
Columns | Kategoriale Spalte für die Spalten. Pflichtfeld; muss sich von Rows unterscheiden. |
For layers | Optional. Erzeugt eine eigene Tabelle und einen eigenen Test für jeden Wert dieser Variablen. |
Row percents / Column percents / Total percents | Fügt Prozenttabellen hinzu. Standardmäßig deaktiviert. |
Chi-Square test | Chi-Quadrat-Test nach Pearson. Standardmäßig aktiviert. |
Likelihood ratio chi-square | Fügt den Likelihood-Quotienten-Test hinzu. |
Expected cell counts / Raw residuals / Standardized residuals / Adjusted residuals / Each cell's contribution to chi-square | Fügt diese Tabellen hinzu. Standardmäßig deaktiviert. |
Cramer's V-square statistic | Stärke des Zusammenhangs. |
Fisher's exact test for 2x2 tables | Exakter p-Wert; wird nur für 2×2-Tabellen ausgegeben. |
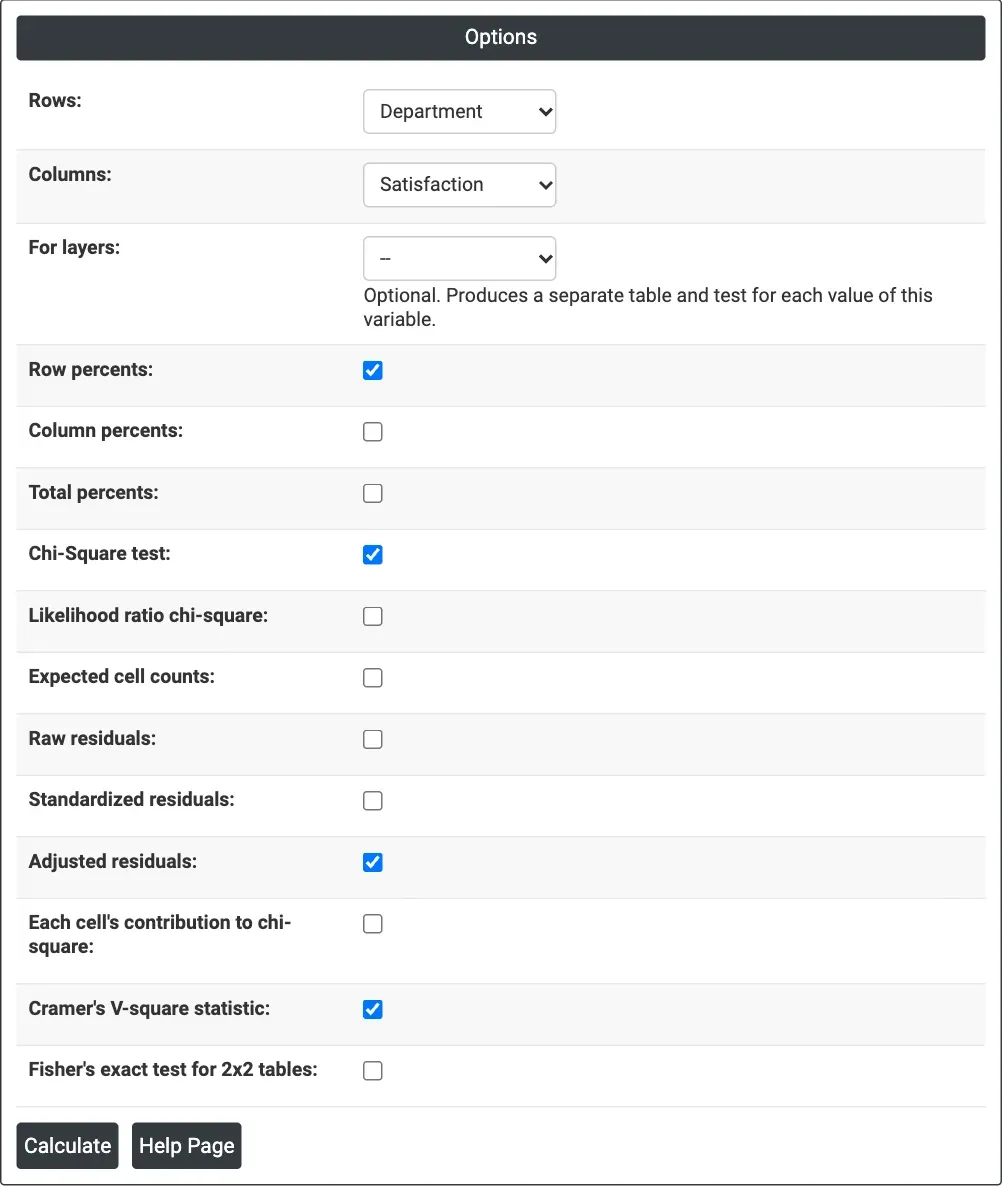
Abbildung 1: Optionen für das Umfragebeispiel: Department als Zeilen, Satisfaction als Spalten; Row percents, Chi-Square test, Adjusted residuals und Cramer's V-square sind aktiviert.
Beschreibung der Ausgabe
- Counts: die Häufigkeitstabelle mit den Summen All (eine je Schicht).
- Row percents, Column percents, Total percents, Expected counts, Raw, Standardized und Adjusted residuals, Contribution-Tabellen: sofern aktiviert.
- Chi-Square Test: Chi-Square, DF und P-Value des Pearson- und des Likelihood-Quotienten-Tests, mit einem Hinweis, wenn erwartete Häufigkeiten unter 5 liegen.
- Other Statistics: Cramer's V-square und P-Value von Fishers exaktem Test.
- PDF-Export über Download.
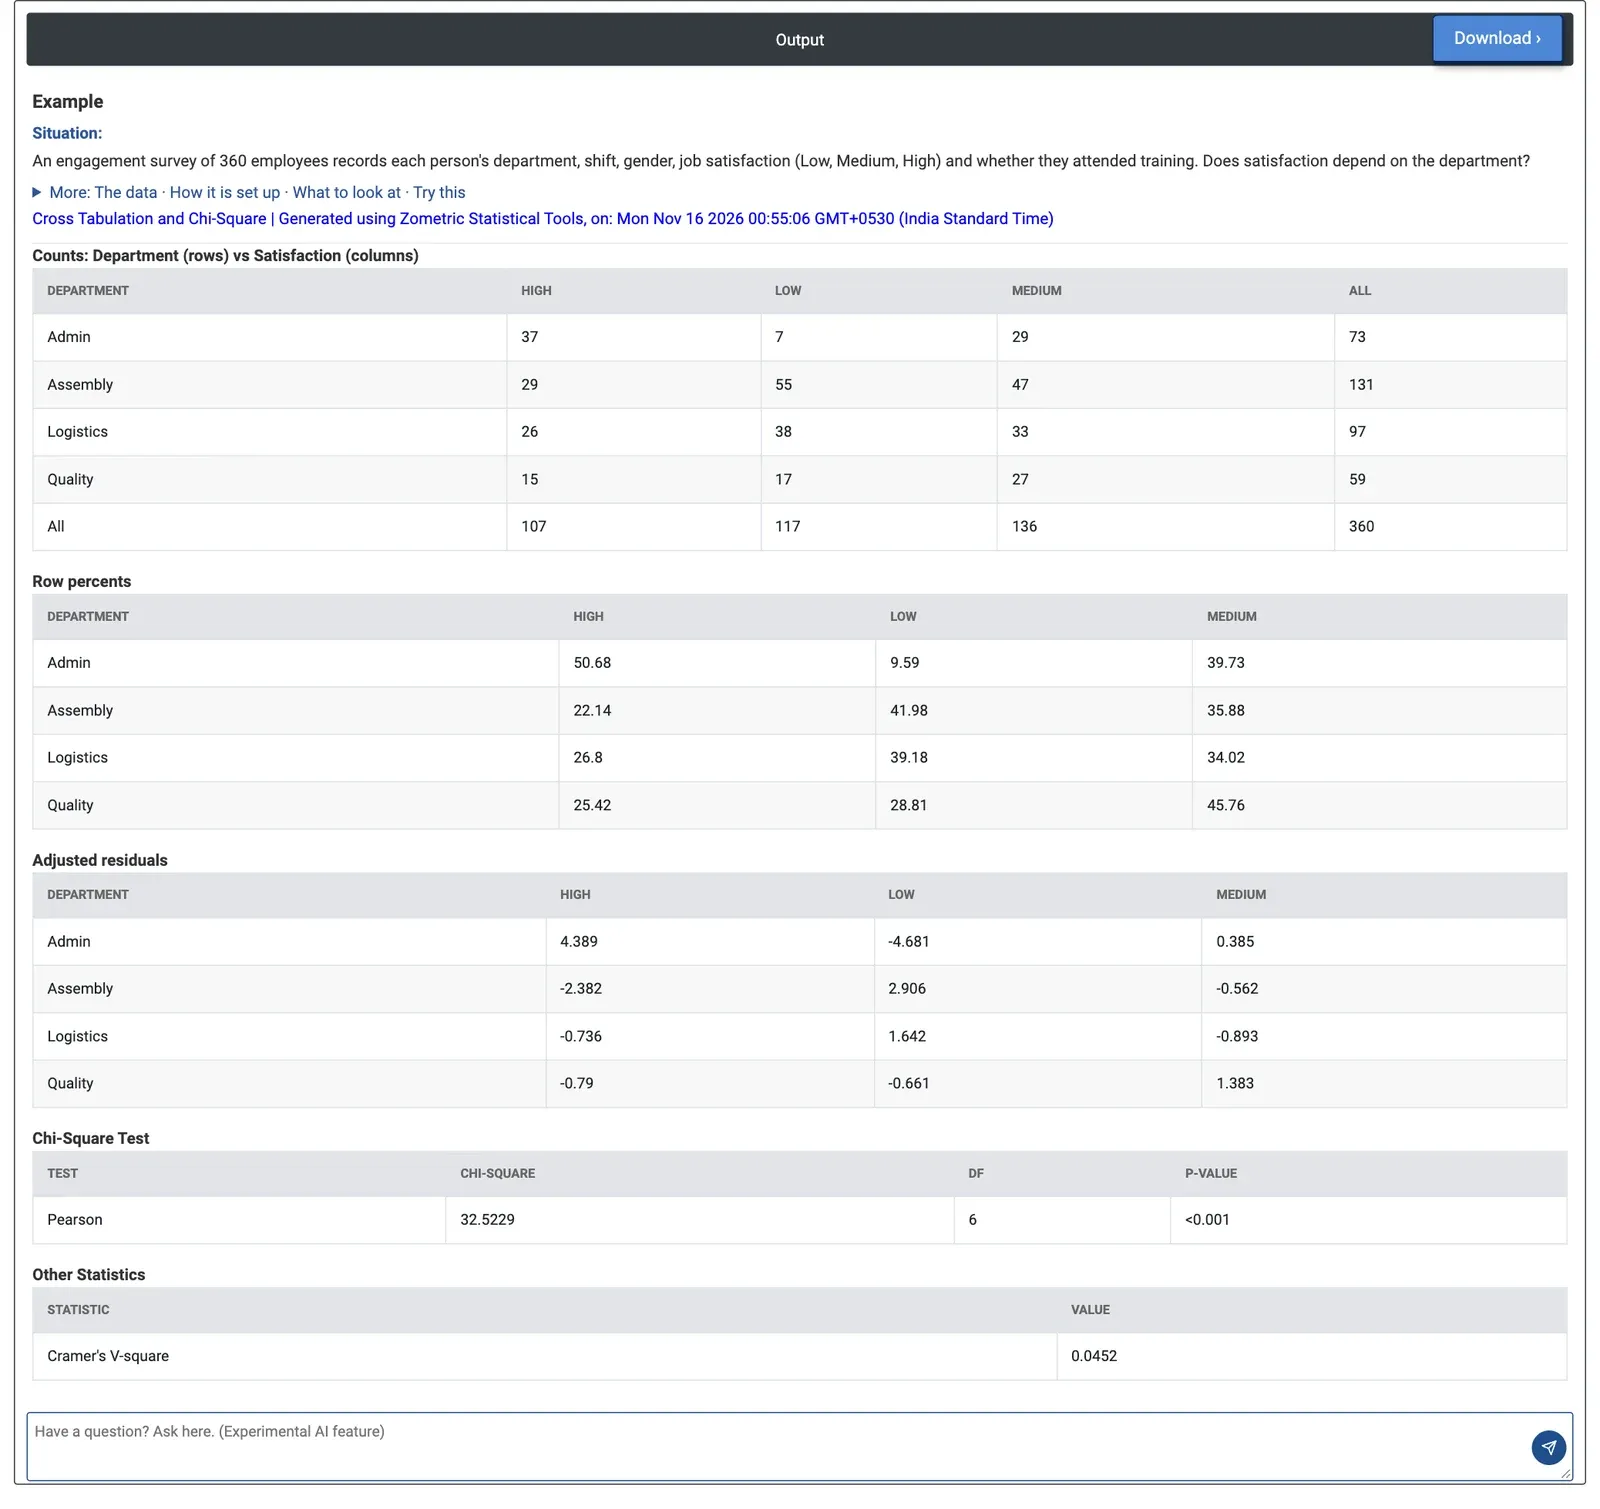
Abbildung 2: Zufriedenheit nach Abteilung: Chi-Quadrat nach Pearson 32.52 mit 6 DF, p < 0.001; Admin hat die meisten Bewertungen High, Assembly die meisten Low.
Beispiel
Eine Mitarbeiterbefragung unter 360 Beschäftigten erfasst für jede Person Abteilung, Schicht, Geschlecht, Zufriedenheit (Low, Medium, High) und ob sie an einer Schulung teilgenommen hat. Die Personalabteilung möchte wissen, ob die Zufriedenheit von der Abteilung abhängt. Sie wählt Department als Zeilen und Satisfaction als Spalten und aktiviert Row percents, Adjusted residuals und Cramer's V-square.
Die Zufriedenheit hängt tatsächlich von der Abteilung ab: Chi-Quadrat nach Pearson 32.52 bei 6 DF, p < 0.001. Admin ist am zufriedensten, mit 50.68% High und nur 9.59% Low; Assembly am wenigsten, mit 41.98% Low und 22.14% High. Die adjustierten Residuen jenseits von ±2 zeigen die Zellen hinter dem Ergebnis: Admin High (+4.389) und Low (−4.681), Assembly Low (+2.906) und High (−2.382). Cramérs V-Quadrat beträgt 0.0452: ein echter, aber mäßiger Zusammenhang.
Wird For layers auf Shift gesetzt, entsteht eine Tabelle je Schicht. In der Nachtschicht hat Logistics nur 4.88% High und 53.66% Low (adjustiertes Residuum für High −2.475), gegenüber 42.86% High in der Tagschicht; beim Logistikteam der Nachtschicht sollte man also ansetzen. Die Tabelle der Nachtschicht enthält den Hinweis, dass 1 Zelle eine erwartete Häufigkeit unter 5 hat. Geschlecht gegen Schulungsteilnahme ist eine 2×2-Tabelle: Fishers exakter Test ergibt p = 0.5888, es gibt also keinen Hinweis darauf, dass sich die Schulungsteilnahme nach Geschlecht unterscheidet.
Häufig gestellte Fragen
Was ist der Unterschied zwischen einer Kreuztabelle und einem Chi-Quadrat-Test?
Eine Kreuztabelle zählt, wie oft jede Kombination zweier kategorialer Variablen vorkommt, und ergibt eine zweidimensionale Tabelle mit Zeilen- und Spaltensummen und optionalen Prozentwerten. Der Chi-Quadrat-Test prüft dann, ob die beiden Variablen zusammenhängen: Ein kleiner p-Wert bedeutet, dass sich die Verteilung über die Spalten zwischen den Zeilen unterscheidet. Eine dritte Variable kann die Analyse in Schichten aufteilen.
Was misst Cramérs V-Quadrat?
Cramérs V-Quadrat = χ² / (N·(min(r, c) − 1)) misst die Stärke des Zusammenhangs, von 0 für keinen bis 1 für einen vollständigen Zusammenhang. Bei großem Stichprobenumfang kann auch ein schwacher Zusammenhang statistisch signifikant sein; im Umfragebeispiel betrug V-Quadrat 0.0452, ein echter, aber mäßiger Zusammenhang, obwohl p unter 0.001 lag.
Wann sollte man Fishers exakten Test verwenden?
Die Chi-Quadrat-Näherung erfordert hinreichend große erwartete Häufigkeiten, und die Ausgabe gibt an, wie viele Zellen eine erwartete Häufigkeit unter 5 haben. Für eine 2x2-Tabelle liefert Fishers exakter Test einen exakten p-Wert, der nicht auf dieser Näherung beruht. Er wird nur für 2x2-Tabellen ausgegeben.
Wie findet man heraus, welche Zellen den Zusammenhang bestimmen?
Betrachten Sie den Beitrag jeder Zelle zum Chi-Quadrat, (O − E)² / E, sowie die Residuen. Das adjustierte Residuum ist annähernd standardnormalverteilt, sodass Werte jenseits von etwa ±2 Zellen kennzeichnen, die deutlich von der Unabhängigkeit abweichen. Im Beispiel gehörten Admin High (+4.389) und Assembly Low (+2.906) zu den Zellen hinter dem Ergebnis.