
Zeitreihenzerlegung (Decomposition)
Die klassische Zerlegung glättet die Reihe mit einem zentrierten gleitenden Durchschnitt, leitet Saisonindizes aus den Medianen der Perioden ab, passt an die saisonbereinigten Daten eine Trendgerade nach der Methode der kleinsten Quadrate an und prognostiziert Trend mal oder plus Index. Wählen Sie ein multiplikatives oder additives Modell. Sie benötigt mindestens zwei vollständige Saisons ohne Lücken. Die Ausgabe umfasst Trendgleichung, Saisonindizes, MAPE, MAD, MSD und Prognosen.
Zuletzt geprüft
Kernaussage
Die Zerlegung teilt eine saisonale Zeitreihe in einen linearen Trend, ein wiederkehrendes Saisonmuster und einen Rest und prognostiziert durch Fortschreiben des Trends und Wiederholen des Saisonmusters.
Auf dieser Seite
Zweck
Die Zerlegung (Decomposition) teilt eine saisonale Zeitreihe in einen linearen Trend, ein wiederkehrendes Saisonmuster und einen Rest. Sie beantwortet Fragen wie „Wie stark wächst die Nachfrage jeden Monat?“ und „Wie weit liegt der Dezember jedes Jahr über oder unter dem Trend?“ und prognostiziert durch Fortschreiben des Trends und Wiederholen des Saisonmusters. Verwenden Sie sie für Monats-, Quartals- oder Schichtdaten mit stabiler Saisonalität, etwa um Kapazität oder Bestand für die Spitzenmonate zu planen.
Wichtige Funktionen
- Multiplikatives Modell (jede Saisonperiode liegt um einen Prozentsatz über oder unter dem Trend) oder additives Modell (jede Saisonperiode liegt um einen festen Betrag darüber oder darunter).
- Saisonindex für jede Periode der Saison und die angepasste Trendgleichung.
- Prognosen für beliebig viele Perioden, ab dem Ende der Reihe oder ab einer früheren Zeile, um das Verfahren an bekannten Daten zu testen.
- Genauigkeitsmaße MAPE, MAD und MSD.
- Zerlegungsdiagramm (beobachtet, Trend, Saison, Residuum), Diagramme Component Analysis und Seasonal Analysis sowie optional Vier-in-eins-Residuendiagramme.
- Vollständige Ergebnistabelle mit Trend-, Saison-, trendbereinigten, saisonbereinigten, angepassten Werten und Fehlerwerten für jede Zeile.
Statistische Methoden
Das Werkzeug verwendet die klassische Zerlegung. Zunächst glättet es die Daten mit einem zentrierten gleitenden Durchschnitt der Länge L (Saisonlänge); bei geradem L verwendet es den 2×L-Durchschnitt, sodass jeder Wert auf einem Zeitpunkt liegt. Die rohen Saisonwerte sind die Daten geteilt durch diesen Durchschnitt (multiplikativ) bzw. abzüglich dieses Durchschnitts (additiv). Für jede Periode der Saison wird der Median ihrer Rohwerte gebildet, und die Mediane werden so skaliert, dass ihr Mittel 1 (multiplikativ) bzw. 0 (additiv) beträgt: Dies sind die Saisonindizes.
Anschließend werden die Daten saisonbereinigt (durch den Index geteilt bzw. um ihn vermindert), und an die bereinigten Daten wird nach der Methode der kleinsten Quadrate eine Gerade Yt = b₀ + b₁·t angepasst. Der angepasste Wert jeder Zeile ist Trend × Index (multiplikativ) bzw. Trend + Index (additiv), und der Fehler ist bei beiden Modellen Daten − angepasster Wert. Prognosen schreiben die Trendgerade fort und wenden den Index der passenden Periode an; Prognoseintervalle werden nicht ausgegeben. Mit einem Prognoseursprung werden Indizes und Trend aus den Daten bis zu dieser Zeile neu berechnet. Genauigkeit: MAPE = Mittelwert von |Fehler / Daten| × 100, MAD = Mittelwert von |Fehler|, MSD = Mittelwert von Fehler².
Die Reihe benötigt mindestens zwei vollständige Saisons ohne Lücken; das multiplikative Modell erfordert, dass alle Werte größer als null sind. Wählen Sie multiplikativ, wenn der saisonale Ausschlag mit dem Niveau der Reihe wächst, und additiv, wenn er gleich groß bleibt.
Eingabefelder & Optionen
Feld | Beschreibung |
Variable (Y) | Pflichtfeld. Die numerische Reihe in zeitlicher Reihenfolge. |
Seasonal length | Pflichtfeld, mindestens 2. Anzahl der Perioden je Saison, z. B. 12 für Monatsdaten mit Jahresmuster, 4 für Quartalsdaten. |
Model | Additive (Standard) oder Multiplicative. |
First observation is in seasonal period | Standard 1. Die Position der ersten Zeile innerhalb der Saison, z. B. 6, wenn die Saison im Januar beginnt und die Daten im Juni beginnen. |
Number of forecasts | Standard 0 (keine), bis zu 1000. |
Forecast origin (row) | Optional, aktiv, wenn Prognosen angefordert werden. Die Prognosen beginnen nach dieser Zeile und verwenden die Daten bis zu ihr; leer = Ende der Reihe. |
Results to display | Summary table (Standard) oder Summary table and results table. |
Residual plots (four in one) | Standardmäßig nicht aktiviert. Normalwahrscheinlichkeitsnetz, Residuen gegen angepasste Werte, Histogramm und Residuen gegen Reihenfolge. |
Component analysis graph / Seasonal analysis graph | Beide standardmäßig aktiviert. Fügen die zwei zusätzlichen Diagramme mit je vier Feldern hinzu. |
Title | Titel der Ausgabe. Standard ist Decomposition. |
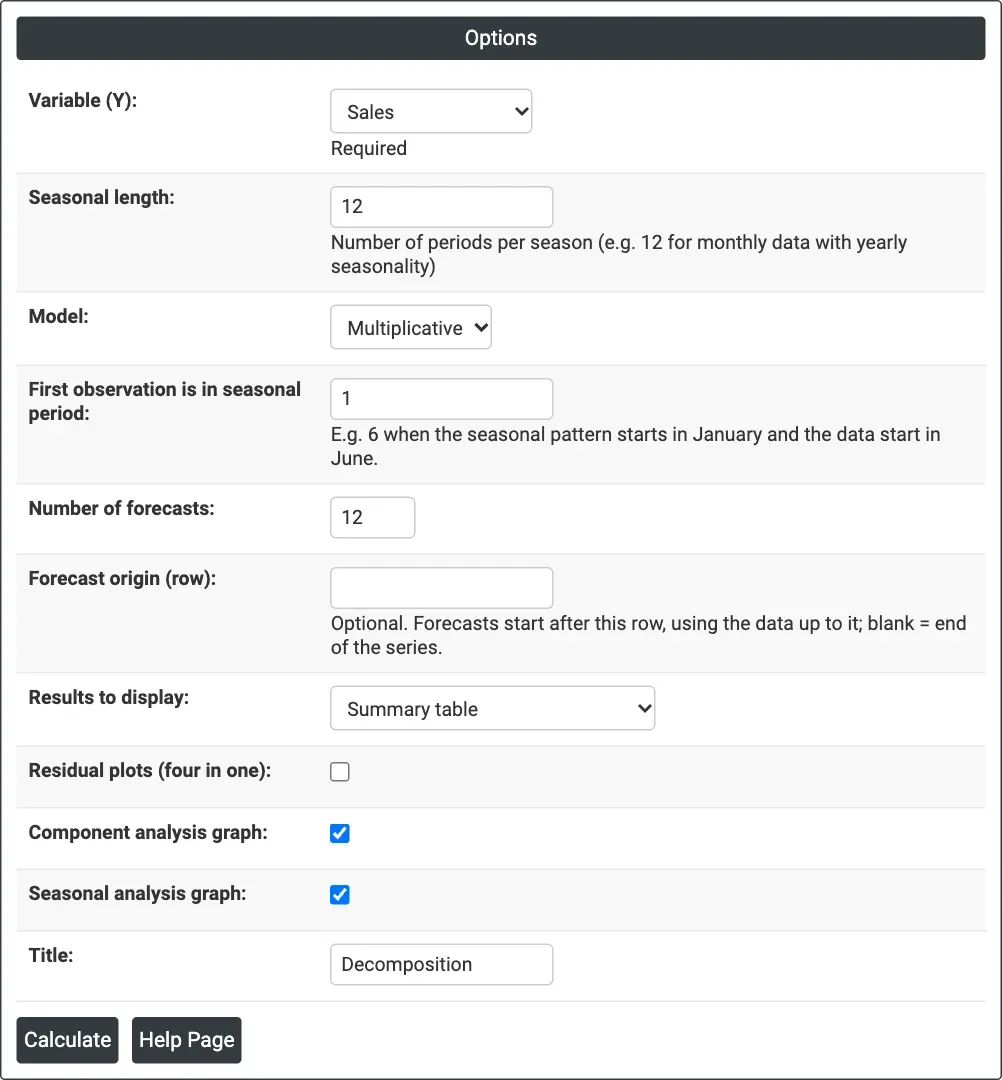
Abbildung 1 – Multiplikative Zerlegung der monatlichen Sales mit einer Saisonlänge von 12 und 12 Prognosen.
Beschreibung der Ausgabe
- <Model> Decomposition of <variable> – vier Felder: Observed, Trend, Seasonal und Residual, mit MAPE, MAD und MSD im Titel.
- Component Analysis for <variable> – Original Data, Detrended Data, Seasonally Adjusted Data sowie Seasonally Adj. and Detrended Data.
- Seasonal Analysis for <variable> – Seasonal Indices, Detrended Data by Season (Boxplots), Percent Variation by Season und Residuals by Season.
- Residual Plots for <variable> – wenn aktiviert.
- Method – Modelltyp, Datenspalte, Länge, Saisonlänge (sowie erste Periode und Prognoseursprung, falls festgelegt).
- Fitted Trend Equation, Seasonal Indices (einer je Periode), Accuracy Measures (MAPE, MAD, MSD) und Forecasts (Periode und Prognose).
- Results – falls gewählt: Period, Daten, Trend, Seasonal, Detrend, Deseason, Predict und Error für jede Zeile.
- PDF-Export über Download.
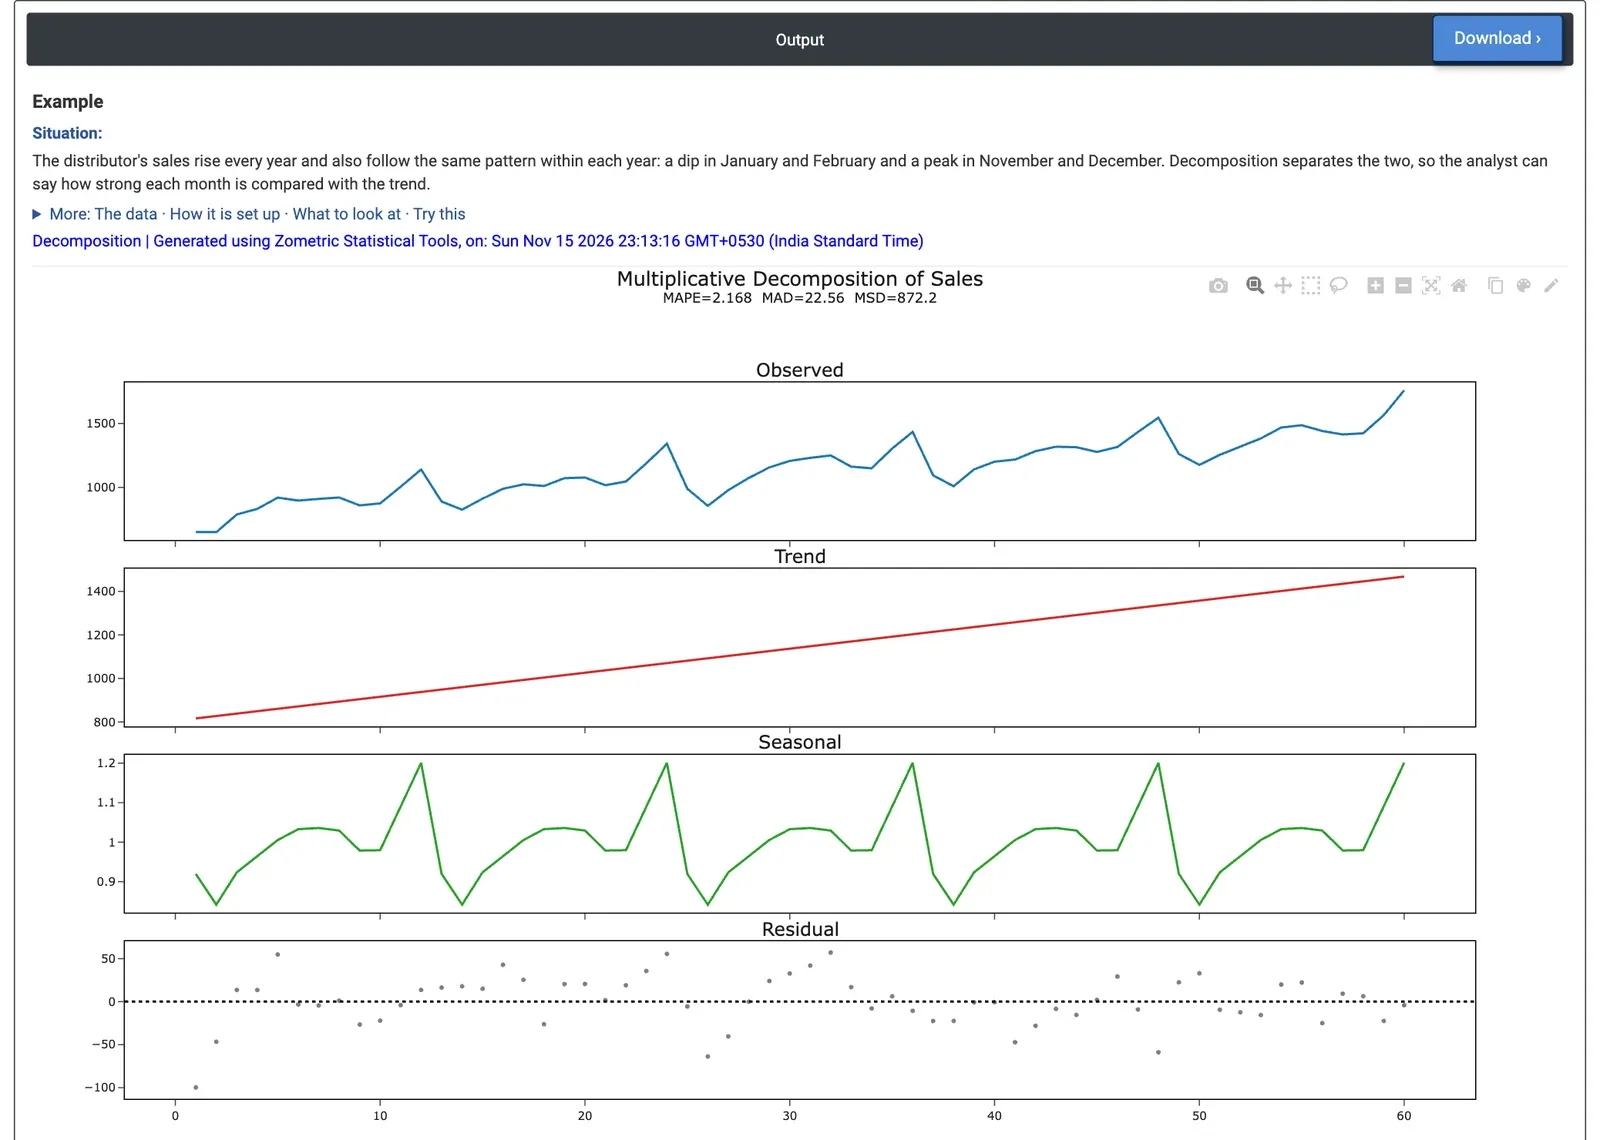
Abbildung 2 – Multiplikative Zerlegung von 60 Monaten Absatz: ein steigender Trend, ein jährlich wiederkehrendes Saisonmuster und kleine Residuen.
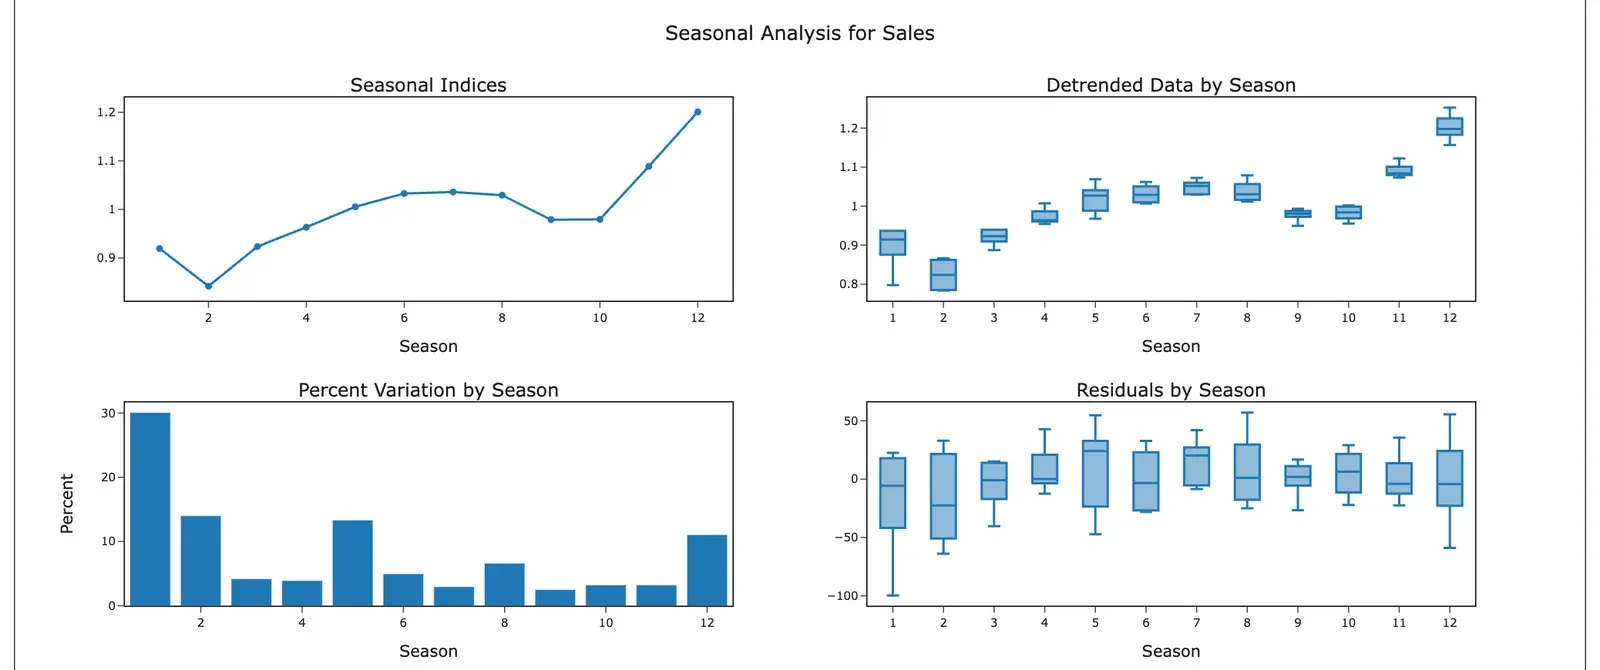
Abbildung 3 – Seasonal Analysis für das Beispiel: Februar ist der schwächste Monat (Index 0.84), Dezember der stärkste (1.20).
Beispiel
Der Absatz eines Distributors für Unterhaltungselektronik steigt jedes Jahr und folgt zudem innerhalb des Jahres demselben Muster: einem Rückgang zu Jahresbeginn und einer Spitze im November und Dezember. Der Absatzanalyst verfügt über 60 Monate Stückabsatz (Januar 2020 bis Dezember 2024) und muss wissen, wie stark jeder Monat im Vergleich zum Trend ist; außerdem benötigt er eine Prognose für 2025. Er wählt Variable (Y) = Sales, Seasonal length = 12, Model = Multiplicative und Number of forecasts = 12.
Der Trend lautet Yt = 805.33 + 11.049×t: etwa 11 Einheiten mehr pro Monat. Die Saisonindizes zeigen den Dezember bei 1.20 (20 % über dem Trend) und den November bei 1.09, während der Februar bei 0.84 (16 % unter dem Trend) und Januar und März bei 0.92 liegen. MAPE beträgt 2.2 % (MAD 22.6 Einheiten), gegenüber 7.4 % für eine reine Trendgerade auf der Seite Trend Analysis: Die Saisonalität erklärt den größten Teil dessen, was die Gerade nicht erfasst. Die Prognosen für 2025 folgen derselben Form, von 1,255 Einheiten im Februar bis 1,922 im Dezember.
Für die Planung bedeutet dies, dass Bestand und Personal für Dezember etwa ein Fünftel über dem Trendniveau liegen müssen und der Februar deutlich darunter bleiben kann. Das Diagramm Percent Variation by Season zeigt, dass der Januar von Jahr zu Jahr am stärksten schwankt, seine Prognose ist also am unsichersten. Mit Model = Additive beträgt MAPE 2.21 % gegenüber 2.17 %, beide Formen beschreiben diese Saisonalität also; die additive Variante weist jedem Monat statt eines Prozentsatzes eine feste Stückzahl zu (Dezember +224, Februar −193).
Häufig gestellte Fragen
Additive oder multiplikative Zerlegung: Welche sollte man verwenden?
Wählen Sie multiplikativ, wenn der saisonale Ausschlag mit dem Niveau der Reihe wächst, sodass jede Saisonperiode um einen Prozentsatz über oder unter dem Trend liegt. Wählen Sie additiv, wenn der Ausschlag gleich groß bleibt, sodass jede Saisonperiode um einen festen Betrag darüber oder darunter liegt. Das multiplikative Modell erfordert, dass alle Werte größer als null sind.
Was ist ein Saisonindex?
Ein Saisonindex zeigt, wie weit jede Periode der Saison über oder unter dem Trend liegt. Im multiplikativen Modell beträgt das Mittel der Indizes 1; ein Dezember bei 1.20 im Beispiel bedeutet also 20 % über dem Trend, ein Februar bei 0.84 bedeutet 16 % darunter. Im additiven Modell beträgt das Mittel der Indizes 0, und sie sind feste Beträge.
Wie viele Daten benötigt die Zerlegung?
Die Reihe benötigt mindestens zwei vollständige Saisons ohne Lücken. Prognosen schreiben die angepasste Trendgerade fort und wenden den Saisonindex der passenden Periode an; Prognoseintervalle werden nicht ausgegeben. Wird ein Prognoseursprung festgelegt, werden Indizes und Trend aus den Daten bis zu dieser Zeile neu berechnet, sodass sich das Verfahren an bekannten Daten testen lässt.
Wie wird die Prognosegenauigkeit der Zerlegung gemessen?
Zometric Statistical Software gibt MAPE (mittlerer absoluter prozentualer Fehler), MAD (mittlerer absoluter Fehler) und MSD (mittlerer quadratischer Fehler) aus. Im Beispiel betrug MAPE 2.2 % gegenüber 7.4 % für eine reine Trendgerade; das saisonale Muster erklärte also den größten Teil dessen, was die Trendgerade nicht erfasste.