
Deskriptive Statistik
Die deskriptive Statistik ist ein grundlegendes Analysewerkzeug, das einen umfassenden Satz numerischer Kennwerte berechnet und darstellt, die die wesentlichen Eigenschaften Ihrer Daten beschreiben. Sie umfasst drei Hauptdimensionen – Lage (wo die Daten zentriert sind), Streuung (wie stark die Daten variieren) und Form (wie die Daten verteilt sind).
Zuletzt geprüft
Kernaussage
Die deskriptive Statistik ist ein grundlegendes Analysewerkzeug, das einen Satz numerischer Kennwerte berechnet und darstellt, die die wesentlichen Eigenschaften Ihrer Daten beschreiben: Lage, Streuung und Form.
Auf dieser Seite
- Was ist deskriptive Statistik?
- Wann wird die deskriptive Statistik eingesetzt?
- Die wichtigsten Kennwerte erklärt
- Hinweise zur richtigen Anwendung der deskriptiven Statistik
- Alternativen: Wann Sie die deskriptive Statistik nicht verwenden sollten
- Beispiel für die deskriptive Statistik
- Anleitung: Deskriptive Statistik berechnen
Was ist deskriptive Statistik?
Die deskriptive Statistik ist ein grundlegendes Analysewerkzeug, das einen umfassenden Satz numerischer Kennwerte berechnet und darstellt, die die wesentlichen Eigenschaften Ihrer Daten beschreiben. Sie umfasst drei Hauptdimensionen – Lage (wo die Daten zentriert sind), Streuung (wie stark die Daten variieren) und Form (wie die Daten verteilt sind).
Statt Rückschlüsse zu ziehen oder Vorhersagen zu treffen, beschreibt die deskriptive Statistik lediglich, was in den Daten bereits vorhanden ist. Sie ist typischerweise der erste Schritt jeder statistischen Untersuchung und verschafft Ihnen ein klares, objektives Verständnis Ihres Datensatzes, bevor Sie weiterführende Verfahren anwenden.
Wann wird die deskriptive Statistik eingesetzt?
- Verwenden Sie sie als ersten Schritt jeder Datenanalyse , um die grundlegende Struktur und das Verhalten Ihres Datensatzes zu verstehen, bevor Sie andere Werkzeuge anwenden.
- Verwenden Sie sie, wenn Sie Daten klar zusammenfassen und vermitteln müssen , etwa an ein Team, eine Führungskraft oder Beteiligte, die einen knappen numerischen Überblick benötigen.
- Verwenden Sie sie beim Vergleich mehrerer Gruppen oder Datensätze – die deskriptive Statistik jeder Gruppe zeigt Unterschiede in Lage und Streuung auf einen Blick.
- Verwenden Sie sie, um auf Ausreißer, Schiefe oder ungewöhnliche Muster zu prüfen , bevor Sie mit einer formalen statistischen Analyse fortfahren.
Die wichtigsten Kennwerte erklärt
Kennwert
Was er aussagt
Mittelwert
Das arithmetische Mittel – der Schwerpunkt aller Messwerte
Median
Der mittlere Wert – weniger von Ausreißern beeinflusst als der Mittelwert
Standardabweichung
Wie stark die Messwerte typischerweise um den Mittelwert streuen
Varianz
Die quadrierte Streuung – wird in weiteren statistischen Berechnungen verwendet
Minimum / Maximum
Der kleinste und der größte beobachtete Wert im Datensatz
Spannweite
Die gesamte Streuung vom kleinsten bis zum größten Wert
Schiefe
Ob die Daten links (negativ) oder rechts (positiv) von der Mitte verschoben sind
Wölbung (Kurtosis)
Ob die Verteilung stärkere oder schwächere Ränder als die Normalverteilung hat
N (Stichprobenumfang)
Die Gesamtzahl der in die Analyse einbezogenen Beobachtungen
Hinweise zur richtigen Anwendung der deskriptiven Statistik
- Geben Sie immer ein Lagemaß und ein Streuungsmaß gemeinsam an – nur den Mittelwert ohne Standardabweichung anzugeben, ergibt ein unvollständiges Bild.
- Wenn die Daten schief verteilt sind oder Ausreißer enthalten, verwenden Sie den Median statt des Mittelwerts als primäres Lagemaß – er ist repräsentativer.
- Prüfen Sie Schiefe und Wölbung, um zu beurteilen, ob Normalverteilung angenommen werden kann , bevor Sie parametrische statistische Verfahren anwenden.
- Erfassen Sie mindestens 20 bis 30 Beobachtungen , damit Kennwerte wie Standardabweichung und Schiefe stabil und aussagekräftig sind.
Alternativen: Wann Sie die deskriptive Statistik nicht verwenden sollten
Situation
Stattdessen verwenden
Sie benötigen neben den Zahlen eine grafische Darstellung der Verteilungsform
Graphical Summary
Sie müssen auf signifikante Unterschiede zwischen Gruppen testen
Hypothesentests (t-Test, ANOVA)
Sie müssen Zusammenhänge zwischen Variablen verstehen
Korrelations- oder Regressionsanalyse
Die Daten sind kategorial (Bezeichnungen, Gruppen)
Balkendiagramm
Sie müssen Trends oder Verschiebungen über die Zeit erkennen
Verlaufsdiagramm (Run Chart) oder Regelkarte
Beispiel für die deskriptive Statistik
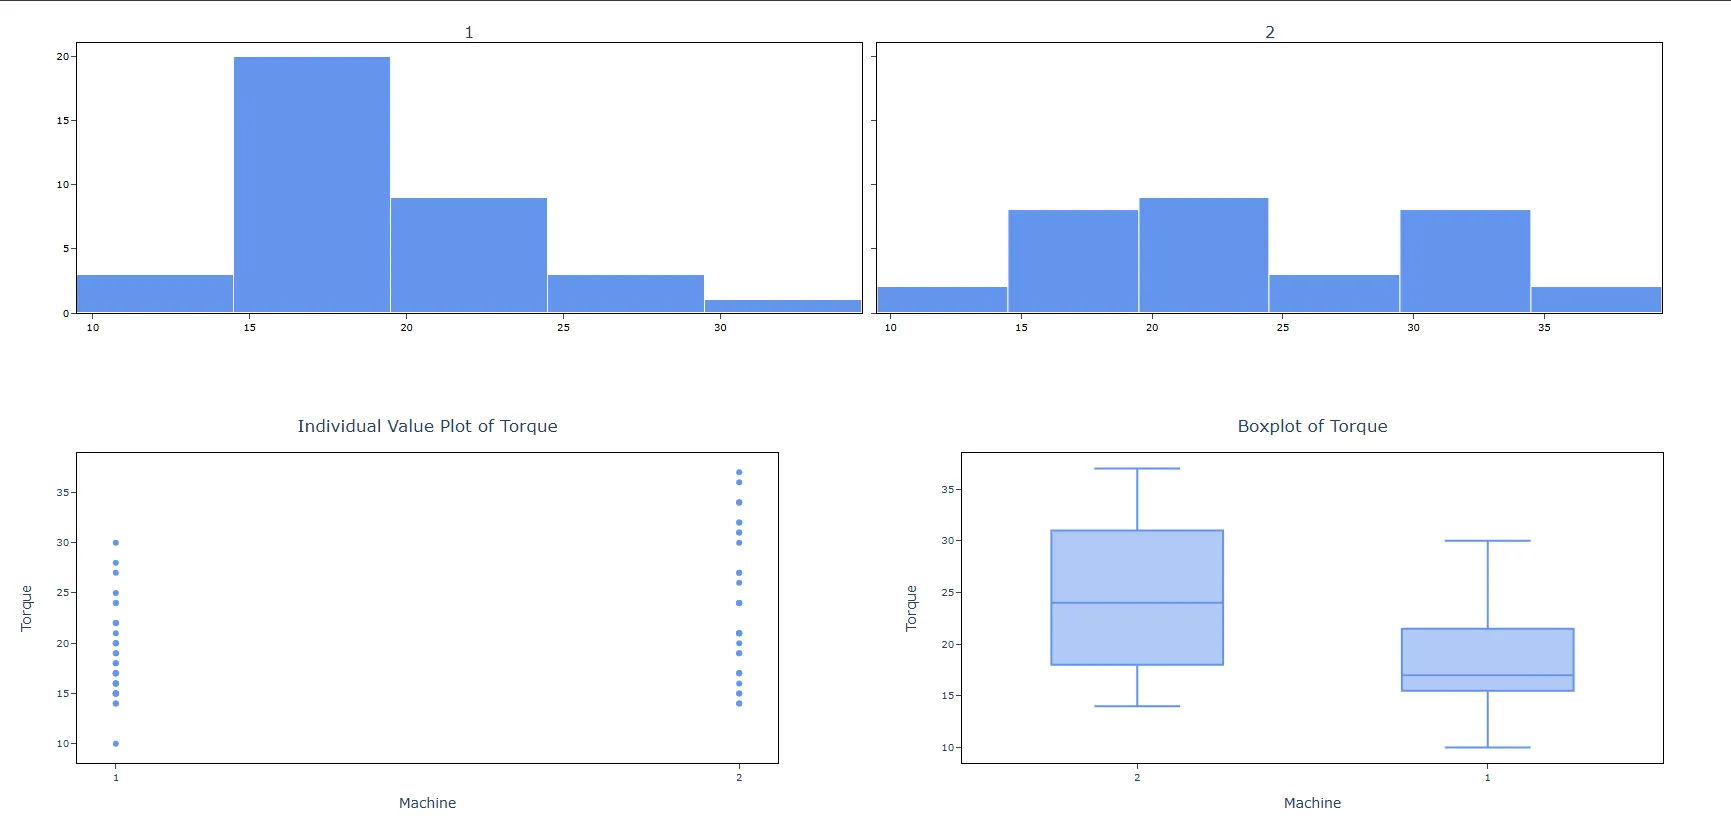
Ein Ingenieur der Qualitätslenkung muss sicherstellen, dass die Verschlüsse von Shampooflaschen korrekt angezogen sind. Sind die Verschlüsse zu locker, können sie sich beim Versand lösen. Sind sie zu fest, lassen sie sich möglicherweise nur schwer öffnen. Der Zielwert des Drehmoments zum Anziehen der Verschlüsse beträgt 18. Der Ingenieur entnimmt eine Zufallsstichprobe von 68 Flaschen und prüft, welches Drehmoment zum Öffnen der Verschlüsse erforderlich ist. Die Schritte:
- Die erforderlichen Daten wurden erhoben.
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Die deskriptive Statistik finden Sie unter Statistical module> Graphical analysis > Descriptive Statistics.
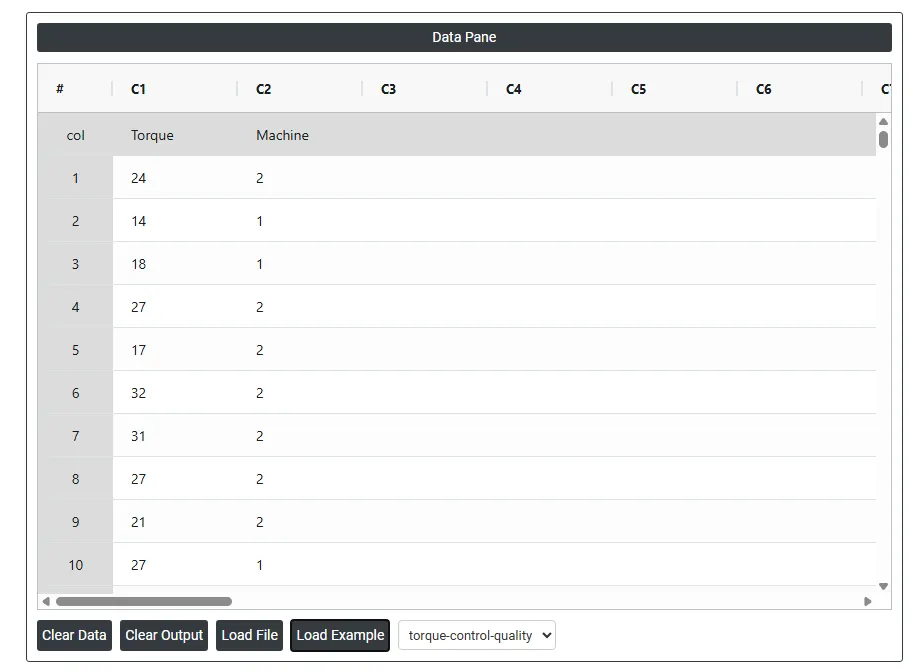
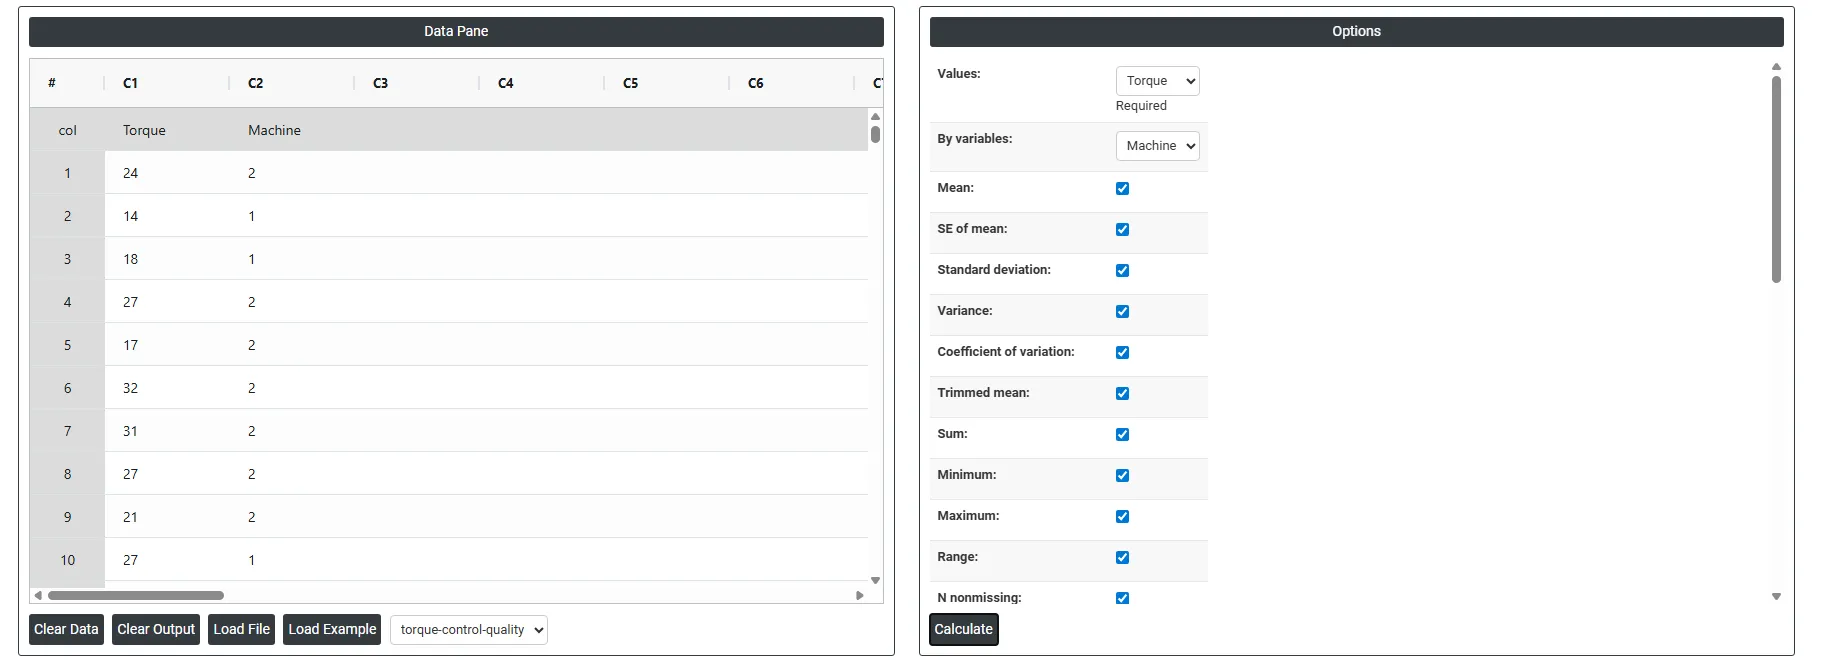
- Geben Sie im Werkzeug die Daten zusammen mit den weiteren Eingaben wie folgt ein:
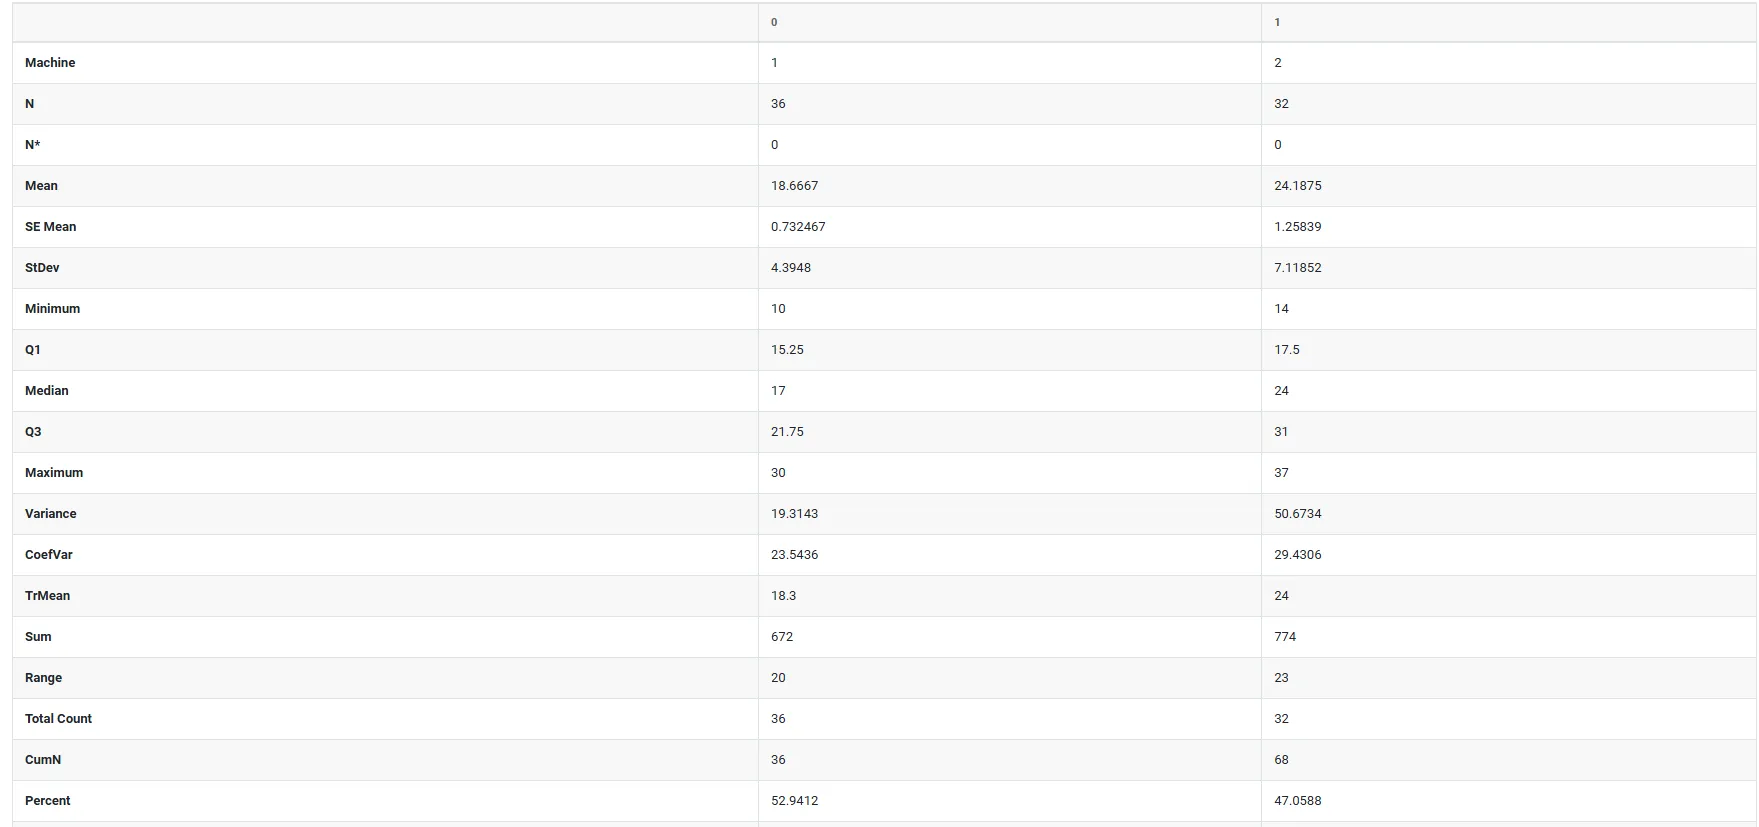
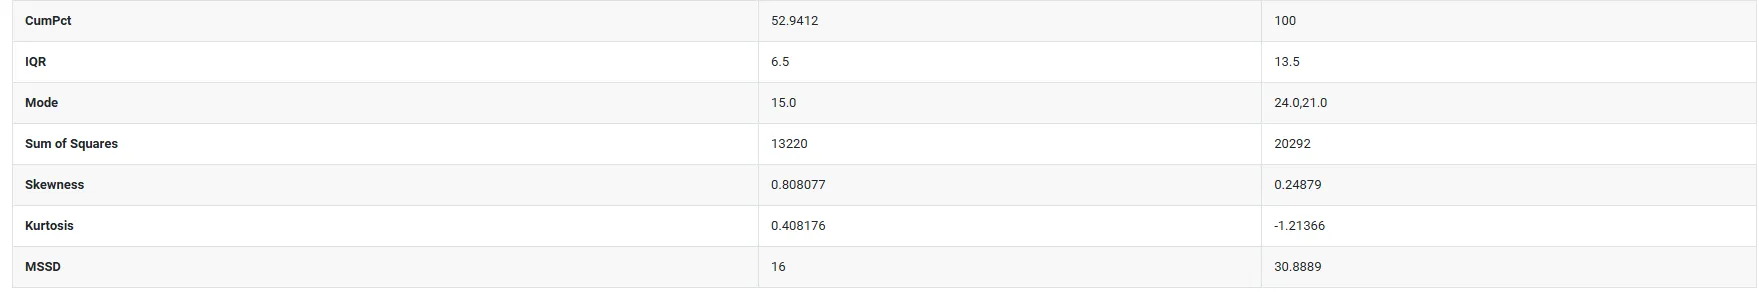
6. Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
Anleitung: Deskriptive Statistik berechnen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Graphical analysis > Descriptive Statistics.
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie ein (Strg+V). Alternativ gibt es die Option Load Example, mit der Beispieldaten geladen werden.
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard der deskriptiven Statistik ist in zwei Bereiche unterteilt.
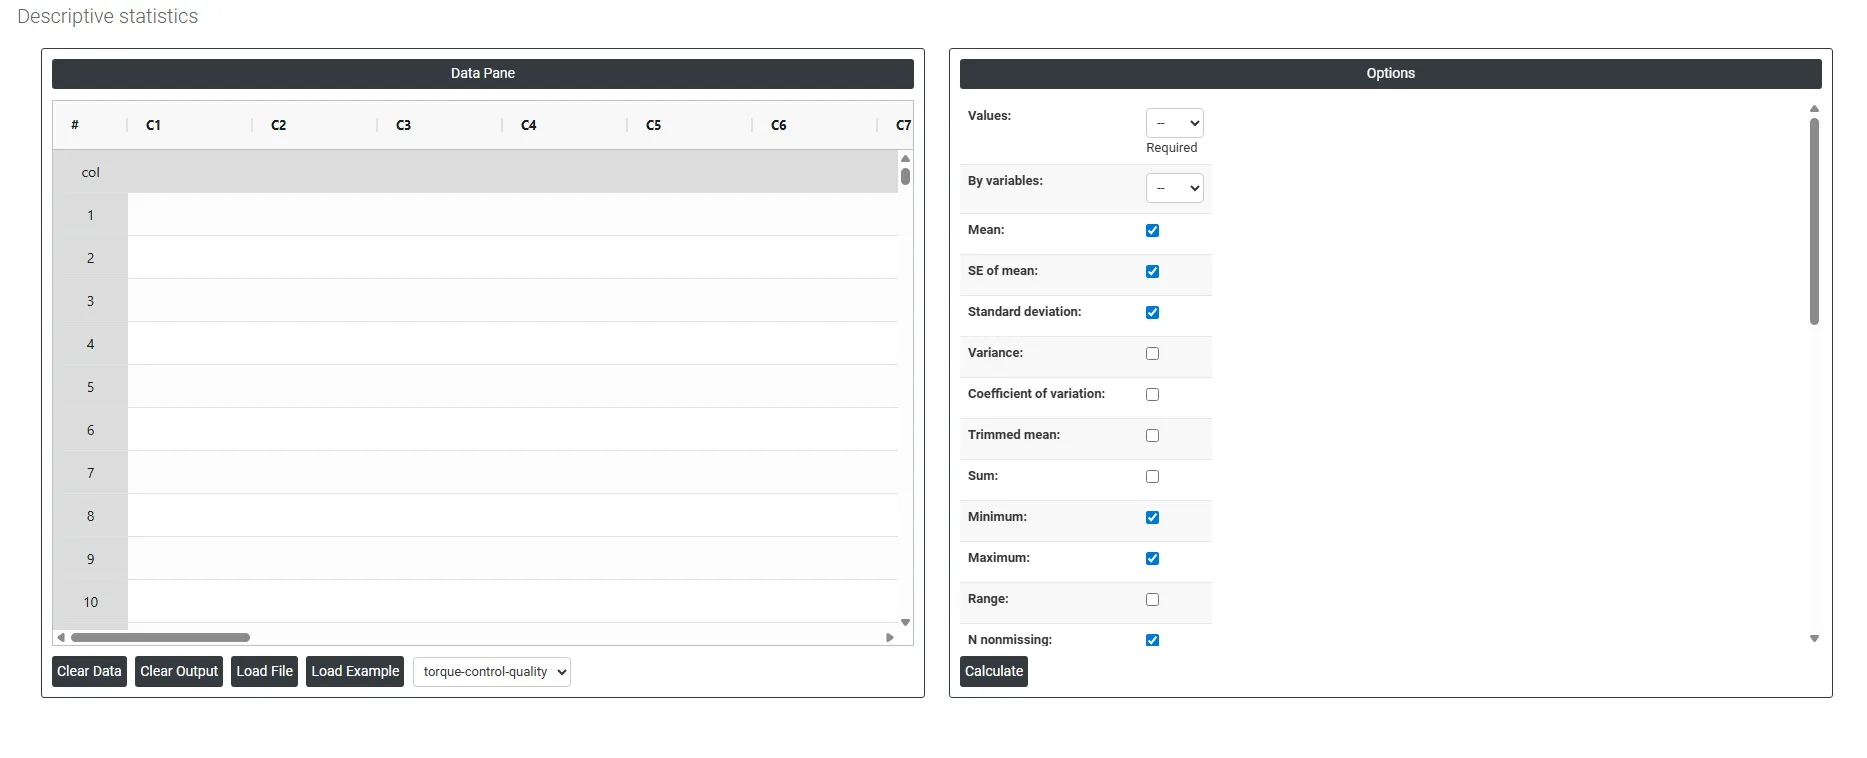
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example: Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich müssen Sie lediglich Folgendes angeben:
Values: Die Variable(n) mit den eigentlichen Daten, die Sie analysieren möchten, zum Beispiel Drehmomentmesswerte oder Maschine; wählen Sie dazu die Spalte aus.
By Variables: Eine optionale Gruppierungsvariable. Ist sie ausgewählt, werden die Kennwerte für jede Gruppe getrennt berechnet (z. B. nach Maschinentyp), sodass Sie die Gruppen nebeneinander vergleichen können.
Mean: Das arithmetische Mittel. Alle Werte addieren und durch die Anzahl teilen. Die gebräuchlichste Art, die Lage Ihrer Daten zusammenzufassen.
SE of mean (Standard Error of the Mean): Der Standardfehler des Mittelwerts schätzt, wie stark Ihr Stichprobenmittelwert vom wahren Mittelwert der Grundgesamtheit abweichen kann. Ein kleiner Standardfehler bedeutet eine verlässliche Schätzung des Mittelwerts; ein großer bedeutet mehr Unsicherheit.
Trimmed mean: Der Mittelwert, der nach Entfernen eines kleinen Prozentsatzes der niedrigsten und höchsten Werte berechnet wird (getrimmter Mittelwert). Das verringert den Einfluss extremer Ausreißer und ergibt eine stabilere Schätzung der Lage.
Median: Der mittlere Wert, wenn alle Datenpunkte der Größe nach sortiert sind. Die Hälfte der Werte liegt darüber, die Hälfte darunter. Verlässlicher als der Mittelwert, wenn die Daten schief verteilt sind oder Ausreißer enthalten.
Mode: Der Wert, der im Datensatz am häufigsten vorkommt (Modalwert). Nützlich, um den häufigsten Messwert oder die häufigste Kategorie zu ermitteln.
Sum: Die Summe aller Werte. Nützlich, wenn die kumulierte Menge wichtig ist und nicht nur der Mittelwert.
Standard deviation: Misst den durchschnittlichen Abstand jedes Datenpunkts vom Mittelwert. Ein kleiner Wert bedeutet, dass die Daten eng beieinander liegen; ein großer, dass sie weit streuen.
Variance: Die quadrierte Standardabweichung. Direkt weniger anschaulich zu interpretieren, wird aber im Hintergrund in vielen statistischen Berechnungen und Tests verwendet.
Coefficient of variation (CV): Drückt die Standardabweichung als Prozentsatz des Mittelwerts aus (SD ÷ Mean × 100) (Variationskoeffizient). So lässt sich die Streuung von Datensätzen mit unterschiedlichen Einheiten oder sehr unterschiedlichen Mittelwerten vergleichen.
Range: Das einfachste Streuungsmaß: Maximum minus Minimum. Leicht verständlich, aber sehr empfindlich gegenüber einem einzelnen Extremwert.
Interquartile range (IQR): Die Streuung der mittleren 50 % Ihrer Daten (Q3 minus Q1) (Interquartilsabstand). Da er die oberen und unteren 25 % außer Acht lässt, ist er robust gegenüber Ausreißern und ein verlässliches Maß der typischen Streuung.
MSSD (Mean of Successive Squared Differences): Misst die Streuung zwischen aufeinanderfolgenden Datenpunkten in der Reihenfolge ihrer Erfassung. Besonders nützlich in der Prozessüberwachung und bei Zeitreihen, um zu erkennen, ob ein Prozess instabil ist oder im Lauf der Zeit driftet.
Sum of squares: Die Summe der quadrierten Einzelwerte. Für sich allein nicht direkt interpretierbar, aber ein zentraler Baustein, der intern in Varianz-, Regressions- und ANOVA-Berechnungen verwendet wird.
Minimum: Der kleinste Wert im gesamten Datensatz.
Maximum: Der größte Wert im gesamten Datensatz.
First quartile (Q1): Das 25. Perzentil. Ein Viertel aller Werte liegt bei oder unter diesem Punkt.
Third quartile (Q3): Das 75. Perzentil. Drei Viertel aller Werte liegen bei oder unter diesem Punkt.
N nonmissing: Die Anzahl der Datenpunkte mit einem gültigen erfassten Wert, die in die Analyse einbezogen werden.
N missing: Die Anzahl der Datenpunkte ohne Wert (leer oder null). Eine hohe Anzahl fehlender Werte kann auf ein Problem bei der Datenerfassung hinweisen.
N total: Die Gesamtzahl der Zeilen = N nonmissing + N missing.
Cumulative N: Eine laufende Summe der Beobachtungen, während Sie die Zeilen oder Gruppen nach unten durchgehen.
Percent: Die Anzahl jeder Gruppe als Prozentsatz der Gesamtzahl der Beobachtungen.
Cumulative Percent: Eine laufende Summe der Prozentsätze. Die letzte Zeile erreicht stets 100%.
Skewness: Misst, wie asymmetrisch die Verteilung um den Mittelwert ist (Schiefe).
- Null = vollkommen symmetrisch
- Positiv = der Verteilungsrand reicht nach rechts (einige sehr hohe Werte ziehen den Mittelwert nach oben)
- Negativ = der Verteilungsrand reicht nach links (einige sehr niedrige Werte ziehen den Mittelwert nach unten)
Kurtosis: Misst, wie stark oder schwach die Ränder der Verteilung im Vergleich zu einer Normalverteilung (Glockenkurve) ausgeprägt sind (Wölbung).
- Hohe Wölbung = mehr extreme Ausreißer als erwartet
- Geringe Wölbung = weniger Extremwerte, flachere Verteilung
Histogram of data: Ein Balkendiagramm, das zeigt, wie häufig Werte in festgelegte Intervalle (Klassen) fallen. Am besten geeignet, um die Gesamtform zu erkennen, etwa ob die Daten normalverteilt, schief, bimodal usw. sind.
Individual value plot: Stellt jeden einzelnen Datenpunkt als eigenen Punkt auf einem Zahlenstrahl dar. Nichts wird verdeckt oder gemittelt. Am besten geeignet, um Ausreißer zu erkennen und die tatsächliche Streuung der Rohdaten zu sehen.
Boxplot of data: Ein Box-Whisker-Diagramm, das Median, Q1, Q3 und Ausreißer in einer kompakten Darstellung zusammenfasst. Hervorragend geeignet, um Streuung und Lage mehrerer Gruppen nebeneinander zu vergleichen.
Show variables as columns: Transponiert die Ergebnistabelle, sodass jede Variable eine Spalte statt einer Zeile wird. Besonders nützlich, wenn Sie viele Variablen vergleichen und sie zum einfachen Vergleich nebeneinander anordnen möchten.
Download as Excel: Gibt das Ergebnis im Excel-Format aus, das sich leicht bearbeiten und über die Option load file erneut für Berechnungen laden lässt.
Häufig gestellte Fragen
Was ist deskriptive Statistik?
Die deskriptive Statistik besteht aus numerischen Kennwerten, die die wesentlichen Eigenschaften eines Datensatzes in drei Dimensionen zusammenfassen: Lage (wo die Daten zentriert sind), Streuung (wie stark sie variieren) und Form (wie sie verteilt sind). Sie beschreibt, was bereits in den Daten vorhanden ist, statt Rückschlüsse zu ziehen, und ist typischerweise der erste Schritt jeder statistischen Untersuchung.
Sollten Sie den Mittelwert oder den Median verwenden?
Wenn die Daten schief verteilt sind oder Ausreißer enthalten, verwenden Sie den Median als primäres Lagemaß, da er weniger von Extremwerten beeinflusst wird als der Mittelwert. Geben Sie immer ein Lagemaß zusammen mit einem Streuungsmaß an; den Mittelwert ohne Standardabweichung anzugeben, ergibt ein unvollständiges Bild.
Was sagen Schiefe und Wölbung aus?
Die Schiefe misst die Asymmetrie: Null ist symmetrisch, positiv bedeutet, dass der Verteilungsrand nach rechts reicht, negativ, dass er nach links reicht. Die Wölbung (Kurtosis) vergleicht die Ausprägung der Ränder mit einer Normalverteilung: Eine hohe Wölbung bedeutet mehr extreme Ausreißer als erwartet, eine geringe weniger. Prüfen Sie beide, um zu beurteilen, ob vor dem Einsatz parametrischer Verfahren Normalverteilung angenommen werden kann.
Wie viele Beobachtungen benötigen Sie für die deskriptive Statistik?
Erfassen Sie mindestens 20 bis 30 Beobachtungen, damit Kennwerte wie Standardabweichung und Schiefe stabil und aussagekräftig sind. Wählen Sie in Zometric Statistical Software die Spalte Values, optional eine By variable, um Gruppen nebeneinander zu vergleichen, und aktivieren Sie die benötigten Kennwerte und Grafiken, etwa Histogramm, Einzelwertdiagramm oder Boxplot.